


Nemotron Elastic: Towards Efficient Many-in-One Reasoning LLMs 요약 설명
20 Nov 2025 | Paper Review Elastic Training Knowledge Distillation Model Pruning목차
이번 글에서는 Nemotron Elastic: Towards Efficient Many-in-One Reasoning LLMs 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 11월 20일(Arxiv)
- Taghibakhshi, Ali, Sreenivas, Sharath Turuvekere, Muralidharan, Saurav, Cai, Ruisi, Chochowski, Marcin, Mahabaleshwarkar, Ameya Sunil, Suhara, Yoshi, Olabiyi, Oluwatobi, Korzekwa, Daniel, Patwary, Mostofa, et al.
- NVIDIA
- 논문 링크
- Project Page
요약
- 복잡한 문제를 풀기 위해 중간 추론 단계를 생성하는 대규모 언어 모델을 여러 크기로 만들려면 보통 크기마다 별도의 학습이나 압축 과정이 필요하다. Nemotron Elastic은 사전 학습된 12B-parameter 부모 모델에서 출발해 110B 학습 토큰으로 중첩된 6B, 9B, 12B 모델을 함께 학습한다. 작은 모델은 부모 모델의 가중치 일부를 공유한다. 추론을 활성화한 벤치마크 평가에서 12B 모델의 평균 점수는 77.41로, NanoV2-12B의 77.38과 비슷하다.
- 이 방법은 가중치 공유, 목표 파라미터 예산에 맞춰 모델 차원을 선택하는 학습된 라우터, 학생 모델이 교사 모델의 예측을 따르도록 학습하는 지식 증류를 결합한다. 학습 시퀀스 길이는 8192 토큰에서 49152 토큰으로 늘어나며, 2단계에서는 가장 큰 모델에 더 많은 샘플을 배정한다.
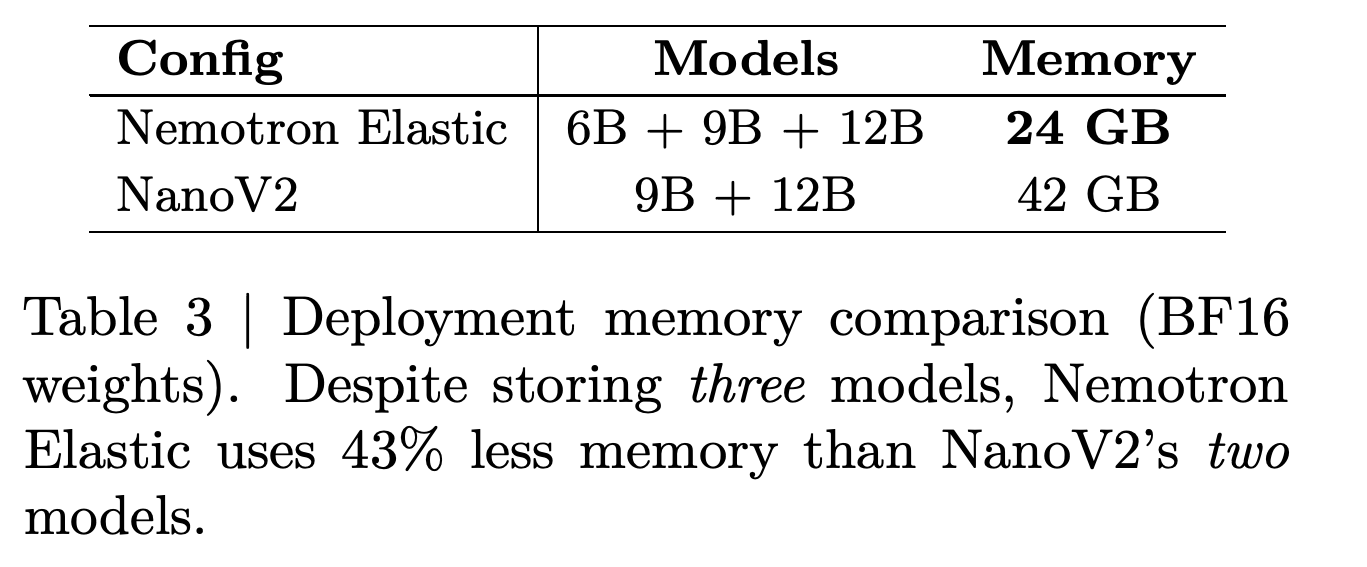
- 보고된 학습 예산은 110B 토큰이며 순차 압축 예산인 750B와 작은 모델을 처음부터 학습하는 예산인 40T보다 적다. 다만 비교 대상의 예산 중 일부는 추정치다. 파라미터를 16비트로 표현하는 BF16 가중치를 공유하면 모든 모델을 저장하는 데 24 GB가 필요하다. NanoV2 9B와 12B 가중치를 각각 저장하면 42 GB가 필요하다. 이 비교는 실행 중 캐시, 활성값, 추론 속도를 정량적으로 다루지 않는다.
Introduction
모델 크기마다 독립적으로 학습하면 비용이 큰 최적화를 반복해야 하며, 기존 압축 방식도 별도의 가지치기와 성능 복구 과정이 필요하다. 가지치기는 모델 구성요소를 제거한다. Elastic 또는 Matryoshka 방식의 네트워크는 큰 모델 안에 작은 모델을 포함해 파라미터를 공유하고 추가 학습 없이 작은 모델을 추출할 수 있게 한다.
- Hybrid Mamba-Attention 아키텍처는 시퀀스 위치 사이의 상호작용을 계산하는 attention과 Mamba 같은 시퀀스 처리 구성요소인 상태 공간 모델(SSM)을 결합한다. Mamba는 선형 시간에 시퀀스를 처리하지만 그룹과 채널에 관한 제약 때문에 압축이 복잡해진다.
- 추론 모델은 중간 추론 단계를 생성하기 위해 긴 시퀀스가 필요하다. 논문은 자원 예산에 맞춰 아키텍처를 유연하게 구성하면서 긴 문맥에서 추론 능력을 유지하는 것을 목표로 한다.
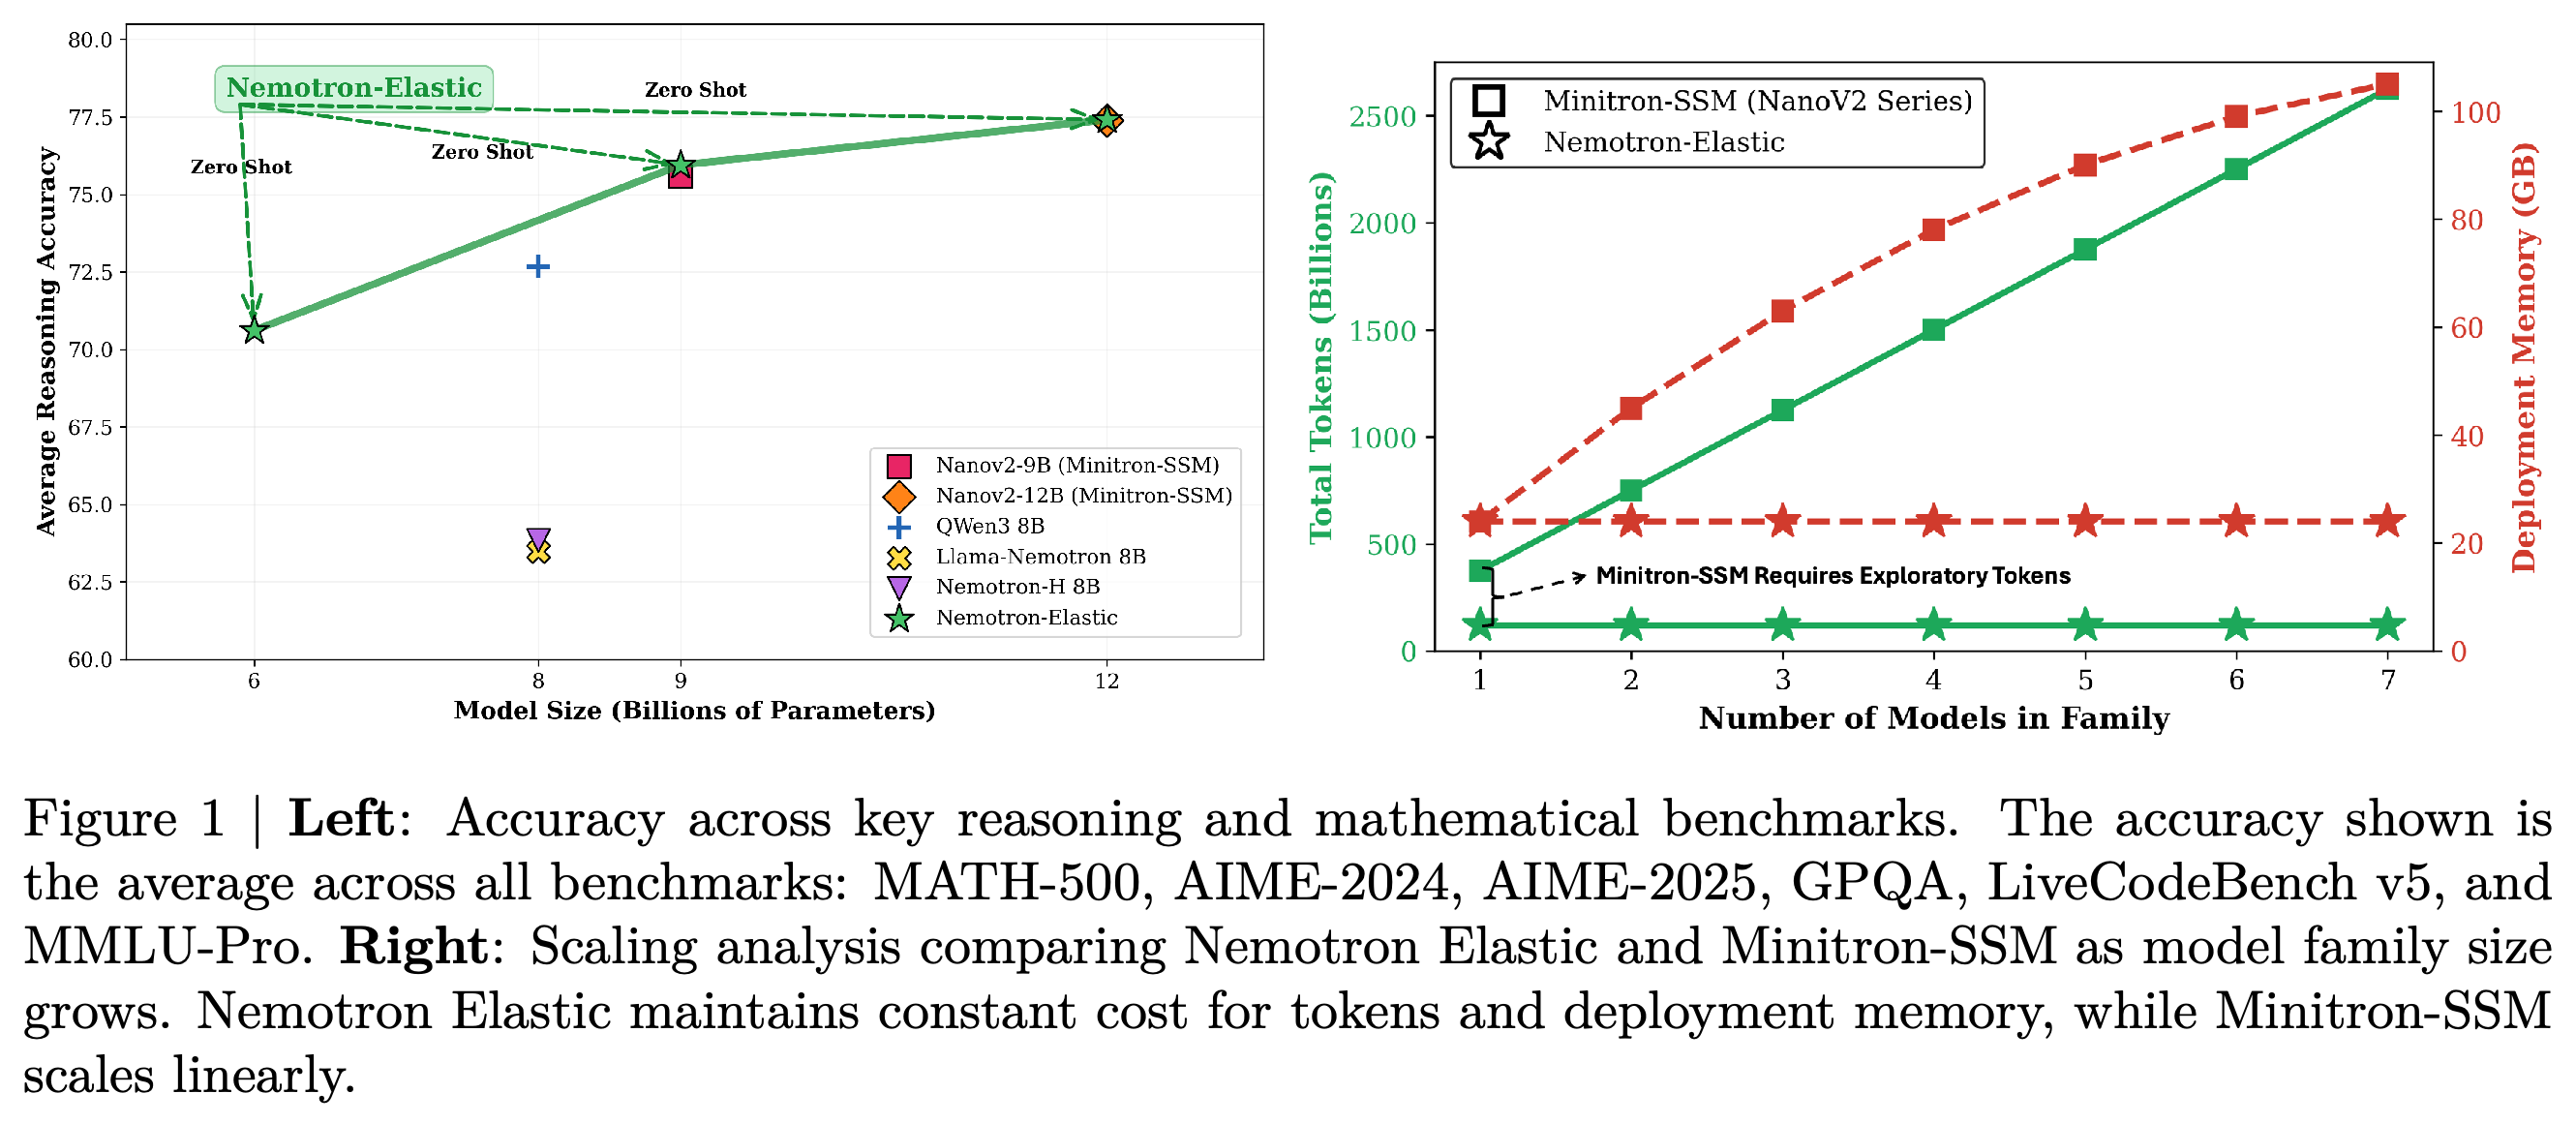
- Figure 1은 수학 문제인 MATH-500, American Invitational Mathematics Examination 문제인 AIME-2024와 AIME-2025, 대학원 수준의 과학 질문인 GPQA, 코드 생성과 문제 해결을 평가하는 LiveCodeBench v5, 대학 수준의 객관식 추론을 평가하는 MMLU-Pro의 평균 점수를 보여준다. 2번째 패널은 모델군 크기에 따른 학습 토큰과 저장 가중치의 변화를 예시한다.
정확도 패널에서 elastic 9B와 12B 모델은 해당 NanoV2 모델과 비슷한 위치에 있으며 6B 모델의 평균 정확도는 더 낮다. 확장성 패널은 체크포인트 공유의 비용상 이점을 예시한다. 다만 모델군을 7개 모델로 확장한 부분은 직접 평가한 3개 예산의 범위를 넘어선다.
Methodology
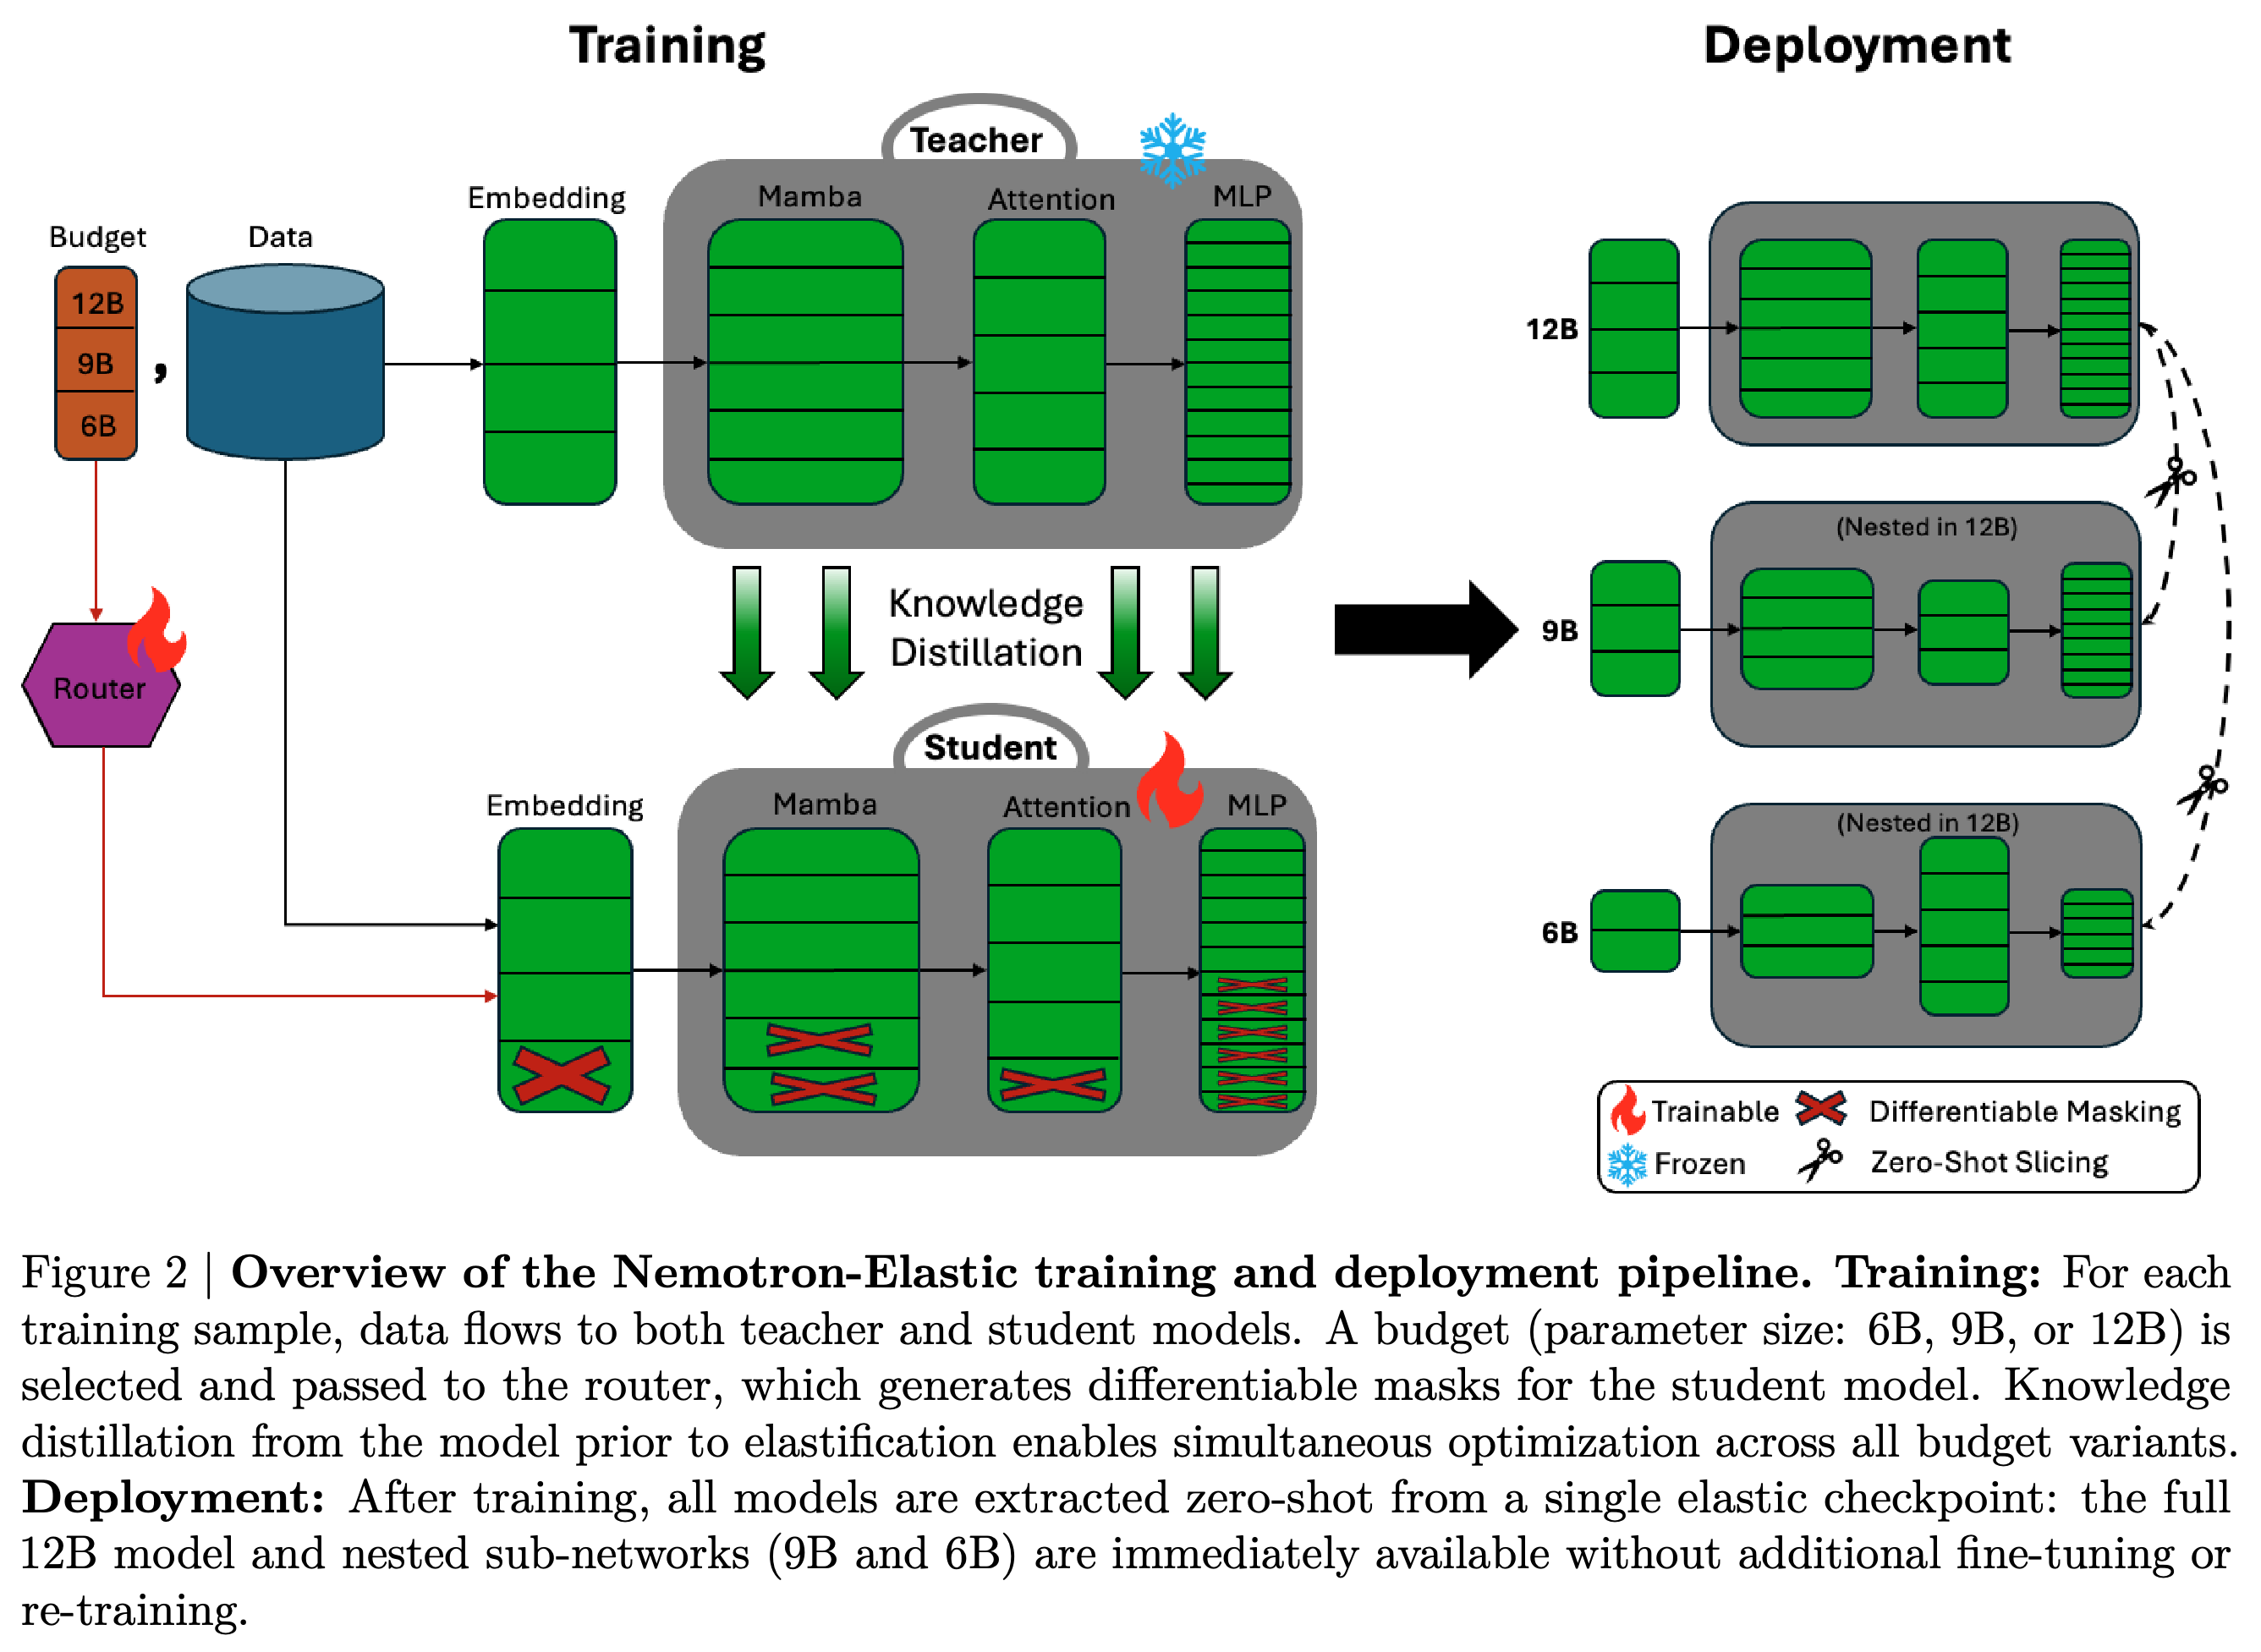
전체 과정은 먼저 구성요소의 중요도를 평가한 뒤, 가중치를 공유하는 학생 모델과 목표 예산을 입력받는 라우터를 학습한다. 라우터는 구성요소 차원의 크기인 너비와 유지할 층의 수인 깊이를 선택한다. 별도로 고정한 원본 모델이 증류 목표를 제공하며 미분 가능한 마스크가 구성요소를 선택하고 학습 기울기를 라우터에 전달한다.
- Figure 2는 학습 중 마스킹과 추가 학습 없이 모델을 추출하는 zero-shot slicing의 관계를 보여준다. 학습된 체크포인트 1개에 지원하는 모델 크기가 모두 포함된다.
선택한 예산을 라우터에 입력하면 라우터가 학습 가능한 학생 모델에 마스크를 적용하고 고정된 교사 모델이 예측 목표를 제공한다. 배포 부분은 작은 모델이 같은 부모 가중치의 부분집합을 재사용함을 보여준다. 이 때문에 각 크기의 모델을 추출할 때 별도의 성능 복구 과정이 필요하지 않다.
Importance Estimation and Model Preparation
너비 중요도는 순전파 활성값의 크기로 추정한다. 대상은 토큰 표현의 차원인 임베딩 채널, 선형 투영 사이에 있는 순방향 신경망(FFN)의 중간 뉴런, 병렬 attention 구성요소인 attention head, Mamba head와 그 채널이다. Mamba 채널 점수는 head 전체에서 집계하고 head 점수는 상위 채널을 사용해 계산한다. SSM 구조를 유지하기 위해 head 순위는 각 그룹 안에서 독립적으로 정한다.
- 임베딩 점수는 층 정규화를 적용한 입력 활성값의 절댓값을 배치와 시퀀스 차원에 걸쳐 집계한다. 층 정규화는 층의 입력 특성 스케일을 조정한다. FFN 점수는 첫 선형 투영의 중간 활성값을 사용하고 attention head 점수는 query 투영의 활성값을 집계한다.
- 깊이 중요도는 층을 제거해 영향을 측정하는 반복적 층 제거 실험과 정규화된 평균제곱오차(MSE)를 사용한다. 전체 모델과 층을 제거한 모델의 logits, 즉 출력 확률을 계산하기 전의 점수를 비교하고 차이의 제곱합을 전체 모델 logits의 제곱합으로 나눈다.
- 층 j의 점수는 s_j = sum_{B,L}(M_full - M_-j)^2 / sum_{B,L}M_full^2이다. 여기서 B와 L은 배치와 시퀀스 차원의 인덱스이며 M은 모델의 logits를 뜻한다. 점수가 높은 층을 우선적으로 유지한다.
Elastic Formulation
Elastic width는 미리 정의된 선택지에서 임베딩 차원, FFN 중간 차원, attention head 수, Mamba head 수, Mamba head의 채널 수를 선택한다. 작은 모델은 중요도순으로 정렬된 구성요소 중 큰 모델이 사용하는 연속된 부분집합을 유지해 중첩된 가중치 공유를 보존한다.
- Elastic depth는 이진 계수로 층의 유지 여부를 정한다. 비활성 층은 입력을 다음으로 전달하는 잔차 연결을 통해 건너뛴다.
- Mamba 선택은 그룹 구조와 채널의 일관성을 유지하며 attention 선택은 head 단위로 이루어진다. 동질적 구성은 같은 유형의 구성요소에 동일한 압축률을 적용하고 이질적 구성은 층마다 다른 압축률을 허용한다.
Elastic Training
Router Architecture and Design은 각 동적 차원에 별도의 2층 네트워크를 배정한다. 선형 층 사이에는 활성화 함수인 LeakyReLU를 사용한다. 입력은 목표 압축 수준을 나타내는 one-hot 표현이다. 출력은 동질적 모드에서는 같은 유형의 구성요소에 공통으로 적용할 선택을, 이질적 모드에서는 층별 선택을 지정한다. 임베딩 선택은 모델 전체에 공통으로 적용한다.
- Loss Formulation은 이산적인 구성 선택을 미분 가능하게 완화하는 Gumbel-Softmax를 사용한다. 온도를 점차 낮추면 부드러운 탐색에서 더 확정적인 선택으로 바뀐다.
- 라우터 목적함수는 선택한 구성의 자원 비용과 목표 제약 사이의 차이에 페널티를 부여한다. 프레임워크는 파라미터 수, 메모리, 지연 시간, 처리량을 비용으로 사용할 수 있다고 설명한다. 보고된 실험은 파라미터 예산을 목표로 한다.
Versatile Training Options는 학습 정답의 확률을 맞추는 교차 엔트로피 학습, 학습 가능한 교사 모델을 통한 증류, 고정된 교사 모델을 통한 증류, 그리고 이 방식들의 조합을 포함한다. 증류는 교사와 학생의 출력 확률분포 사이의 차이를 나타내는 forward Kullback–Leibler divergence를 최소화한다. 보고된 중첩 모델 실험은 고정된 원본 12B 교사 모델을 사용한다.
- 학습 가능한 교사 모델은 모델 자체의 출력을 감독 신호로 사용하는 자기 증류 과정에서 붕괴를 막기 위해 교차 엔트로피 감독도 받는다. 고정된 교사 모델은 기울기로 갱신되지 않고 고정된 목표를 제공한다.
- Final Optimization Target은 과제 손실과 가중치를 적용한 라우터 손실을 결합한다. 식은 L_total = L_task(theta) + lambda * L_router(psi)이다. 여기서 theta는 모델 파라미터, psi는 라우터 파라미터이며 lambda는 자원 페널티의 가중치다.
Two-Stage Training with Curriculum-Based Sampling은 각 샘플에 목표 예산 1개를 배정한다. Stage 1은 예산을 균등하게 샘플링해 아키텍처 학습을 안정화한다. Stage 2는 더 긴 시퀀스를 사용하고 전체 예산을 사용하는 학생 모델에 더 많은 샘플을 배정해, 균등 샘플링에서 관찰된 성능 불균형을 완화한다.
- 실험의 Stage 2 확률은 p(12B) = 0.5, p(9B) = 0.3, p(6B) = 0.2이다.
- 저자들은 이 불균형을 가중치를 공유하는 모델 사이에서 학습 갱신이 충돌하는 기울기 경쟁으로 해석한다. 샘플링 비교 실험은 예산 배분의 상충관계를 뒷받침하지만 그 메커니즘을 직접 측정하지는 않는다. 고정된 교사 모델은 바뀌지 않는다.
Implementation
Dynamic Model Formulation은 공유 아키텍처의 활성값과 가중치 행렬에 차원별 마스크를 적용하고 이진 계수로 층의 유지 여부를 제어한다. Dynamic Mamba는 투영, 현재와 이전 위치만 처리하는 인과적 합성곱, 상태 공간 갱신, 마스킹된 출력 전반에서 그룹 구조를 고려한 head 선택과 head 채널의 일관성을 유지한다.
- Dynamic Attention은 임베딩 차원과 attention 계산에 사용하는 query, key, value 투영을 마스킹한 뒤, 출력 투영과 마스킹을 수행한다.
- Dynamic FFN은 2개의 선형 변환과 출력에서 임베딩 차원과 중간 차원을 마스킹한다.
- Mask Generation은 라우터의 선택을 중요도가 높은 구성요소를 유지하는 마스크로 변환한다. 이질적 모드에서는 층별 마스크를 만들며, 깊이 선택은 중요도가 높은 층을 활성화한다.
- 구현은 선택한 logit으로 스케일을 조정하는 hard selection과 확률로 가중한 soft mask를 지원한다. 배포 시에는 확률이 가장 높은 선택지를 고르는 argmax를 사용하고 선택한 logit을 1로 설정한다.
Elastic Model Deployment
학습에 포함된 예산에 대해 라우터가 유지할 파라미터를 식별하고 나머지 구성요소를 elastic 체크포인트에서 영구적으로 잘라낸다. 이렇게 얻은 모델에는 추가 재학습, 미세 조정, 증류가 필요하지 않다.
- 추출 절차는 학습에 사용한 예산 집합에 적용된다. 학습하지 않은 임의의 예산에서도 같은 품질을 얻는지는 평가하지 않았다.
- 부모 체크포인트를 공유하면 각 모델을 별도로 저장할 필요가 없다. 학습된 예산 중에서 선택하는 것은 과제에 따라 추론 시점에 동적으로 라우팅하는 것과 다르다. 결론에서는 후자를 향후 연구로 제시한다.
Experiments and Results
실험은 NVIDIA Nemotron Nano V2 12B를 중첩된 9B와 6B 모델로 압축하며 이는 각각 25%와 50%의 파라미터 감소에 해당한다. 논문은 base와 reasoning 모델을 모두 고려한다고 밝힌다. 주요 정량 결과는 중첩 모델군에 대해 6개의 추론 및 지식 벤치마크 성능을 보고한다.
Experimental Setup
구성요소 중요도를 추정하는 보정 작업과 증류에는 NanoV2-9B 학습에 사용한 것과 동일한 압축용 데이터 혼합을 사용한다. 중요도 추정에는 길이 8192인 샘플 1024개를 처리한다. Phase 1은 배치 크기 1536, 시퀀스 길이 8192로 약 65B 토큰을 사용하고 Phase 2는 배치 크기 512, 시퀀스 길이 49152로 약 45B 토큰을 사용한다.
- 평가는 추론을 활성화하고 생성한 답변 1개의 성공 여부를 나타내는 pass@1을 보고한다. 논문은 MATH-500, AIME-2024, AIME-2025, GPQA, LiveCodeBench v5, MMLU-Pro 각각에 맞춰 4~16 shots의 결과를 평균한다고 밝힌다.
- 모델과 라우터의 학습률은 각각 9e-5와 1e-2이며, 60-step 선형 warmup을 사용한다. Gumbel-Softmax 온도는 1.0에서 0.05로 감소하고 라우터 손실 가중치는 1.0이다. 라우터 logit의 스케일은 1.0에서 10.0으로 증가하며 라우터 은닉 차원은 256이다.
- Stage 1은 6B, 9B, 12B 예산 각각에 1/3의 확률을 부여한다. Stage 2는 각각 0.2, 0.3, 0.5의 확률을 사용한다.
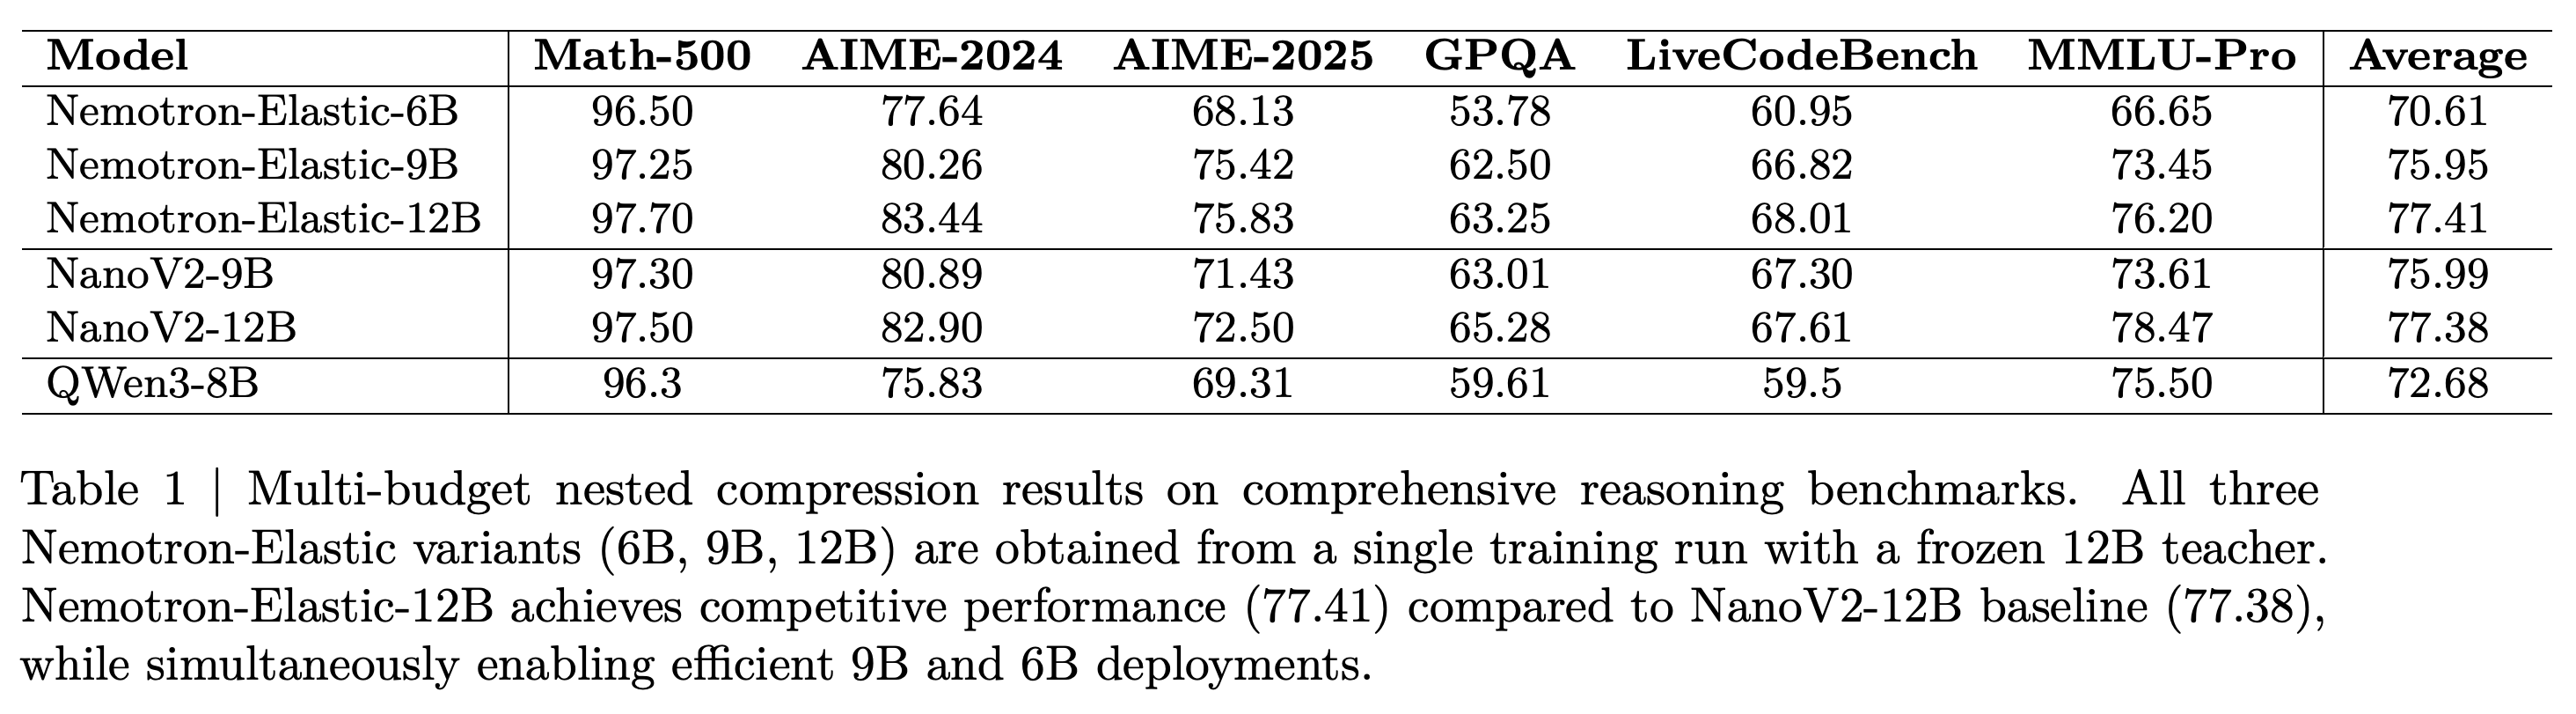
평균 점수는 같은 크기의 NanoV2 기준 모델과 거의 일치하지만 평균만으로는 과제별 상충관계를 알기 어렵다. Elastic-12B는 AIME-2025에서 75.83으로 비교 점수 72.50보다 높고, MMLU-Pro에서는 76.20으로 비교 점수 78.47보다 낮다. 이 표에는 같은 크기의 독립적인 6B 기준 모델이 없다.
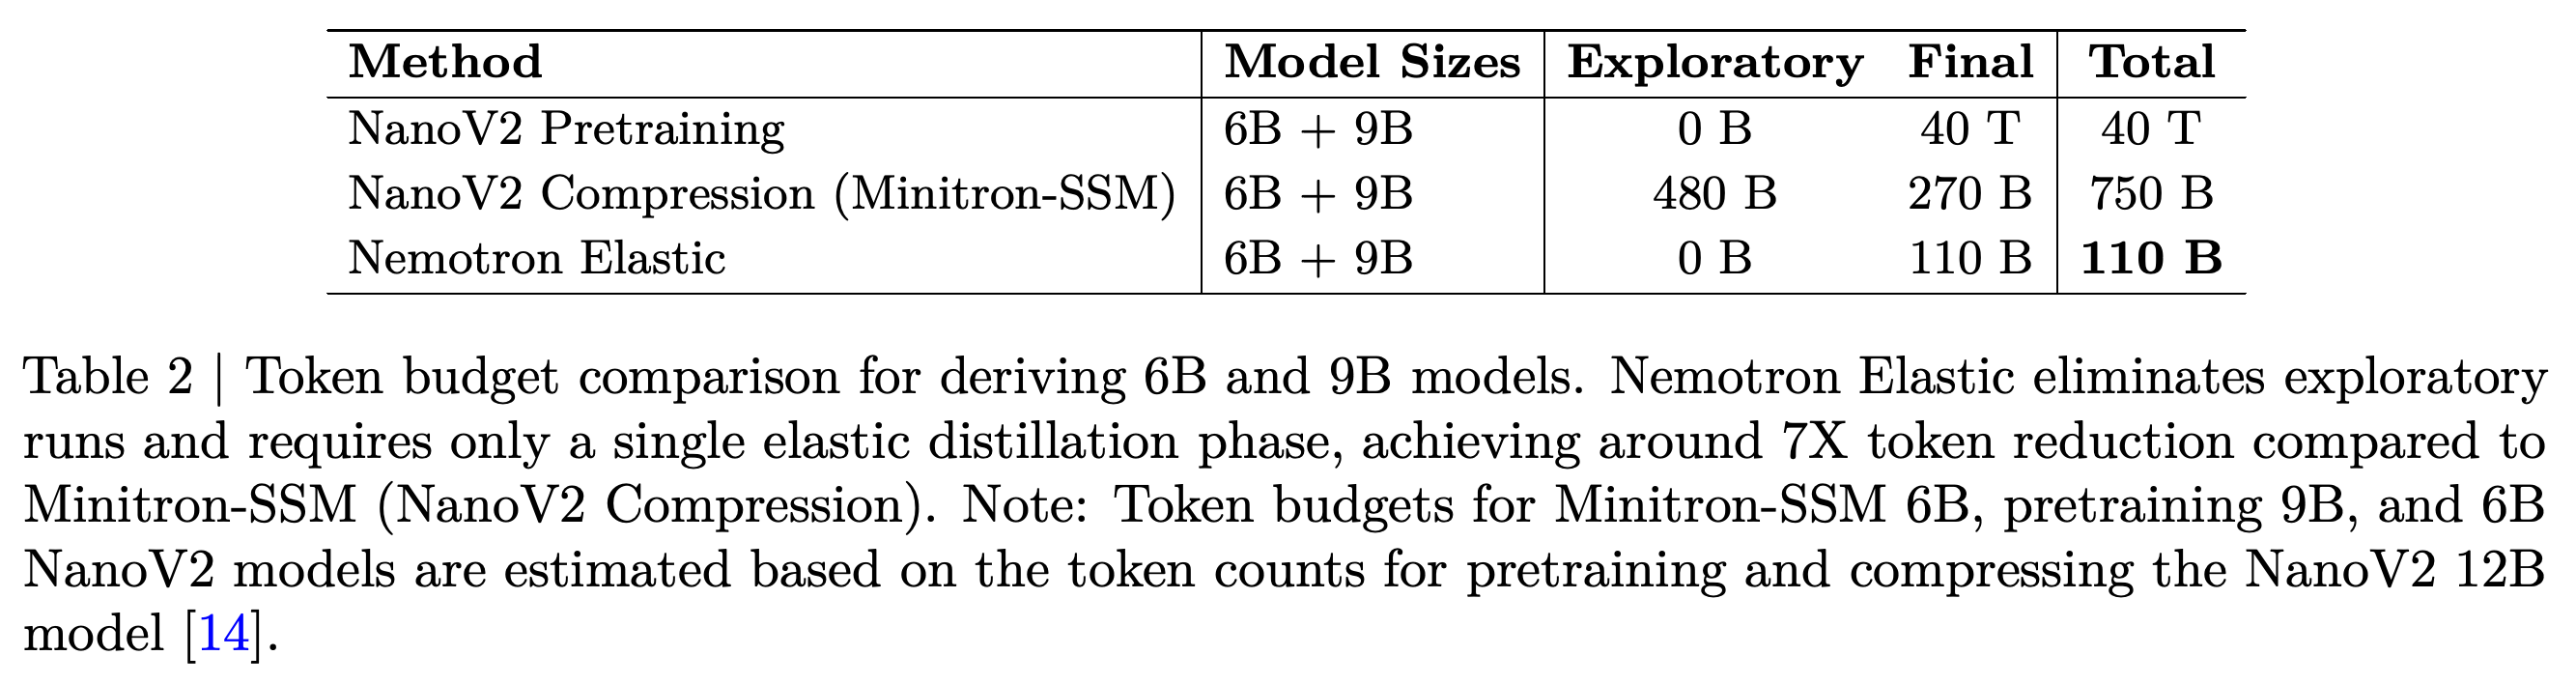
별도의 탐색 실행을 제거하면 보고된 모델군 생성용 토큰 예산이 순차 압축의 750B에서 elastic 학습의 110B로 줄어든다. 사전 학습 예산인 40T와의 비교 및 압축 비교의 일부에는 추정치를 사용한다. 따라서 이 표는 토큰 사용량을 비교하며 하드웨어 비용을 측정한 결과는 아니다.
중첩 저장은 가장 큰 모델의 BF16 가중치 용량인 24 GB 안에 3개 파라미터 예산을 담는다. NanoV2 모델 2개를 별도로 저장하면 42 GB가 필요하다. 이 비교는 모델 가중치에 관한 것이며 동시 서빙 시의 전체 메모리를 정량적으로 다루지 않는다.
Results
Table 1에서 Nemotron-Elastic-6B, 9B, 12B의 평균 점수는 각각 70.61, 75.95, 77.41이다. 9B 모델은 NanoV2-9B의 평균 75.99와, 12B 모델은 NanoV2-12B의 평균 77.38과 거의 일치한다. 다만 벤치마크별로 점수가 오르거나 내려간다.
- Elastic-9B는 AIME-2025에서 75.42로 NanoV2-9B의 71.43보다 높지만 나머지 5개 벤치마크에서는 점수가 조금 낮다. Elastic-12B는 수학과 코딩 점수가 높아지는 반면 GPQA와 MMLU-Pro에서는 NanoV2-12B보다 낮다.
- Table 2는 학습 토큰 예산을 비교한다. elastic 학습은 110B이며, 순차 압축은 탐색 과정의 480B와 최종 과정의 270B를 합쳐 총 750B이고, 사전 학습은 40T다. 캡션은 그룹 구조를 고려한 hybrid 모델 가지치기 및 증류 기준 모델인 Minitron-SSM의 6B 예산과 NanoV2 6B/9B 사전 학습 예산이 추정치임을 밝힌다.
- Table 3은 6B + 9B + 12B가 공유하는 BF16 가중치의 24 GB와 9B + 12B NanoV2 가중치를 별도로 저장하는 데 필요한 42 GB를 비교하며 43% 감소를 보고한다. 라우터 오버헤드는 가장 큰 모델 크기의 2% 미만이라고 설명한다. 표는 실행 중 캐시와 활성값을 정량적으로 다루지 않는다.
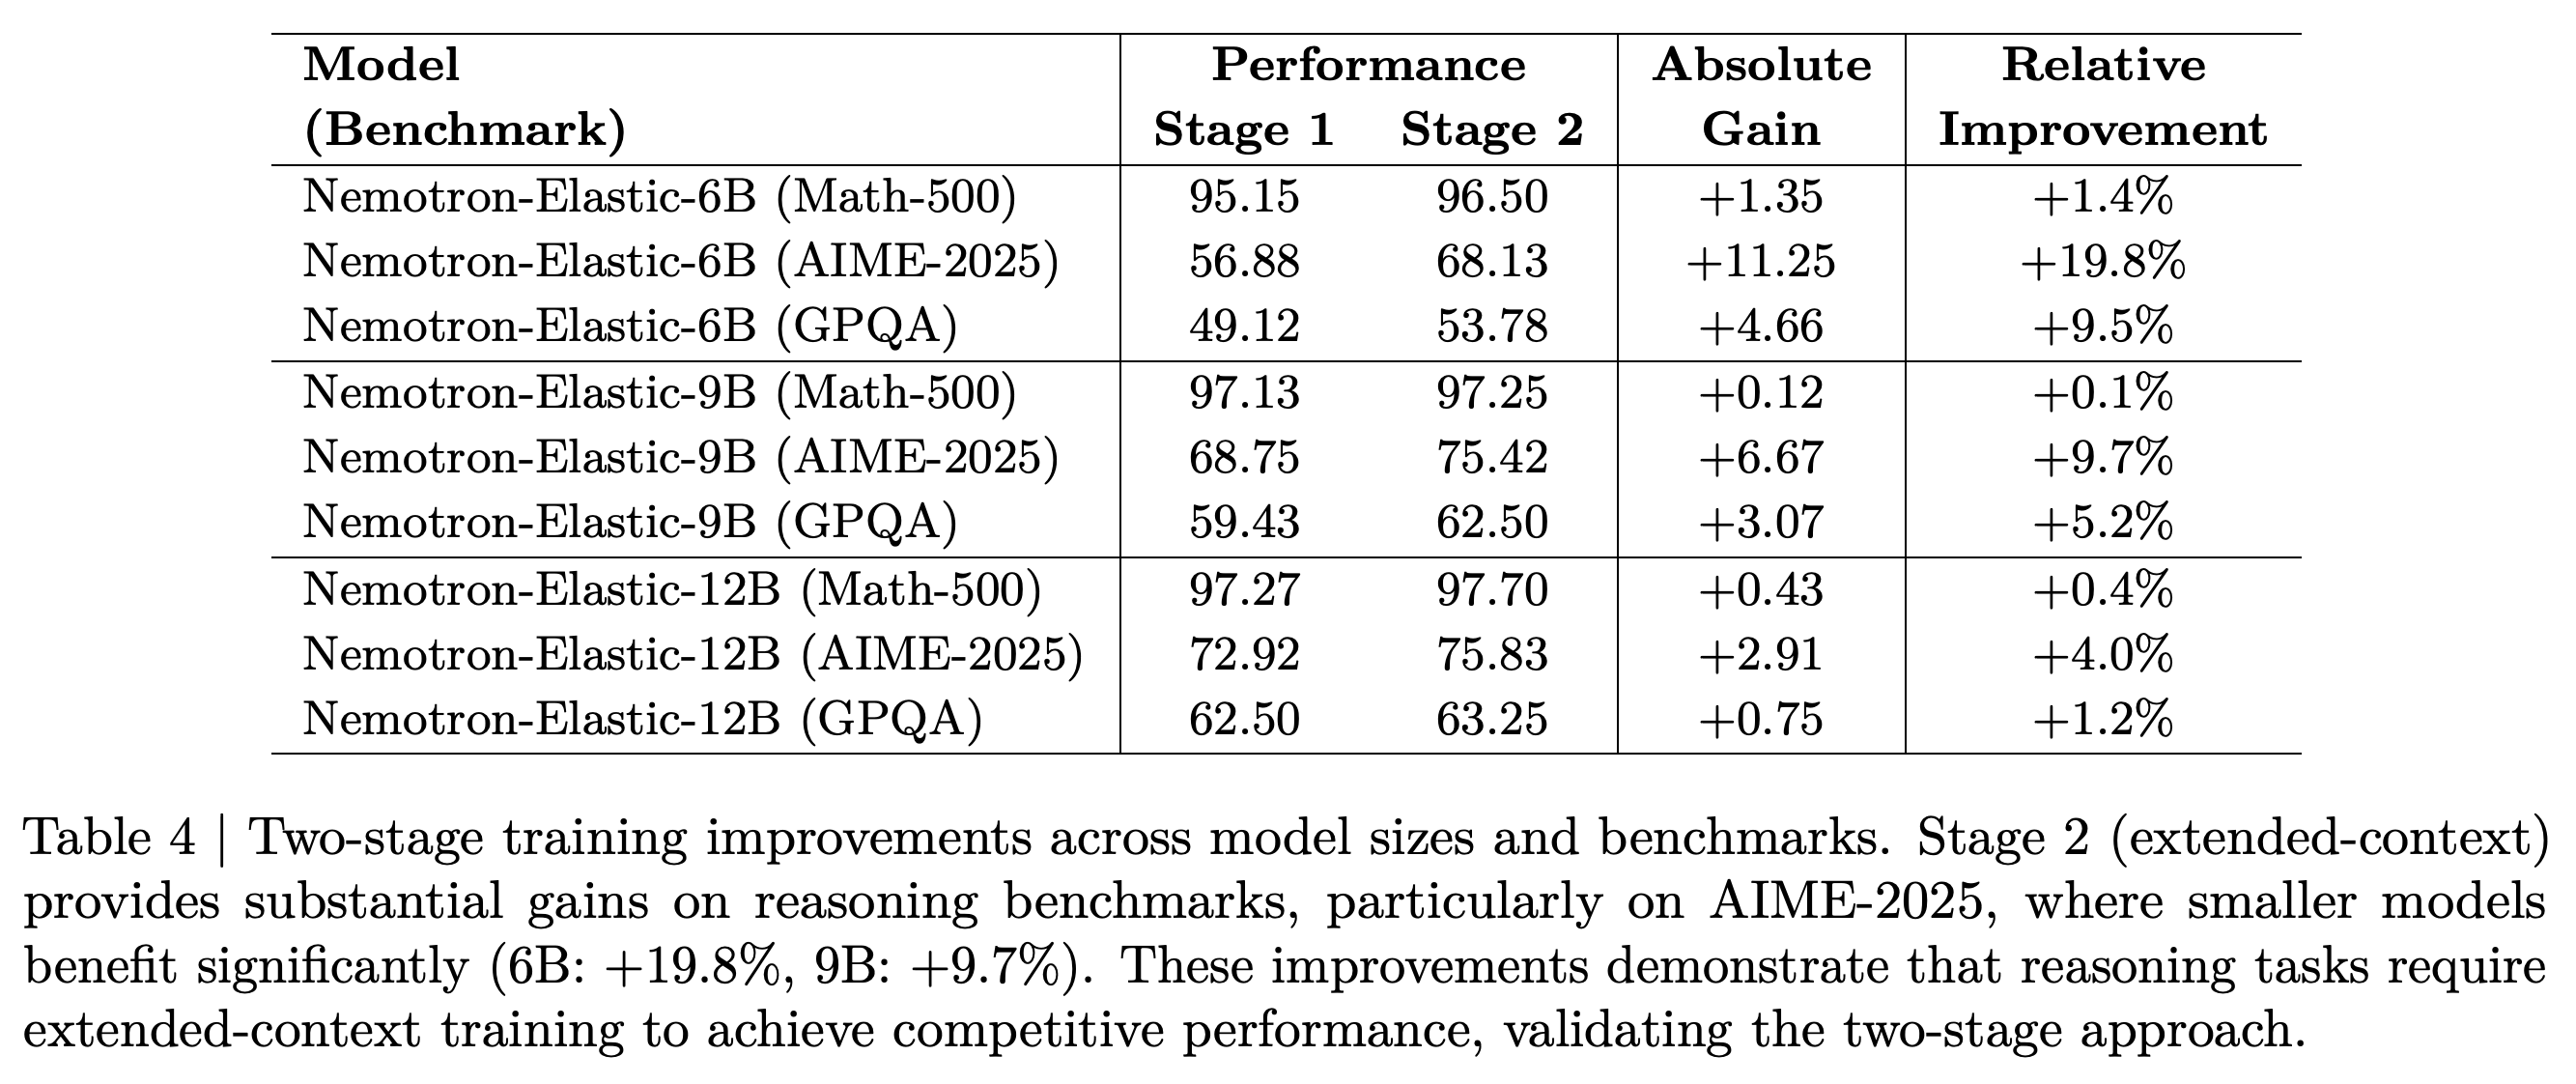
2번째 단계의 상대적 향상 폭은 6B AIME-2025에서 19.8%로 가장 크며, 이는 11.25%포인트에 해당한다. 나열된 모든 설정에서 성능이 향상되지만 학습 토큰 수와 문맥 길이가 함께 늘어난다.
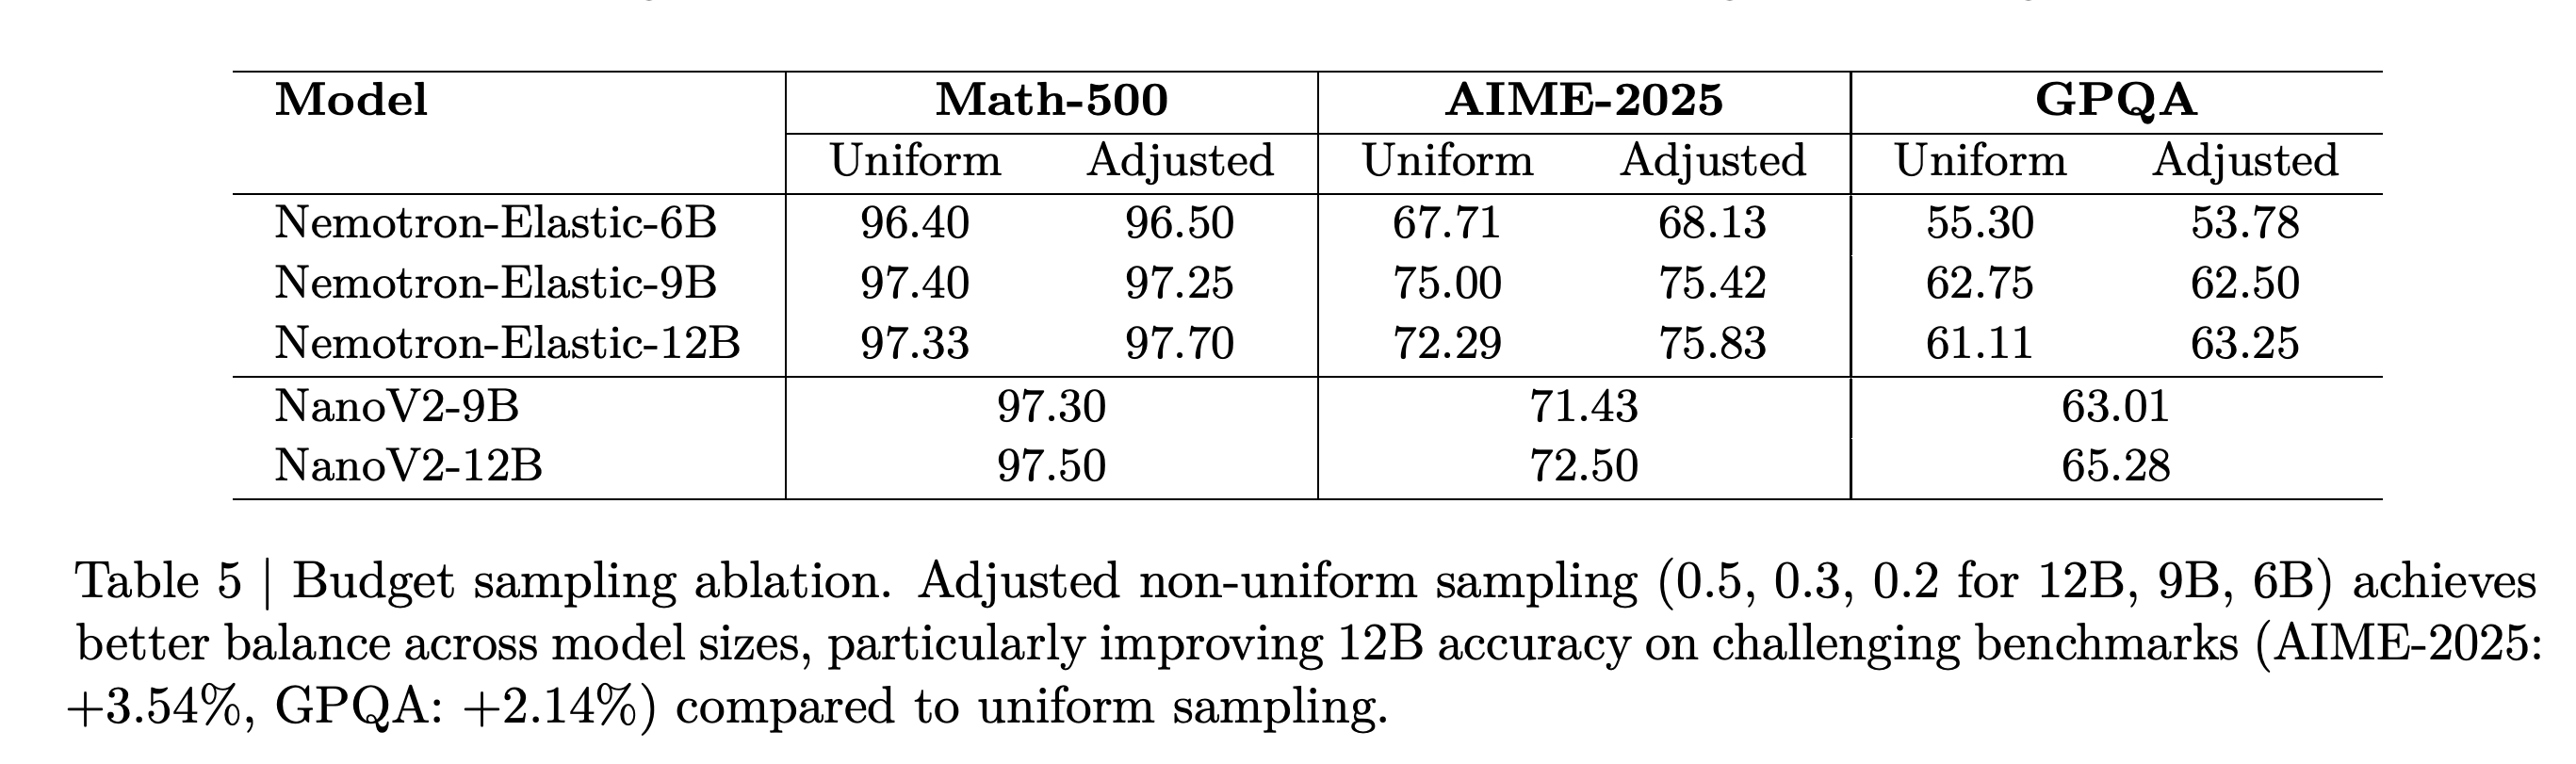
12B 샘플을 우선하면 해당 모델의 AIME-2025와 GPQA 점수가 각각 3.54와 2.14%포인트 높아진다. 동시에 6B의 GPQA 점수는 1.52 points만큼 낮아진다. 이는 조정된 분포가 공유 예산 사이에서 품질을 재배분함을 보여준다.
Effects of Two-Stage Training
Table 4에서 긴 문맥 학습 단계는 6B의 AIME-2025 정확도를 56.88에서 68.13으로 높인다. 이는 11.25-percentage-point 증가이며 상대적으로는 19.8% 향상이다. 9B와 12B의 해당 증가 폭은 각각 6.67과 2.91 points이다. MATH-500에서는 증가 폭이 더 작고, GPQA에서도 점수가 높아진다.
- 이 결과는 해당 설정에서 2번째 학습 단계가 유용함을 뒷받침한다. 다만 이 단계에서 약 45B 학습 토큰도 추가되므로, 이 비교만으로 문맥 길이의 효과와 추가 최적화의 효과를 분리할 수는 없다.
- Table 5에서 샘플링을 조정하면 12B의 AIME-2025 점수는 72.29에서 75.83으로, GPQA 점수는 61.11에서 63.25로 높아진다. 증가 폭은 각각 3.54와 2.14%포인트다.
- 이 조정에는 작은 모델의 성능 저하도 따른다. 6B의 GPQA 점수는 55.30에서 53.78로 낮아지고, 9B의 MATH-500과 GPQA 점수도 조금 낮아진다. 결과는 전체 예산 모델의 품질을 우선하는 대신 일부 작은 예산의 과제에서는 성능이 떨어짐을 보여준다.
Related Work
논문은 Nemotron Elastic을 목표 크기마다 따로 성능을 복구하는 가지치기 및 증류 방법, 상태 공간 처리와 attention을 결합한 hybrid SSM-Transformer 모델, MatFormer, Flextron, MatMamba 같은 중첩 아키텍처와 비교한다. 제안하는 차별점은 hybrid 구조의 제약, 추론을 위한 긴 문맥 학습, 예산을 조건으로 하는 아키텍처 선택의 end-to-end 학습을 결합한다는 데 있다.
- MatFormer는 중첩 Transformer 모델과 부분 네트워크 선택을 위한 휴리스틱인 MixnMatch를 사용한다. Flextron은 입력에 적응하는 라우팅을 도입하고 MatMamba는 중첩된 하위 블록을 Mamba로 확장한다. 논문은 조건부 파라미터 로딩을 사용하는 중첩 모델의 배포 사례로 Gemma 3n도 인용한다.
- 추론 학습에 관한 논의는 아키텍처 압축을 프롬프팅 및 추론 기록을 활용한 강화학습과 비교한다. 주요 결과는 인용한 모든 elastic 아키텍처와 통제된 비교를 제공하지 않으며 긴 문맥 학습이 추론 모델에만 특별히 필요하다는 점도 입증하지 않는다.
Conclusions
실험으로 확인한 결과는 110B 토큰의 공동 학습을 거친 elastic 체크포인트 1개에서 6B/9B/12B 추론 모델군을 추출할 수 있다는 것이다. 결론은 긴 문맥 적응과 가중치를 공유하는 배포를 강조한다. 더 큰 모델군, 과제별 아키텍처 선택, 추론 시점의 동적 라우팅, 파라미터를 낮은 정밀도로 저장하는 양자화를 향후 연구 방향으로 제시한다.
부록
- 제공된 17페이지 PDF에는 부록이 없으며 Acknowledgments와 References로 끝난다. 첫 페이지의 모델 링크는 https://huggingface.co/nvidia/Nemotron-Elastic-12B이며, 논문 식별자는 arXiv:2511.16664v1이다.
짧은 생각
가장 강한 근거는 1회 학습 실행으로 3개 크기를 모두 얻으면서 9B와 12B의 평균 정확도를 거의 유지했다는 결과와, 가중치를 공유했을 때의 저장 용량 비교다. 샘플링 비교 실험은 실용적인 상충관계를 보여준다. 가장 큰 모델의 품질을 보호하면 일부 과제에서 작은 모델의 점수가 낮아질 수 있다. 보고된 토큰 절감은 일부 추정된 비교 대상 예산에 의존하며 이미 사전 학습된 부모 모델의 비용은 제외한다. 이는 모델군을 만드는 데 필요한 토큰 예산을 비교한 것으로, 전체 계산량이나 금전적 절감액을 측정한 결과는 아니다. 평가는 12B 부모 모델군 1개와 3개 예산을 대상으로 하며, 불확실성 구간이나 서빙 지연 시간은 보고하지 않는다. 더 큰 모델군에서도 토큰 수를 일정하게 유지할 수 있다는 주장은 이 설정을 넘어선 외삽이다. 논문은 정규화된 MSE를 이용한 깊이 순위와 이질적 너비 선택을 설명하지만 각 기여를 따로 측정하는 정량적 제거 실험은 제공하지 않는다. 따라서 각 요소의 효과를 전체 학습 방식에서 분리할 수 없다.