


On the Interplay of Pre-Training, Mid-Training, and RL on Reasoning Language Models 요약 설명
08 Dec 2025 | Paper Review Reasoning Reinforcement Learning LLM Pretraining Reward Design목차
- 요약
- 1 Introduction
- 2 Preliminaries
- 3 When Does Post-Training Incentivize Reasoning Beyond the Base Model?
- 4 How Does Pre-training Exposure Shape Post-Training Generalization?
- 5 How Does Mid-Training Interact with Post-Training?
- 6 Mitigating Reward Hacking via Process Supervision in Outcome Rewards
- 7 Related Work
- 8 Conclusion
- 부록
- 짧은 생각
이번 글에서는 On the Interplay of Pre-Training, Mid-Training, and RL on Reasoning Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 8일(Arxiv)
- Zhang, Charlie, Neubig, Graham, Yue, Xiang.
- Carnegie Mellon University, Language Technologies Institute
- 논문 링크
- Github
요약
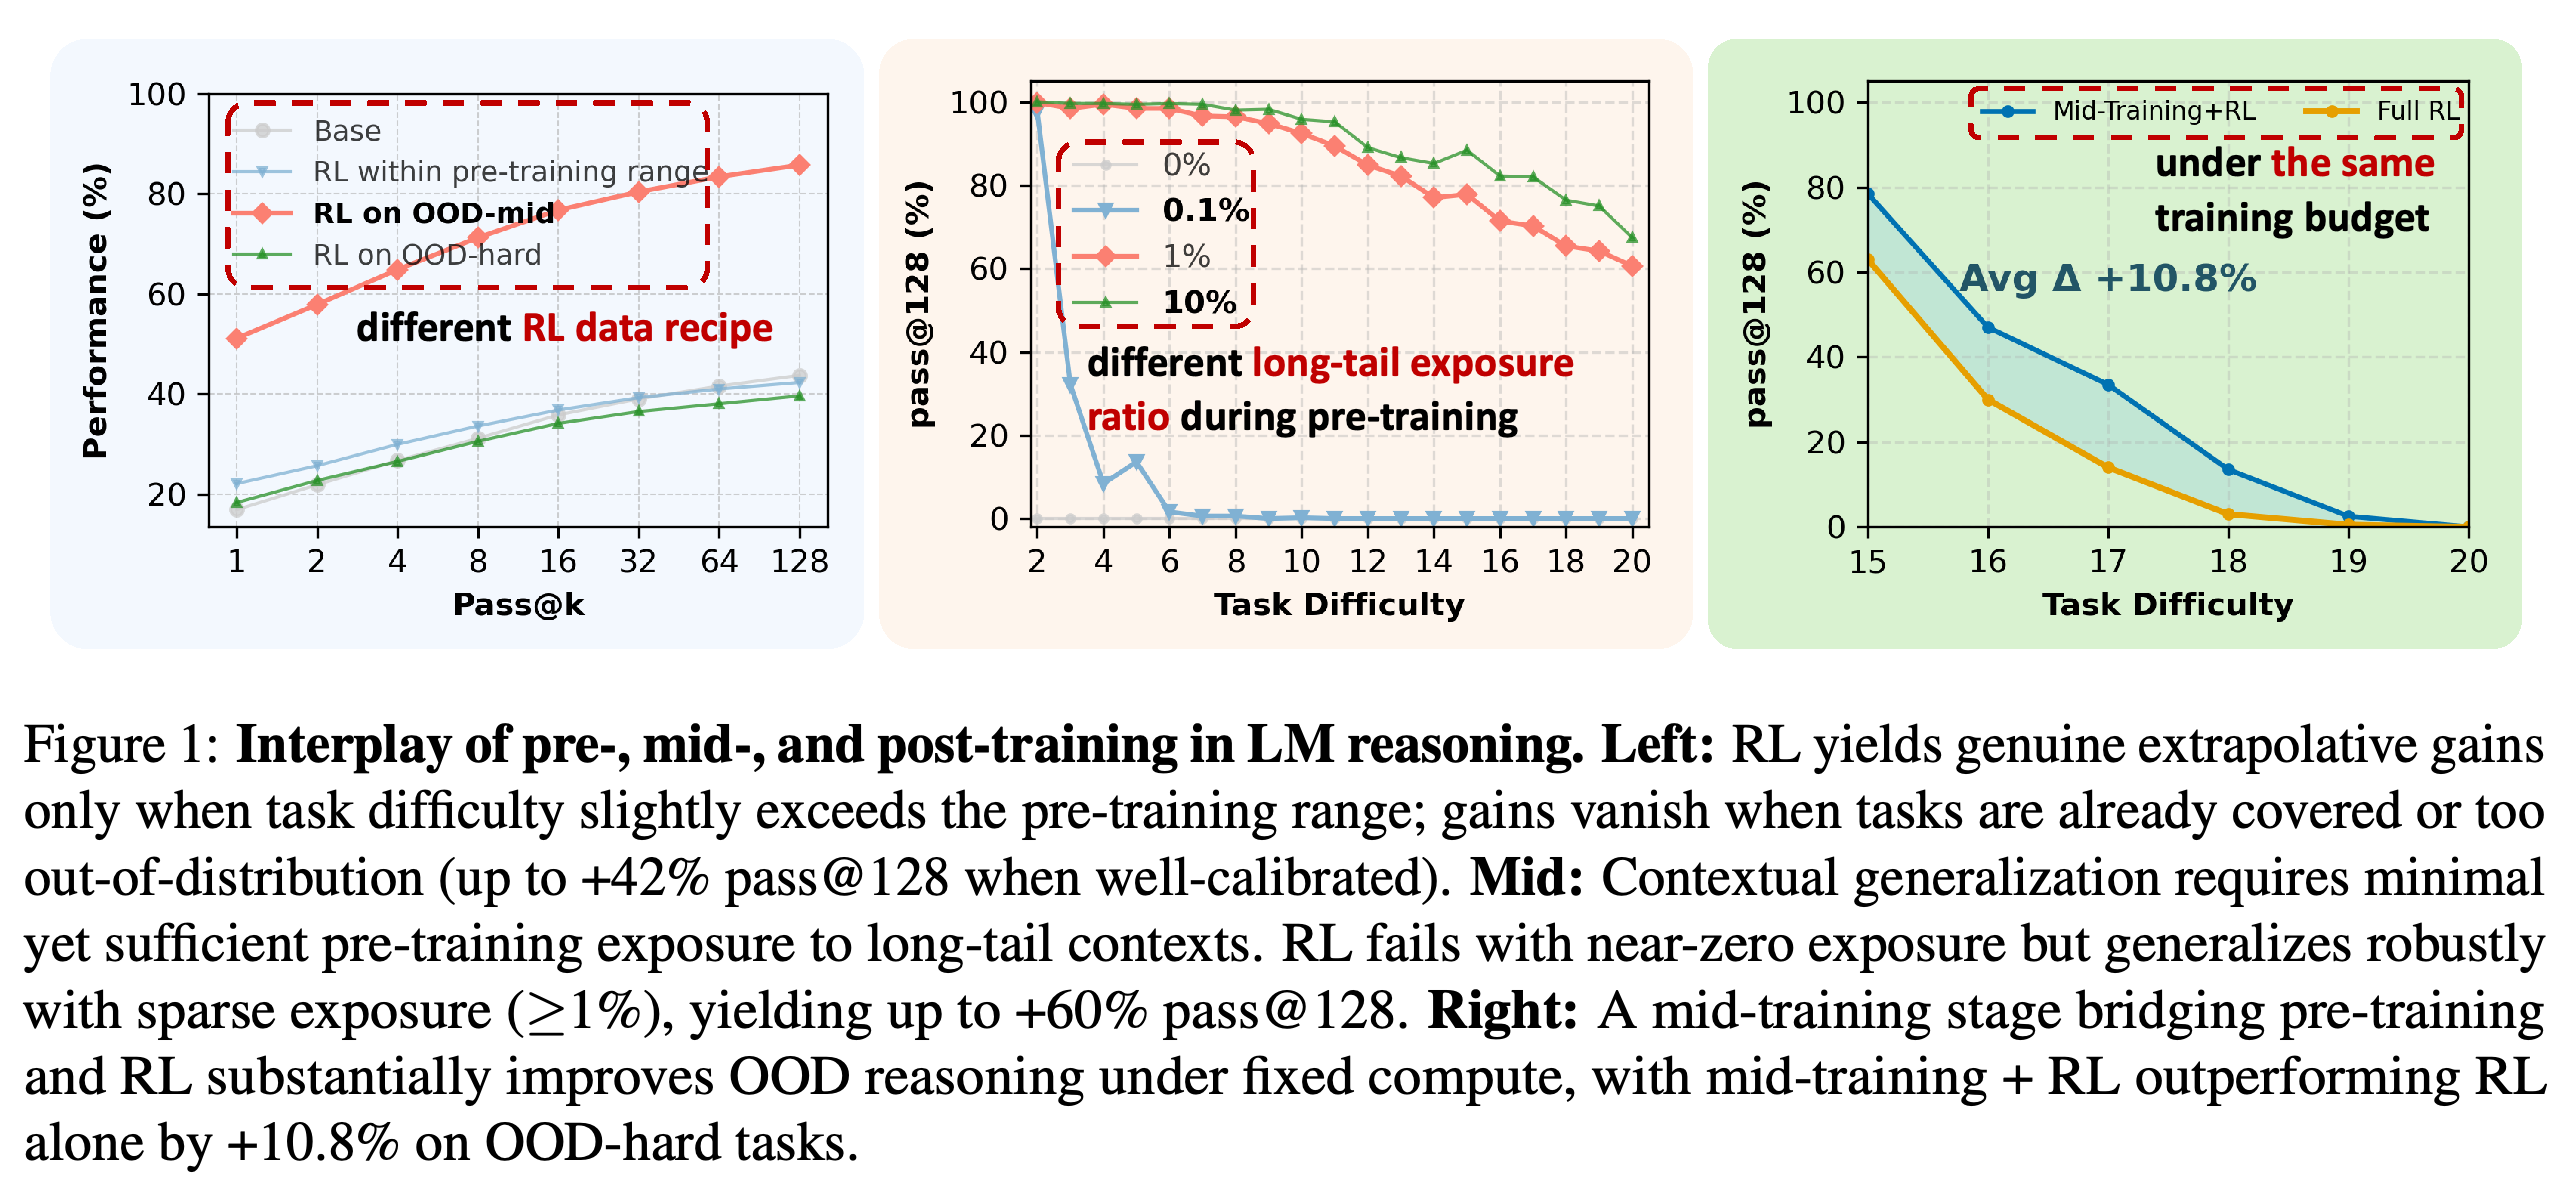
- 이 논문은 보상으로 학습하는 강화학습(RL)이 언제 언어 모델이 사전학습에서 배운 범위를 넘어서는 추론 문제를 풀도록 돕는지 살펴본다. 통제된 합성 산술 실험에서 RL 학습 대상을 모델이 간혹 풀 수 있는 능력의 경계에 맞추면, 어려운 문제의 pass@128이 기본 모델보다 높아진다. pass@128은 128개 표본 중 검증을 통과한 풀이가 적어도 1개 나오는 성공률이다. 이미 숙달한 문제나 지나치게 어려운 문제로 학습하면 이 지표는 거의 개선되지 않는다.
- 실험에서는 논문에 명시된 decoder-only 구조를 사용하는 100M-parameter Qwen2.5 방식의 모델을 10B 합성 토큰으로 처음부터 학습하고 산술 복잡도와 서술 맥락을 독립적으로 조절한다. 과정 검증 평가는 모든 기준 추론 단계와 최종 답이 정확해야 통과하므로, 보고된 성능 향상은 최종 답의 정확도만으로 평가한 결과보다 엄격한 기준을 따른다.
- 서로 다른 서술 맥락으로 추론을 전이하는 맥락 일반화에는 목표 맥락의 기초 과제를 사전학습에서 충분히 접하는 과정이 필요하다. 목표 맥락의 예시를 연산 2개짜리 문제로 제한했을 때, 사전학습 비중이 0%와 0.1%이면 복잡한 문제로 전이하지 못한다. 반면 1%와 10%이면 동일한 RL 학습 이후 상당한 성능을 보인다.
- Mid-training은 사전학습과 RL 사이에 지도학습 방식의 토큰 예측을 추가하는 단계이며 주어진 학습 예산으로 어떤 과제의 성능을 높일지에 영향을 준다. 지도학습 비중을 높이면 학습 범위에 가까운 과제에 유리하고 지도학습 단계를 줄인 뒤 RL 비중을 높이면 더 어려운 미학습 과제에 유리하다. 도입부 개요에서는 사전학습 연산 범위를 크게 벗어난 OOD-hard 과제에서 mid-training과 RL을 결합하면 RL만 적용한 경우보다 평균 pass@128이 +10.8% 높다고 보고한다. 부록 실험에서는 유리한 예산 배분이 총 연산량에 따라서도 달라진다.
- 중간 추론 단계의 정확성에 보상을 주는 과정 지도는 실험한 보상 비교에서 검증 정확도를 높이고 구조적 오류를 줄인다. 연산 15–20개짜리 문제에서는 결과 보상 0.2와 과정 보상 0.8을 결합하면 결과 보상만 사용한 RL보다 pass@1이 5.6%에서 9.9%로, pass@128이 23.2%에서 27.7%로 높아진다. pass@1은 풀이를 1개 표본 추출했을 때 검증을 통과하는 성공률이다.
패널 3개는 많은 표본을 추출했을 때의 성능 향상이 RL 과제 난도에 달려 있고, 복잡한 맥락 전이가 기초 예시의 사전학습 노출량에 달려 있으며 보고된 고정 예산에서 혼합 배분이 어려운 과제의 성능을 높인다는 결과를 요약한다. +10.8% 비교는 OOD-hard 난도 전반의 평균이며 모든 난도에서 같은 폭으로 개선되었다는 뜻은 아니다.
1 Introduction
논문은 RL의 추론 효과에 관한 연구 결과가 엇갈리는 이유 중 하나로 불투명한 사전학습 말뭉치를 지목한다. 연구자는 기본 모델이 이미 어떤 추론 기본 요소를 갖추었는지 신뢰성 있게 파악하기 어렵다. 추론 기본 요소는 조합하여 더 긴 풀이를 구성하는 기초 능력이다. 논문은 3가지 학습 단계의 데이터 분포를 통제하고 더 깊은 조합과 표면 맥락을 넘나드는 전이를 함께 살펴본다.
- 명시적인 산술 연산, 관찰 가능한 추론 과정, 체계적인 분포 변화를 결합하여 각 학습 단계의 효과를 분리한다.
- 도입부는 개선 여지, RL 과제 난도, 관련 기본 요소의 사전학습 범위, 중간 단계 지도라는 4가지 요인의 상호작용을 제시한다.
2 Preliminaries
기초 설명에서는 합성 데이터 생성기, 2가지 일반화 축, 추론 과정과 답을 함께 확인하는 평가 절차를 제시한다. 이 구성은 검증에 필요한 기준 계산을 유지하면서 문제 복잡도의 변화와 서술 맥락의 변화를 분리한다.
2.1 Controllable Synthetic Reasoning Dataset
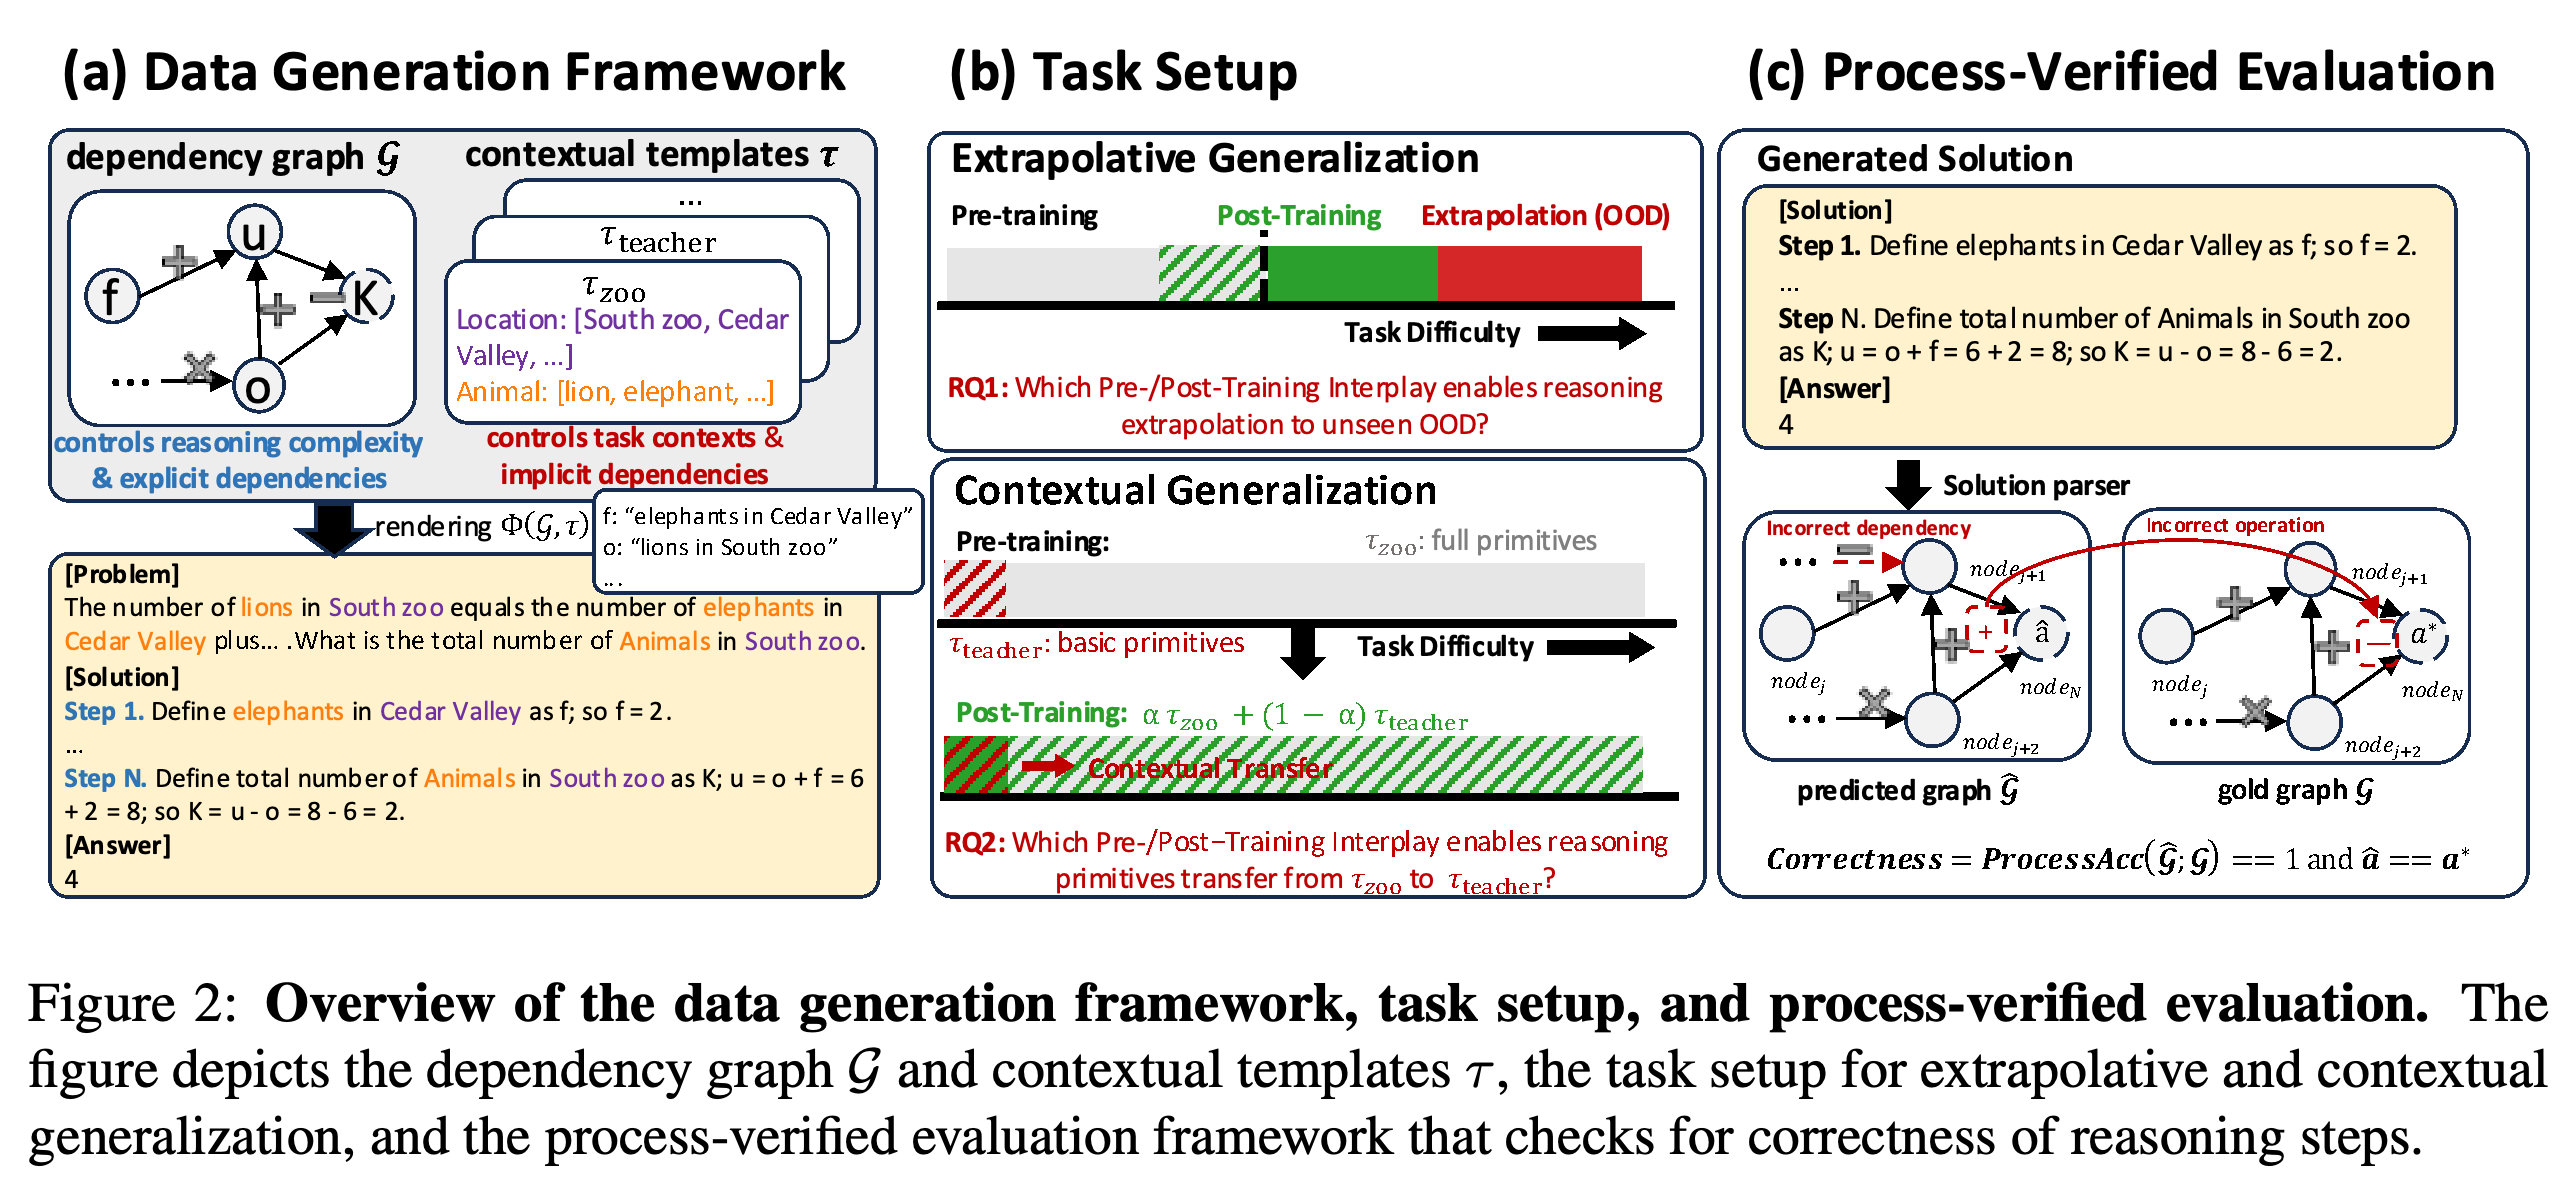
데이터셋은 추론 복잡도를 통제하여 산술 문장제를 생성하는 프레임워크인 GSM-Infinite를 기반으로 한다. 각 예시는 방향성 순환이 없는 의존성 그래프인 방향성 비순환 그래프(DAG)에서 생성한다. 노드는 수량을 나타내고, 간선은 해당 수량을 계산하는 데 필요한 의존 관계를 나타낸다.
- 논문은 연산 복잡도를 \(\operatorname{op}(\mathcal{G})=|\mathcal{E}|\)로 정의한다. E는 그래프의 간선 집합이며 op는 과제 난도를 조절하는 연산 수를 뜻한다.
- animals–zoo와 teachers–school 같은 맥락 템플릿은 그래프의 변수와 의존 관계를 자연어로 표현한다. 수치 할당, 그래프 구조, 언어적 맥락은 각각 별도로 통제한다.
- 서로 겹치지 않는 데이터 분할과 기준 그래프를 통해 데이터 오염을 통제하고 중간 단계를 검증한다. 정확한 중복 제거 방법은 A.1.5에 제시한다.
그래프 구조와 맥락 표현을 분리하면 기준 계산을 유지하면서 복잡도와 서술을 바꿀 수 있다. 평가 패널은 최종 답의 정확성만으로 충분하지 않은 이유를 보여준다. 의존 관계나 산술 단계가 틀리면 생성된 풀이는 검증에 실패한다.
2.2 Task Setup
외삽적 깊이 일반화(Extrapolative (Depth) Generalization)는 학습에서 접한 것보다 긴 연산 사슬의 정확도를 측정한다. 맥락적 폭 일반화(Contextual (Breadth) Generalization)는 내부 계산 구조가 동등한 문제에서 추론이 다른 서술 템플릿으로 전이되는지 측정한다.
- 깊이 실험에서는 학습 단계별 연산 범위를 바꾼다. 맥락 실험에서는 자주 등장하는 템플릿과 학습 데이터에서 비중이 낮은 롱테일 템플릿의 노출량을 바꾼다.
- A.2는 학습 그래프를 템플릿 간에 의도적으로 대응시키지 않고 무작위로 표본 추출한다고 명시한다. 따라서 동등한 구조가 모든 학습 맥락에 등장하는 것은 아니다.
2.3 Evaluation Protocol.
평가기는 생성된 풀이를 예측 의존성 그래프와 최종 답으로 파싱한다. 각 기준 노드에 대해 해당 노드의 존재 여부, 의존 관계, 수치가 정확한지 확인한다. 과정 정확도는 각 단계의 정확성 지표를 평균한 값이다.
- 과정 정확도가 1이고 최종 답이 기준 답과 일치할 때만 풀이 전체를 정답으로 인정한다. 보고된 모든 pass@k 결과는 k개 표본 중 검증을 통과한 풀이가 적어도 1개 나오는 성공률이며 이 기준을 사용한다.
- 최종 답이 맞더라도 기준 단계가 누락되거나 틀리면 풀이를 통과시키지 않는다. 검증은 파싱된 풀이 과정과 기준 그래프를 대상으로 한다.
2.4 Training Setup.
전체 합성 말뭉치는 30B 토큰이며 사전학습, mid-training, post-training에 서로 겹치지 않는 분할을 사용한다. 기본 설정에서는 decoder-only 구조의 100M-parameter Qwen2.5 방식의 모델을 10B 토큰으로 처음부터 학습한다. 토큰 대 파라미터 비율은 100×이며, 맥락 템플릿 전반에서 op=2–10을 다룬다.
- 사전학습은 기초 산술 능력과 조합 능력을 형성하지만 더 깊은 과제는 완전히 해결하지 못한 상태로 남긴다. 사전학습 연산 범위 안에서는 pass@128 정확도가 포화 수준에 가까워진다.
- Mid-training은 사전학습 목적함수를 유지하되, 모델의 능력이 나타나기 시작하는 과제로 데이터 분포를 좁힌다. 이 단계는 Section 5에서 도입한다.
- Post-training은 실험의 RL 최적화 알고리즘으로 선택한 GRPO를 사용하며 선별한 난도 범위와 맥락을 혼합한 데이터로 학습한다. 레이블이 있는 과제 예시로 학습하는 Supervised Fine-tuning(SFT)도 다른 post-training 전략으로 논의하지만 실험의 중심은 아니다.
3 When Does Post-Training Incentivize Reasoning Beyond the Base Model?
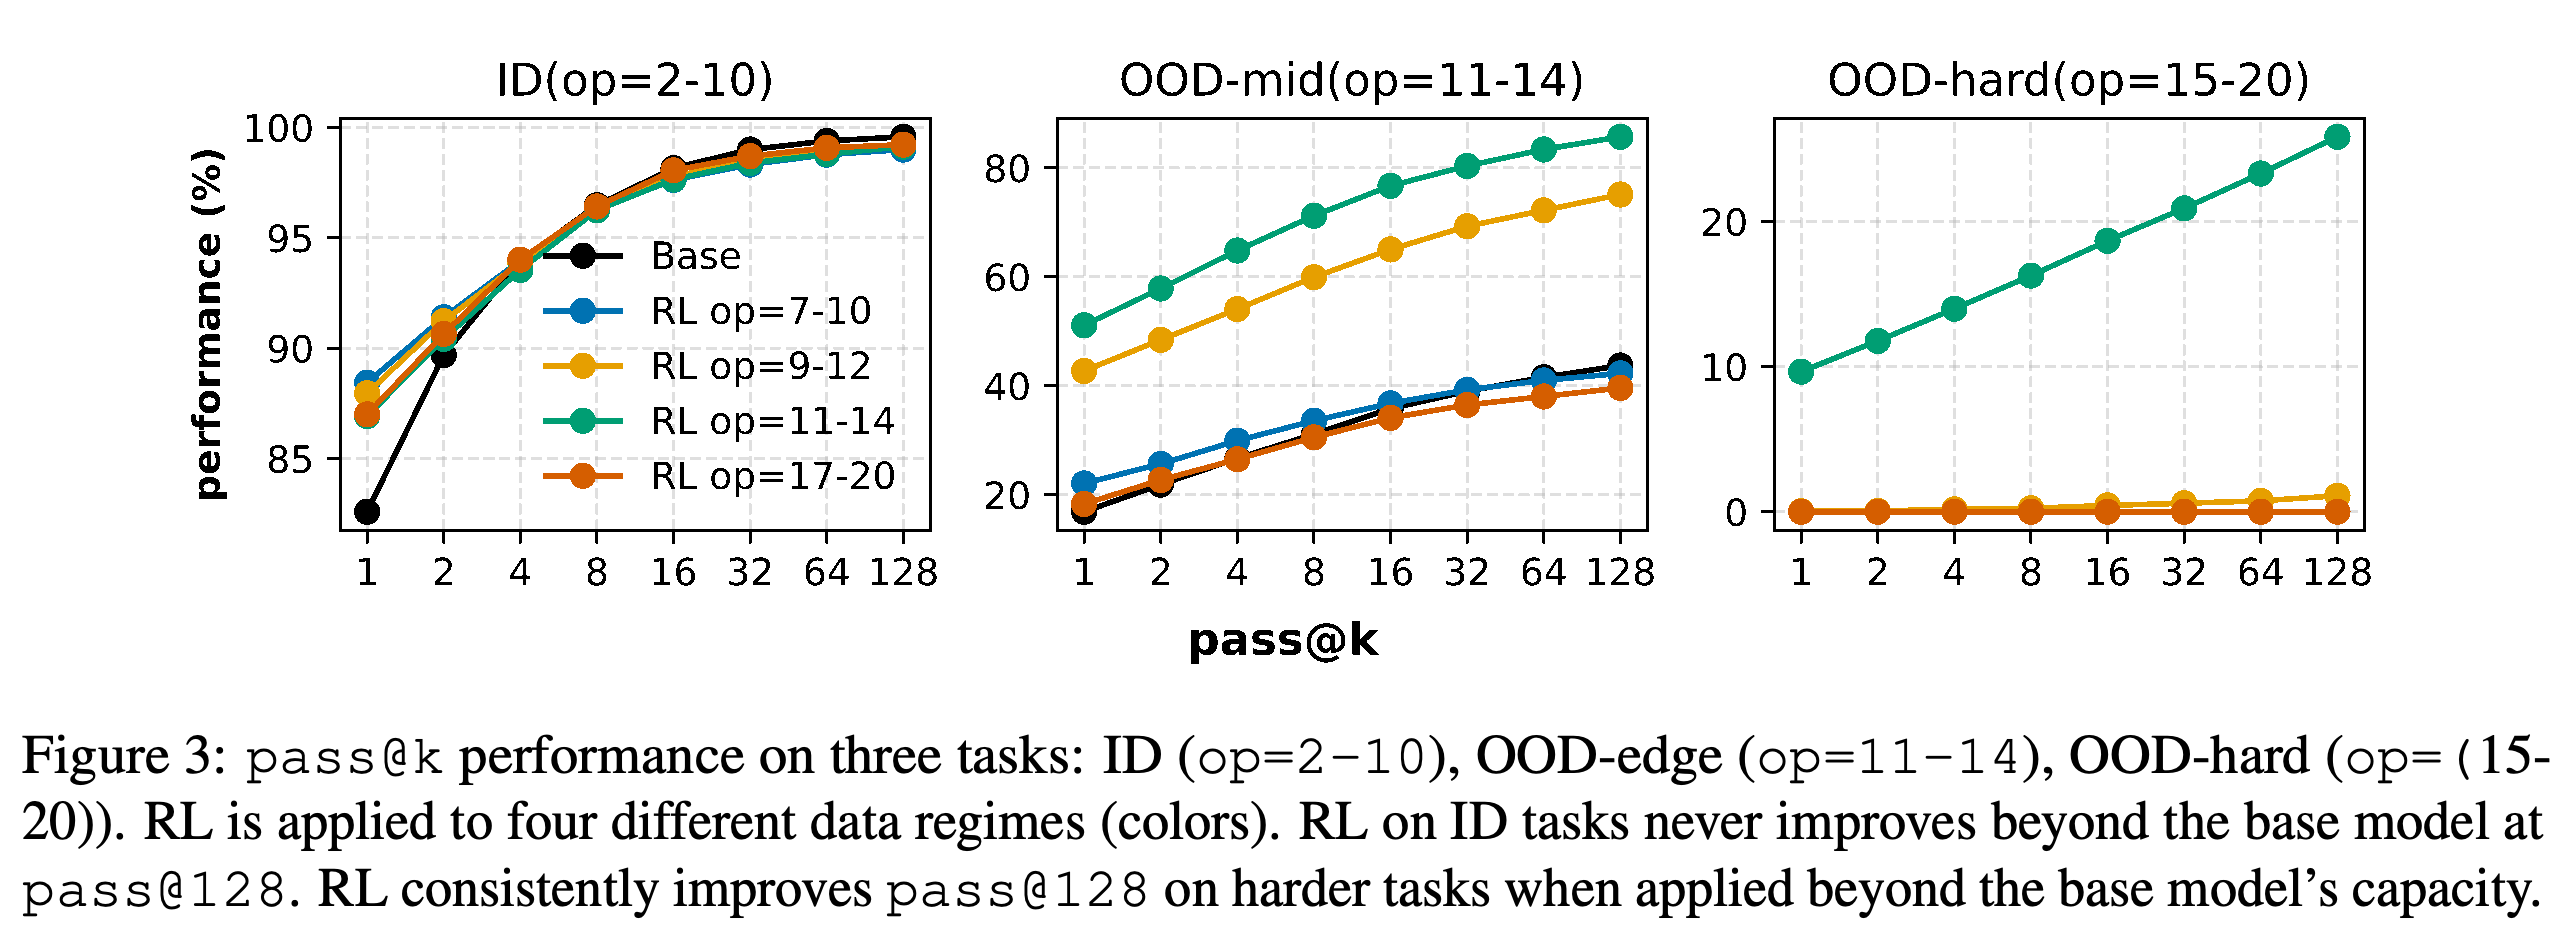
Section 3은 사전학습을 고정하고 RL 데이터의 난도를 바꾼다. 사전학습 범위 안에 있는 In-Distribution(ID)은 op=2–10이다. 범위 밖에 있는 out-of-distribution(OOD)은 기본 모델의 pass@128이 0이 아닌 op=11–14의 OOD-edge와 기본 모델 정확도가 0에 가까운 op=15–20의 OOD-hard로 나눈다.
- 본문은 op=7–10, op=9–12, op=11–14, op=17–20에서 각각 약 200K개의 RL 표본을 추출한다고 설명한다. A.9에는 표본 수가 204.8k로 기록되어 있으며 가장 쉬운 설정의 범위가 본문과 달리 op=8–10으로 제시된다.
- Observation 1에서는 실험한 RL 설정 전반에서 ID pass@1은 개선되지만 ID pass@128은 개선되지 않는다. op=11–14로 학습하면 OOD-edge와 OOD-hard의 pass@128이 모두 개선된다. op=17–20으로 직접 학습하면 어려운 과제의 성능은 0에 가깝게 유지된다.
Takeaway 1은 많은 표본을 추출했을 때 검증 성능이 향상되려면 2가지 조건이 필요하다고 설명한다. 사전학습 이후에도 개선 여지가 있어야 하며, RL 예시는 모델이 일부라도 풀 수 있어야 한다. Discussion 1은 과제 범위와 난도에 대한 이러한 의존성을 바탕으로, 능력의 정교화를 보고한 연구와 외삽 성능 향상을 보고한 연구를 함께 설명한다.
- Practical Guidance 1은 pass@1에서는 실패하지만 더 큰 pass@k에서는 성공하는 예시를 선택하라고 권고한다. 이미 해결한 쉬운 과제와 사실상 보상이 나오지 않는 과제라는 2가지 유형을 모두 피하는 방식이다.
- 저자는 능력이 향상될 때마다 이 예시 집합을 주기적으로 재평가하자고 제안한다. 이러한 적응형 커리큘럼은 권고 사항이며 Section 3에서 평가한 절차는 아니다.
RL 이후 pass@1이 개선되어도 ID 곡선은 거의 같은 높은 pass@128로 수렴한다. 제시된 결과에서 op=11–14로 학습하면 가까운 범위와 더 어려운 범위 모두에서 가장 크게 개선된다. 반면 op=17–20으로 직접 학습하면 어려운 과제의 정확도는 0에 가깝게 유지된다. 이는 학습 데이터가 부분적으로 풀 수 있는 수준이어야 한다는 조건을 뒷받침한다.
4 How Does Pre-training Exposure Shape Post-Training Generalization?
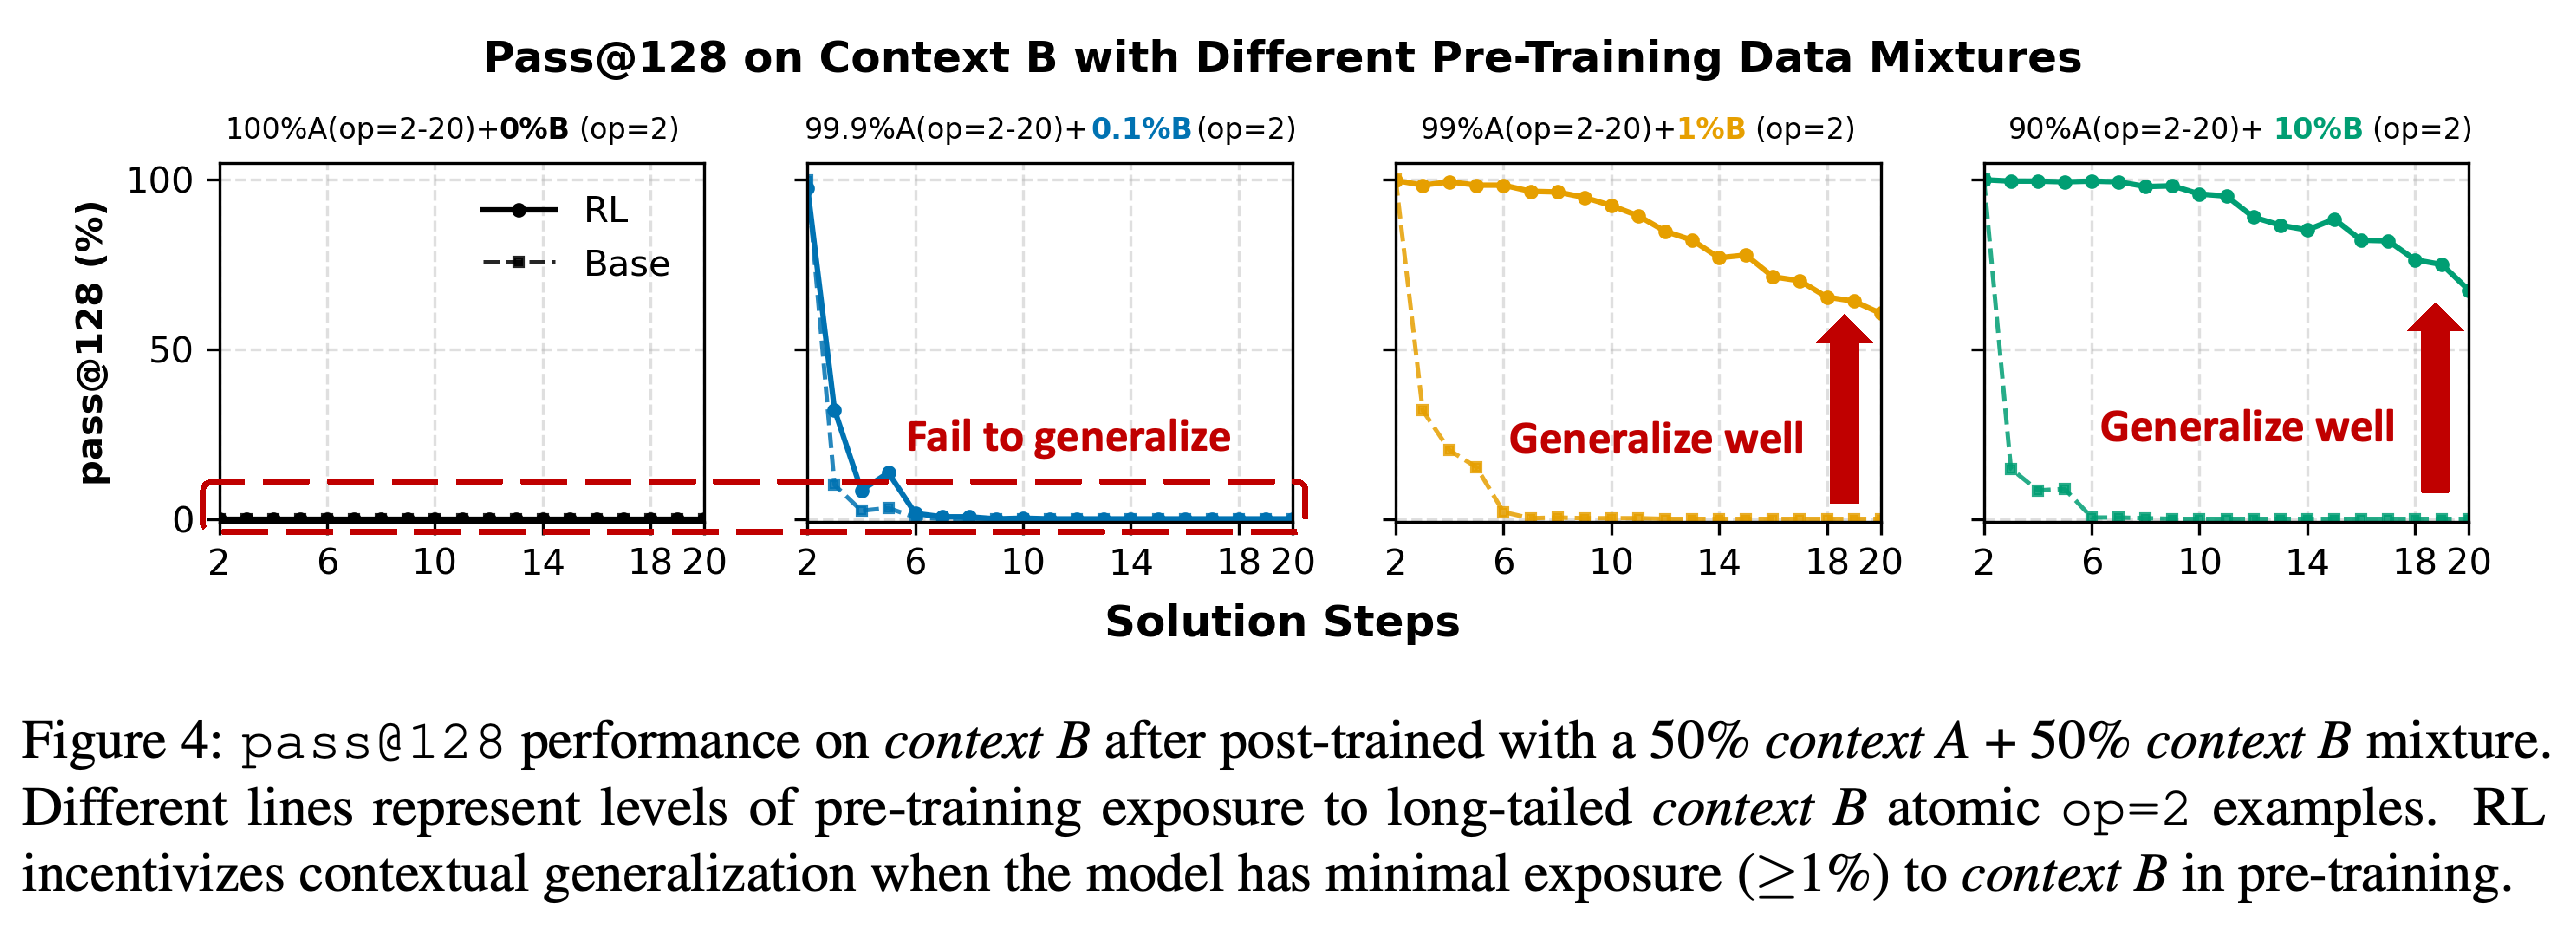
Section 4는 맥락 A의 op=2–20 문제와 op=2로 제한한 맥락 B 문제를 포함하는 10B 토큰으로 사전학습한다. 맥락 B의 사전학습 비중을 0%, 0.1%, 1%, 10%로 바꾼 뒤, 동일한 약 200K-sample RL 혼합 데이터로 학습한다. RL 데이터는 op=2–20 범위에서 맥락 A 50%와 맥락 B 50%로 구성한다.
- Observation 2에서는 맥락 B 노출량이 0%나 0.1%이면 복잡한 맥락 B 문제로 전이하지 못한다. 1%나 10%이면 RL 이후 op=20에서도 상당한 검증 정확도를 보인다.
- Takeaway 2는 목표 맥락의 기초 문제를 접하는 것이 RL이 강화할 수 있는 선행 조건이라고 해석한다. 관찰된 ≥1% 조건은 이 합성 실험 설정에 해당하며 일반적인 임계값을 확립한 결과는 아니다.
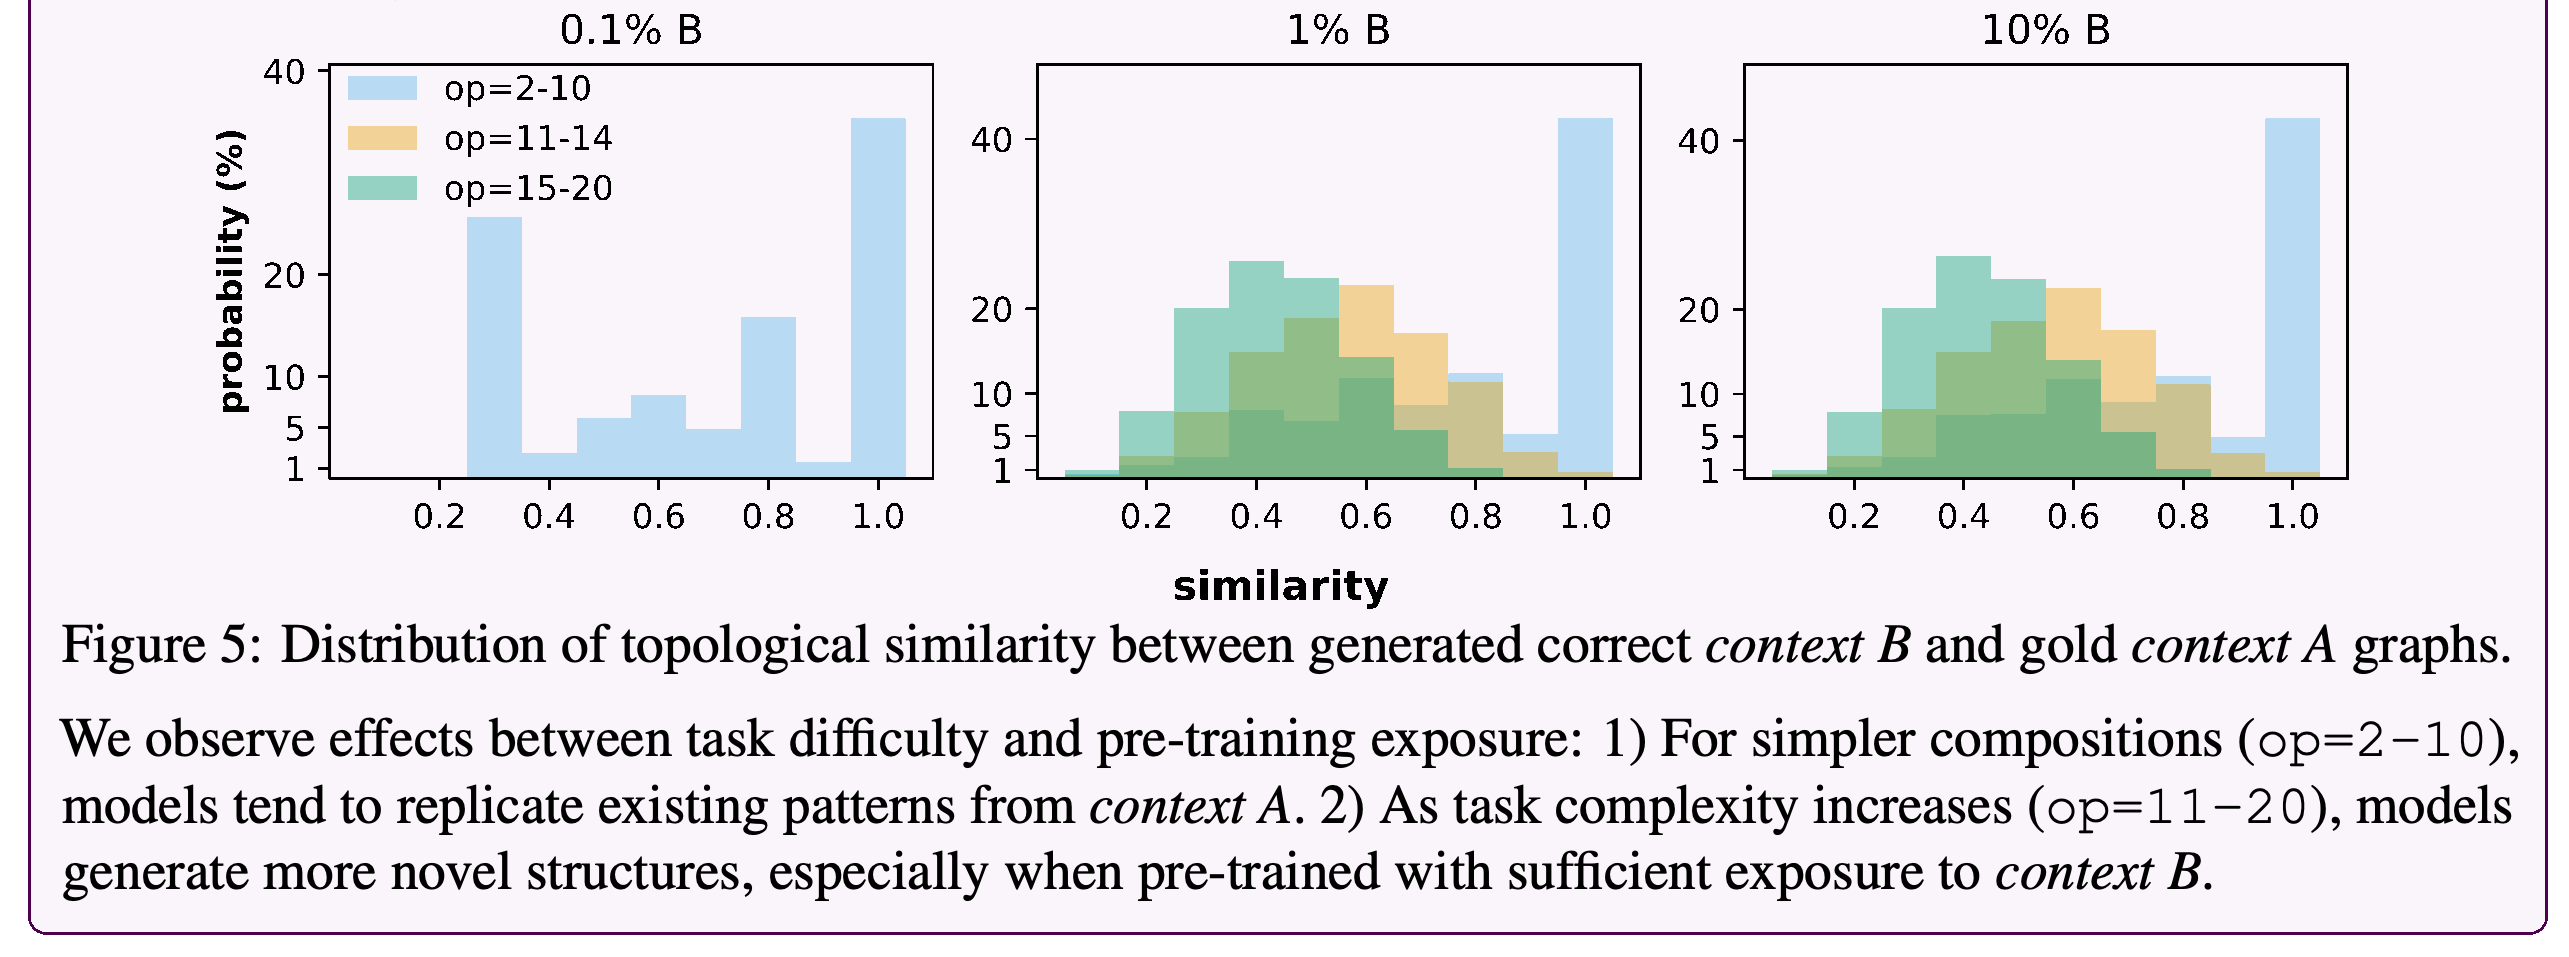
Discussion 2는 생성된 맥락 B 정답 풀이와 맥락 A 기준 그래프 사이의 위상적 유사성, 즉 의존성 그래프 구조의 유사성을 살펴본다. 간단한 풀이는 기존 맥락 A 패턴과 유사한 경우가 많다. 반면 맥락 B 노출량이 충분하면 어려운 풀이의 유사성이 더 낮아진다.
- 저자는 낮은 유사성을 더 새로운 조합의 근거로 해석한다. 이 분석은 합성 산술 프레임워크 안에서 생성된 구조를 대상으로 한다.
- Practical Guidance 2는 RL이 조합에 사용할 기본 요소를 갖추도록 사전학습에서 기초적인 롱테일 지식, 규칙, 능력을 다루라고 권고한다.
RL 혼합 데이터에서 맥락 A와 B의 비중을 같게 고정해도, 사전학습 중 기초 B 예시의 노출량에 따라 복잡한 과제의 성능이 크게 달라진다. 0%와 0.1% 조건은 더 긴 풀이에서 실패하지만 1%와 10% 조건은 연산 20개까지 상당한 pass@128을 유지한다.
5 How Does Mid-Training Interact with Post-Training?
Section 5는 산술 계산량을 학습 토큰 단위로 환산한 부동소수점 연산량의 근사치를 사용하여 지도학습 기반 mid-training과 RL을 비교한다. RL 비용은 T_RL ≈ (5/3)NrL_total이며, N은 RL 표본 수다. 롤아웃 수 r=6은 표본마다 6개의 풀이를 생성한다는 뜻이고, 전체 시퀀스 길이는 L_total=2048이다. RL 예산 비율 β에 따라 T_mid=(1−β)T와 T_RL=βT로 예산을 배분한다.
- 본문은 Full mid-training에 지도학습 토큰 1B를 사용하고 Full RL에는 배치 크기 1024로 100회 업데이트를 수행한다고 명시한다. 또한 Light-RL (β=0.2), Medium-RL (β=0.5), Heavy-RL (β=0.8)을 비교하며 모두 동일한 기본 모델과 op=11–14 적응 범위를 사용한다. 명시된 비용 공식에 따르면 Full RL 설정은 약 2.10B 환산 토큰에 해당하므로, 양 끝 설정의 예산이 일치하지 않는다.
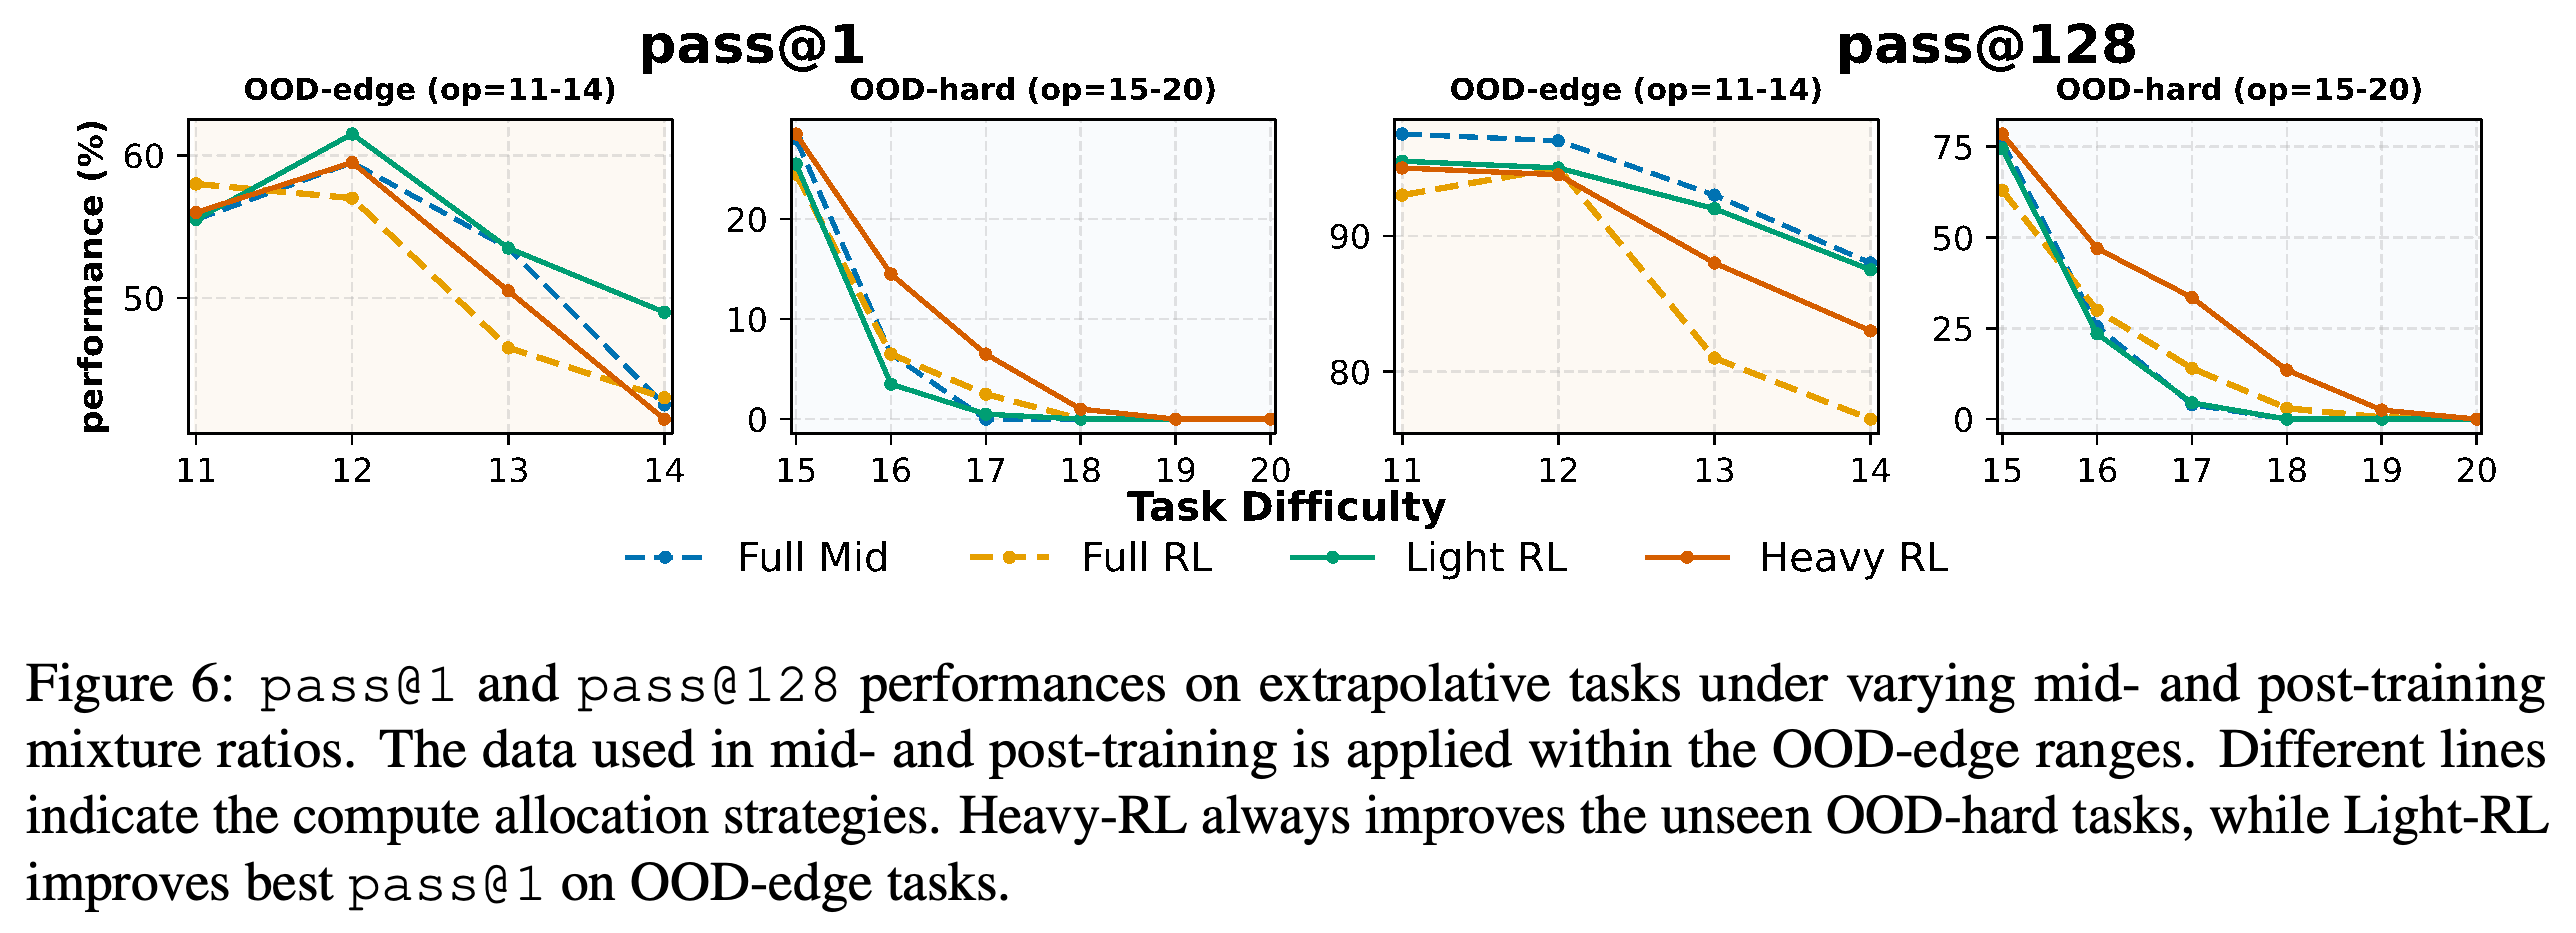
- Observation 3에서는 Full mid-training과 Light-RL이 OOD-edge 성능에 유리하며 Figure 6의 pass@1은 Light-RL이 가장 높다. Heavy-RL은 제시된 다른 배분보다 OOD-hard pass@1과 pass@128을 높인다.
- Figure 1은 동일하다고 보고된 예산에서 mid-training과 RL을 결합하면 Full RL보다 OOD-hard pass@128이 평균 +10.8% 높다고 제시한다.
B 노출량이 충분하면 어려운 정답 풀이의 그래프 유사성은 많은 간단한 풀이보다 낮은 범위에 분포한다. 이는 생성기 안에서 서로 다른 조합이 나타난다는 저자의 해석을 뒷받침한다. 다만 이 분포만으로 새로운 범용 추론 능력을 입증할 수는 없다.
Takeaway 3과 Practical Guidance 3은 목표로 하는 일반화 유형에 따라 연산량을 배분하라고 권고한다. 학습 범위에 가까운 과제의 신뢰도를 높이려면 mid-training 비중을 높이고 RL 비중을 낮추며, 복잡한 외삽을 목표로 한다면 mid-training 단계를 줄이고 RL 비중을 높인다. Discussion 3은 이 결과를 mid-training이 후속 RL 과제에 가까워지도록 학습 데이터 분포를 조정하는 연결 단계라는 기존 연구와 연결한다.
- 이 비교는 모델의 순전파와 역전파, 토큰 길이로 연산량을 추정한다. 특정 하드웨어에서 실제 실행 시간이 같다는 결과는 보고하지 않는다.
- A.10은 이 권고에 조건을 붙인다. 예산이 커지면 Full RL이 OOD-hard pass@128에서 가장 높은 성능을 낼 수 있으므로, 혼합 배분이 항상 최적은 아니다.
학습 범위에 가까운 평가와 어려운 평가 사이에서 예산 배분의 순위가 달라진다. 가까운 과제의 pass@1은 Light-RL이 가장 높고, 더 어렵고 학습에서 접하지 않은 여러 연산 수에서는 Heavy-RL이 더 높은 성능을 유지한다. 가장 어려운 연산 수에서는 제시된 모든 전략의 성능이 0에 가까워지므로, 관찰된 외삽의 범위에는 한계가 있다.
6 Mitigating Reward Hacking via Process Supervision in Outcome Rewards
Section 6은 지름길이나 잘못된 추론으로 최종 답만 맞히는 보상 해킹을 다룬다. op=11–14에서 복합 보상 R=αR_out+(1−α)R_pv로 학습한다. R_out은 최종 답의 정오를 나타내는 이진 보상이고, R_pv는 중간 단계 정확도이며 α는 가중치를 조절한다. R_pv=1일 때만 R_out을 부여하는 엄격한 보상도 실험한다.
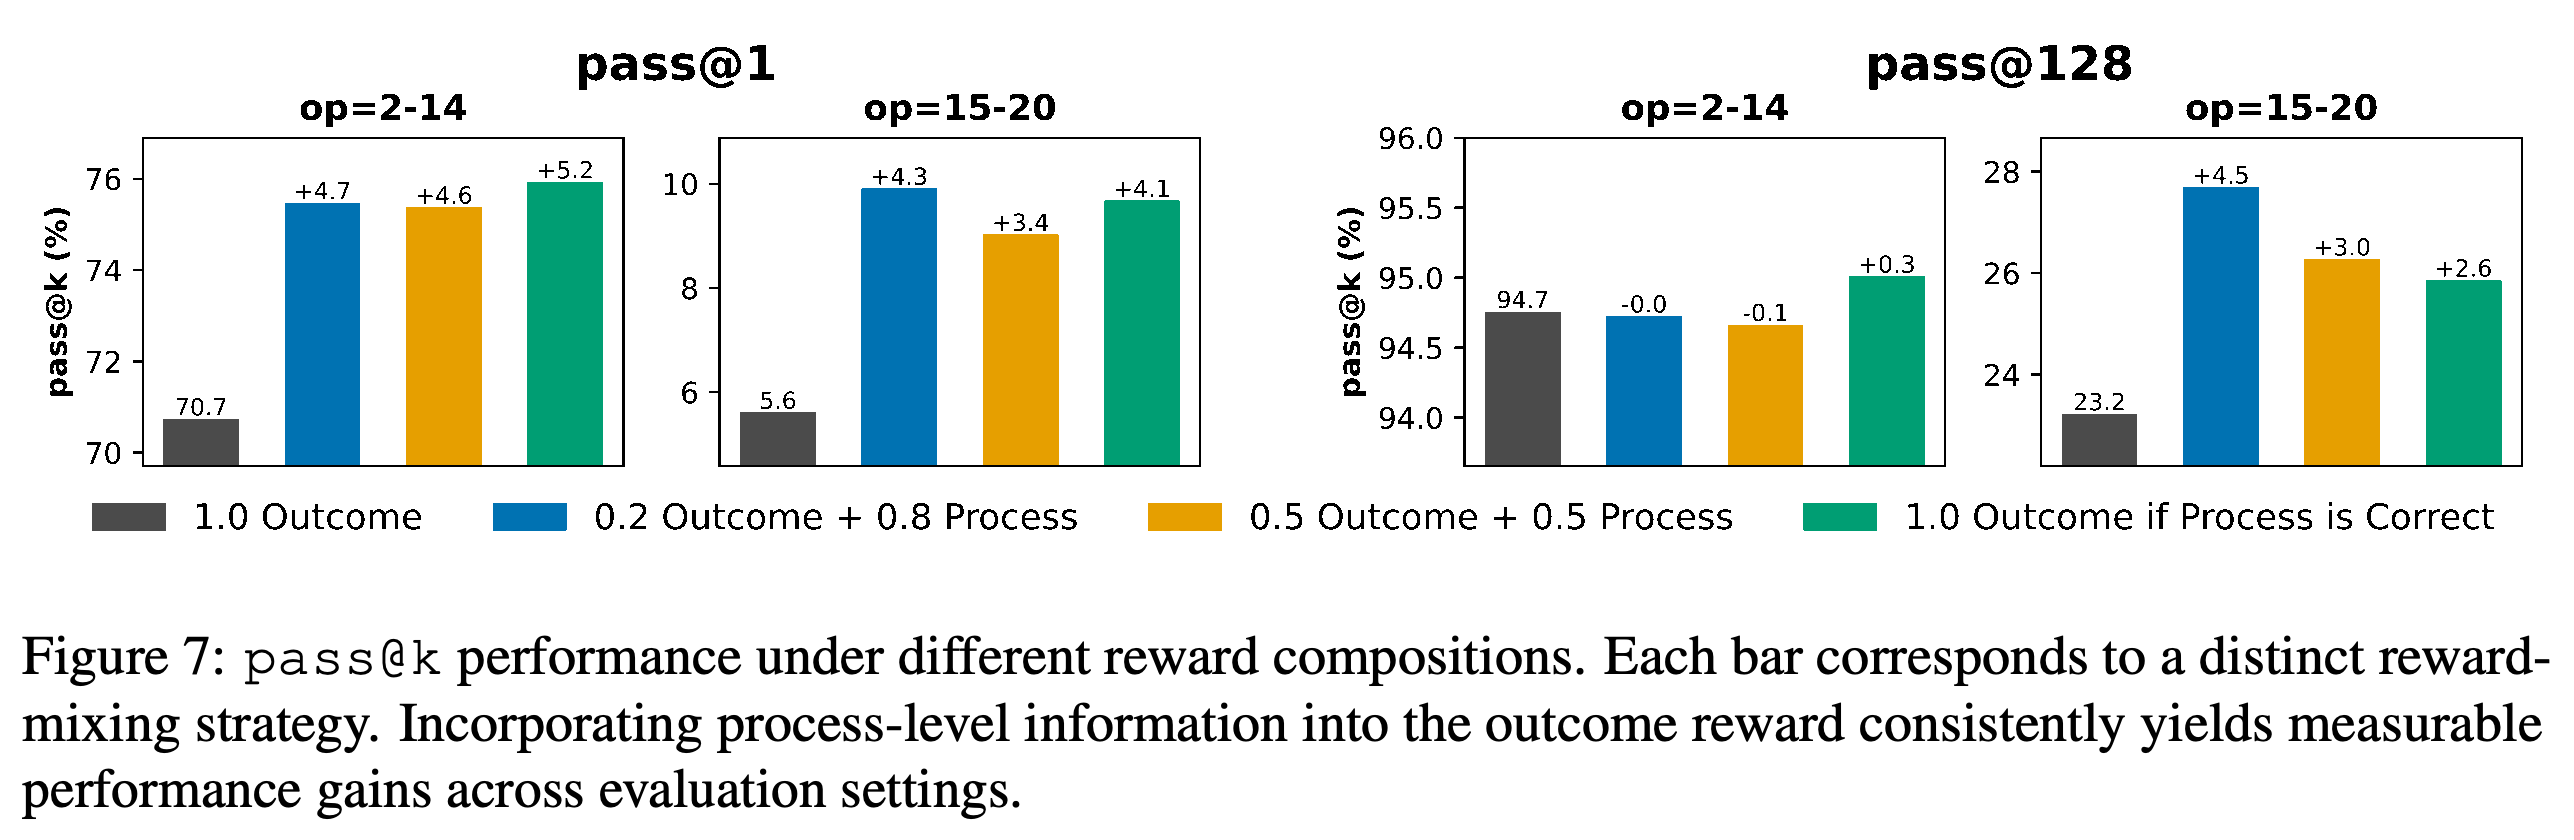
- Observation 4에서는 op=15–20에서 결과 보상 0.2 + 과정 보상 0.8의 혼합이 결과 보상만 사용한 RL보다 pass@1을 4.3%p, pass@128을 4.5 points 높인다. 엄격한 보상은 각각 4.1과 2.6 points 높인다.
- op=2–14에서는 과정을 반영하는 보상 방식이 pass@1을 4.6–5.2 points 높이는 반면, pass@128 변화는 −0.1에서 +0.3 points 범위다. 따라서 효과는 지표와 난도에 따라 다르다.
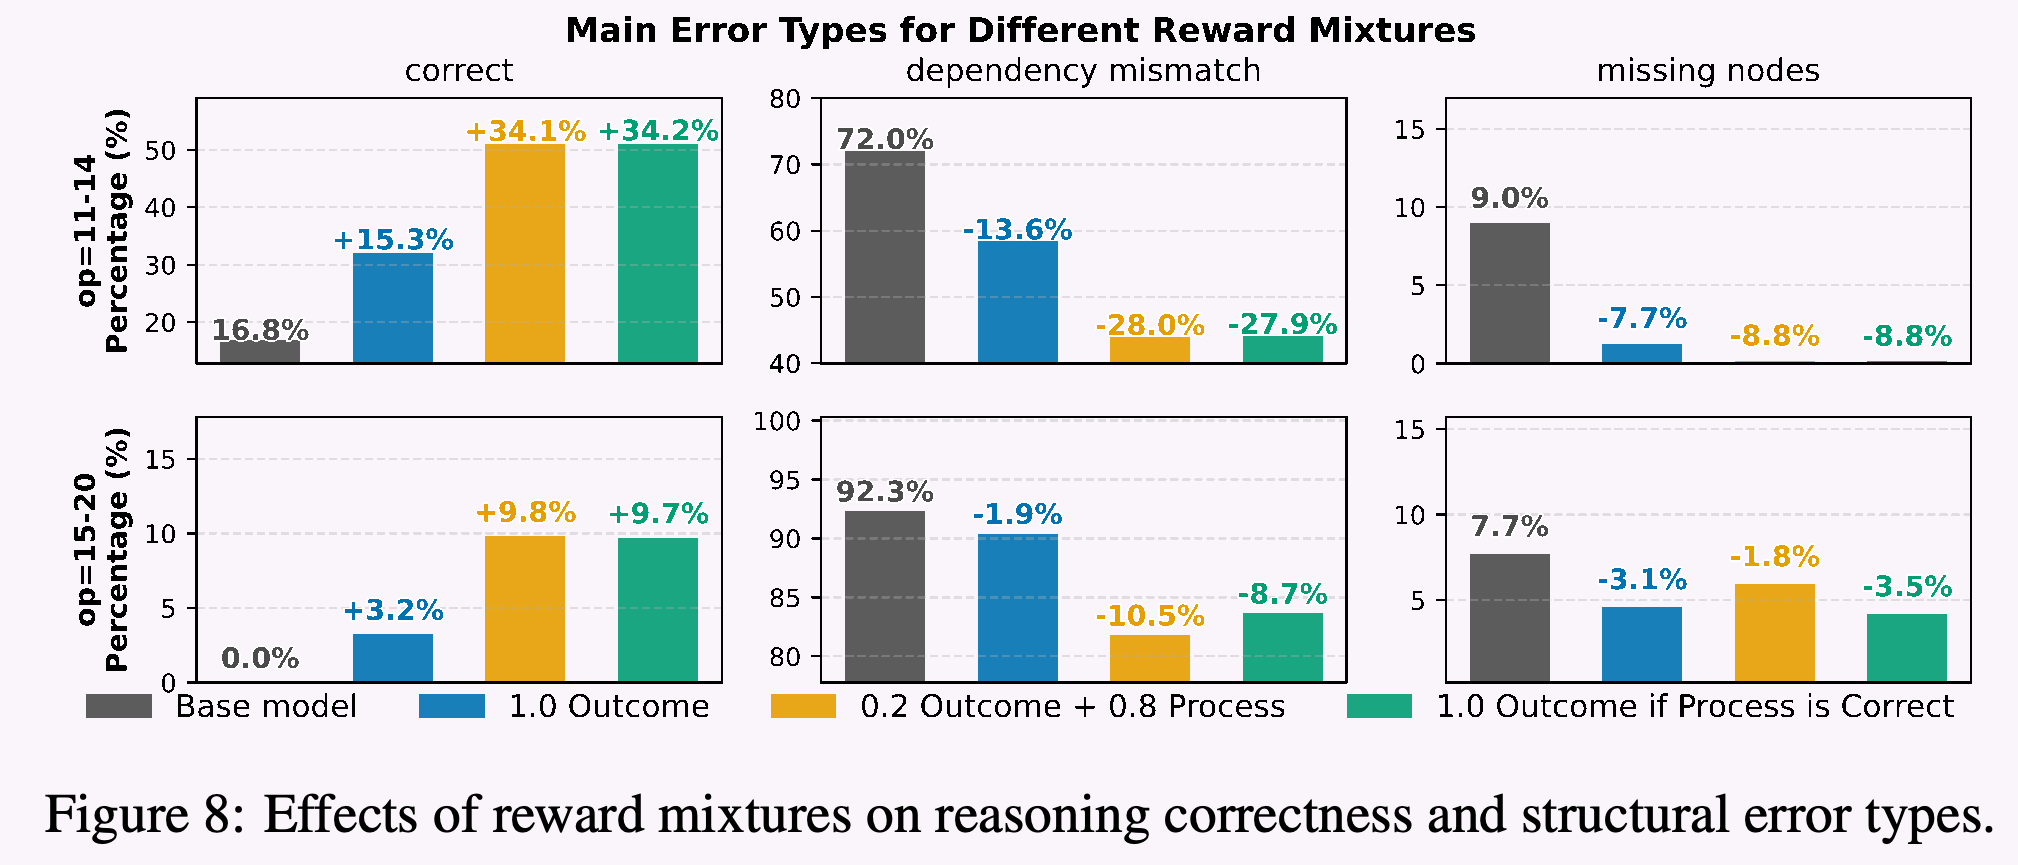
Takeaway 4는 과정을 반영하는 보상을 더 충실한 추론과 연결한다. Discussion 4는 구조적 오류 분석으로 이 해석을 뒷받침한다. 제시된 비교에서는 과정을 반영한 학습이 결과 보상만 사용한 학습보다 의존성 불일치와 노드 누락을 더 많이 줄인다. 의존성 불일치는 계산에 필요한 선행 수량의 집합이 잘못된 경우다.
- op=15–20에서 기본 모델의 의존성 불일치 비율은 92.3%다. 결과 보상 0.2 + 과정 보상 0.8의 혼합은 이를 10.5%p 줄이며 결과 보상만 사용한 RL은 1.9 points 줄인다.
- Practical Guidance 4는 과정 지도가 충분히 정확하다면 희소한 결과 피드백과 조밀한 중간 단계 피드백을 결합하라고 권고한다.
결과 보상 0.2 + 과정 보상 0.8은 어려운 과제의 pass@1을 5.6%에서 9.9%로, pass@128을 23.2%에서 27.7%로 높인다. op=2–14의 Pass@128은 거의 변하지 않는다. 따라서 그림은 지표와 평가 범위에 따라 개선 효과가 달라짐을 뒷받침한다.
7 Related Work
Related Work는 pass@k가 커지면 RL의 이점이 줄어드는 연구와 합성 과제 및 미학습 조합에서 성능 향상을 보이는 연구를 비교한다. 논문은 사전학습에서 확보한 기본 요소와 RL 데이터의 난도가 어떻게 이러한 서로 다른 결과를 만드는지 실험적으로 설명하는 데 기여한다고 제시한다.
- 통제된 언어 모델 실험과 합성 산술 생성기 연구를 바탕으로, 사전학습, 선택적인 mid-training, RL 전반으로 통제 범위를 확장한다.
제시된 비교에서 과정을 반영하는 보상 방식은 결과 보상만 사용한 RL보다 의존성 불일치와 노드 누락을 더 많이 줄인다. op=15–20에서 결과 보상 0.2 + 과정 보상 0.8의 혼합은 기본 모델보다 그림의 정답 범주 비율을 9.8%p 높이고, 의존성 불일치를 10.5 points 줄인다. 이는 pass@k 향상과 함께 구조적인 근거를 제공한다.
8 Conclusion
결론은 post-training을 통한 추론 개선이 사전학습에서 형성한 기본 요소에 달려 있다고 주장한다. 통제된 실험은 검증한 합성 산술 설정 안에서 데이터 커리큘럼, 보상 설계, 연산량 배분에 관한 조건부 지침을 뒷받침한다.
부록
- A.1 Data Generation Framework는 A.1.1 Graph-Level Formalism과 A.1.2 Abstract and Instance Parameters를 포함하며 기초 덧셈, 뺄셈, 곱셈, 나눗셈으로 그래프를 정의하고 기호적 의존 관계를 수치 및 언어적 개체와 분리한다. A.1.3 Contextual Rendering은 그래프를 [question], [solution], [answer] 묶음으로 변환한다. A.1.4 Generation Pipeline and Structural Knobs는 구조 표본 추출, 구체화, 맥락에 따른 자연어 표현, 순방향 생성 또는 지정한 미지의 수량을 구하는 역방향 생성을 설명한다. A.1.5 Deduplication and Canonicalization은 정규화한 자연어 묶음의 해시가 정확히 일치하는 중복을 각 분할 내부와 분할 사이에서 제거하여, 동일한 문제와 풀이 묶음이 학습과 평가에 함께 등장하지 않도록 한다.
- A.2 Task Setup은 사전학습, mid-training, post-training의 연산 범위를 합친 집합에서 최대 연산 수를 초과하는 경우를 외삽으로 정의한다. 템플릿 사이의 맥락 전이도 명시하며 학습 시 맥락 간 그래프를 의도적으로 대응시키지 않는다고 설명한다. 따라서 본문의 OOD-edge는 사전학습을 기준으로 한 난도 구분이다. op=11–14로 적응한 뒤에는 op=15–20이 해당 학습 단계 전체에서 접한 연산 범위를 넘어서는 외삽을 평가한다.
- A.3 Training Setup의 A.3.1 Model Architecture는 100M-parameter 모델에 12개 층, 은닉 크기 768, 중간 크기 3,072, attention head 12개, key-value head 2개를 사용한다고 명시한다. A.3.2 Tokenizer and Input Representation은 반복되는 토큰 쌍을 병합하여 어휘를 구성하는 byte-pair encoding(BPE) 토크나이저를 학습하며 어휘 크기는 2,200 토큰이고 최대 시퀀스 길이는 2,048이다. A.3.3 Hyperparameters는 사전학습에 512K-token 배치를 사용하고 학습률을 2×10^−4, 가중치 감쇠를 0.1, 최소 학습률을 3×10^−5, 워밍업 비율을 5%, 학습 기간을 1 epoch로 지정한다. Mid-training은 학습률 1×10^−4와 워밍업 비율 15%를 사용한다.
- A.3.3은 RL 배치를 예시 1,024개, 프롬프트와 응답의 최대 길이를 각각 1,024 토큰, 학습 기간을 2 epochs, actor 학습률을 1×10^−6으로 지정한다. 기준 모델에서 벗어나는 데 페널티를 주는 기준 정책 정규화의 계수는 10^−3이다. RL 표본 추출에는 temperature 1.0을 사용한다. 평가에는 temperature 0.7, top-p=1.0, top-k=−1을 사용하고 새 토큰을 최대 1,024개 생성한다. 이 평가 표본 추출 설정은 확률 질량이나 토큰 수에 따른 후보 절단을 적용하지 않는다. A.3.4 Performance Ladder는 기본 모델 사전학습 중 op=2–10의 pass@128이 거의 포화하고 op=11–14는 부분적으로 해결하며 op=15–20의 해결 성능은 0임을 보여준다.
- A.4 Process-Verified Evaluation은 “Define … as …” 단계를 결정론적으로 파싱하고 참조한 변수에서 의존 관계를 추출한다. 각 단계에서 마지막으로 계산 가능한 산술식을 평가하며 필요하면 마지막 숫자 리터럴을 대신 사용한다. 기준 노드가 누락되거나 부모 집합 또는 수치가 틀리면 정답으로 인정하는 단계 수는 0단계다. 추가로 예측한 노드는 과정 정확도에 영향을 주지 않는다. 전체 정답으로 인정받으려면 모든 기준 노드가 검증을 통과하고 추출한 답이 일치해야 한다.
- A.5 Training Dynamics for § 3은 모델이 기준 텍스트를 얼마나 부정확하게 예측하는지 측정하는 손실인 음의 로그우도(NLL)와 RL 보상 추이를 보고한다. 제시된 결과에서 op=11–14로 학습할 때 op=15–20의 NLL 감소가 가장 크다. op=9–12와 op=11–14의 보상은 개선되지만 쉬운 범위의 보상은 대체로 정체하고 op=17–20의 보상은 0으로 유지된다. 이러한 학습 추이는 부분적으로 풀 수 있는 학습 예시가 유리하다는 정확도 비교와 일치한다.
- A.6 Detailed Analysis of Post-Training Effects on Contextual Generalization은 2가지 사전학습 조건을 구분한다. A.6.1 When Reasoning Primitives are Shared During Pre-Training에서는 맥락 A 99.9%와 맥락 B 0.1%가 모두 op=2–20을 다룬다. Observation 5와 Takeaway 5는 RL 중 B의 비중이 0%여도 B로 전이되며, RL에서 B의 비중을 높이면 추가로 개선된다고 보고한다. A.6.2 When Only Atomic Primitives are Exposed During Pre-Training에서는 B가 사전학습의 1%를 차지하고 op=2로 제한된다. Observation 6과 Takeaway 6은 RL 중 B의 비중이 0–1%이면 전이가 거의 없고, 10%에서 상당히 개선되며, 50–100%에서 더 높은 성능을 보인다고 제시한다. 이때 A의 성능은 비교적 안정적으로 유지된다.
- A.6.3 Training Dynamics for § A.6.2는 RL 중 목표 맥락의 노출 비중이 0–1%이면 보상이 대체로 정체하고 10–100%이면 증가함을 보여준다. Observation 6은 B를 약 10% 도입하면 pass@128이 +76 points 넘게 오른다고 서술하지만 Figure 13의 10% 곡선은 그 크기를 뒷받침하지 않는다. 그림에서 가장 큰 개선은 B 비중이 50–100%일 때 나타난다. 그림은 목표 맥락의 RL 노출량에 성능이 의존한다는 정성적 결과를 뒷받침하지만 수치 개선을 어느 조건에 귀속하는지는 서술과 일치하지 않는다.
- A.7 Detailed Analysis of Pre-Training Effects on Extrapolative Generalization은 RL을 op=11–14로 고정하고 사전학습에서 더 어려운 예시의 노출량을 바꾼다. Observation 7과 Takeaway 7은 부분적으로 형성된 조합 능력을 더 깊은 외삽의 기반으로 해석한다. 그림에서 어려운 데이터 비중이 0.1%, 5%, 20%, 33.3%, 50%일 때 op=15–20의 pass@128 개선은 각각 +5.9, +10.4, +22.1, +18.0, +25.8 points다. 이 값은 단조롭게 증가하지 않으며 가장 큰 개선이 20%에서 발생한다는 서술과 모순된다.
- A.7.1 Training Dynamics for § A.7은 어려운 데이터 비중이 0.1%부터 50%인 조건에서 보상이 증가하는 추이를 제시한다. 캡션은 제시된 패널에 없는 0%와 100%도 추가로 논의한다. A.8 Training Dynamics for § 4는 기초적인 맥락 B 예시의 노출 비중이 0.1%이면 지속적인 보상 개선이 거의 없지만 1%와 10%이면 보상이 증가함을 보여준다. 제시된 추이는 정확도 비교를 보완하지만 캡션에서만 언급한 조건을 검증하지는 않는다.
- A.9 Post-Training and Pre-Training Data Recipe는 맥락 A를 animals–zoo, B를 teachers–school, C를 movie-festival로 명시하고 사전학습 예산 10B 토큰과 RL 예산 204.8k 표본을 표로 정리한다. Section 3의 가장 쉬운 RL 범위는 본문에서는 op=7–10이지만 표에서는 op=8–10이다. A.7의 서술은 어려운 예시를 op=7–10으로 설명하지만 표의 여러 설정은 op=8–10을 사용한다. Table 2에는 0.1% op=8–20 설정도 포함되어 있으며 Figure 15에 대응하는 33.3% 설정은 명시되어 있지 않다. 따라서 그림에 제시된 ablation 실험의 일부 조건은 재현에 필요한 설명이 부족하다.
- A.10 Mid-/Post-Training Mixing with Different Computation Budget과 A.10.1 Compute Budget of Mid-Training and RL Equivalence는 지도학습 비용 C_train≈6PT와 RL 비용 C_RL=(8+2γ)PNrL_total을 유도한다. P는 임베딩을 제외한 파라미터 수이고, γ는 기준 모델 연산의 수행 여부를 나타낸다. γ=1이면 지도학습 토큰으로 환산한 비용은 T_RL=(5/3)NrL_total이다. 부록의 적응 설정은 학습 단계 모두 op=2–10을 20%, op=11–14를 80% 사용한다. Table 3은 총예산을 환산 토큰 기준으로 1.05, 2.10, 4.20, 8.40, 12.58, 16.78, 20.00B로 제시한다.
- Observation 8과 Takeaway 8은 최적 배분이 과제와 예산에 따라 달라진다고 설명한다. 혼합 학습은 pass@1에 유리한 경우가 많다. OOD-hard pass@128에서는 환산 토큰 4.2B일 때 Heavy-RL이 유리하고 8.4B 이상에서는 Full RL이 유리하다. Figure 18에는 함께 제시된 보편적인 pass@1 주장에 대한 예외가 있다. 4.2B에서는 Full mid-training의 OOD-edge pass@1이 가장 높고, 20.0B에서는 Full RL의 OOD-hard pass@1이 가장 높다. 결과는 학습 방식마다 상호 보완적인 강점이 있으며 유리한 배분이 과제, 지표, 예산에 따라 달라진다는 해석을 뒷받침한다.
짧은 생각
핵심 기여는 사전학습 범위, 적응 난도, 추론 검증을 함께 통제한 데 있다. ID pass@128은 포화한 상태에서 더 어려운 과제의 pass@128이 개선된 결과는 RL의 효과가 학습 조건에 달려 있다는 근거를 제공한다. 중간 단계 검증은 최종 답만 맞히는 지름길 풀이를 유효한 풀이로 집계할 가능성을 줄인다.
근거는 소규모 템플릿 집합을 사용하는 합성 산술 데이터로 학습한 1가지 100M-parameter 모델 구조에서 나왔다. 따라서 1% 노출 임계값과 유리한 연산량 배분은 더 다양한 과제와 더 큰 모델에서 검증해야 한다. 기본 모델에서 128개 표본을 추출해 정답 풀이를 찾지 못했다는 결과는 유한한 표본 추출에서 성능 차이가 있음을 보여준다. RL 이전에 해당 풀이가 나올 확률이 0이었다는 사실을 증명하지는 않는다. 파서는 생성된 과정을 기준 그래프와 비교해 검증하며 내부 계산을 직접 관찰하지는 않는다.
부록의 일부 주장은 그림이 뒷받침하는 범위를 넘어선다. 서술과 설정 표의 연산 범위가 다르고, Section 5에서 명시한 양 끝 설정은 자체 공식에 따르면 비용이 같지 않다. 이러한 불일치는 정확한 재현과 예산 배분 권고를 제한한다. 주요 비교는 검증할 3가지 가설을 제시한다. 부분적으로 풀 수 있는 RL 과제를 선택하고 전이를 기대하기 전에 목표 맥락의 기본 요소를 형성하며 과정을 반영하는 보상과 결과만 반영하는 보상을 비교한다는 가설이다.