


Bolmo: Byteifying the Next Generation of Language Models 요약 설명
17 Dec 2025 | Paper Review Byte-Level Language Models Knowledge Distillation Adaptive Computation목차
- 요약
- 1 Introduction
- 2 Related Work
- 3 Byteified Olmo
- 4 Experiment Setup
- 5 Main Results
- 6 Ablations
- 7 Conclusion
- 8 Future Directions
- 부록
- 짧은 생각
이번 글에서는 Bolmo: Byteifying the Next Generation of Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 17일(Arxiv)
- Minixhofer, Benjamin, Murray, Tyler, Limisiewicz, Tomasz, Korhonen, Anna, Zettlemoyer, Luke, Smith, Noah A., Ponti, Edoardo M., Soldaini, Luca, Hofmann, Valentin.
- Allen Institute for AI, University of Cambridge, University of Washington, University of Edinburgh
- 논문 링크
- 검토 원문: 2026년 2월 9일 개정한 arXiv v2. 선정 주차는 2025-W52이다.
요약
- Bolmo는 사전학습된 subword LLM을 byte-level Latent Tokenizer Language Models(LTLMs)로 변환한다. 핵심 기여는 prefill에서 미래의 1바이트를 참조하는 patch 경계 예측과 2단계 학습 절차다. 먼저 원본 모델의 Transformer를 고정한 채 지식을 증류하고, 이어서 전체 모델을 학습한다.
- Bolmo 7B는 문자 이해 종합 점수에서 Olmo 3 7B의 56.0보다 높은 75.1을 기록하고, 코드 종합 점수에서도 39.5보다 높은 40.7을 기록한다. 반면 수학과 여러 QA 범주에서는 원본 모델보다 점수가 낮다. Stage 1은 9.8B 토큰을, Stage 2는 39.3B 토큰을 처리하며 원본 모델에 이미 투입된 사전학습 자원을 재활용한다.
- H100 GPU에서 batchsize=1로 측정한 결과, patch 압축률을 높인 Bolmo 7B는 patch당 약 6.6바이트에서 원본 모델의 추론 속도를 넘어선다. Olmo 3 RL-Zero case study에서는 Task Arithmetic으로 Bolmo를 추가 학습하지 않고도 instruction-following 능력을 이전한다. 다만 성공 여부는 기본 모델의 embedding 공간과 호환되는지에 달려 있다.
1 Introduction
Subword tokenization은 문자 구조를 가리고, 프롬프트에 따라 tokenization 효과를 일으키며, 어휘를 제한하고 토큰 단위로 연산량을 배분한다. 저자들은 byte-level 모델이 주요 subword 모델의 발전 속도를 따라가지 못한 이유 중 하나가 처음부터 학습하는 방식에 개발이 집중되어 왔기 때문이라고 가정한다. 이 방식에는 데이터, 아키텍처, post-training에 별도의 투자가 필요하다.
- Bolmo 7B는 Olmo 3 7B에서, Bolmo 1B는 OLMo 2 1B에서 출발한다. Byteification은 subword 입력과 출력 처리를 byte-level 구성 요소로 교체하면서 기존에 학습한 능력을 보존하는 것을 목표로 한다.
- 논문은 39.3B 토큰이 일반적인 사전학습 예산의 1% 미만이라고 설명한다. 이는 Stage 2의 예산이며, Stage 1은 별도로 9.8B 토큰을 처리한다.
- 공개된 자료는 https://huggingface.co/allenai/Bolmo-7B, https://huggingface.co/allenai/Bolmo-1B, https://huggingface.co/datasets/allenai/bolmo_mix, https://github.com/allenai/bolmo-core 에서 확인할 수 있다.
2 Related Work
관련 연구는 바이트를 직접 처리하는 방식과 계층적 아키텍처를 구분한다. 계층적 아키텍처는 가벼운 local 모델로 바이트를 patch로 모으고, 깊은 global 모델로 patch를 처리한 뒤 바이트 표현을 복원한다. Dynamic patching은 입력에 따라 patch 크기와 global 모델의 연산량 배분을 조절한다.
- DTP, BLT, H-Net은 LTLM과 byteification의 선행 사례다. Bolmo는 기존 subword 모델을 이전하는 데 적합한 아키텍처와 학습 절차를 개발한다.
- Tokenizer 이전과 기존 모델의 개조에는 embedding 초기화나 tokenizer 간 증류가 자주 쓰인다. Bolmo는 전체 모델을 학습하기 전에 지도학습을 통한 경계 일치, 표현 정렬, patch likelihood 증류를 결합한다.
- Byte-level 처리도 tokenizer를 사용한다. UTF-8은 텍스트를 256개의 가능한 바이트 값으로 변환한다. UTF-8은 라틴 문자에 치우친 인코딩이므로, 유한한 subword 어휘를 제거한다고 해서 모든 문자 체계에서 효율이 같아지는 것은 아니다.
3 Byteified Olmo
Byteified Olmo는 사전학습된 Transformer를 잠재 바이트 patch를 처리하는 global 모델로 유지한다. Local 구성 요소는 바이트와 Transformer가 기대하는 표현 공간 사이를 변환한다. 이 구성 요소의 아키텍처와 학습 목표는 전체 모델을 적응시키기 전에 원본 모델의 동작을 복원하도록 설계된다.
3.1 Architecture
각 바이트 위치에서 현재 위치까지의 바이트열과 가장 긴 공통 접미사를 갖는 원본 subword 토큰을 선택하고, 그 embedding을 바이트 embedding에 더한다. 1개 층으로 구성된 mLSTM encoder가 이 embedding에 문맥을 반영하고, 각 patch의 마지막 바이트 표현을 pooling해 원본에서 유지한 Transformer에 전달한다. Depooling은 가장 최근에 사용할 수 있는 Transformer patch 표현을 local 바이트 표현의 선형 투영에 더한다. 이후 4개 층의 mLSTM decoder와 바이트 예측 head가 처리한다.
- Local 표현과 global 표현의 차원을 같게 설정한다. 작은 local 표현을 up-projection할 때 embedding rank가 제한되는 문제를 피하기 위해서다. 차원은 Bolmo 7B에서 4096, Bolmo 1B에서 2048이다.
- Subword 접미사 embedding을 유지하면 희소하게 활성화되는 파라미터로 표현 용량을 늘려 얕은 encoder를 사용할 수 있다. 저자들은 이를 유지하지 않아도 더 큰 encoder로 비슷한 성능을 얻을 수 있지만, 성능과 효율의 절충은 덜 유리하다고 보고한다.
- 원본의 출력 embedding 행렬을 제거하면 local 모델을 추가하면서 늘어나는 파라미터의 상당 부분을 상쇄한다. Bolmo 7B의 파라미터 수는 7.63B이고 Olmo 3 7B는 7.30B다. Bolmo 1B는 1.47B이고 OLMo 2 1B는 1.48B다.
Transformer는 pooling된 patch를 처리하고, local mLSTM 구성 요소는 모든 바이트를 처리한다. Local 바이트 표현에서 decoder로 이어지는 residual 경로는 patch pooling을 거치지 않고 세밀한 정보를 전달할 수 있게 한다.
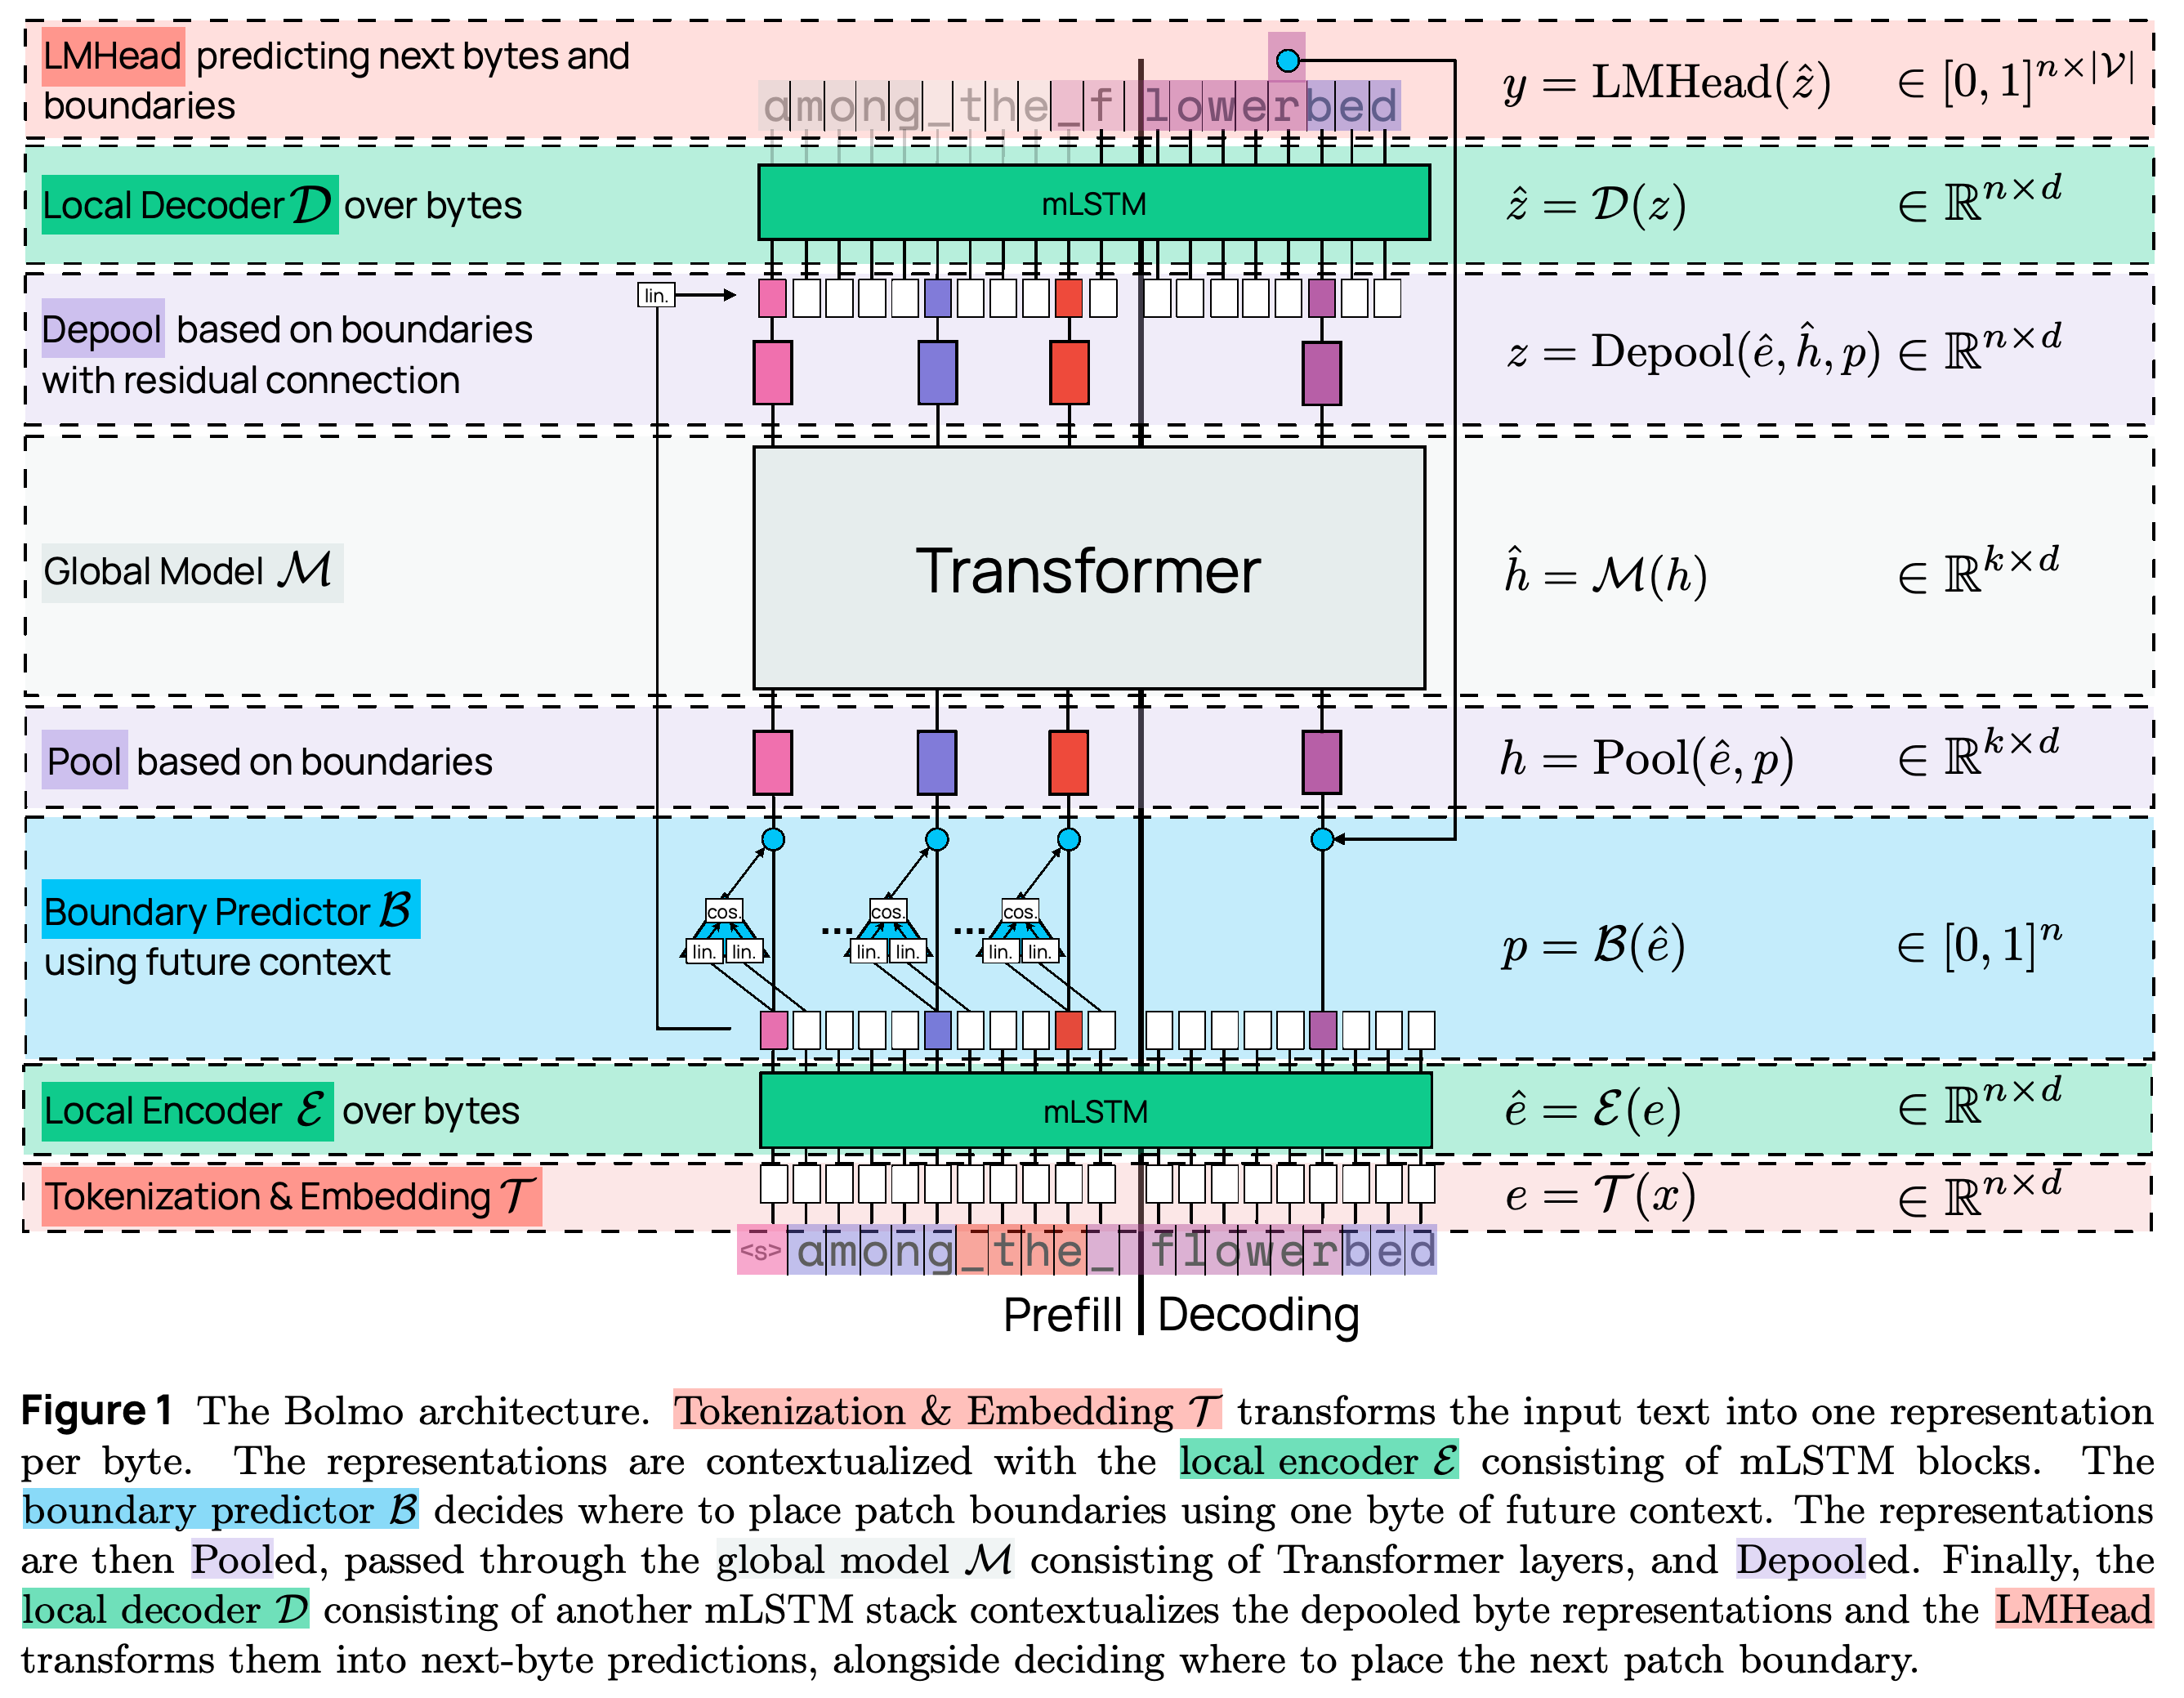
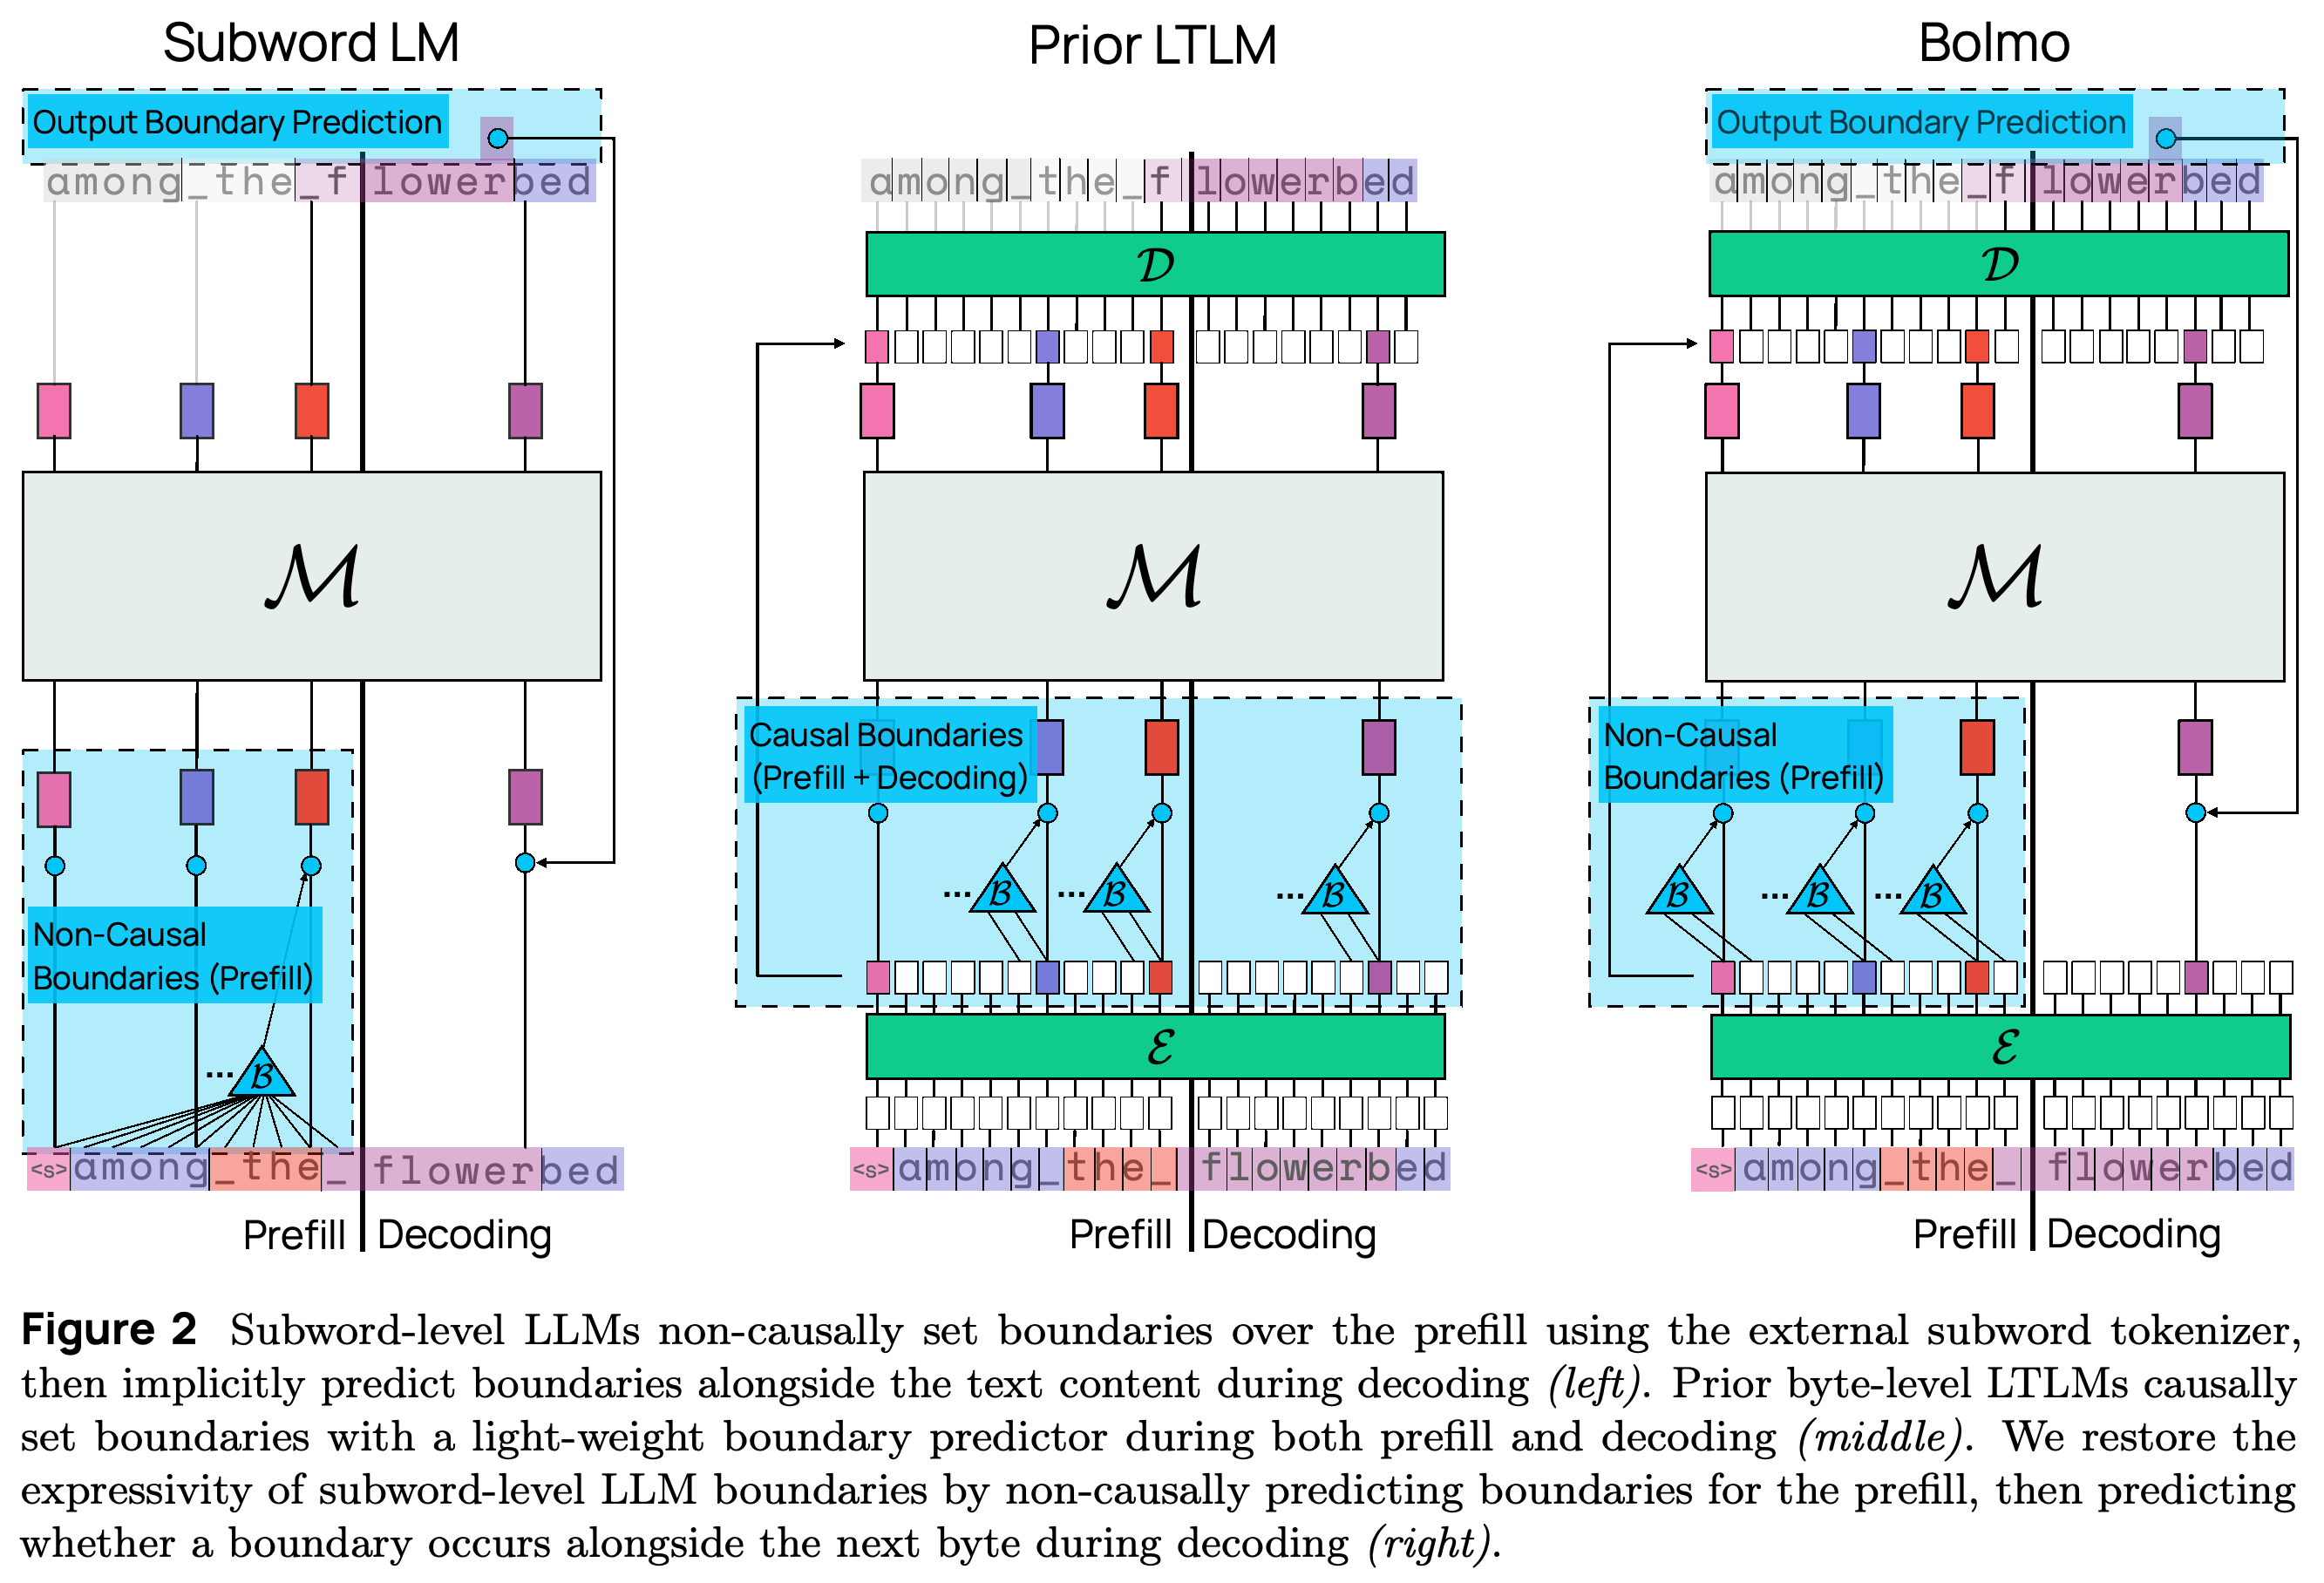
3.1.1 Non-Causal Patch Boundary Prediction은 subword tokenizer와 causal LTLM 경계 예측기 사이의 차이를 다룬다. Subword tokenizer는 토큰의 끝을 정할 때 미래 바이트를 참조할 수 있지만, causal LTLM 경계 예측기는 이를 참조할 수 없다. Bolmo의 prefill 예측기는 현재 바이트와 다음 바이트의 투영된 표현 사이에서 cosine distance의 절반을 사용한다. Decoding에서는 language modeling head가 다음 바이트와 해당 바이트가 patch의 끝인지 함께 예측한다.
- 예를 들어 _Hello_Wor!와 _Hello_World!는 _Hello_Wor라는 접두사가 같아도 r 뒤의 경계가 달라질 수 있다. 미래의 1바이트를 참조하면 prefill 경계 예측기가 이 차이를 구분할 수 있다. 다만 subword tokenizer는 더 먼 문맥도 참조할 수 있다.
- Boundary Symbol Fusion은 각 바이트에 경계가 뒤따르는 버전을 대응시켜 출력 바이트 어휘를 256에서 512로 확장한다. 따라서 별도의 <b> 기호를 출력하기 위한 추가 decoder 단계를 피한다.
- 경계 예측기는 연속적인 경계 점수를 통해 gradient를 전달받는 대신 외부 감독 신호를 받는다. 저자들은 non-causal bfloat16 점수가 미래 바이트에 관한 16비트의 정보를 decoder에 전달할 수 있다는 잠재적 실패 양상을 지적한다.
Bolmo는 prefill에서 미래 문맥을 참조하는 분할과 생성 중 바이트 및 경계를 함께 예측하는 처리를 구분한다. 그림의 causal patch 시작 예측은 patch 내용을 1바이트만큼 이동시키지만, Bolmo의 non-causal patch 끝 예측은 원본 tokenization과의 정렬을 유지한다.
3.2 Byteifying Procedure
3.2.1 Stage 1: Subword-to-Byte Distillation은 global Transformer를 고정하고 local encoder, local decoder, 경계 예측기, language modeling head를 학습한다. 학습 목표는 subword patch의 끝에 감독 신호를 제공하고, 고정된 Transformer의 4개 층을 거친 encoder 표현을 정렬하며, 원본 토큰의 likelihood를 대응하는 바이트와 경계의 likelihood 곱에 맞추는 것이다. 이 likelihood 비교는 patch 경계가 일치한다고 가정하며, 원본 모델에서 문맥을 반영한 표현을 사용해 decoder를 학습한다.
- 경계 감독에는 binary cross-entropy를 사용하며, 정확도가 빠르게 >99%에 도달한다. 표현을 정렬할 때는 실제 subword 경계를 pooling에 사용해 시퀀스 간 대응을 유지한다.
- n=4개의 Transformer 층을 거친 표현을 맞추면 n=0에서 embedding을 직접 맞추는 것보다 성능이 높다. 동시에 global 모델을 통한 역전파 연산도 제한한다.
- Patch likelihood를 맞추는 데는 τ=5로 temperature를 조절한 binary cross-entropy를 사용하며, log-space에서 계산한다. 결합된 목표에는 next-byte cross-entropy도 포함된다. 가중치는 λ_B=4, λ_E=1, λ_D,Distill=1, λ_D,CE=1이다.
3.2.2 Stage 2: End-to-End Training은 global 모델의 고정을 해제하고 경계 감독과 next-byte cross-entropy로 모든 파라미터를 최적화한다. 이 단계의 next-byte 목표는 Bolmo 자체에서 문맥을 반영한 patch 표현을 사용한다. 따라서 불완전하게 학습된 경계와 local 표현에 적응할 수 있다. 이 단계에서는 patch당 바이트 수의 목표값도 늘릴 수 있다.
- Stage 1에는 global 모델 전체의 순전파가 필요하지만, 역전파는 처음 4개 층과 local 구성 요소만 통과한다. 따라서 매번 전체 모델을 학습하는 것보다 아키텍처를 빠르게 실험할 수 있다.
- Stage 2에서도 경계 결정은 외부 감독 신호를 받으며, 이산적인 patch 선택을 통해 gradient가 전달되지는 않는다.
4 Experiment Setup
Bolmo Mix는 Dolma 3 사전학습 혼합 데이터에서 가져온 약 172B 토큰과 CUTE 형식의 문자 과제 75M 토큰으로 구성된다. 토큰 수는 Dolma2 Tokenizer로 측정한다. Stage 1은 9.8B 토큰, 약 43B 바이트를 처리하고, Stage 2는 39.3B 토큰, 약 173B 바이트를 처리한다. 학습량은 전체 혼합 데이터의 1 epoch 미만이다.
- Bolmo 7B는 mid-training과 long-context 확장을 마친 Olmo 3 7B checkpoint에서 출발한다. 아키텍처 개발에는 주로 OLMo 2 모델을 사용하며, 완성된 절차를 수정 없이 Olmo 3 7B에 적용한다.
- 추가 학습을 수행하는 Olmo 3 baseline에도 같은 데이터로 동일한 39.3B 토큰의 global 모델 갱신 예산을 제공한다. 이를 통해 변환 효과와 추가 학습 효과를 구분하는 데 도움을 얻는다.
- 명시된 7B 평가 설정은 OlmoBaseEval을 수정해 GSM Symbolic과 BigCodeBench를 제외하고 CUTE와 다국어 EXECUTE를 추가한다. 1B 평가 모음은 Base Easy Suite를 수정하고 CUTE를 추가한다.
- 코드 sampling에는 원본 모델과 byteified 모델 모두 temperature=0.6과 top_p=0.6을 사용한다. Sweep에 사용하는 1B 핵심 과제는 ARC, MMLU, CSQA, HellaSwag, WinoGrande, SocialIQA, PIQA, Basic Skills, CUTE다.
5 Main Results
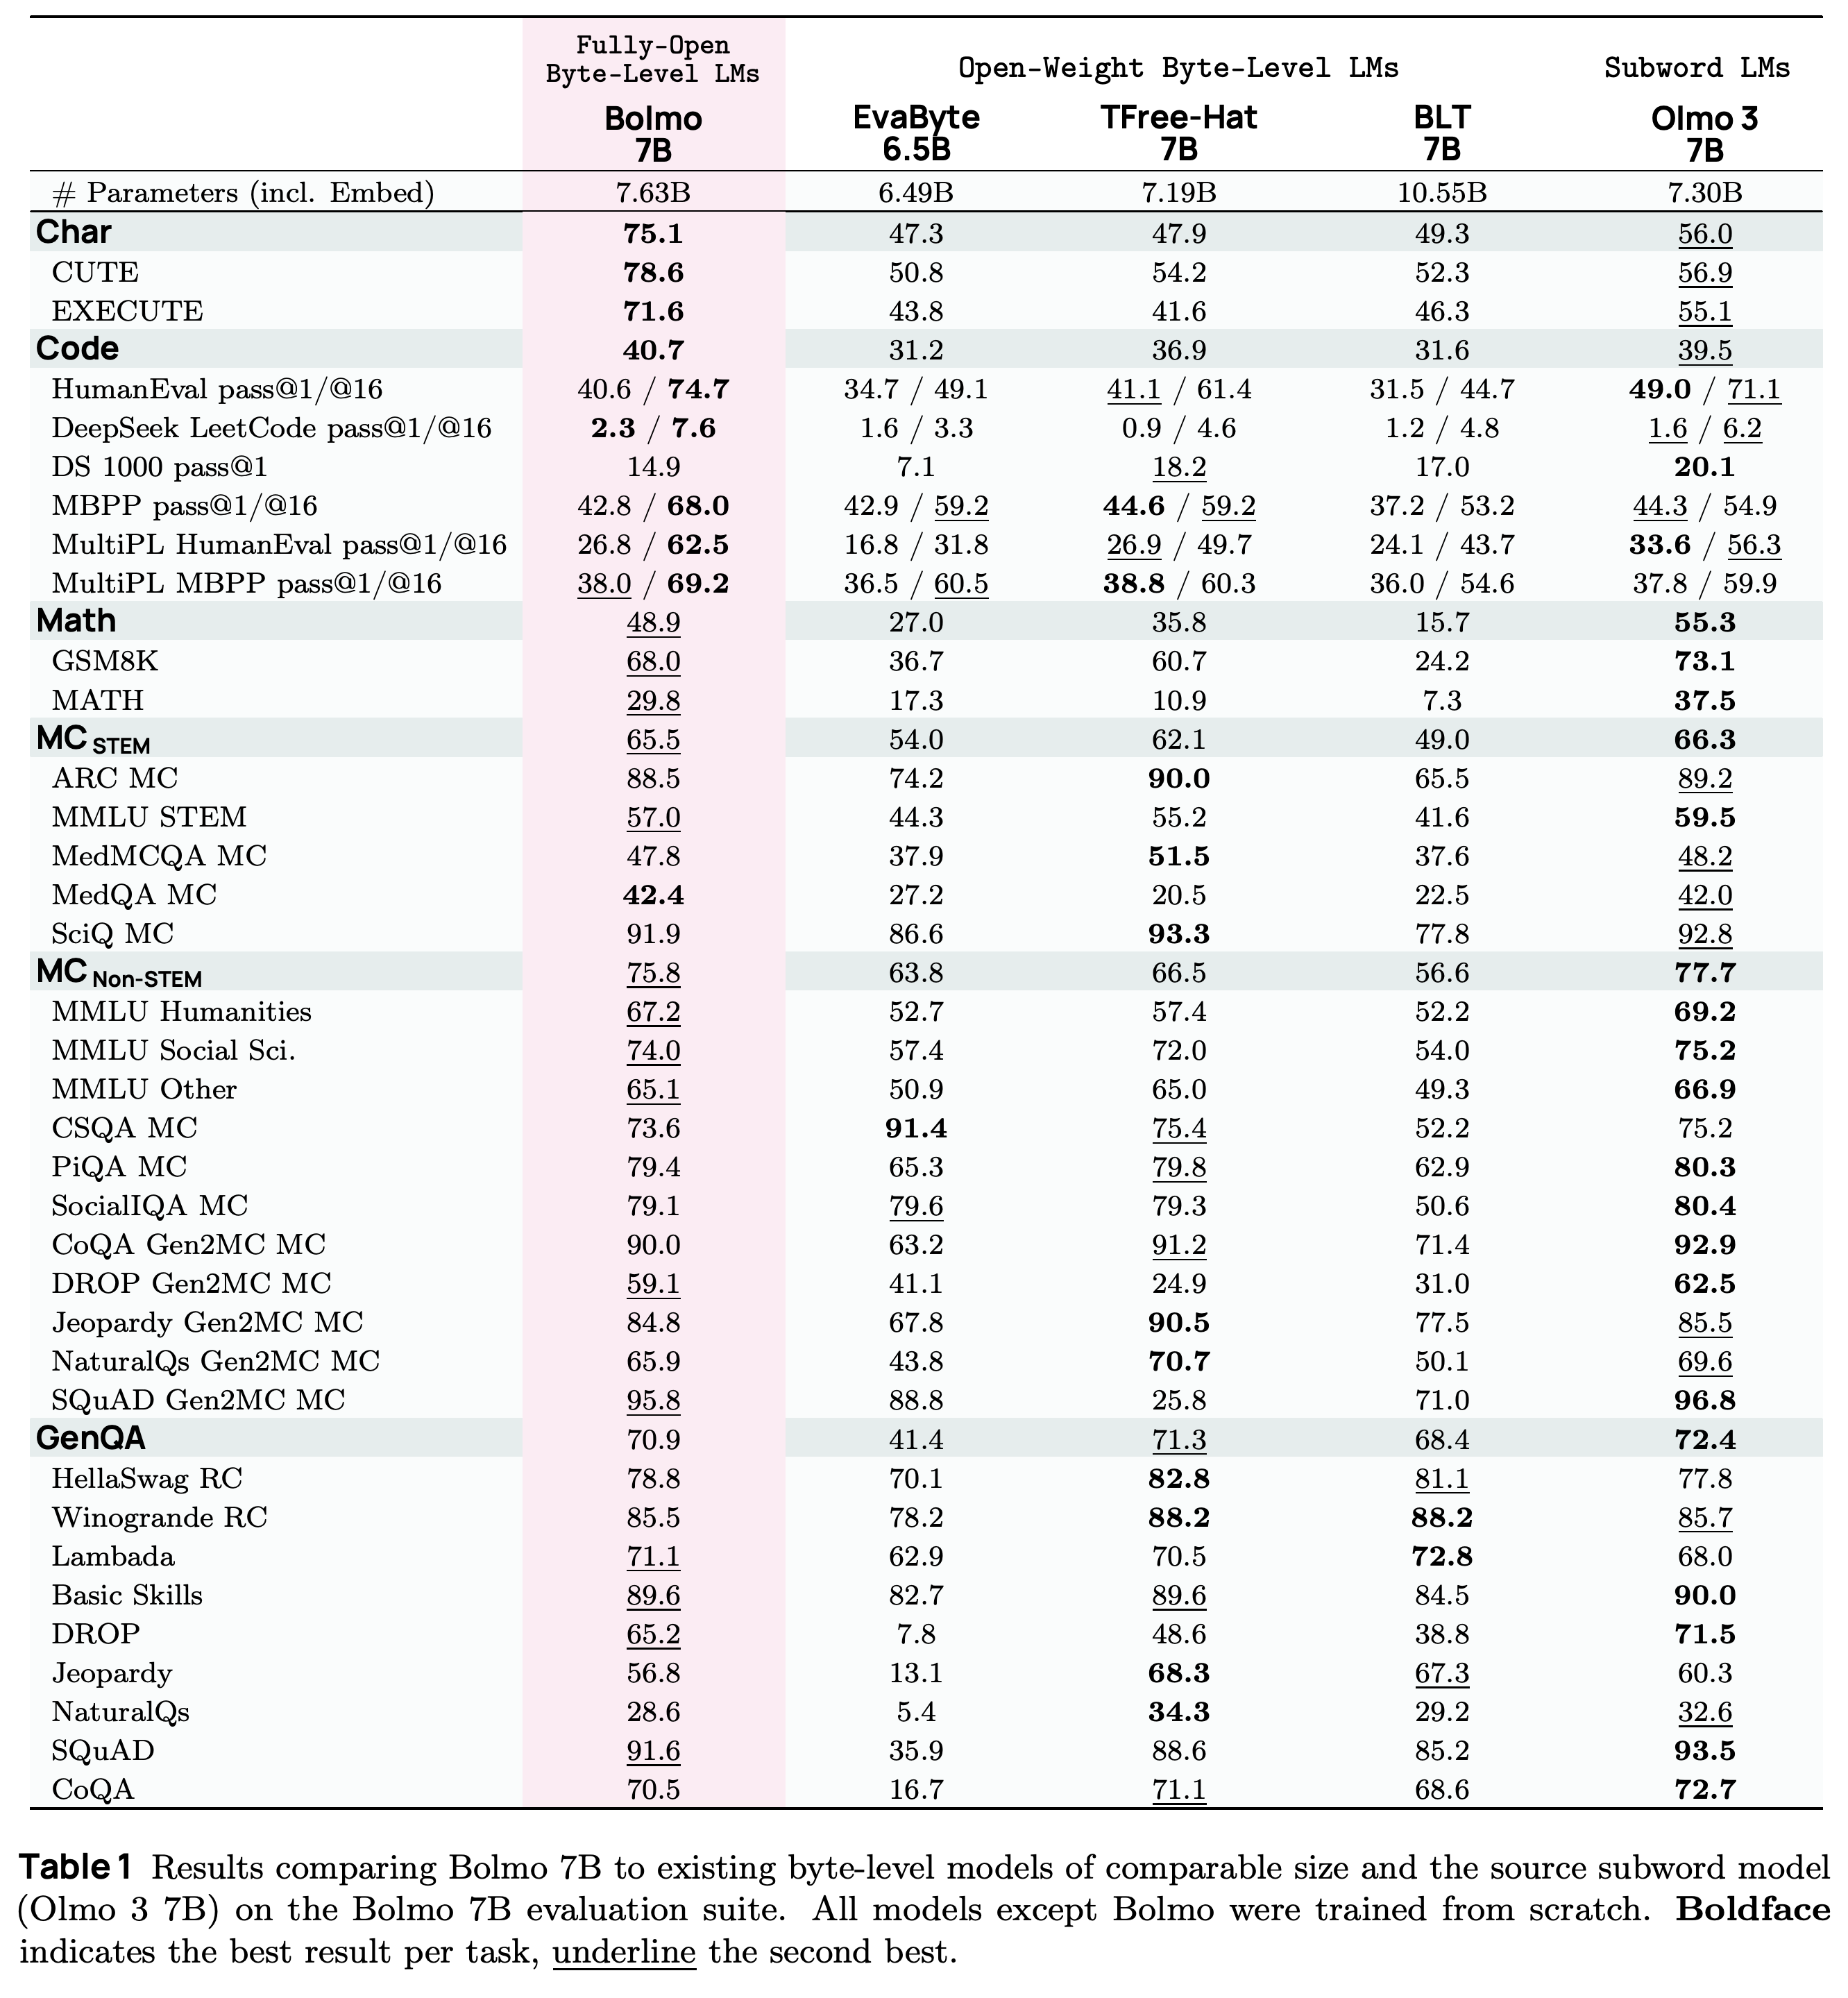
Bolmo 7B는 평가한 byte-level 기준 모델 중 문자 이해, 코드, 수학, STEM 객관식 QA, 비STEM 객관식 QA의 종합 점수에서 가장 높다. 점수는 Char 75.1, Code 40.7, Math 48.9, MC STEM 65.5, MC Non-STEM 75.8이다. GenQA에서는 TFree-Hat이 71.3으로 Bolmo의 70.9보다 조금 높다.
- Olmo 3 7B와 비교하면 CUTE는 56.9에서 78.6으로, EXECUTE는 55.1에서 71.6으로 향상된다. Math는 55.3에서 48.9로, MC STEM은 66.3에서 65.5로, MC Non-STEM은 77.7에서 75.8로, GenQA는 72.4에서 70.9로 낮아진다.
- 코드 종합 점수는 pass@1이 대체로 낮아졌음에도 pass@16이 높아져 39.5에서 40.7로 향상된다. HumanEval의 pass@1/pass@16은 49.0/71.1에서 40.6/74.7로 바뀐다.
- 저자들은 이 pass@16 양상을 시험한 sampling 설정에서 생성 결과의 다양성이 커진 것으로 해석한다. Byte-level 모델의 품질과 다양성 사이의 절충에 관한 더 일반적인 주장은 미해결로 남아 있다.
- 추가 학습 대조군도 여러 과제에서 성능이 낮아지고 문자 이해는 향상된다. Bolmo는 Char 점수가 71.0인 대조군보다 문자 이해에서 우위를 유지하지만, Math, 각 객관식 QA 종합 점수, GenQA에서는 대조군보다 낮다.
Bolmo가 원본 모델 대비 가장 크게 앞서는 범주는 문자 이해로, 점수는 75.1 대 56.0이다. 코드 종합 점수는 40.7로 향상되지만, Math는 원본의 55.3에 비해 48.9에 머문다. 범주별 결과는 원본 능력을 상당 부분 복원하면서도 과제에 따라 향상과 저하가 함께 나타남을 보여준다.
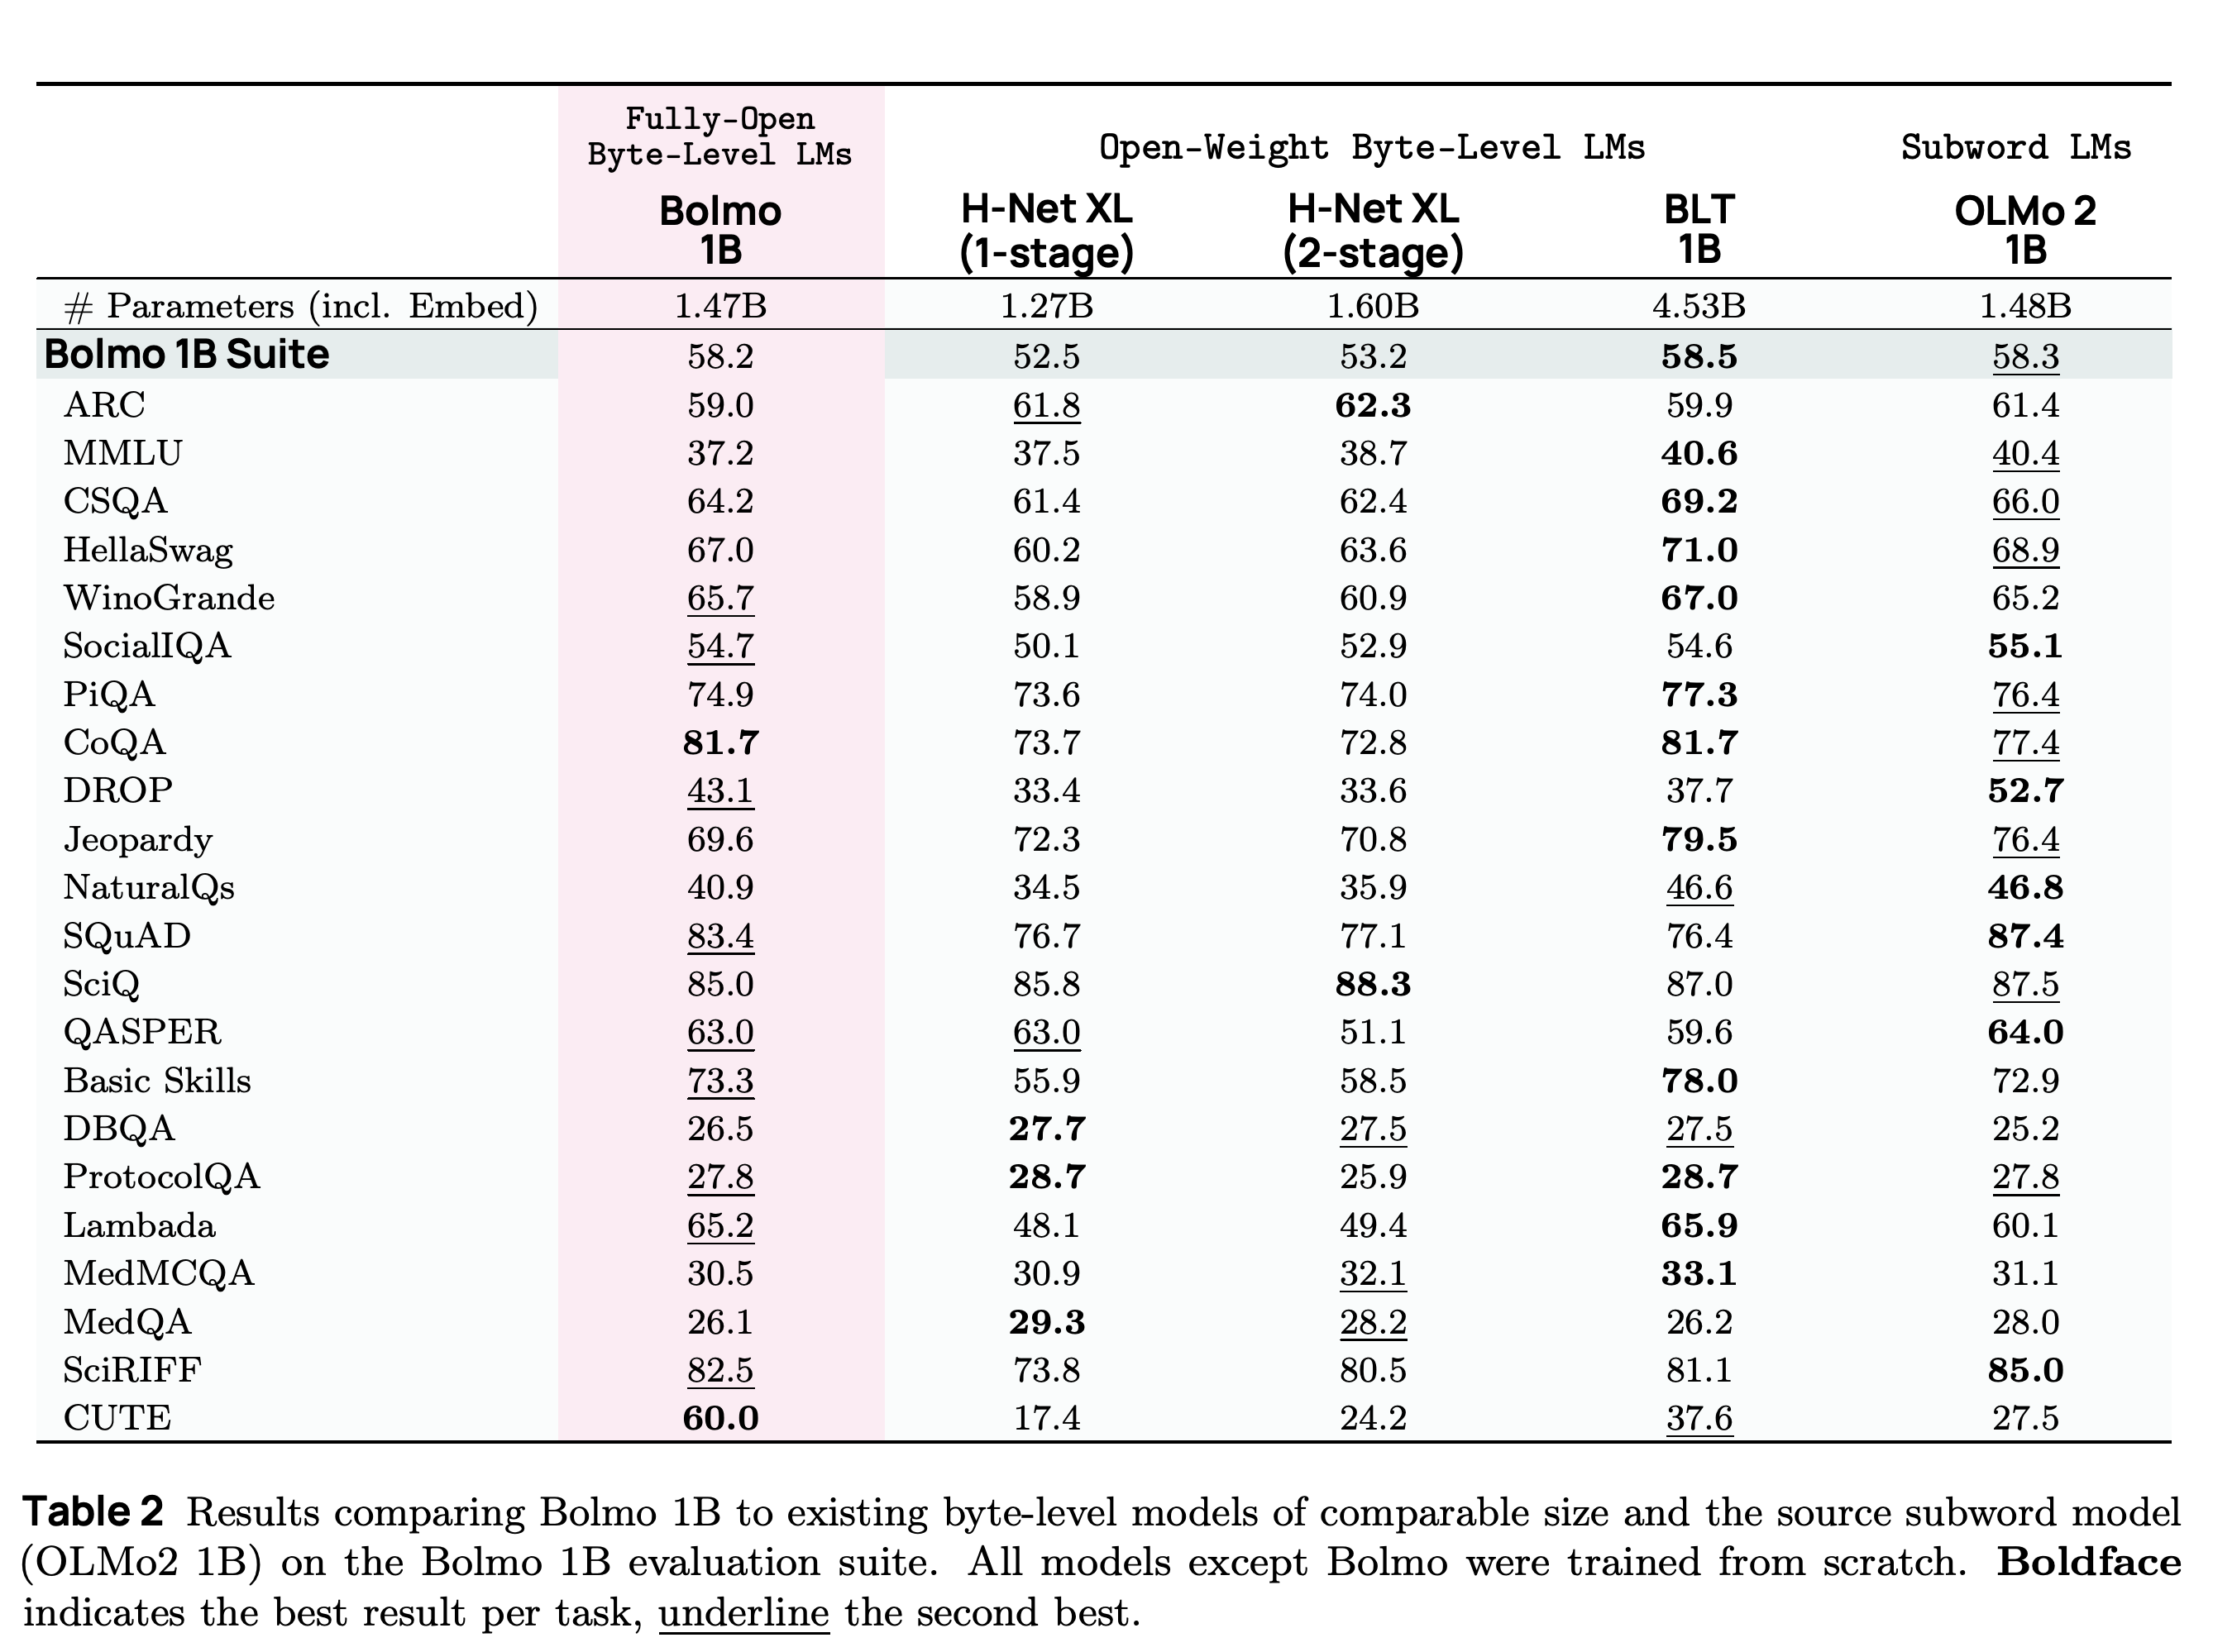
Bolmo 1B의 전체 평가 평균은 58.2로, OLMo 2 1B의 58.3 및 BLT 1B의 58.5와 비슷하다. 1단계 및 2단계 H-Net XL 변형의 52.5와 53.2보다는 높다. 다만 전체 파라미터 예산이 일치하는 비교는 아니다. BLT 1B는 embedding을 포함해 4.53B 파라미터를 갖지만 Bolmo는 1.47B다.
- CUTE는 OLMo 2 1B의 27.5에서 Bolmo 1B의 60.0으로 향상된다. Lambada는 60.1에서 65.2로 향상되지만, MMLU는 40.4에서 37.2로 낮아진다.
- 논문 본문은 CoQA가 +3.3% 향상됐다고 설명하지만, Table 2에는 81.7과 77.4가 제시되어 차이는 4.3 percentage points다.
Bolmo 1B의 전체 평가 평균은 원본 모델 및 BLT와 비슷하지만, CUTE는 훨씬 크게 향상된다. Embedding 파라미터를 포함하면 BLT 1B의 전체 파라미터 수는 4.53B이므로, 모델 이름에 표시된 크기만으로는 파라미터 예산이 일치한다고 볼 수 없다.
5.1 Training at Higher Compression Factors
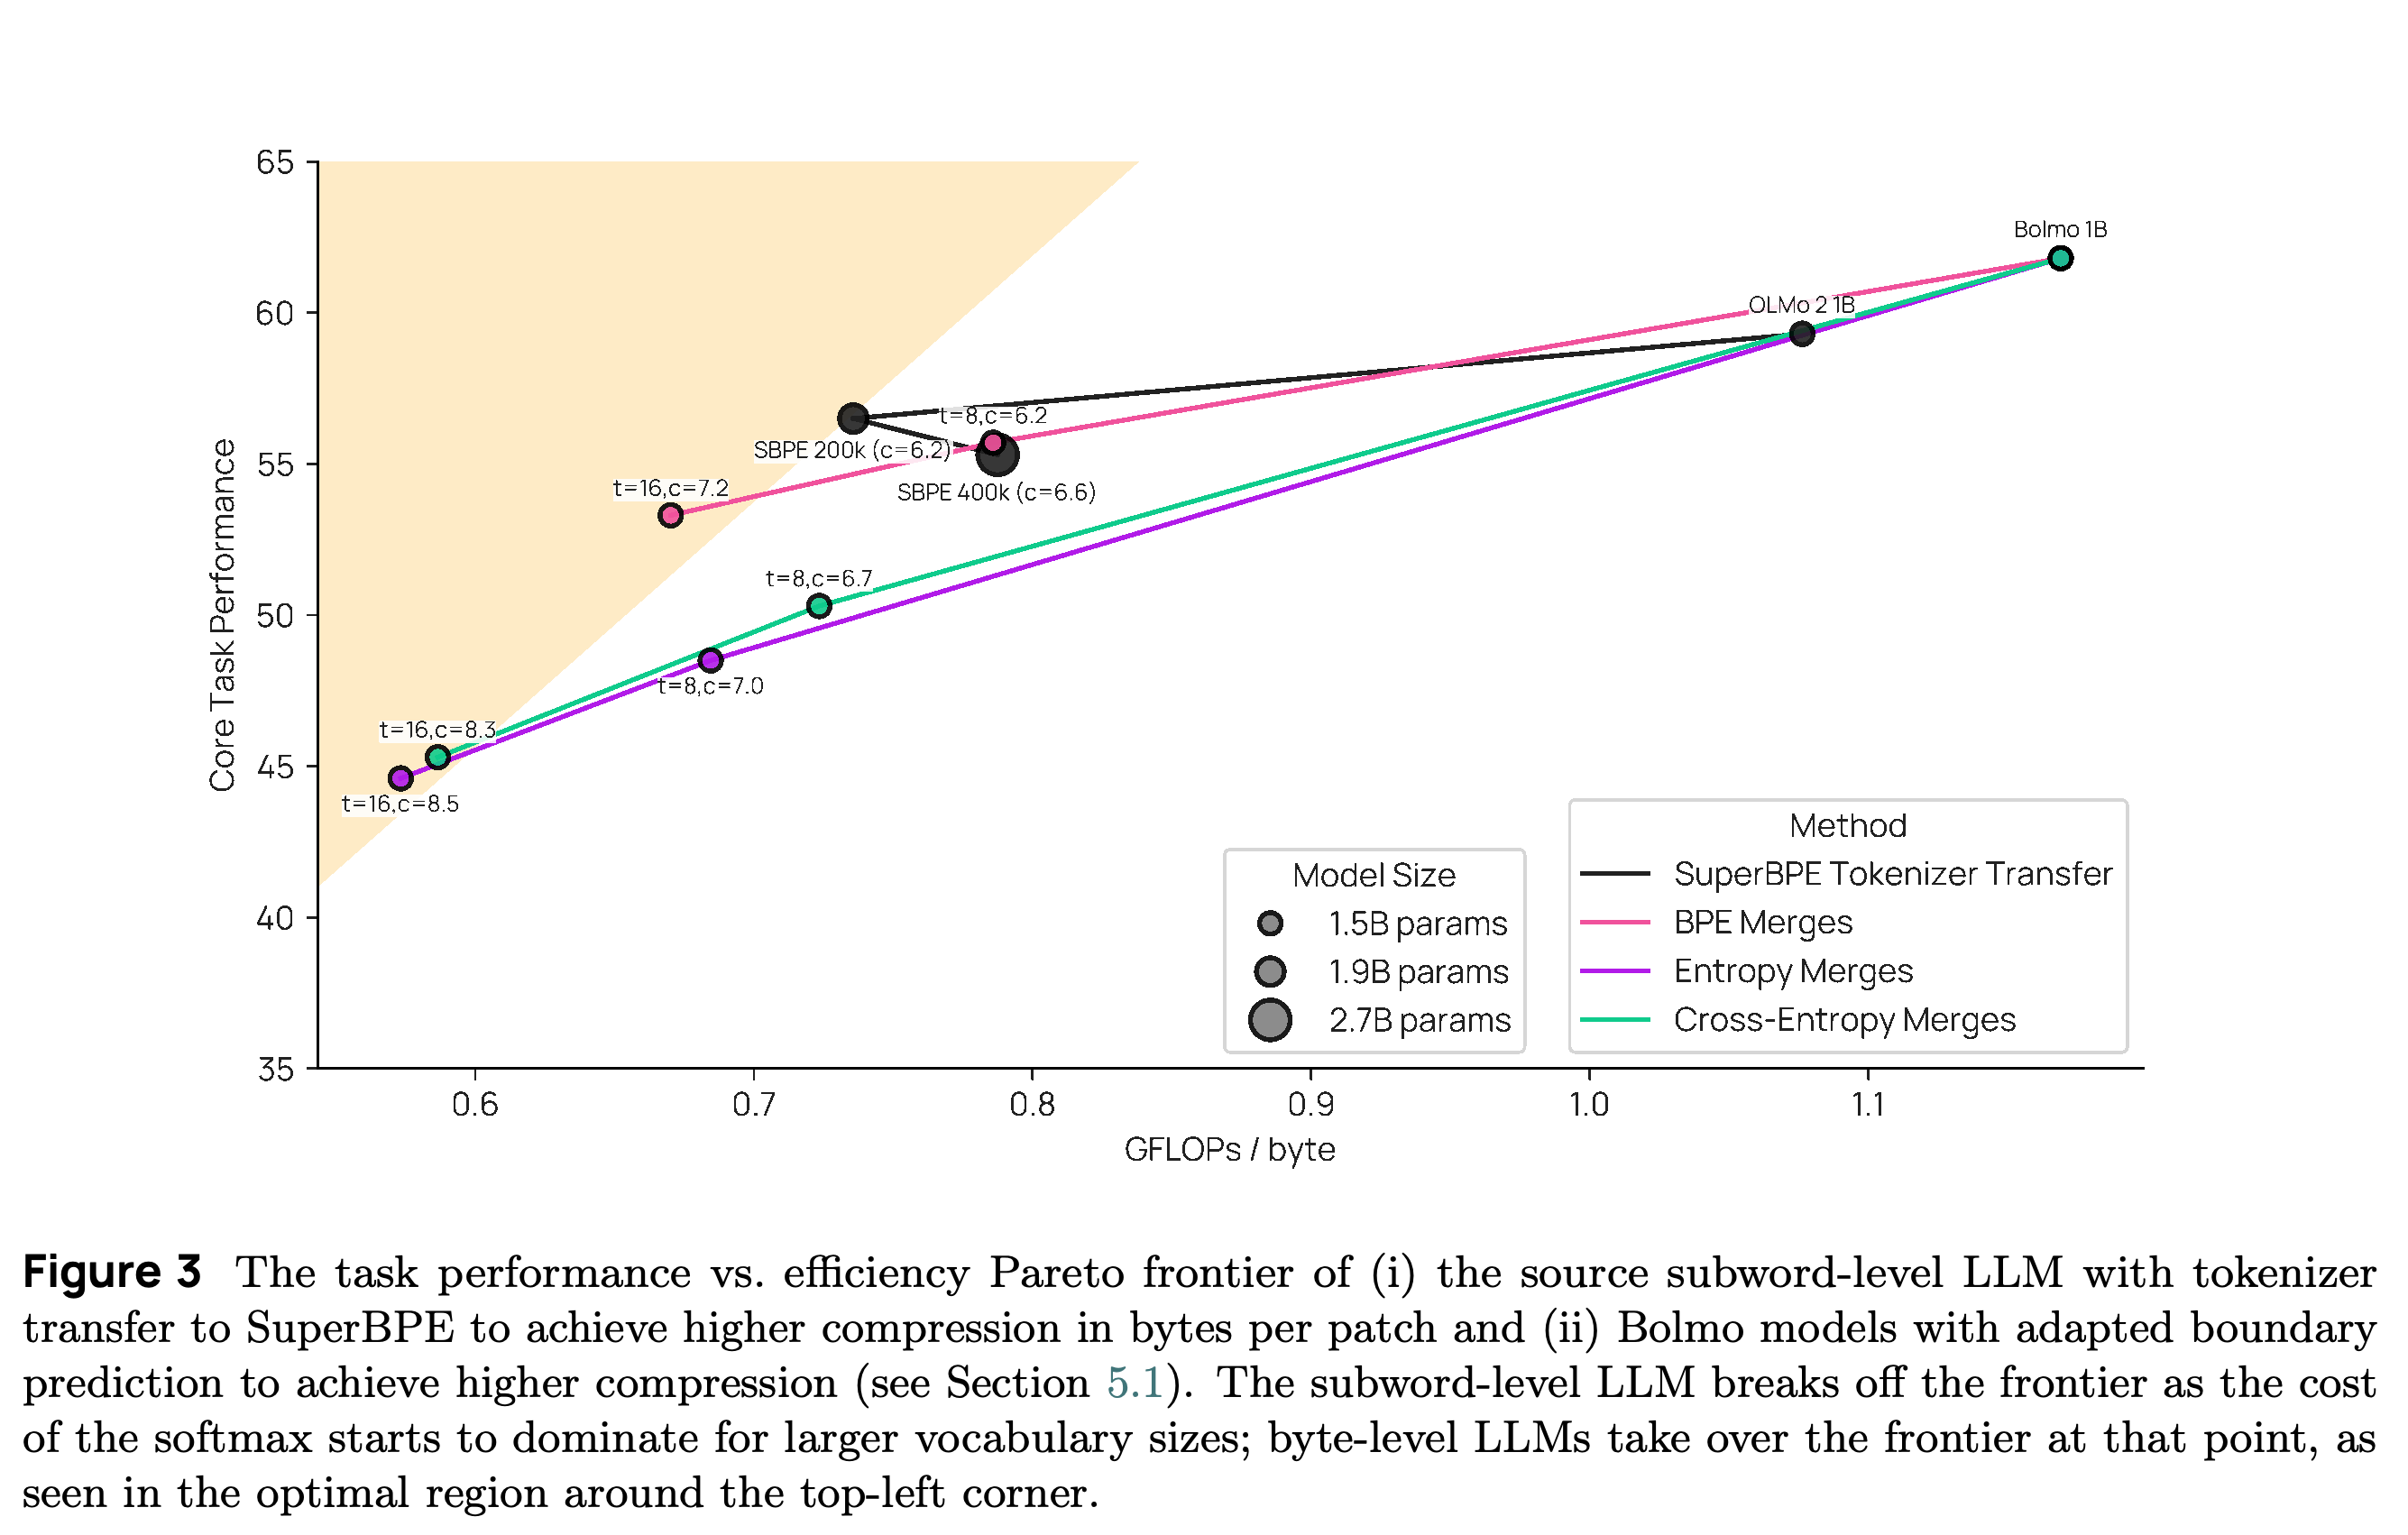
압축률을 높이는 학습에서는 감독 신호의 평균 patch 크기가 목표에 도달할 때까지 원본 subword 경계를 제거한다. 시험한 전략은 각 예제에서 BPE로 빈번한 쌍을 병합하거나, next-token entropy 합이 가장 낮은 쌍을 병합하거나, next-token cross-entropy 합이 가장 낮은 쌍을 병합하는 것이다.
- Entropy와 cross-entropy 감독에는 74.3B 토큰으로 학습한 370M-parameter 보조 모델을 사용한다. 이 모델은 학습할 때만 필요하며 추론에는 사용하지 않는다.
- 경계 감독과 next-byte 예측이 경쟁하므로 목표 압축률 t와 실제 압축률 c는 다르다. 경계 손실의 가중치는 λ_B=4로 유지한다.
- 비교 실험에서는 10GB 텍스트 표본과 FOCUS embedding 초기화를 사용해 OLMo 2를 어휘 크기가 200k와 400k인 SuperBPE로 이전한다. 어휘가 이렇게 커지면 출력 softmax 비용이 subword 모델의 성능과 연산량 사이에서 얻을 수 있는 최선의 절충을 제한한다.
- 시험한 Bolmo 설정에서는 BPE 병합이 가장 유리한 절충을 보인다. 목표 t=16에서 c=7.2를 달성하며, entropy 및 cross-entropy 병합은 c=8.5와 c=8.3을 달성하지만 핵심 과제 성능은 더 낮다. 사전학습 모델과의 근접성으로 이를 설명하는 저자들의 해석은 가설로 남아 있다.
그래프는 실제 실행 시간이 아니라 바이트당 GFLOPs에 따른 핵심 과제 성능의 절충을 측정한다. BPE 감독을 사용한 Bolmo 압축은 시험한 entropy 기반 대안보다 성능을 더 잘 유지한다. SuperBPE 어휘를 200k에서 400k로 늘려도 subword 모델이 얻을 수 있는 최선의 절충은 더 개선되지 않는다.
5.2 Post-Training Byteified Models via Task Arithmetic
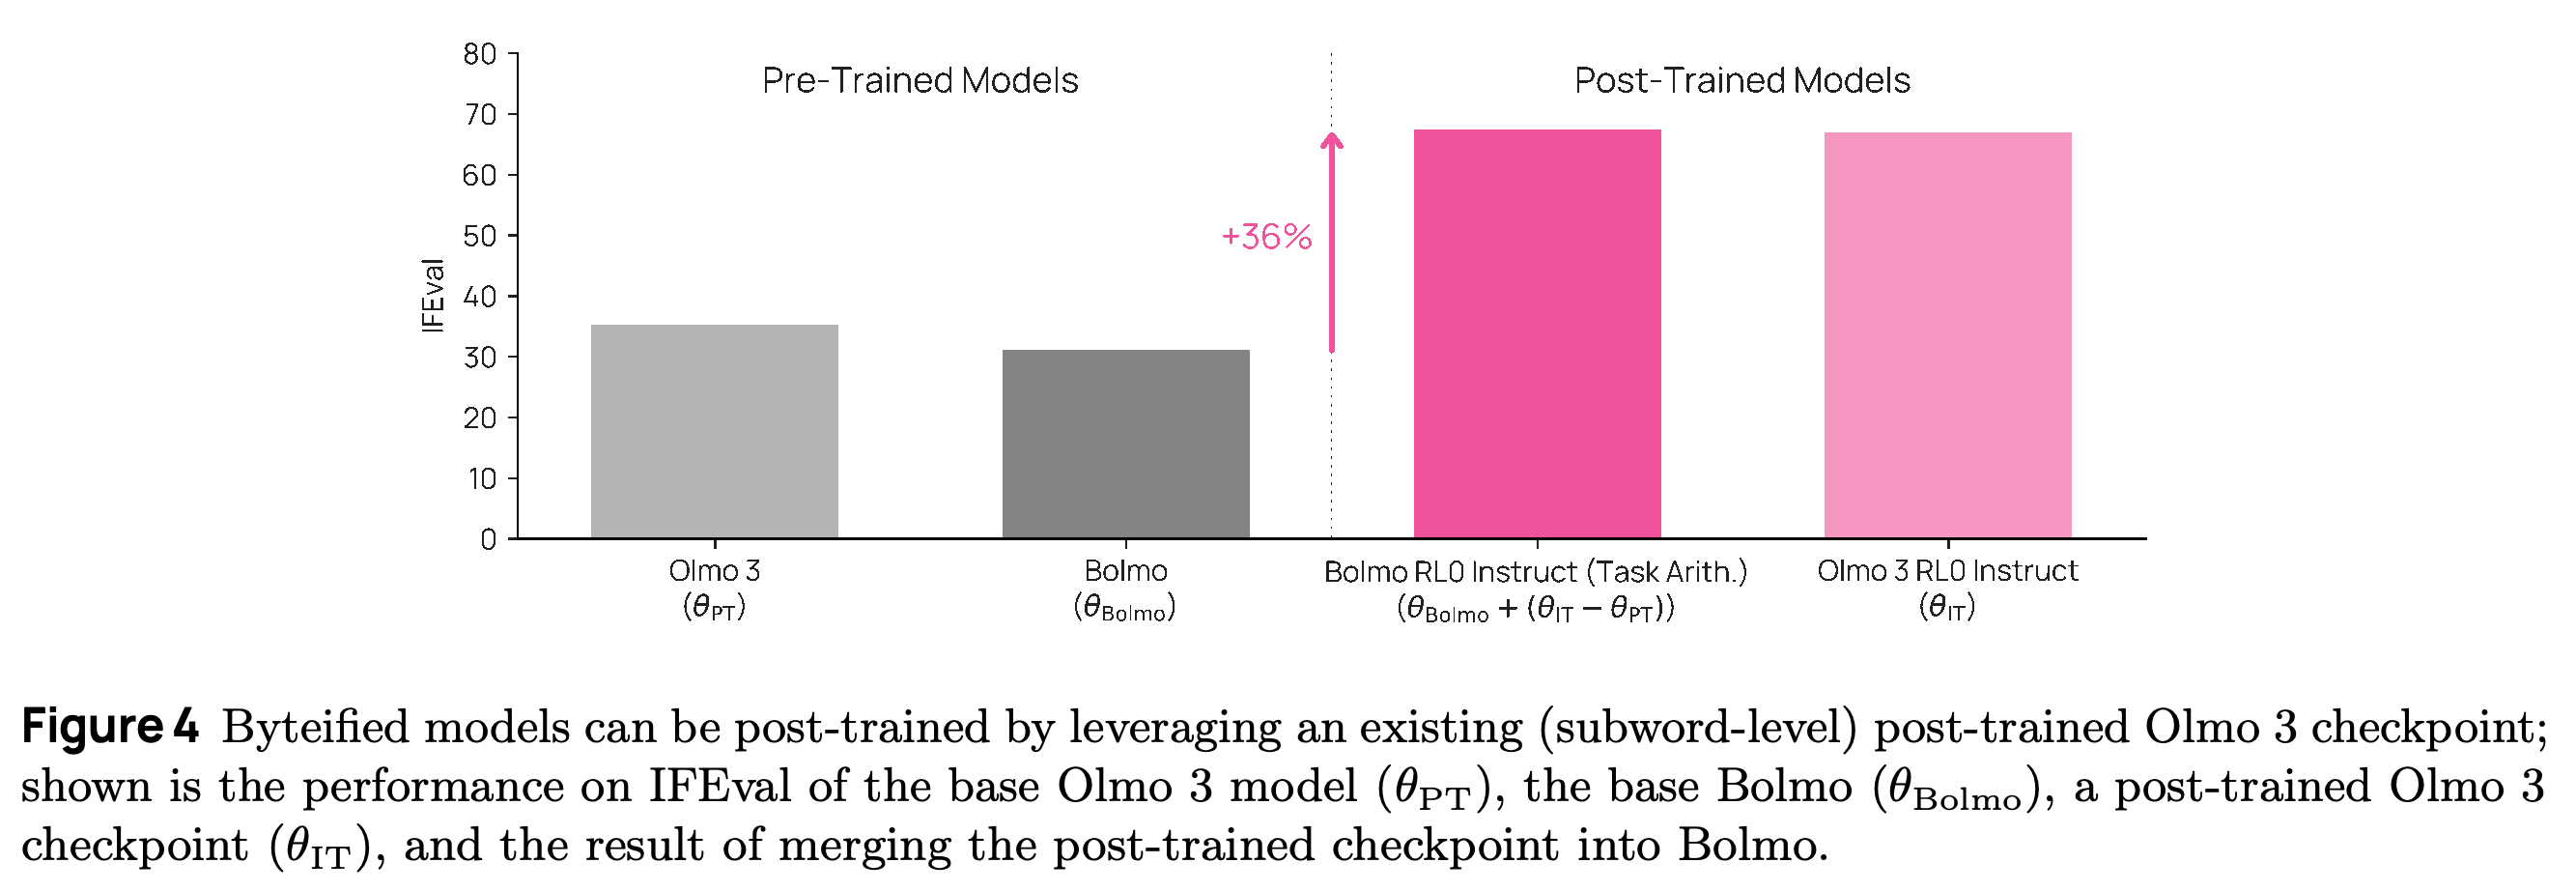
Task Arithmetic은 post-training을 마친 모델과 기본 Olmo 3의 Transformer 가중치 차이를 대응하는 Bolmo Transformer 가중치에 더해 post-training 갱신을 이전한다. RL-Zero instruction-following 사례에서 Bolmo의 IFEval 점수는 31.1%에서 67.4%로 상승한다. 기본 Olmo 3는 35.4%, post-training checkpoint는 66.9%를 기록한다.
- 이 연산은 Bolmo의 추가 학습을 요구하지 않지만, 이미 post-training을 마친 원본 checkpoint를 사용한다.
- 아키텍처 간에 파라미터가 대응하는 부분은 global Transformer뿐이다. Bolmo의 local encoder와 decoder는 기본 모델의 표현 공간에 남아 있다.
- 성공하려면 embedding을 기본 모델의 것으로 되돌릴 수 있어야 한다. 즉, post-training을 마친 Transformer가 기본 입력 및 출력 embedding 공간과 호환되어야 한다. 부록은 이 조건이 모델과 post-training 절차에 따라 달라짐을 보여준다.
원본의 instruction-following 가중치 갱신을 더하면 Bolmo의 IFEval 점수가 31.1%에서 67.4%로 상승해 원본의 post-training checkpoint 점수인 66.9%에 가까워진다. 이는 Bolmo를 추가 학습하지 않고도 시험한 RL-Zero 갱신을 성공적으로 재활용했음을 보여준다.
6 Ablations
Ablation은 non-causal 경계, Stage 1 초기화, local 아키텍처를 시험한다. 경계 정확도와 표현 정렬, 연산량을 대략 맞춘 조건에서의 학습 손실, 실제 추론 지연 시간과 처리량을 비교한다.
6.1 Impact of Non-Causal Patch Boundaries
Causal patch 시작 예측은 경계 label을 정확하게 예측하지만 patch 내용이 1바이트만큼 어긋난다. Causal patch 끝 예측은 내용의 정렬을 유지하지만 얕은 encoder로는 더 어렵다. Non-causal patch 끝 예측은 정확한 경계와 정렬된 표현을 함께 확보하며, causal 설정들보다 downstream 성능이 높다.
- Stage 1 이후 causal patch 끝 예측은 경계 정확도 96.0%와 핵심 과제 평균 42.5를 기록한다. 경계를 융합한 non-causal patch 끝 예측은 정확도 99.2%와 평균 55.6을 기록한다.
- Oracle 경계를 사용하면 경계를 융합한 non-causal 설정의 점수가 57.9로 높아진다. 이는 Stage 1에서 남은 차이의 상당 부분이 경계 오류 때문이라는 저자들의 해석을 뒷받침한다. 다만 이 비교만으로 최종 Stage 2 benchmark에서 발생하는 모든 차이의 원인을 직접 밝히지는 못한다.
- 별도의 non-causal 경계 기호를 사용하면 점수가 55.7로 융합 설정보다 조금 높다. 다만 global 모델을 호출할 때마다 local 모델을 9.8회 호출해야 하며, 융합 설정은 8.8회가 필요하다. 융합은 과제 성능을 거의 동일하게 유지하면서 이 부가 비용을 줄인다.
6.2 Is Stage 1 Training Necessary?
연산량을 대략 맞춘 비교에서 Stage 1은 bits-per-byte를 개선하며, 7B 모델보다 1B 모델에서 효과가 크다. 시험한 예산 안에서는 Stage 1을 생략해도 성능이 심각하게 저하되지는 않는다. 따라서 이 단계는 유용한 초기화를 제공하고 아키텍처 실험 주기를 줄이지만 필수 조건은 아니다.
- 비교에서는 Stage 1의 global 모델 연산량을 순전파 약 2회에 해당하는 양으로, Stage 2는 3회에 해당하는 양으로 추정한다. 따라서 Stage 2만 수행하는 실행에는 9.8B×2/3=6.5B 토큰을 추가해 Stage 2 길이를 17% 늘린다.
- 메모리 사용량은 맞추지 않으며, 저자들은 이 근사가 Stage 2만 수행하는 학습에 유리할 수 있다고 설명한다. Bits-per-byte 개선 폭은 학습이 진행되면서 줄어들지만 시험한 예산 안에서는 유지된다.
- 학습 곡선이 learning-rate schedule과 데이터 구성에 따라 달라질 수 있으므로, 더 큰 예산에서의 결과를 외삽하기는 어렵다.
6.3 Selecting the Right Local Model Architecture for Fast Inference
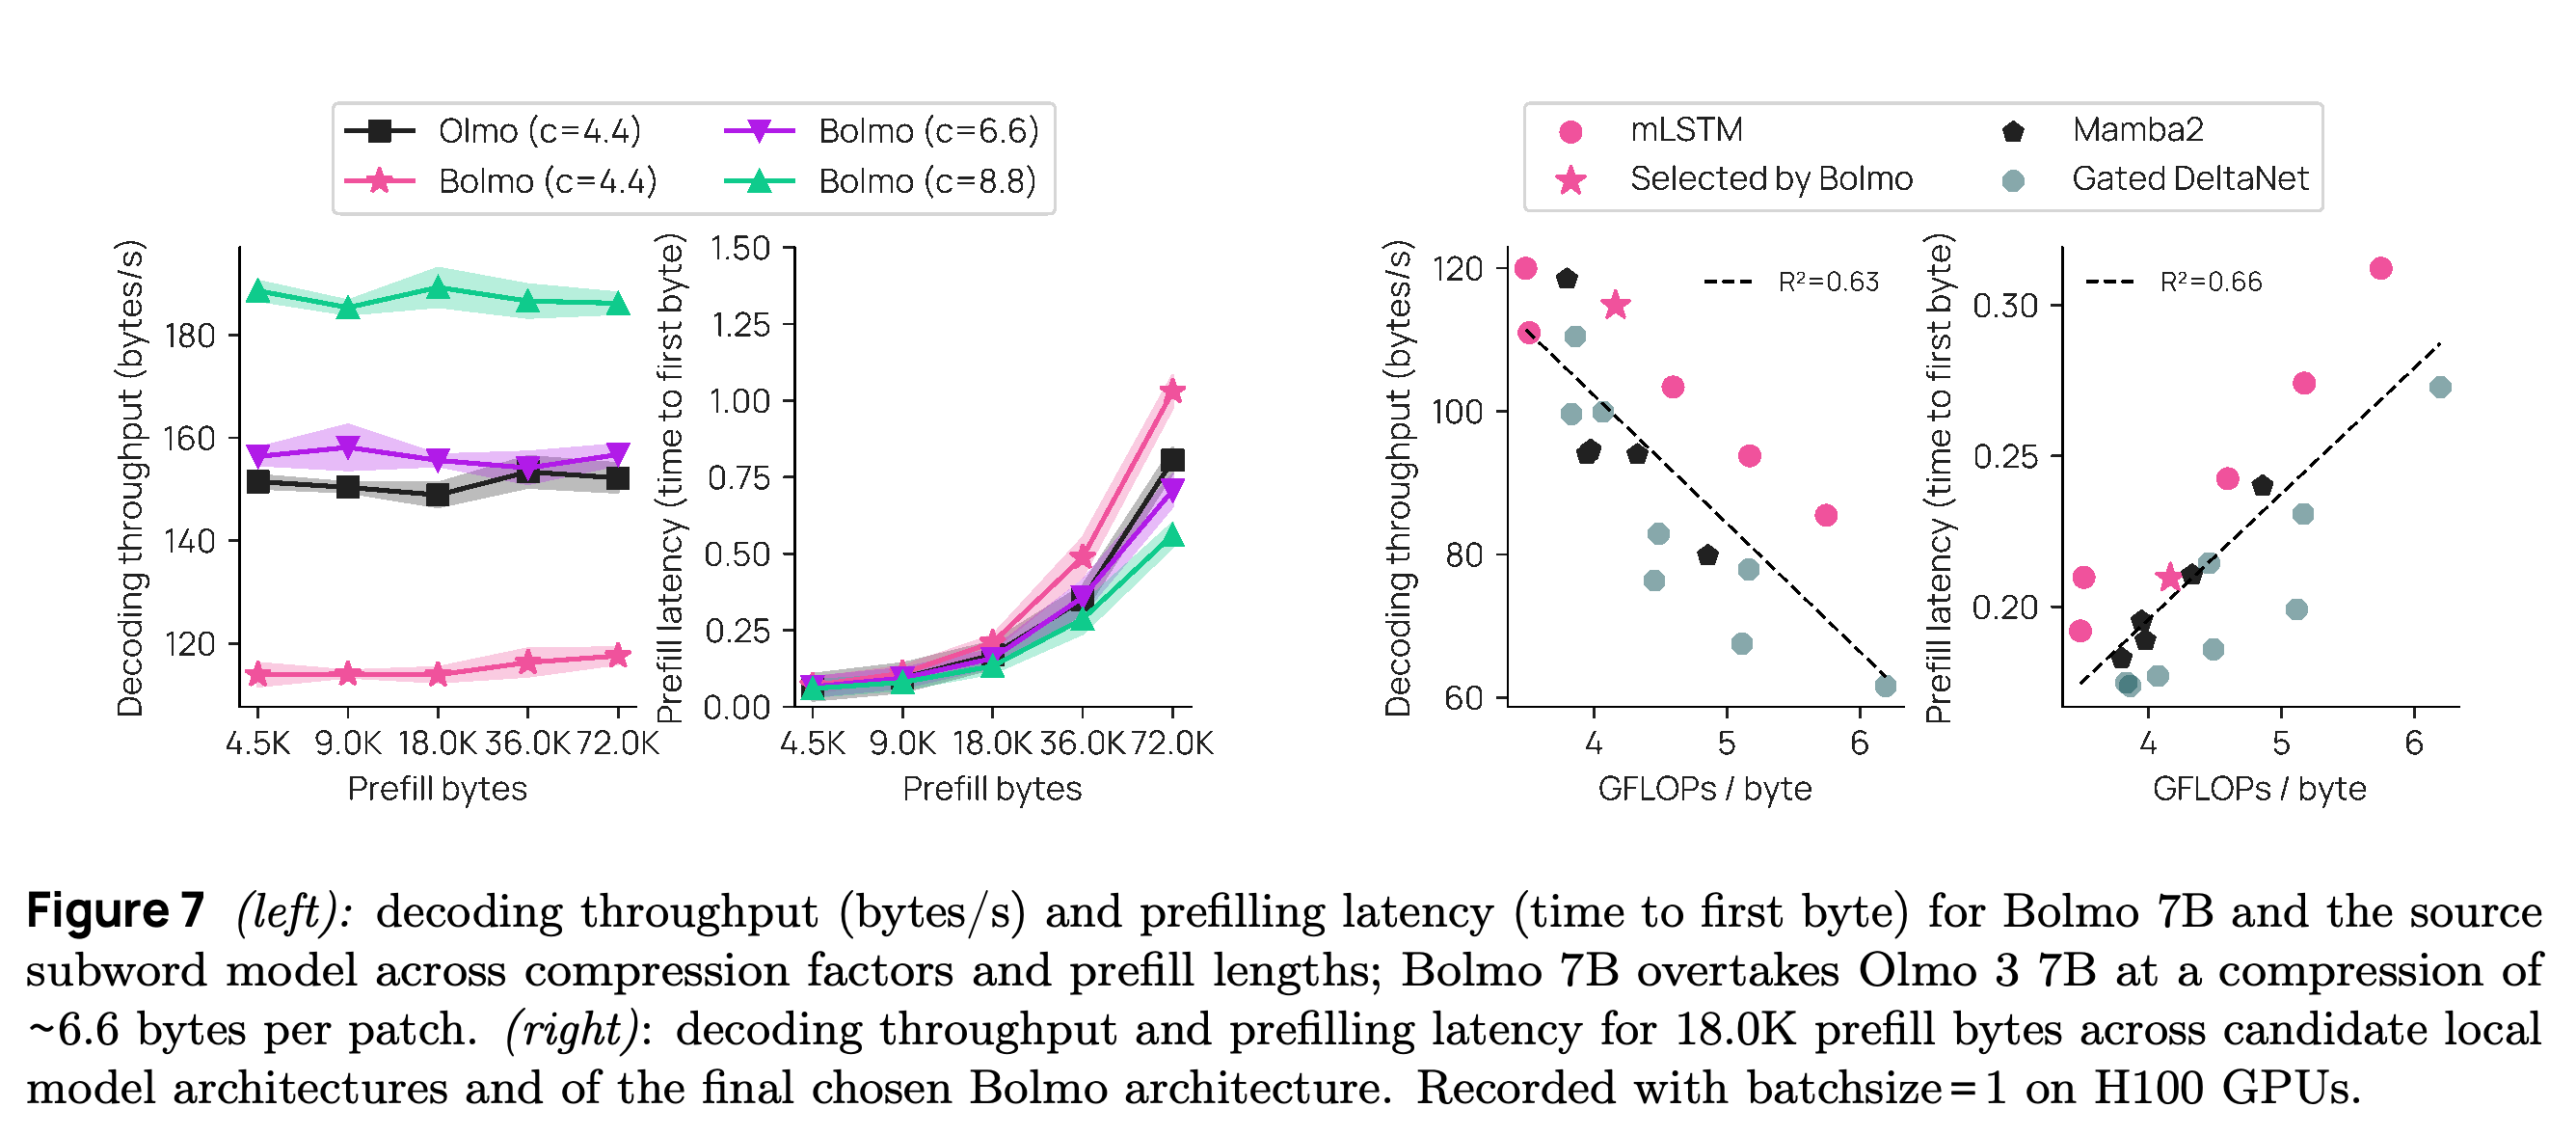
바이트당 FLOPs만으로는 실행 속도를 충분히 예측할 수 없으므로, local 아키텍처는 실제 decoding 처리량과 prefill 지연 시간으로 선택한다. 논문은 H100 GPU에서 batchsize=1로 압축률을 동일하게 맞췄을 때 Bolmo가 약 125 bytes/s, 원본 모델이 약 150 bytes/s를 기록한다고 보고한다. 72K 바이트의 prefill에는 각각 약 1 s와 0.8 s가 걸린다.
- 보고된 추론 측정에서는 Bolmo의 압축률을 patch당 약 6.6바이트로 높이면 원본 모델보다 빨라진다. 압축률을 더 높이면 속도는 향상되지만 과제 성능은 낮아진다.
- Tiled Flash Linear Attention으로 구현한 mLSTM은 바이트당 FLOPs가 비슷한 조건에서 시험한 Mamba2와 Gated DeltaNet보다 decoding 처리량이 높다. 보고된 FLOP와 속도 사이의 회귀 분석에서 R²는 약 0.63–0.66이다.
- Embedding lookup을 dense one-hot 행렬 곱셈으로 계산하면 FLOP 집계가 비교를 왜곡할 수 있다. 속도 측정 결과는 시험한 하드웨어와 구현에 적용되며, 효율적인 batch serving은 향후 과제로 남아 있다.
왼쪽 패널은 보고된 추론 측정에서 Bolmo가 patch당 약 6.6바이트에서 원본 모델보다 빨라짐을 보여준다. 오른쪽 패널은 local 아키텍처 간 바이트당 FLOPs가 비슷해도 처리량과 지연 시간이 다름을 보여준다. 이는 H100 batchsize=1 조건에서 실제 실행 속도로 아키텍처를 선택하는 근거가 된다.
7 Conclusion
결론은 byteification을 byte-level 모델을 처음부터 학습하는 방식의 보완책으로 제시한다. 실험은 원본 모델의 benchmark 성능을 상당 부분 복원하고, 문자 이해를 개선하며, patch 압축률을 조절할 수 있음을 보여준다. 또한 호환되는 post-training 갱신 1개를 이전한다. 원본 모델 대비 성능은 여전히 과제에 따라 다르다.
8 Future Directions
Future Directions에서 제시한 8개 연구 방향은 아키텍처를 처음부터 학습하기, non-causal 경계를 end-to-end로 학습하기, patch 크기와 local 용량을 함께 확장하기, multi-byte 예측, 기존 능력의 손실을 줄이는 추가 학습, LTLM 전용 sampling, 대안적인 최소 입력 단위, batch 추론 최적화다.
- 현재 경계 예측기는 외부 label을 사용하며, decoder는 바로 다음 바이트만 예측한다. 아키텍처를 처음부터 학습하거나 multi-byte 예측을 사용할 때 얻는 이점은 이 연구에서 시험하지 않았다.
- 논문은 망각을 줄이기 위한 PEFT 방법과 생성 동작을 조사하기 위한 patch 위치별 sampling을 제안한다.
- UTF-8 인코딩의 편향은 미해결로 남아 있다. 효율적인 batching에서는 바이트와 잠재 patch 사이의 가변적인 대응 관계도 처리해야 한다. 논문은 관련 인프라로 https://github.com/Aleph-Alpha/vllm 을 제시한다.
부록
- A Additional Ablations는 oracle 경계와 학습된 경계를 비교하고, byteification과 일반적인 추가 학습을 비교한다. Oracle 경계는 Stage 1의 차이를 크게 줄이며, Bolmo Mix로 추가 학습하는 것만으로도 원본 모델의 여러 능력이 저하된다. Bolmo는 추가 학습 대조군보다 문자 이해가 높지만, 다른 범주에서는 차이가 남아 있다.
- B Benchmark Details는 7B 및 1B 평가 모음의 OLMES 평가 형식, few-shot 조건, 지표, sampling 파라미터를 명시한다. 본문의 실험 설정은 BigCodeBench를 제외한다고 설명하지만, 부록의 평가 명세에는 이를 포함한다. 주요 결과 표에는 BigCodeBench 점수가 없다.
- C CUTE-Style Training Data는 https://github.com/Leukas/CUTE 를 사용해 150000개 단어에서 생성한 약 75M 토큰의 합성 데이터를 설명한다. 이는 혼합 데이터의 약 0.04%이며, CUTE 테스트 단어와의 중복은 0개다. 영어로만 구성된 과제에는 철자 쓰기, 역순 변환, 문자 교환, 삭제, 치환이 포함되지만 다국어 EXECUTE에서도 성능이 향상된다. 저자들은 이 데이터가 없으면 byte-level 모델이 짧은 학습 일정 안에서 이러한 문자 지식을 습득하지 못한다고 보고한다.
- D Does Post-Training Byteified Models via Task Arithmetic Always Work?는 Olmo, Qwen, Gemma, Llama 모델에서 Tulu 3 예제의 cross-entropy를 사용해 embedding을 되돌리는 효과를 조사한다. 호환성은 크게 달라지며, Olmo 3 RL-Zero models는 특히 성능을 잘 유지한다. 모델 크기와의 관계가 약하다는 결과만으로 일반적인 이전 성공을 보장할 수는 없다.
- E Embedding Rank Analysis는 시험한 입력 및 출력 embedding 행렬 대부분에서 상당한 high-rank 구조를 확인한다. Qwen3-4B-Base의 입력 embedding은 두드러진 예외다. 차원이 낮은 local 표현을 선형 up-projection하면 rank에 엄격한 상한이 생기므로, Bolmo는 local 차원과 global 차원을 같게 설정한다.
- F Full Hyperparameters는 mLSTM과 FFN을 결합한 encoder 단일 층과 decoder 네 층을 명시하며, SwiGLU와 RMSNorm을 사용한다. 크기가 다른 2개 모델 모두 Stage 1단계는 batch size 32로 75K step, Stage 2단계는 batch size 64로 150K step을 학습한다. AdamW, weight decay 0.1, β_1=0.9, β_2=0.95, 최대 gradient norm 0.5를 사용하며, warmup 이후 선형 learning-rate schedule을 적용한다. Tables 7과 8은 모델별 차원, learning rate, H100 학습 실행에서 추정한 가속기당 처리량도 제공한다.
짧은 생각
경계 ablation은 Bolmo의 아키텍처 선택을 가장 명확하게 뒷받침한다. Patch 표현이 원본 모델과 정렬되지 않으면 정확한 label만으로는 충분하지 않다. 추가 학습 대조군은 변환 효과와 적응 효과를 구분하는 데 도움이 되며, 원본 모델에 동일한 맞춤 학습 데이터를 제공해도 Bolmo의 문자 이해 우위가 유지됨을 보여준다. Byteification은 기존 모델에 투입된 사전학습 자원을 재활용한다. 실험에서는 byte-level 모델을 처음부터 학습하는 방식과 총 개발 비용을 비교하지 않는다. 문자 이해 향상은 합성 학습 과제에 부분적으로 의존하며, 코드의 pass@16 향상은 대체로 낮아진 pass@1과 함께 나타난다. 이 결과가 byte-level 모델링의 보편적인 우위를 입증하지는 않는다. 속도 결과는 시험한 H100 batchsize=1 설정에 적용된다. 실제 서비스에서의 효율적인 batching, 더 다양한 원본 모델로의 이전, 임의의 post-training 갱신을 안정적으로 재활용하는 방법은 미해결 과제로 남아 있다.