Paper2Rebuttal: A Multi-Agent Framework for Transparent Author Response Assistance 요약 설명
20 Jan 2026 | Paper Review Rebuttal Generation Multi-Agent Coordination Rubric-Based Evaluation목차
- 요약
- 1 Introduction
- 2 Related Works
- 3 RebuttalAgent
- 4 RebuttalBench
- 5 Experiments
- 6 Conclusion
- Limitations and Future Work
- Broader Impact and Ethics Statement
- 부록
- 짧은 생각
이번 글에서는 Paper2Rebuttal: A Multi-Agent Framework for Transparent Author Response Assistance 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 1월 20일(Arxiv)
- Ma, Qianli, Guo, Chang, Tian, Zhiheng, Wang, Siyu, Xiao, Jipeng, Yue, Yuanhao, Zhang, Zhipeng.
- AutoLab, School of Artificial Intelligence, Shanghai Jiao Tong University
- 논문 링크
- Github
- Project Page
요약
- Paper2Rebuttal은 rebuttal 작성을 곧바로 텍스트를 생성하는 작업이 아니라 근거를 정리하고 응답을 계획하는 작업으로 다루는 RebuttalAgent를 소개한다. 이 시스템은 리뷰어의 우려를 개별 쟁점으로 추출하고, 각 쟁점에 맞는 원고 구절과 외부 근거 요약을 결합한다. 초안을 작성하기 전에는 저자가 검토할 수 있는 응답 계획을 점검한다.
- RebuttalBench는 ICLR 2023 토론 데이터를 사용하며, 챌린지 세트는 논문 20편과 다중 턴 평가 사례 106개로 구성된다. 동일한 모델 백본을 사용하고 전 과정을 자동으로 실행했을 때, RebuttalAgent는 직접 텍스트를 생성하는 프롬프팅보다 보고된 루브릭 항목 9개 모두에서 높은 점수를 얻었다. 특히 Coverage와 Specificity가 크게 개선되었다. Table 1에 보고된 전체 점수 상승 폭은 +0.38에서 +0.57이지만, 일부 종합 점수는 표에 나열된 항목 점수의 평균과 다르다.
- 연구자 9명과 리뷰-rebuttal 테스트 샘플 33개를 대상으로 한 저자 평가 연구는 생성된 응답의 유용성을 뒷받침한다. 사람 평가와 자동 평가 점수의 일치도는 Kendall τ = 0.646으로 보고되었다. 다만 이 결과가 사실적 신뢰성을 보장하지는 않는다. checker 제거 실험의 효과는 엇갈리며, 제시된 응답 사례는 측정값 없이 r > 0.9를 주장한다.
1 Introduction
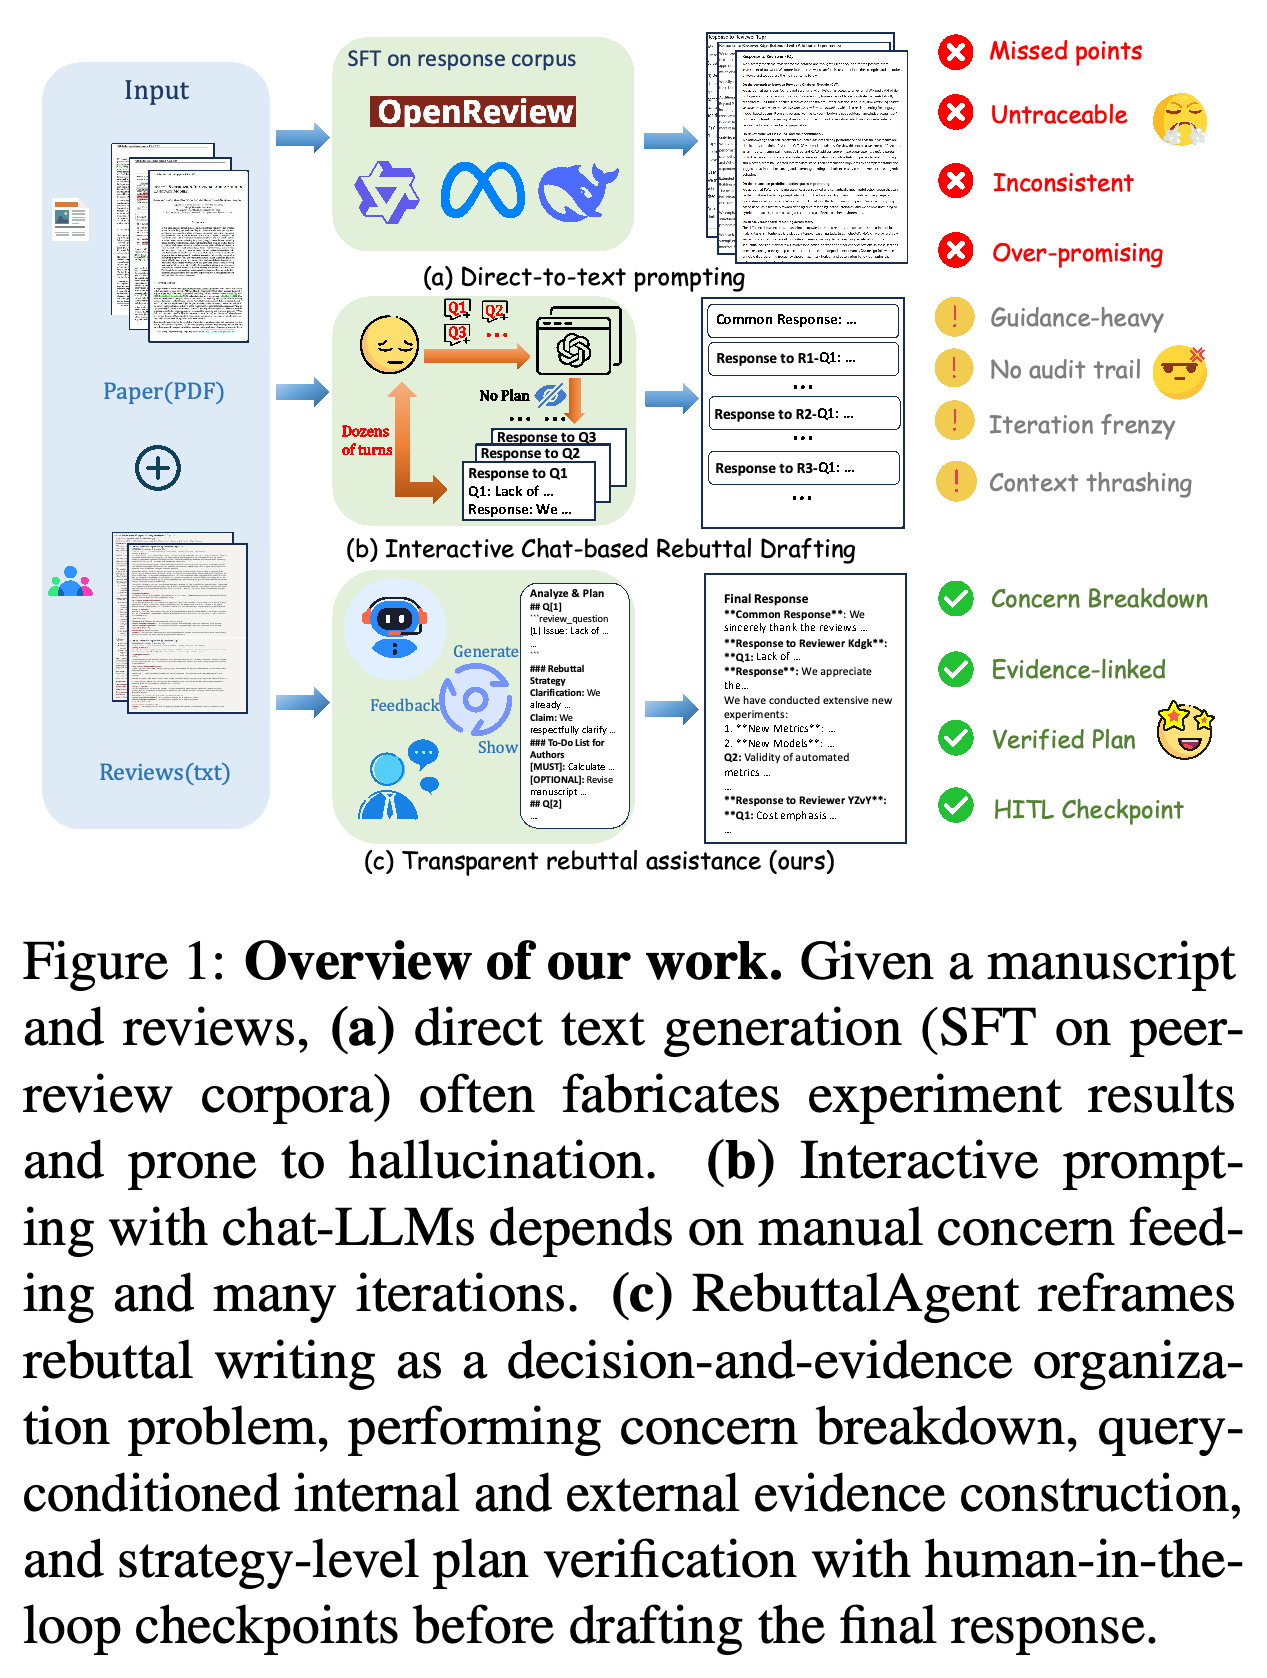
서론은 신뢰할 수 있는 rebuttal 지원에 필요한 요건 4개를 제시한다. 이 요건은 Comprehensive Coverage, Strict Faithfulness, Verifiable Grounding, Global Consistency다. 직접 텍스트를 생성하면 비판을 누락하거나 결과를 지어낼 수 있다고 주장한다. 대화형 워크플로는 저자가 반복해서 지침을 제공해야 하며, 검토 가능한 과정을 반드시 드러내는 것도 아니라고 지적한다.
- RebuttalAgent는 “verify-then-write” 워크플로를 통해 근거 수집과 전략적 결정을 최종 문장 작성에서 분리한다.
- Human-in-the-loop 점검 단계에서는 쟁점 목록, 근거 링크, 응답 계획을 저자에게 보여준다. 저자는 초안 작성 전에 제안된 작업 약속을 수정할 수 있다.
- 관련 자료는 https://Paper2Rebuttal.github.io 및 https://huggingface.co/spaces/RebuttalAgent 에 안내되어 있다.
워크플로 3개는 최종 문장을 생성하기 전에 쟁점, 근거, 작업 약속을 드러내는지에서 차이가 난다. 이 도식은 저자의 통제와 과정 검토가 필요한 이유를 보여준다. 다만 나열된 실패 유형과 장점은 측정된 결과가 아니라 개념적 주장이다.
2 Related Works
관련 연구 절은 이 프레임워크를 도구를 사용하는 LLM 에이전트, 역할별로 전문화된 멀티 에이전트 시스템, AI 기반 동료 심사 지원과 연결한다. DISAPERE, APE, Re2는 담화 정렬이나 토론 코퍼스를 제공한다. 반면 RebuttalAgent는 쟁점에서 근거를 거쳐 계획으로 이어지는 명시적 워크플로를 강조한다.
- 에이전트 연구는 추론에 검색, 도구 사용, 메모리, 실행 피드백을 결합한다. 멀티 에이전트 시스템은 전문화된 역할에 작업을 분배한다.
- 논문은 기존 rebuttal 방법이 쟁점 분해와 근거 기반 계획을 충분히 드러내지 않는다고 주장한다. 이는 연구의 차별점을 설명하는 주장이며, 모든 기존 시스템을 포괄적으로 실험 비교한 결과는 아니다.
3 RebuttalAgent
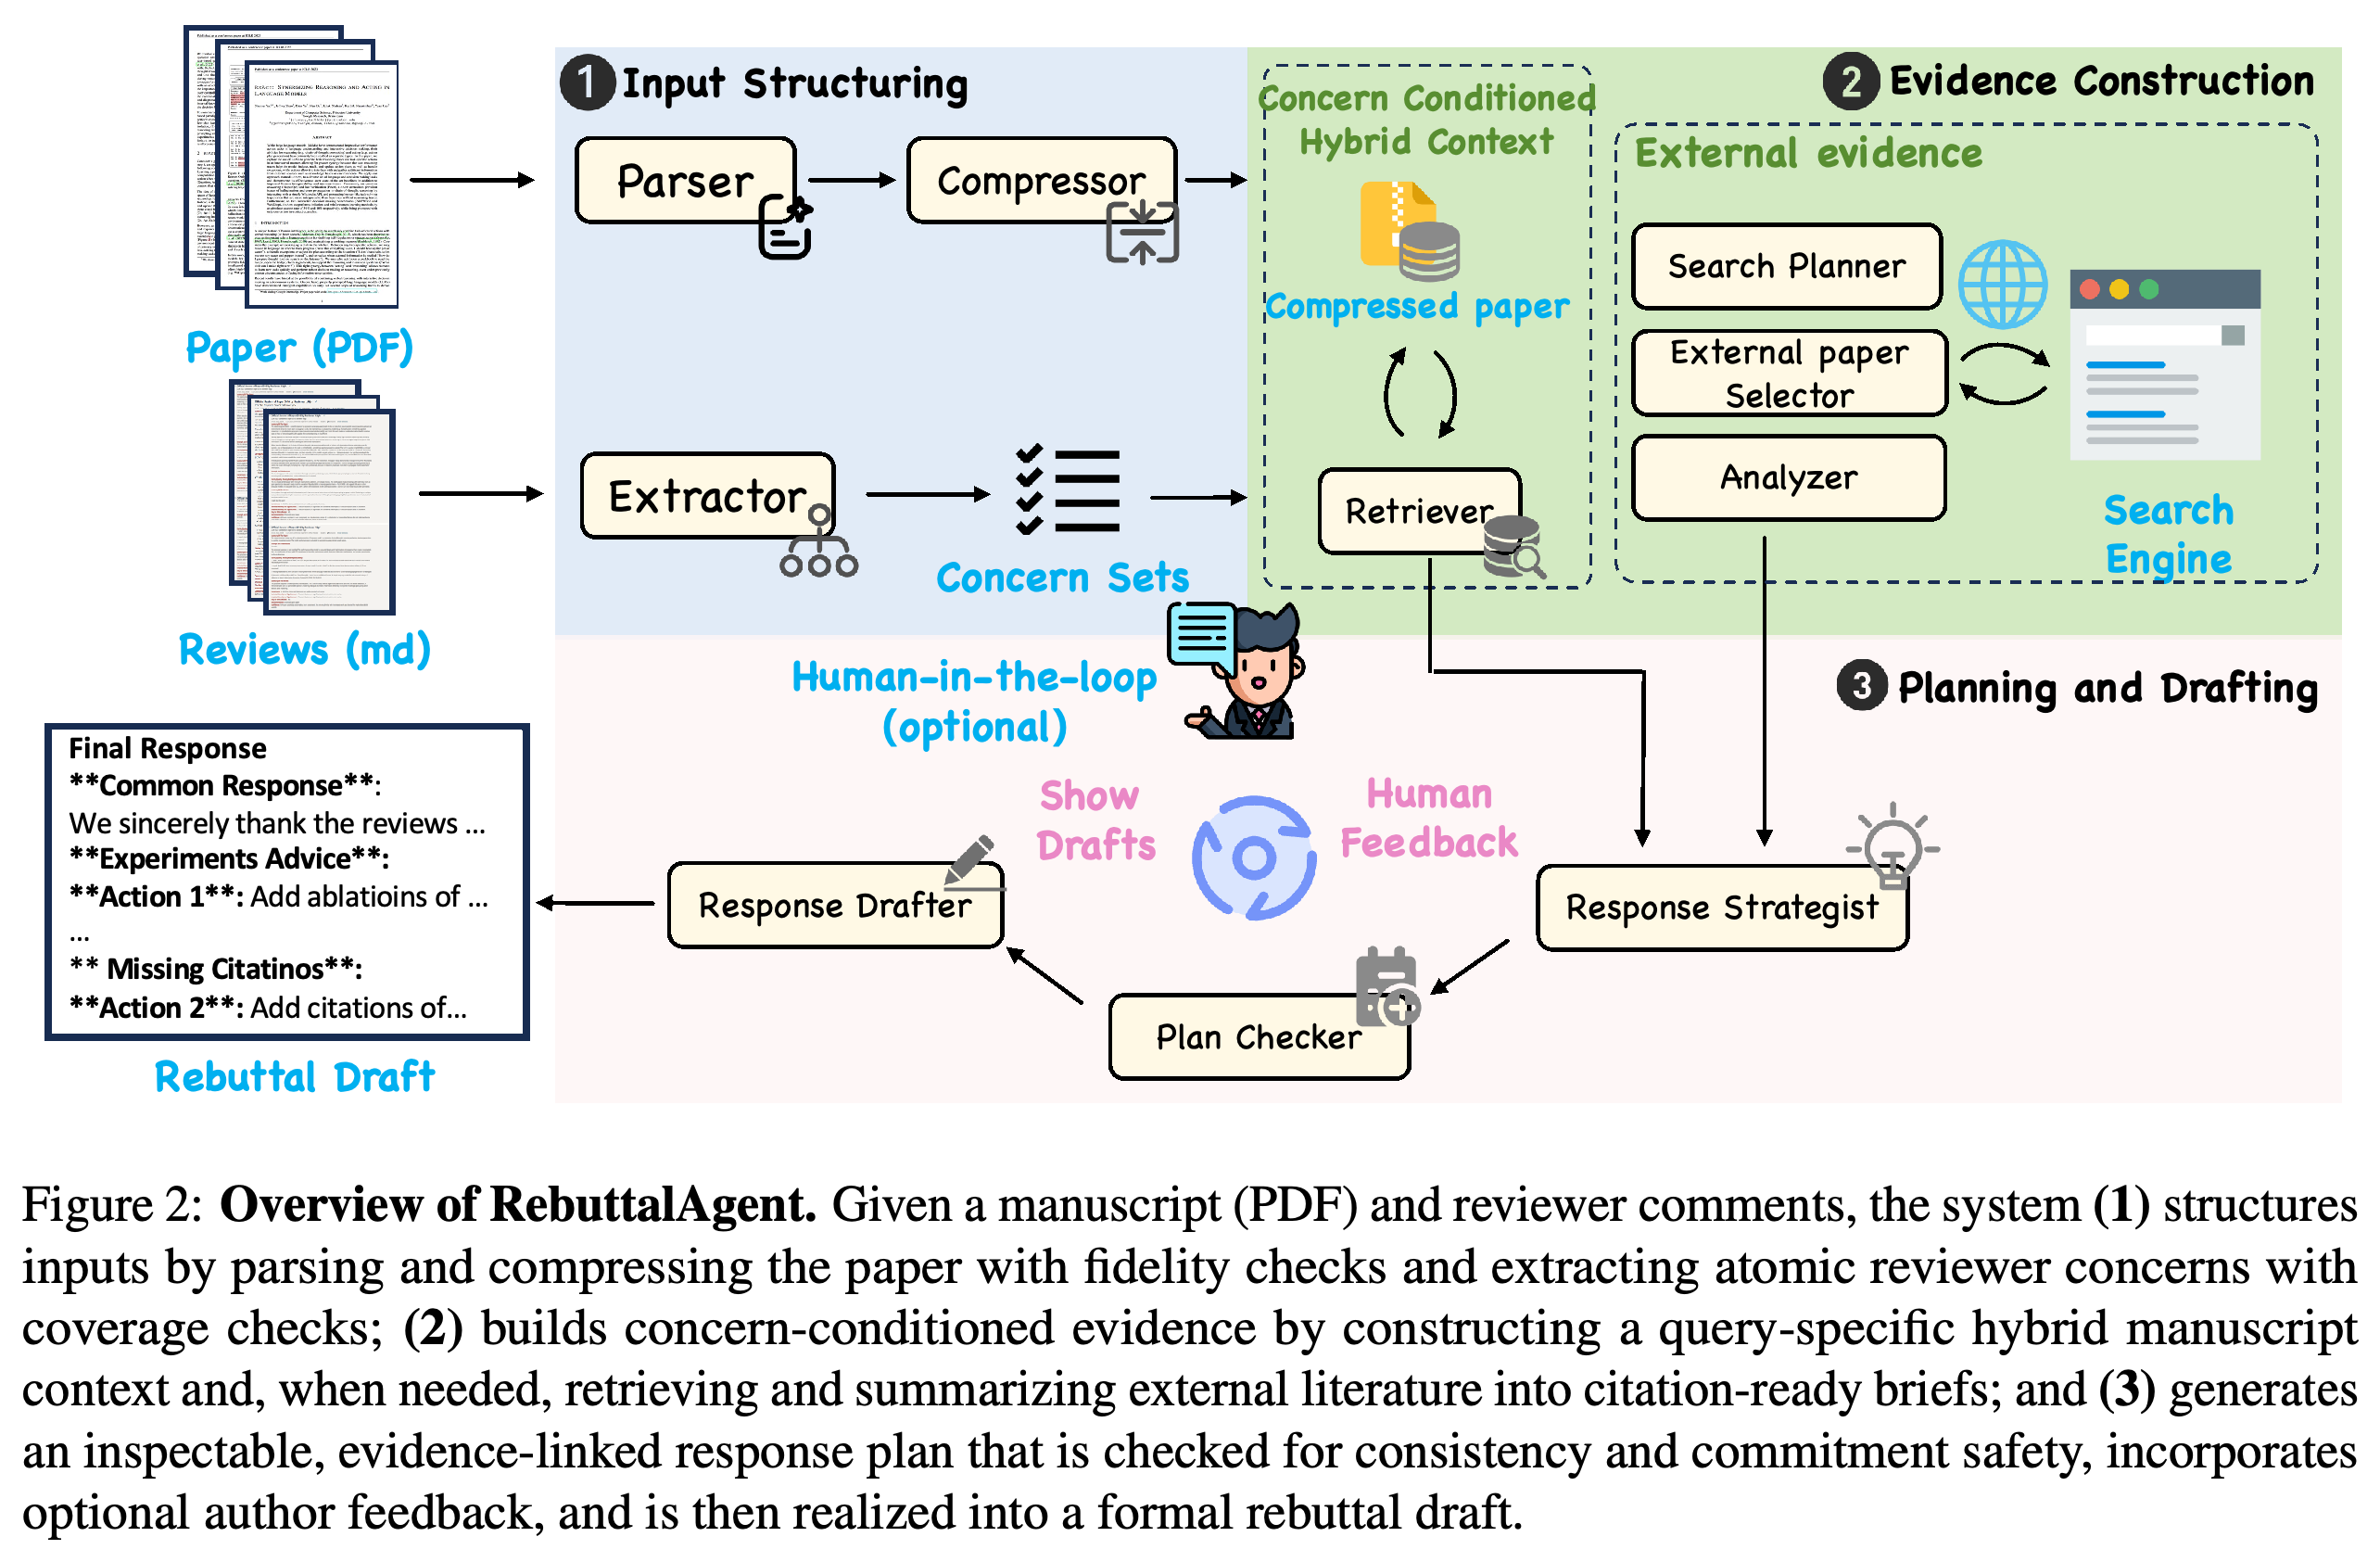
RebuttalAgent는 Manuscript and Review Structuring, Evidence Construction, Planning and Drafting의 3단계로 구성된다. 전문화된 에이전트가 중간 산출물을 만들고, checker는 원문 충실성, 쟁점 포괄성, 근거 연결, 일관성을 검사한다. 선택적으로 저자 피드백을 받아 응답 전략을 수정한다.
- 이 연구의 기여는 추론 시점의 워크플로이며, 새로 학습한 언어 모델이 아니다.
- 과학적 주장, 작업 약속, 최종 표현에 대한 책임은 저자에게 있다.
원고 압축과 쟁점 추출 결과는 근거를 구성하는 경로 2개로 전달된다. 각 경로는 원고의 원문 구절을 선택적으로 복원하거나 외부 문헌을 검색한다. 이 경로들은 응답 전략 수립 단계에서 합쳐지며, 이후 계획 점검, 선택적인 저자 피드백, 초안 작성을 거친다.
3.1 Manuscript and Review Structuring
parser는 원고를 문단별 인덱스가 붙은 텍스트로 변환한다. compressor는 기술적 진술과 실험 결과를 보존하는 압축 표현을 만든다. consistency checker는 압축된 단위를 원문과 비교하고, 누락된 주장이나 의미 변화를 발견하면 재처리를 요청한다.
- 압축 표현은 원고를 탐색하고 검색하는 데 사용한다. 이후 모듈은 여전히 원래 구절을 복원할 수 있다.
- 이와 병행하여 extractor는 리뷰를 개별 쟁점으로 변환한다. 관련 질문을 묶되, 독립적으로 답할 수 있는 문제는 유지한다.
- coverage checker는 리뷰어의 의도와 쟁점의 세분화 수준을 검사하여 누락, 과도한 분할, 부적절한 병합을 줄인다.
3.2 Evidence Construction
시스템은 각 개별 쟁점에 관련된 압축 원고 단위를 찾고, 이를 대응하는 원문 구절로 대체한다. 이렇게 만든 하이브리드 문맥은 원고 전체를 간결하게 보여주면서 해당 쟁점에 필요한 상세한 근거도 제공한다.
- 독창성 논쟁, 참고문헌 요청, 베이스라인 비교처럼 원고의 근거가 부족한 경우 외부 검색을 수행한다.
- search planner가 검색어를 만들고, screening agent가 유용한 논문을 선택한다. analyzer는 관련 주장과 비교 내용을 정리하여 인용에 사용할 수 있는 근거 요약을 만든다.
- 논문에 명시된 학술 검색 엔드포인트는 https://export.arxiv.org/api/query 다.
3.3 Planning and Drafting
Strategist Agent는 기존 근거를 해석하여 방어할 수 있는 쟁점과 새로운 실험이나 분석이 필요한 쟁점을 구분한다. 추가 작업이 필요한 경우에는 결과가 아니라 Action Items를 생성하도록 지시받는다. 계획을 점검한 뒤, 초안 작성 전에 저자 피드백으로 수정할 수 있다.
- 저자는 제안된 작업의 범위를 줄이거나 논리를 수정하여 자신의 역량과 의도한 입장에 맞출 수 있다.
- 제출용 초안에서는 저자가 검증된 값을 제공할 때까지 확보하지 못한 수치 결과를 [TBD]로 표시해야 한다.
- 이러한 통제는 워크플로의 안전장치이지 정확성을 형식적으로 보장하는 수단은 아니다. 주요 실험에서는 저자 개입을 생략한다.
4 RebuttalBench
RebuttalBench는 실제 리뷰-응답 상호작용에 관련성, 논증, 의사소통을 평가하는 루브릭을 결합한다. 문장의 유창성이나 단일 참조 rebuttal과의 유사성보다 쟁점에 실질적으로 대응하는지, 근거가 응답을 뒷받침하는지를 평가한다.
4.1 Evaluation Dataset
RebuttalBench-Corpus는 공개 ICLR 토론에서 얻은 약 9.3K개의 리뷰-rebuttal 쌍으로 구성된다. Appendix A는 데이터 출처를 Re2의 ICLR 2023 부분집합으로 명시하며, 약 9,310개 항목이라고 설명한다. 챌린지 세트는 해결된 쟁점과 해결되지 않은 쟁점이 모두 있고 리뷰어 참여가 충분한 논문을 우선 선정하여, 논문 20편과 다중 턴 사례 106개로 구성한다.
- 리뷰어의 후속 의견과 점수 변화는 결과를 판단하는 신호를 제공한다. 신뢰도 등급은 이 신호의 신뢰성을 나타낸다.
- Tier 1은 객관적 메타데이터나 명시적인 수정 진술을 사용한다. Tier 2는 신뢰도가 높은 텍스트 신호를 사용하며, Tier 3 cases는 모호한 사례에 해당한다.
- 본문은 모호한 사례를 제거한다고 설명하지만, Appendix D는 스트레스 테스트를 위해 일부를 남긴다고 명시한다.
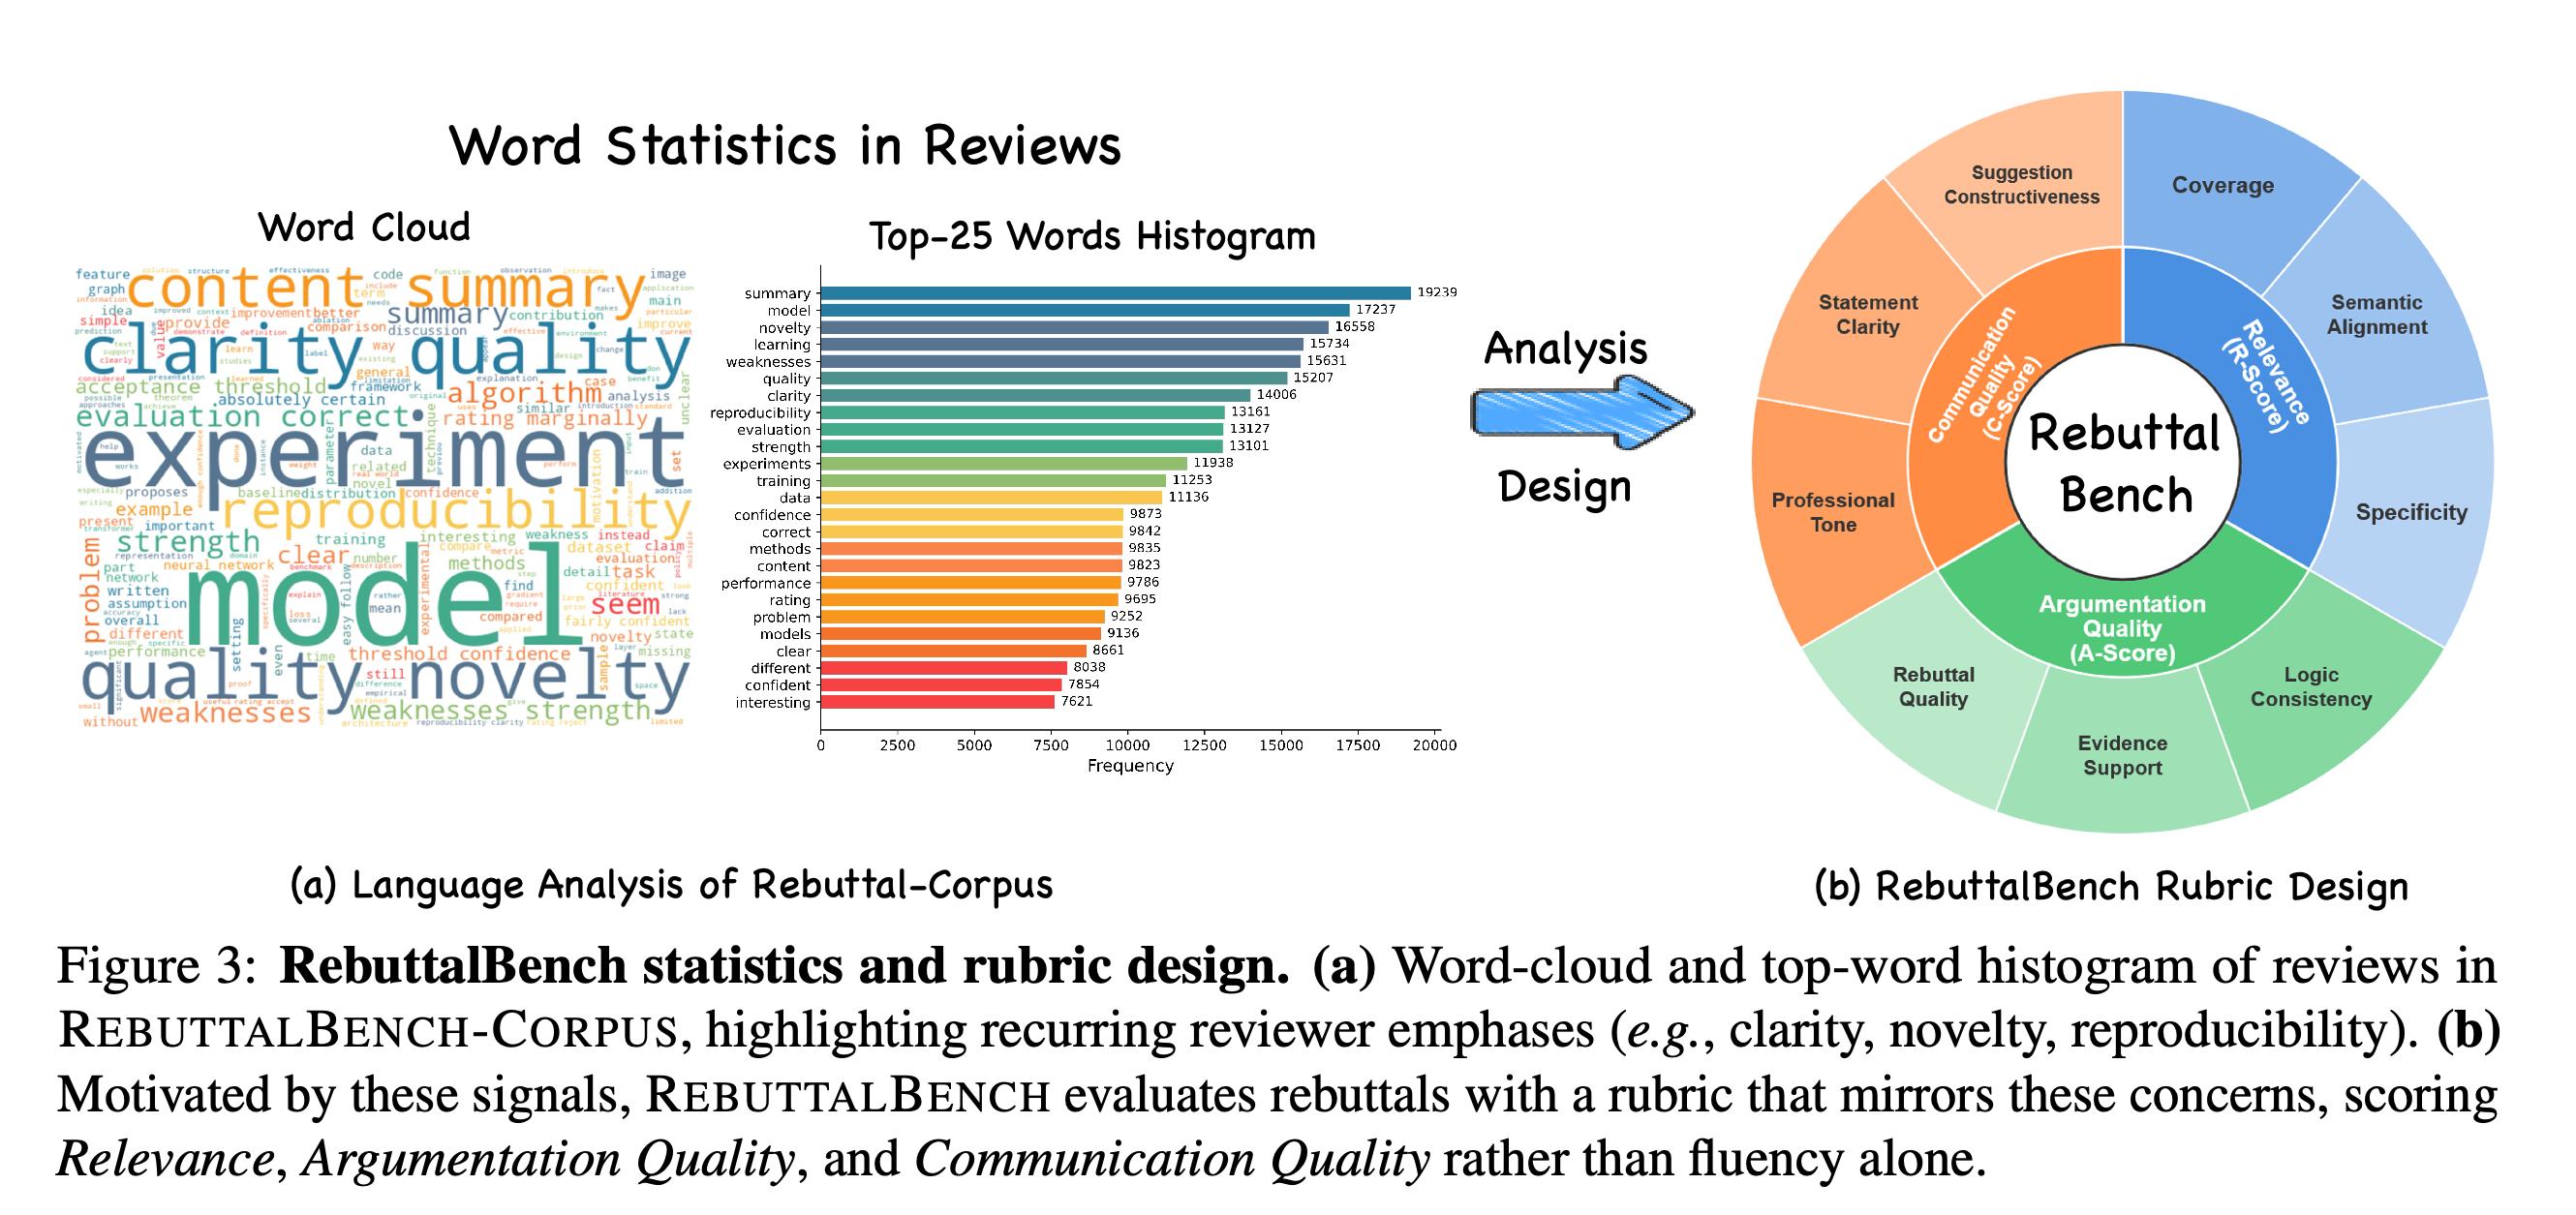
- Figure 3은 반복해서 등장하는 리뷰 어휘를 통해 평가 차원의 필요성을 설명한다. 다만 단어 빈도만으로 평가 기준의 타당성을 검증할 수는 없다.
워드 클라우드와 Top-25 Words Histogram은 모델, 실험, 명료성, 재현성, 독창성에 관한 용어가 리뷰에 반복해서 등장함을 보여준다. 옆의 원형 도식은 평가를 차원 3개와 항목 9개로 묶는다. 도식은 논증 항목 1개를 Rebuttal Quality라고 표기하지만, 평가 지표 설명과 표는 Response Engagement를 사용한다. 어휘 분석은 루브릭의 필요성을 설명하지만 통계적으로 타당성을 검증하지는 않는다.
4.2 Evaluation Metrics
LLM 평가자는 아홉 항목을 0–5 척도로 평가하며, Appendix H는 반 점 가산 조건을 정의한다. Relevance는 Coverage, Semantic Alignment, Specificity를 포함한다. Argumentation Quality는 Logic Consistency, Evidence Support, Response Engagement를 포함한다. Communication Quality는 Professional Tone, Clarity, Constructiveness를 포함한다.
- 각 차원의 점수는 해당 항목 3개의 평균이며, 최종 점수는 차원 3개의 동일 가중 평균이다.
- 평가자는 설명과 정성적 경고 또는 진단도 반환한다.
- checker 사례 연구는 Coverage 평가의 한계를 보여준다. 응답이 관련 키워드를 언급하더라도 초점이 흐리거나 구체적으로 실행하기 어려울 수 있다.
5 Experiments
실험은 동일한 백본에서 직접 텍스트를 생성하는 프롬프팅과 전체 파이프라인을 비교하고, 구성 요소 3개를 각각 제거한 결과를 살펴본다. 부록 실험은 대안 베이스라인, 2번째 평가자 모델, CVPR 2026 제출 논문에 대한 저자 평가를 포함한다.
5.1 Experimental Setup
주요 백본 4개는 GPT-5-mini, Grok-4.1-fast, Gemini-3-Flash, DeepSeekV3.2다. 각 베이스라인과 대응하는 RebuttalAgent는 동일한 원고와 리뷰어 의견을 입력받고, 동일한 항목별 응답 형식을 생성하며, 일관된 디코딩 설정을 사용한다. 기본 평가자는 Gemini-3-Flash다.
- 본문의 모든 실험은 사람의 개입 없이 실행한다. 따라서 저자가 참여하는 전체 워크플로가 아니라 자동화된 파이프라인을 평가한다.
- 백본을 맞추면 사용한 모델의 차이는 통제할 수 있다. 하지만 파이프라인의 추가 추론 호출, 검색, 연산 예산까지 맞춘 것은 아니다.
- 저자들은 자동화된 성능을 실제 사용 성능의 보수적인 하한으로 설명한다. 다만 실험은 저자 개입에 따른 개선을 직접 측정하지 않는다.
5.2 Main Results
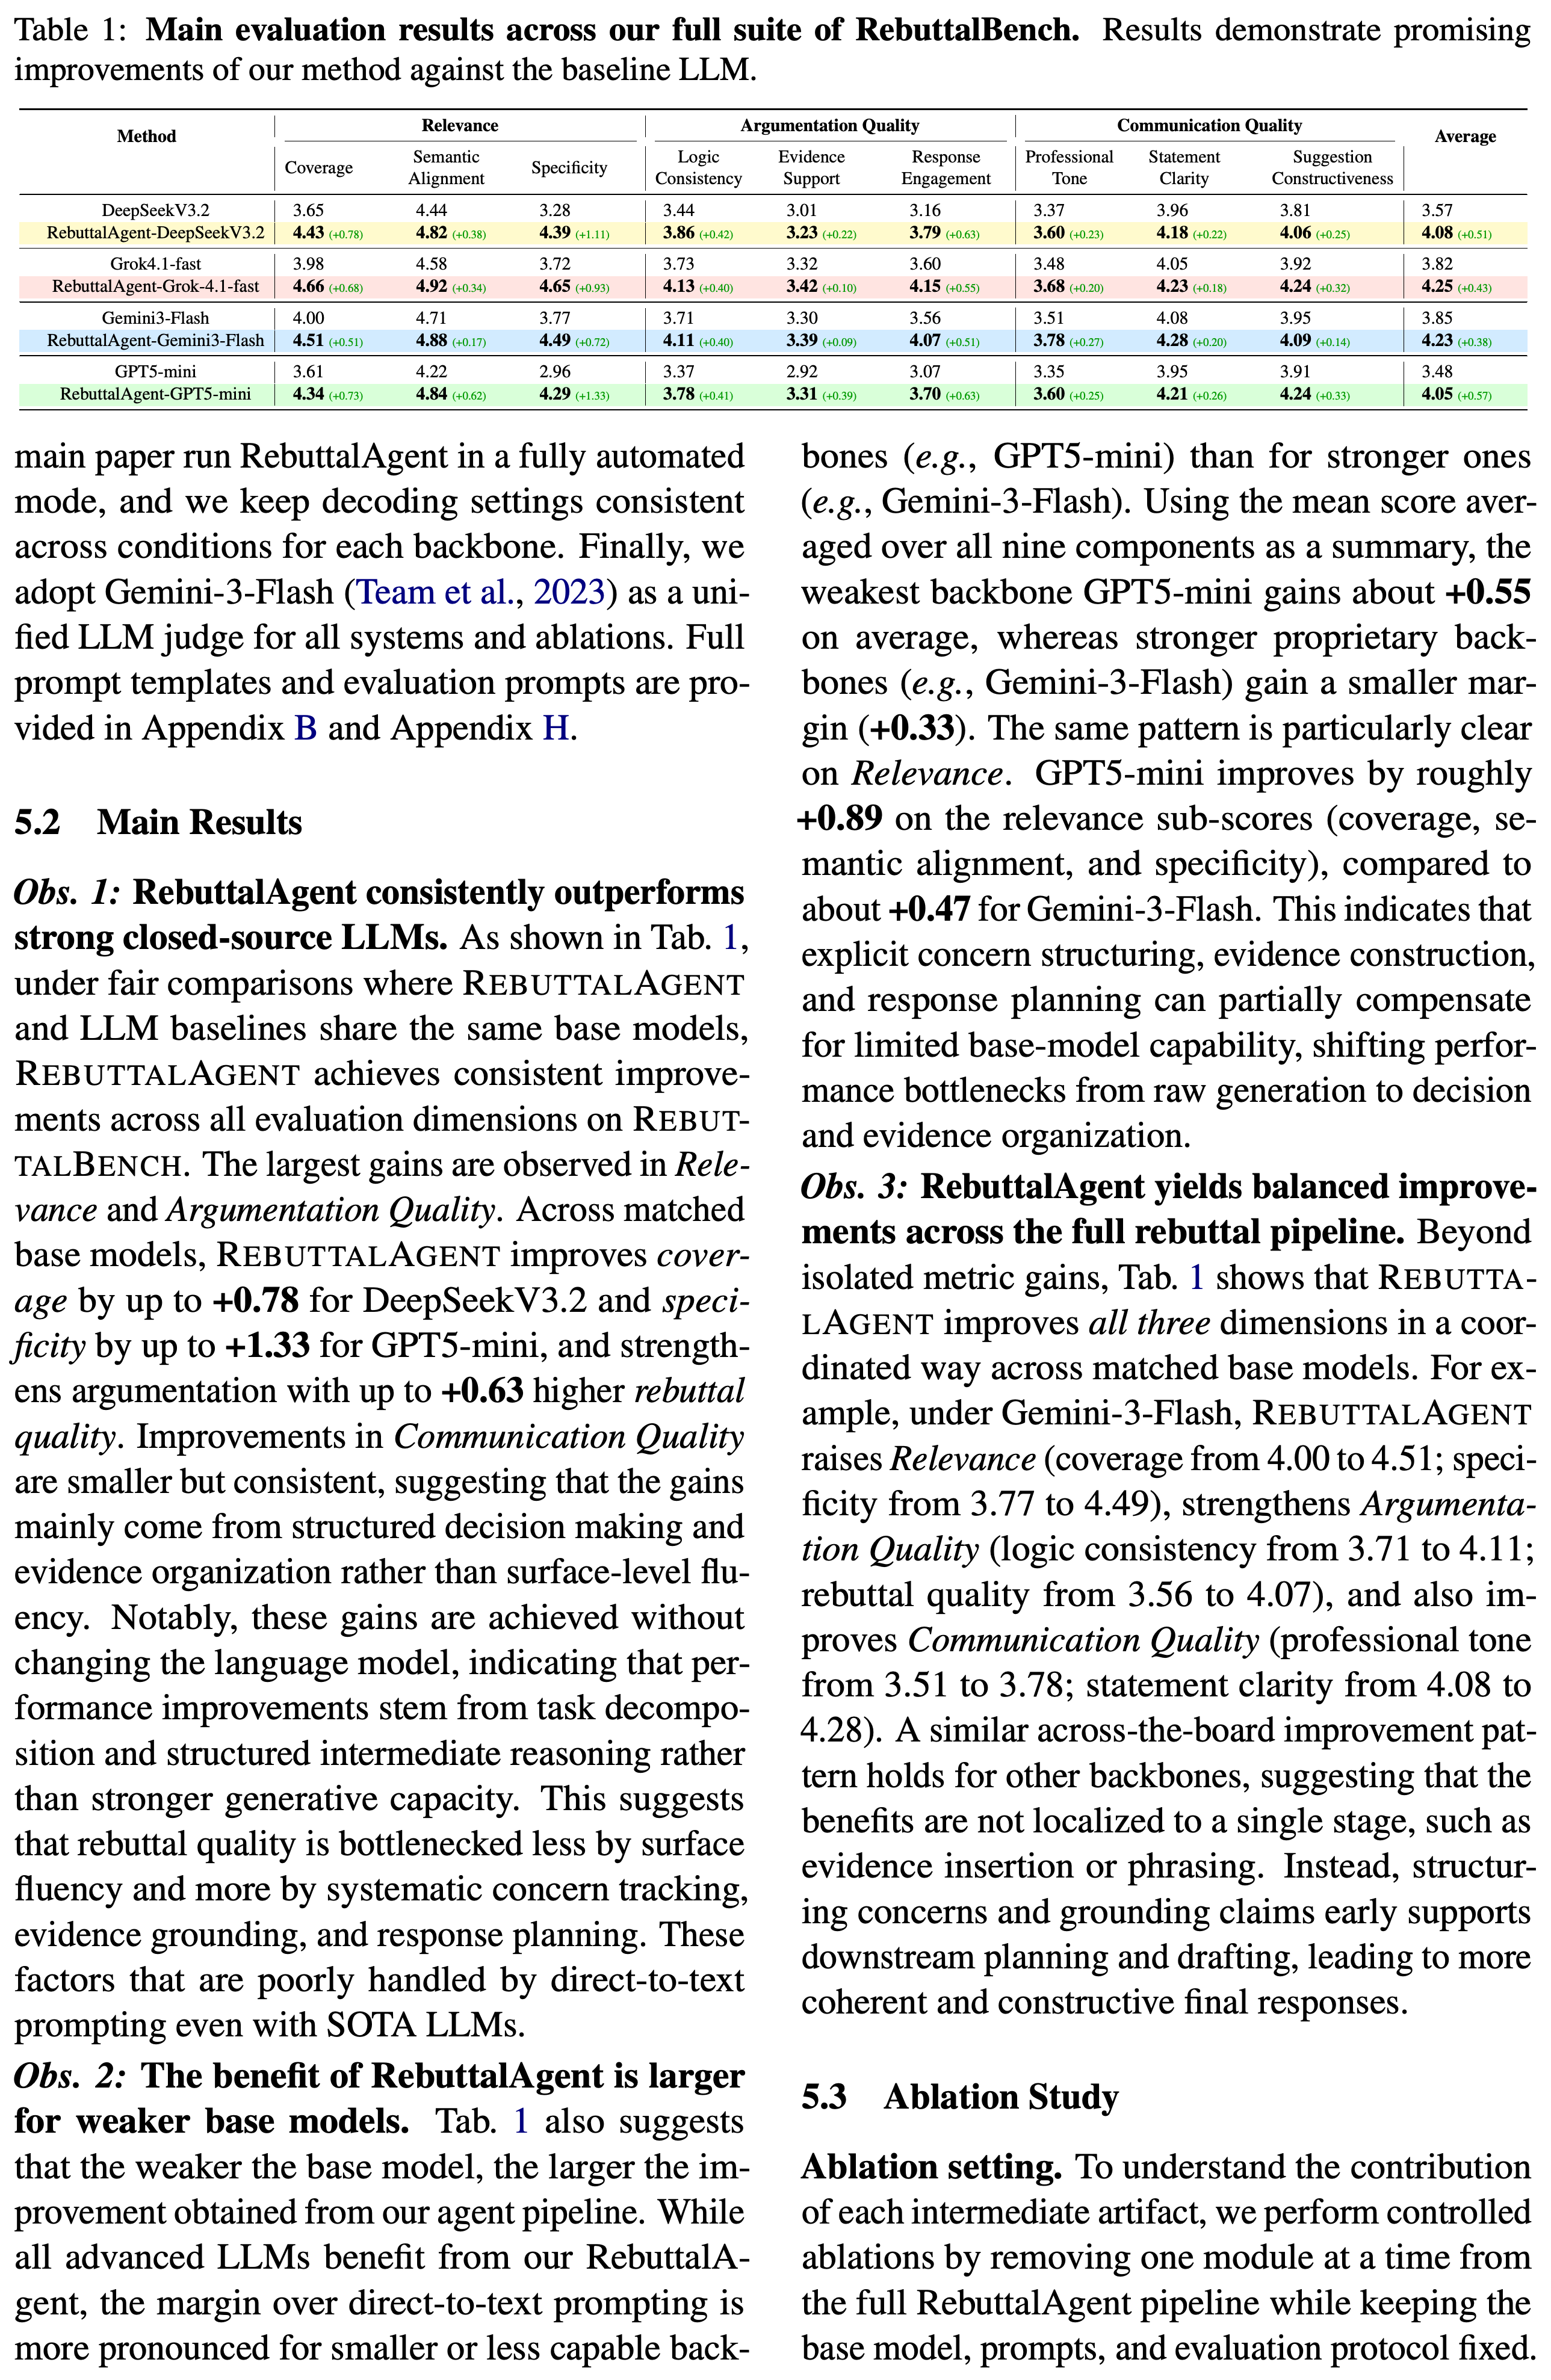
Table 1에서 RebuttalAgent는 모든 백본의 항목 9개 모두에서 더 높은 점수를 얻는다. 보고된 전체 평균은 DeepSeekV3.2에서 3.57에서 4.08로, Grok-4.1-fast에서 3.82에서 4.25로, Gemini-3-Flash에서 3.85에서 4.23으로, GPT-5-mini에서 3.48에서 4.05로 상승한다.
- Coverage의 최대 상승 폭은 DeepSeekV3.2의 +0.78이며, Specificity의 최대 상승 폭은 GPT-5-mini의 +1.33이다.
- Grok-4.1-fast와 Gemini-3-Flash의 Evidence Support 상승 폭은 각각 +0.10과 +0.09로 더 작다. 설명이 상세해졌다고 해서 근거의 강도도 같은 폭으로 개선되었다고 볼 수는 없다.
- 보고된 평균을 나열된 항목 9개로 일관되게 재현할 수는 없다. 항목별 점수로 계산한 평균 상승 폭은 GPT5-mini에서 약 +0.55, Gemini-3-Flash에서 약 +0.33이다. 이는 표의 +0.57과 +0.38이 아니라 본문 설명과 일치한다.
- 점수가 낮은 베이스라인에서 개선 폭이 더 크다는 결과는 이 벤치마크에서 워크플로가 직접 텍스트 생성의 약점을 보완한다는 해석을 뒷받침한다. 하지만 모델 역량과 개선 효과 사이의 일반적인 관계를 독립적으로 입증하지는 않는다.
동일한 백본을 사용한 모든 비교에서 RebuttalAgent가 항목 9개 모두에서 앞서며, 특히 Coverage와 Specificity의 상승 폭이 크다. 표는 전체 점수 상승 폭을 +0.51, +0.43, +0.38, +0.57로 보고한다. 하지만 일부 평균은 나열된 항목 점수의 평균과 다르다. Gemini와 GPT5-mini의 항목별 점수로 계산한 상승 폭은 각각 약 +0.33과 +0.55다. 불확실성 추정치나 추론 예산을 맞춘 비교는 제공하지 않는다.
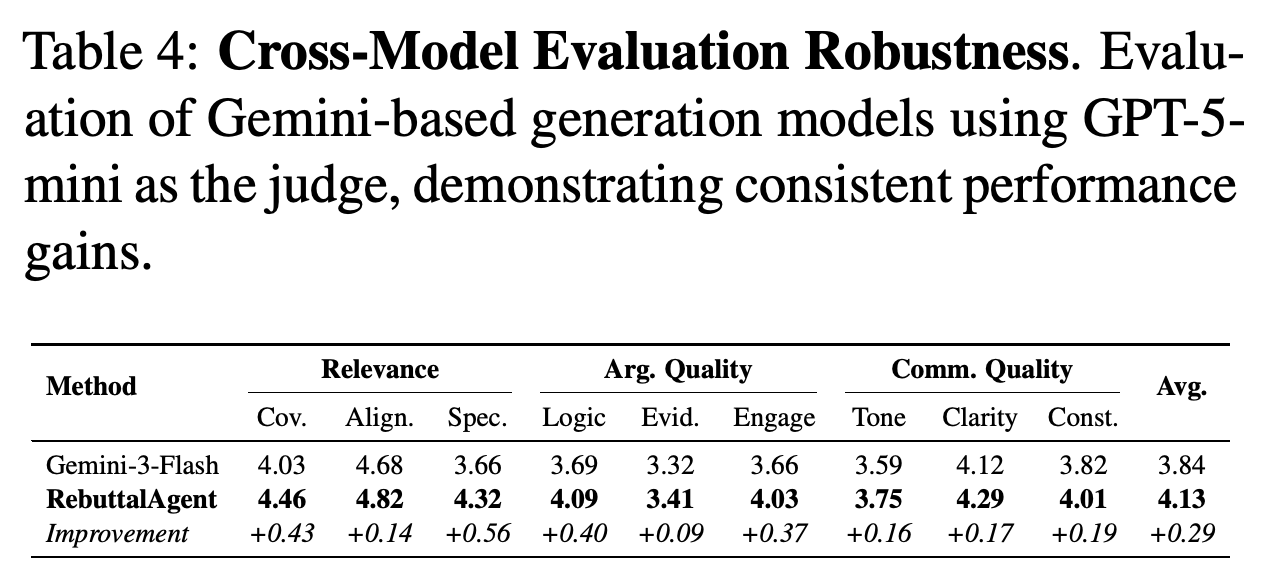
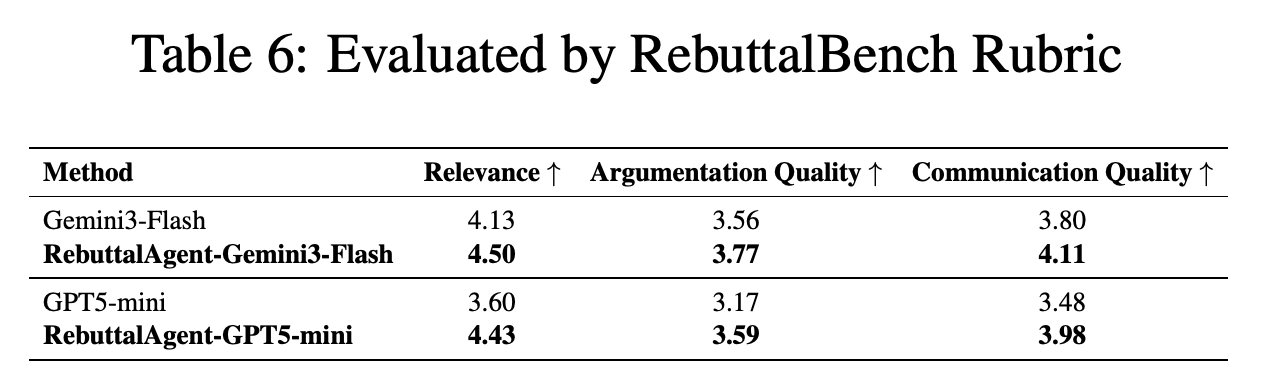
Appendix E는 리뷰-rebuttal 테스트 샘플 33개에 대한 저자 평가와, Gemini가 생성한 응답을 GPT-5-mini 평가자로 재평가한 결과를 통해 자동 평가를 점검한다. 2번째 평가자에서도 개선 방향은 유지되며, 전체 점수는 3.84에서 4.13으로 상승한다.
- 저자 9명이 최근 자신의 CVPR 2026 제출 논문에 대한 응답을 평가한다. 생성 조건은 동일한 백본을 맞춘 4개이며, 사람 평가 차원은 3개다.
- 사람이 평가한 Faithfulness & Argumentation 점수는 Gemini3-Flash에서 2.88에서 4.33으로, GPT5-mini에서 2.30에서 3.97로 상승한다.
- 보고된 Kendall τ = 0.646은 저자 판단과의 일치를 뒷받침한다. 다만 연구 규모가 작고 불확실성 추정치가 없어, 평가자의 신뢰성이나 편향 부재를 더 강하게 주장하기는 어렵다.
5.3 Ablation Study
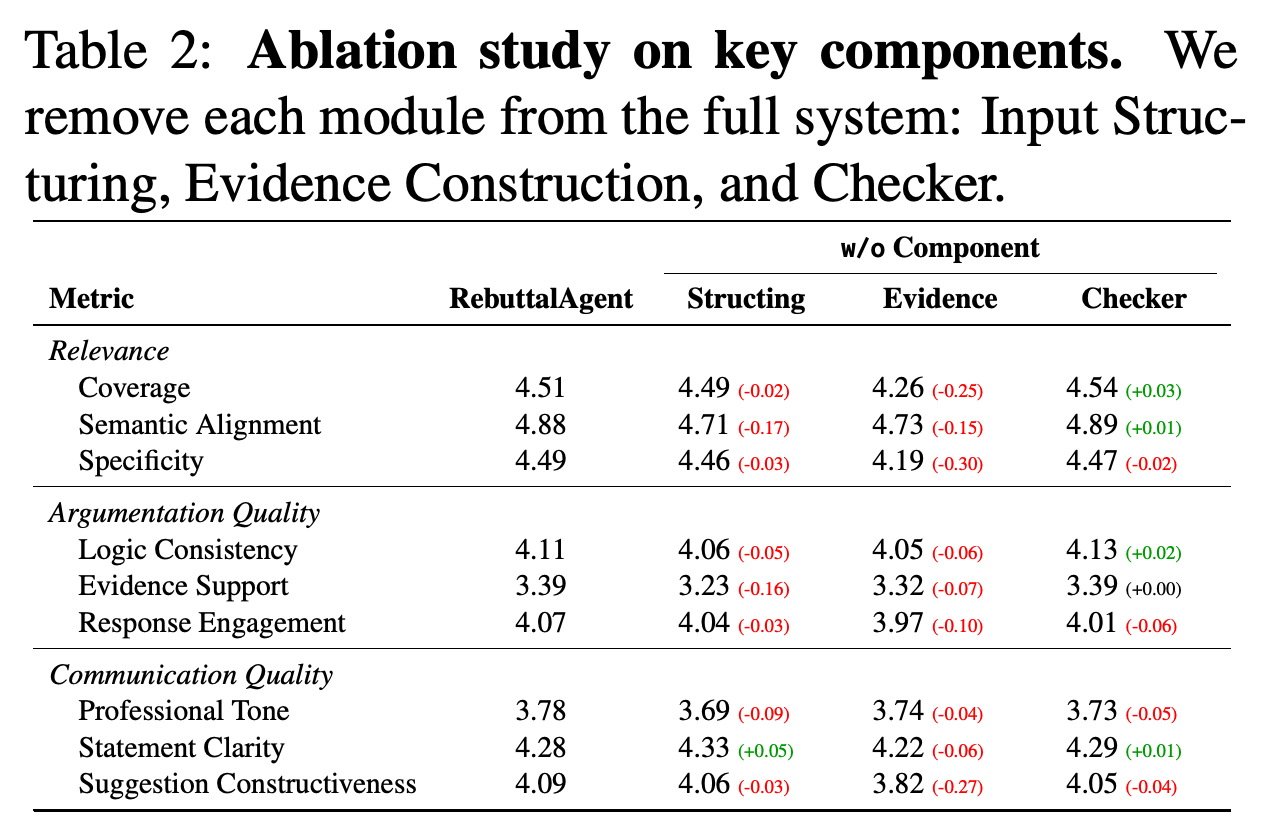
Table 2는 Gemini 기반 파이프라인에서 명시적 쟁점 구조화, 외부 Evidence Construction, 계획 수준의 Checkers를 각각 제거한다. 외부 검색과 인용 가능한 근거 요약을 비활성화했을 때 하락 폭이 가장 크다. Coverage는 4.51에서 4.26으로, Specificity는 4.49에서 4.19로, Suggestion Constructiveness는 4.09에서 3.82로 하락한다.
- Input Structuring 제거 조건은 명시적 분해와 병합 없이 리뷰어 쟁점을 원래 형태로 처리한다. Evidence Construction 제거 조건은 외부 검색과 근거 요약을 비활성화하지만, 원고 내부의 근거 활용까지 모두 제거하지는 않는다.
- Input Structuring을 제거하면 Semantic Alignment는 4.88에서 4.71로, Evidence Support는 3.39에서 3.23으로 하락한다.
- checker 제거의 효과는 엇갈린다. Coverage는 4.54로, Logic Consistency는 4.13으로, Statement Clarity는 4.29로 상승한다. 반면 Response Engagement는 4.01로, Constructiveness는 4.05로 하락한다.
- 본문은 checker를 제거하면 Evidence Support가 3.39에서 3.33으로 하락한다고 주장한다. 하지만 Table 2는 3.39와 변화량 +0.00을 보고한다. 따라서 종합 결과만으로 점검이 사실적 신뢰성을 전반적으로 높인다고 뒷받침하기는 어렵다.
외부 검색과 근거 요약을 비활성화했을 때 성능 저하가 가장 뚜렷하며, 특히 Specificity와 Constructiveness가 크게 하락한다. checker 제거의 효과는 엇갈린다. 일부 항목은 소폭 상승하고 Evidence Support는 3.39로 유지된다. 이는 3.33으로 하락했다는 본문 주장과 다르다.
5.4 Case Study
사례 연구는 명시적인 수정 계획과 더 짧은 서술형 방어 응답을 비교한다. 이론적 엄밀성, 상한과 단조적 거동의 차이, Hausdorff 기반 topographic similarity가 compositionality를 입증하는지를 다룬다.
- 계획은 저자가 작업을 약속하기 전에 제안된 증명 수정, 진단 분석, 원고 편집을 드러낸다.
- Appendix G는 “Coverage Paradox”를 보여준다. checker가 없는 응답의 용어집은 관련 키워드를 언급하지만 주변적인 개념을 추가한다. 반면 점검된 응답은 쟁점에 집중한 수학적 수정을 제안한다.
- 이 사례들이 환각 방지를 일관되게 입증하지는 않는다. 상한 사례의 응답은 완료된 측정 결과를 제시하지 않은 채 r > 0.9의 강한 양의 상관관계를 주장하며 끝난다.
6 Conclusion
결론은 rebuttal 품질 개선의 원인을 구조화된 쟁점, 쟁점별 문맥, 외부 근거 종합, 점검된 응답 계획에서 찾는다. 비교 결과는 더 높은 루브릭 점수와 저자가 평가한 유용성을 뒷받침한다. 다만 인지 부담 감소와 추적 가능성의 보장은 직접 측정하지 않는다.
Limitations and Future Work
논문이 밝힌 한계는 지연 시간과 비용, 쟁점 간 또는 저자의 반복 수정 과정에서 중간 산출물을 충분히 재사용하지 못하는 점, 학회와 세부 분야마다 다른 rebuttal 관행이다. 개선 방안으로 캐싱, 점진적 갱신, 적응형 조기 종료 정책, 학회별 문체와 정책을 반영하는 경량 제약을 제안한다.
- 지연 시간, 비용, 저자 작업 시간 절감에 대한 정량적 결과는 보고하지 않는다.
- 주요 챌린지 세트는 ICLR 2023 논문 20편으로 구성된다. CVPR 저자 평가 연구는 학회가 달라졌을 때의 성능을 소규모로 점검한 결과이지 광범위한 검증은 아니다.
Broader Impact and Ethics Statement
윤리 성명은 설득력은 있지만 오해를 유발하는 응답, 조작된 결과, 비현실적인 약속, 기밀 유출 위험을 잠재적 피해로 제시한다. 저자의 책임, 출처를 보존하는 검색, 검토 가능한 중간 산출물을 권고한다. 기밀 원고와 리뷰에는 로컬 환경이나 기관이 승인한 환경에서 시스템을 운영하도록 권고한다.
- 데이터셋은 공개 ICLR 2023 포럼에서 가져왔다. 논문은 원본 이용 조건을 따르고 민감한 정보나 개인 식별 정보를 배포하지 않겠다고 명시한다.
- 이러한 안전장치는 효과적인 점검과 저자의 검증에 의존한다. 논문은 오용이나 개인정보 노출이 제거되었음을 입증하지 않는다.
부록
- A Evaluation Dataset은 4단계를 설명한다. 결과에 따라 Improved와 Unimproved 그룹으로 분류하고, 신뢰성을 등급화하며, 대표 논문 20편을 선정한 뒤, 다중 라운드 베이스라인을 생성한다. Tier 2는 confidence ≥ 0.7을, Tier 3은 0.4 ≤ conf < 0.7을 사용한다. 각 베이스라인 라운드는 원고, 현재 리뷰, 선택적인 이전 라운드 문맥을 입력받는다. 이후 다음 라운드에 전달할 200단어 미만의 사실 중심 요약을 생성한다. 출력과 토큰 사용량은 기록하지만, 자원 사용량의 비교 측정 결과는 보고하지 않는다.
- B Evaluation Metric은 항목 9개, 항목별 평가 근거, 동일 가중 집계를 정의한다. 계산식은 (R = \frac{R_1 + R_2 + R_3}{3})과 (\mathrm{Score} = \frac{R + A + C}{3})이며, A와 C에도 같은 방식의 평균을 적용한다. 따라서 “weighted score”라는 표현과 달리, 명시된 최종 집계는 항목 9개 모두에 동일한 가중치를 부여한다. 보고된 일부 표의 평균은 이 계산을 따르지 않는다.
- C Related Works는 문헌 검색, 가설 생성, 연구 아이디어 구상, 실험 계획, 과학적 시각화를 포함하는 자동화된 과학 연구 안에서 rebuttal 지원의 위치를 설명한다. 리뷰어의 의도를 추적하고 원고의 근거에 기반하여 응답하면서, 연구를 전달하고 방어하는 데 초점을 둔다.
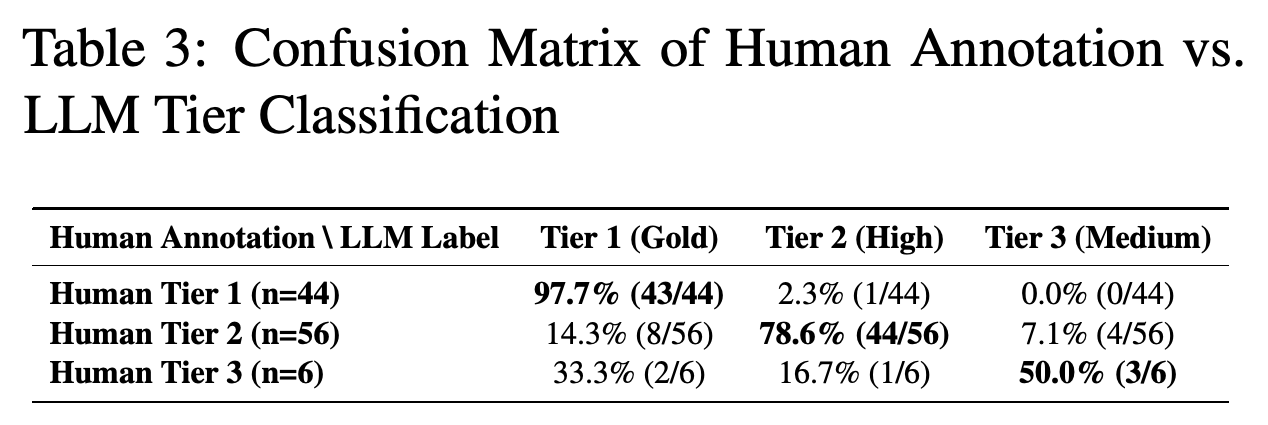
- D Data Filtering Pipeline은 Resolved와 Unresolved라는 결과 레이블을 신뢰성 필터로 사용하는 신뢰도 등급과 구분한다. D.1은 리뷰어의 후속 텍스트와 점수 변화에서 결과를 추출하고 등급을 부여한다. 또한 양쪽 결과가 모두 있고 리뷰어가 더 많은 논문을 우선 선정한다. D.2는 스트레스 테스트를 위해 신호가 혼재하거나 모순되는 Tier 3 cases 중 일부를 의도적으로 유지한다. D.3은 106 cases에서 전문가 주석과 결과 레이블이 100.0% 일치한다고 보고한다. 하지만 Table 3은 사람이 분류한 Tier 3 cases 중 2/6을 Tier 1로 배정하여, 해당 등급 사이의 누출이 엄격히 0.0%라는 주장과 모순된다. 또한 샘플 수준의 일치가 일반적으로 편향 없는 정답을 입증하는 것은 아니다.
- E Evaluation Setup and Metric Validation은 사람 평가와의 일치도 및 평가자 선택에 대한 민감도를 점검한다. E.1은 Kendall τ = 0.646을 보고하며, GPT-5-mini 평가자로 점검해도 Gemini 기반 RebuttalAgent의 우위가 유지된다고 설명한다. E.2는 저자 9명이 자신의 CVPR 2026 제출 논문에서 얻은 리뷰-rebuttal 테스트 샘플 33개를 대상으로 생성 조건 4개를 평가한 연구를 설명한다. 저자들은 Responsiveness & Coverage, Faithfulness & Argumentation, Communication & Practical Utility에 1–5 Likert 척도를 사용한다. Tables 5와 6은 같은 시스템 순위를 유지하지만, 사람 평가와 자동 평가의 점수 차이를 서로 같은 것으로 해석할 수는 없다.
- E.3 Limitations of Standard N-gram Metrics는 독창성을 방어하는 사례를 제시한다. 직접 텍스트 생성의 점수는 BLEU-4 = 6.96과 ROUGE-L = 18.49이며, RebuttalAgent의 점수는 BLEU-4 = 2.38과 ROUGE-L = 14.05다. 확장된 응답은 참조 응답을 가깝게 바꾸어 쓰기보다 Information Bottleneck 추론, latent alignment, 제안된 상호정보량 논증을 활용한다. 이 사례는 내용을 확장하면 참조 응답과의 중복이 줄어들 수 있음을 보여준다. 다만 확장된 응답의 과학적 정확성을 독립적으로 검증하지는 않는다.
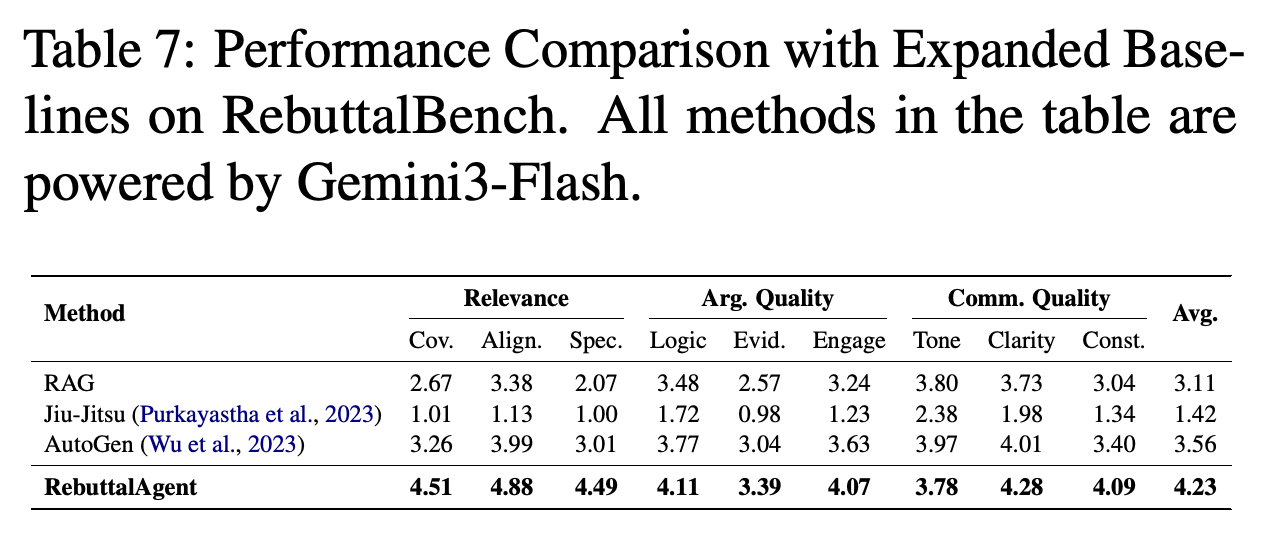
- F Additional Baseline Comparisons는 모두 Gemini3-Flash를 사용하는 all-MiniLM-L6-v2 기반 Standard RAG, AutoGen, Jiu-Jitsu를 평가한다. Table 7의 전체 점수는 각각 3.11, 3.56, 1.42이며, RebuttalAgent는 4.23이다. 다만 RebuttalAgent에 나열된 항목 9개의 평균은 약 4.18이다. 이 결과는 보고된 설정에서 특화된 파이프라인이 더 우수함을 보여준다. 하지만 베이스라인을 어떻게 조정했고 어느 정도 예산을 사용했는지에 대한 설명이 제한적이어서, 낮은 성능의 원인을 설명하기는 어렵다. Standard RAG는 Table 1의 직접 텍스트 생성 Gemini보다도 점수가 낮다. 이는 단순 프롬프팅보다 개선되었다는 부록의 주장과 다르다.
- G Case Study: The Coverage Paradox and the Role of Checkers는 non-Markovian 정식화를 명확히 하고 Utility와 Reward를 구분해 달라는 리뷰어 요청을 살펴본다. checker가 없는 응답은 광범위한 용어집을 제공하고 Social Graph와 Adversarial Interaction을 추가하며, non-Markovian 거동을 일반적인 POSG의 특성으로 설명한다. 반면 점검된 응답은 순간적인 Reward Ri(s, a)와 meta-game Utility Ui(π)를 분리하고, Eq. 4의 조건을 현재 상태 st만이 아니라 상대의 행동 이력 τt−1로 바꾸도록 제안한다. 이는 쟁점에 집중한 수정 제안이다. 다만 사례 자체가 제안의 이론적 정확성을 독립적으로 입증하거나, 장황함이 종합 Coverage 점수 상승의 원인임을 증명하지는 않는다.
- H Prompt Templates는 추출, 검색, 수정, 초안 작성, 평가의 실행 제약을 명시한다. Rebuttal Strategist는 압축된 원고, 리뷰 텍스트, 선택적인 다중 라운드 문맥을 사용해 새롭거나 해결되지 않은 문제를 추출한다. 서로 다른 근거가 필요한 쟁점은 분리하고, 동등한 이의는 병합하며, 일반적인 칭찬과 빈 리뷰 필드는 제외한다. 각 문제는 원문 그대로 인용한 출처, 관련 원고 위치, P1–P3 우선순위와 함께 [qN] 블록에 기록한다. Strategist Checker는 이 추출 형식을 반복하고 누락을 보완하는 작업을 추가한다. Literature Retrieval Assistant는 리뷰어가 지목한 참고문헌, 외부 방법이나 데이터셋, 요청된 비교, 원고에서 빠진 근거를 검색한다. 기존 근거로 충분하거나 사소한 서식 문제인 경우에는 검색을 생략한다. 보통 검색어를 5개 미만으로 생성하고, 제공된 제목이나 링크를 지어내지 않고 보존하며, need_search, queries, links, reason을 반환한다. Rebuttal Expert는 초록을 검토하여 직접적인 유용성을 판단하고, 보통 논문을 6편 이하로 선택한다. 명시된 예외 조건에 따라 리뷰어가 지정한 참고문헌을 유지하고, 중복 논문을 제외하며, 이유와 함께 selected_papers를 반환한다. Reference Extractor는 외부 연구 결과와 원고의 주장을 구분한다. 제목, 요약, 관련성, 안전하게 인용할 수 있는 내용, 한계, URL을 담은 600단어 이하의 근거 요약을 생성한다. 출처가 비어 있거나 초록만 제공되거나 가치가 낮은 경우에는 근거를 지어내지 않고 그 한계를 밝혀야 한다. Human-In-The-Loop Strategy Revisor는 원고, 쟁점, 참고문헌 요약, 현재 계획, 저자 피드백을 결합하여 일정을 추가하지 않고 전략을 수정한다. Rebuttal Letter Writer는 계획을 리뷰어 순서에 맞추어 응답에 반영하고, Common Response 및 리뷰어별 Q1/A1 또는 Comment/Response 형식을 사용한다. 전문적인 표현과 LaTeX 표기를 요구하며, 확보하지 못한 수치 결과에는 [TBD]를 의무적으로 사용한다. 다만 뒤에 나오는 별표로 표시한 추측성 데이터에 관한 지시는 이 금지 규칙과 모순된다. Unified Rebuttal Evaluation 프롬프트는 포괄성, 의미 정렬, 구체성, 논리, 근거, 대응, 어조, 명료성, 건설성에 0–5의 정수 항목 점수를 부여한다. 이후 기본 점수가 3 또는 4이고 명시된 가산 조건을 최소 2개 충족한 경우에만 +0.5를 허용한다. 반복, 간접적인 답변, 근거 없는 약속, 설명 없는 인용, 약한 근거를 가리는 매끄러운 표현을 면밀히 점검한다. 예시 출력 스키마 2개는 각각 quality_warnings와 red_flags를 사용한다는 차이가 있지만, 모두 항목 점수와 설명을 포함한다.
- I Case Study는 “Rigorous formalization & verification v.s. High-level intuitive explanation”, “Actionable theoretical expansion v.s. Passive logical defense”, “Methodological triangulation v.s. Linear request fulfillment”의 비교 3개를 제시한다. 첫 사례에서는 Proposition 1에 대한 우려에 대응하여 명시적 가정, 번호를 붙인 보조정리, 층별 진단, 합성 데이터 검증, 상관관계, k ∈ {5, 15, 29}와 δ ∈ {0.05, 0.1, 0.2}에 대한 강건성 탐색을 계획한다. 베이스라인은 주로 직관을 설명하고 정의를 더 명확히 하겠다고 약속한다. 다음 사례의 계획은 상한과 단조성을 구분하고 새로운 보조정리, 산점도, 상한 진단을 제안한다. 하지만 요약은 측정 결과 없이 r > 0.9를 주장한다. 베이스라인은 상한에 대한 간결한 설명을 제공한다. 마지막 사례의 계획은 Hausdorff 기반 유사성을 서술적 지표로 재해석하고, 구성 요소의 decodability, latent-space linearity, 공개 ideogram 10–15개를 통한 보정을 제안한다. 반면 베이스라인은 주로 외부 검증 요청을 수용한다. 산출물과 할 일 목록은 완료된 RebuttalAgent 실험이 아니라 권장 수정 사항을 설명한다. 제안된 작업의 실행 가능성은 원래 논문의 체크포인트와 코드에 접근할 수 있는지에 달려 있다.
짧은 생각
가장 돋보이는 설계는 근거로 뒷받침할 수 있는 설명과 아직 수행해야 할 작업을 분리한 점이다. 하이브리드 원고 문맥, 외부 근거 요약, 명시적인 실행 항목은 저자가 검토할 수 있도록 결정 사항을 드러낸다. 동일 백본 비교와 저자 평가 연구는 이 워크플로의 유용성을 뒷받침한다.
가장 큰 우려는 응답 평가 점수의 개선과 입증된 사실적 신뢰성 사이의 차이다. 엇갈리는 checker 효과, 일관되지 않은 종합 점수, 근거 없는 r > 0.9 주장을 고려하면 RebuttalAgent는 검증된 과학적 추론 시스템보다 검토 가능한 초안 작성 도구로 보는 편이 타당하다. 사실 오류 점검과 자원 예산을 맞춘 비교가 더 강한 근거를 제공할 것이다.
분류기는 사람이 분류한 Tier 1 cases 중 43/44를 Tier 1로 유지한다. 하지만 사람이 분류한 Tier 3 cases 중 2/6도 Tier 1로 배정한다. 따라서 이 행렬은 Tier 1–Tier 3 사이의 누출이 전혀 없다는 주장과 모순된다. 누출이 없는 방향은 사람이 분류한 Tier 1에서 모델이 배정한 Tier 3으로 가는 방향뿐이다.
평가자를 Gemini-3-Flash에서 GPT-5-mini로 바꾸어도, Gemini가 생성한 응답에서 RebuttalAgent는 항목 9개 모두의 우위를 유지한다. 보고된 전체 점수는 3.84에서 4.13으로 상승한다. 이는 해당 평가자 교체에 대한 강건성을 뒷받침하지만, 평가자 편향이 완전히 없음을 의미하지는 않는다.
저자들은 RebuttalAgent 변형 모두를 대응하는 직접 텍스트 생성 방식보다 대응성, 충실성, 실용성에서 높게 평가한다. 자신의 제출 논문에 대한 응답을 평가하므로 관련 전문성을 활용할 수 있다. 다만 연구는 연구자 9명과 리뷰-rebuttal 테스트 샘플 33개만을 포함하며, 생성 조건은 4개다.
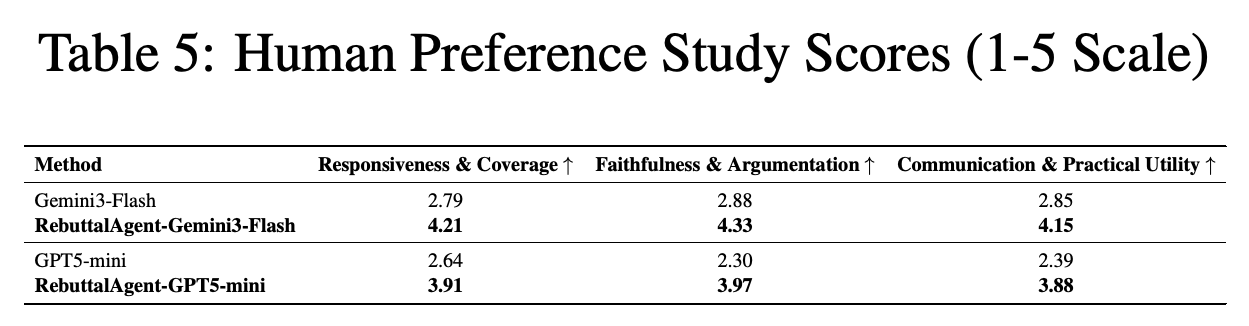
동일한 테스트 샘플 33개에 대한 자동 평가는 사람 평가 연구와 같은 시스템 순위를 보인다. 자동 평가의 점수 차이는 사람 평가의 차이보다 작다. 따라서 순위가 일치한다고 해서 절대 점수를 서로 대체할 수 있는 것은 아니다.
RebuttalAgent의 보고된 평균 4.23은 Standard RAG의 3.11, AutoGen의 3.56, Jiu-Jitsu의 1.42보다 높다. 다만 항목 점수의 평균은 약 4.18이다. 항목 수준에서 항상 우세한 것은 아니다. Professional Tone에서는 AutoGen과 RAG가 각각 3.97과 3.80으로 RebuttalAgent의 3.78보다 높다.