


Qwen3-ASR Technical Report 요약 설명
29 Jan 2026 | Paper Review Automatic Speech Recognition Forced Alignment Multilingual Learning Reinforcement Learning목차
이번 글에서는 Qwen3-ASR Technical Report 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 1월 29일(Arxiv)
- Shi, Xian, Wang, Xiong, Guo, Zhifang, Wang, Yongqi, Zhang, Pei, Zhang, Xinyu, Guo, Zishan, Hao, Hongkun, Xi, Yu, Yang, Baosong, et al.
- 논문 링크
- Github
요약
- Qwen3-ASR Technical Report는 30개 언어와 22개 중국어 방언의 전사 및 언어 식별을 지원하는 Qwen3-ASR-1.7B와 Qwen3-ASR-0.6B, 그리고 11개 언어의 타임스탬프 정렬을 지원하는 Qwen3-ForcedAligner-0.6B를 소개한다. ASR 모델은 사전학습된 AuT 음성 인코더와 Qwen3 언어 모델을 결합하며, Qwen3-Omni를 기반 모델로 사용한다.
- 1.7B 모델은 대부분의 공개 표준 중국어 및 방언 벤치마크와 내부 영어·중국어 강건성 평가의 모든 하위 집합에서 평가 대상 시스템 중 가장 좋은 성능을 보인다. 다국어 성능이 항상 우세한 것은 아니다. 전체 30개 언어를 평가하는 Fleurs에서 평균 오류는 12.60으로, Whisper-large-v3의 8.16보다 높다.
- 강제 정렬 모델은 다음 토큰을 생성하는 대신 80ms 단위의 타임스탬프 클래스를 사용하여 요청된 모든 타임스탬프 슬롯을 비자기회귀 방식으로 예측한다. 사람이 주석을 단 데이터에서 보고된 평균 타임스탬프 편차는 32.4ms다. Qwen3-ASR-0.6B는 동시성 1에서 평균 첫 토큰 지연 92ms, 동시성 128에서 초당 오디오 2,000초의 처리량을 달성한다. 이 수치는 서로 다른 운영 조건에서 측정한 결과다.
1 Introduction
이 보고서는 잡음이 있는 음성, 다국어, 방언, 장시간 음성을 전사하기 위해 음향 이해와 언어 모델링, 세계 지식을 결합하는 방법으로 Large Audio-Language Models (LALMs)를 제시한다. 타임스탬프 예측도 별도의 배포 요구사항으로 다룬다. 사용자가 정렬 단위를 선택할 수 있는 다국어 LALM을 기존 CTC 또는 CIF 기반 후처리의 대안으로 제안한다.
- 제안한 모델군은 ASR 모델 2개와 강제 정렬 모델 1개로 구성된다. 가중치는 Apache 2.0 라이선스로 공개되며, 오픈소스 추론 및 파인튜닝 프레임워크도 제공한다.
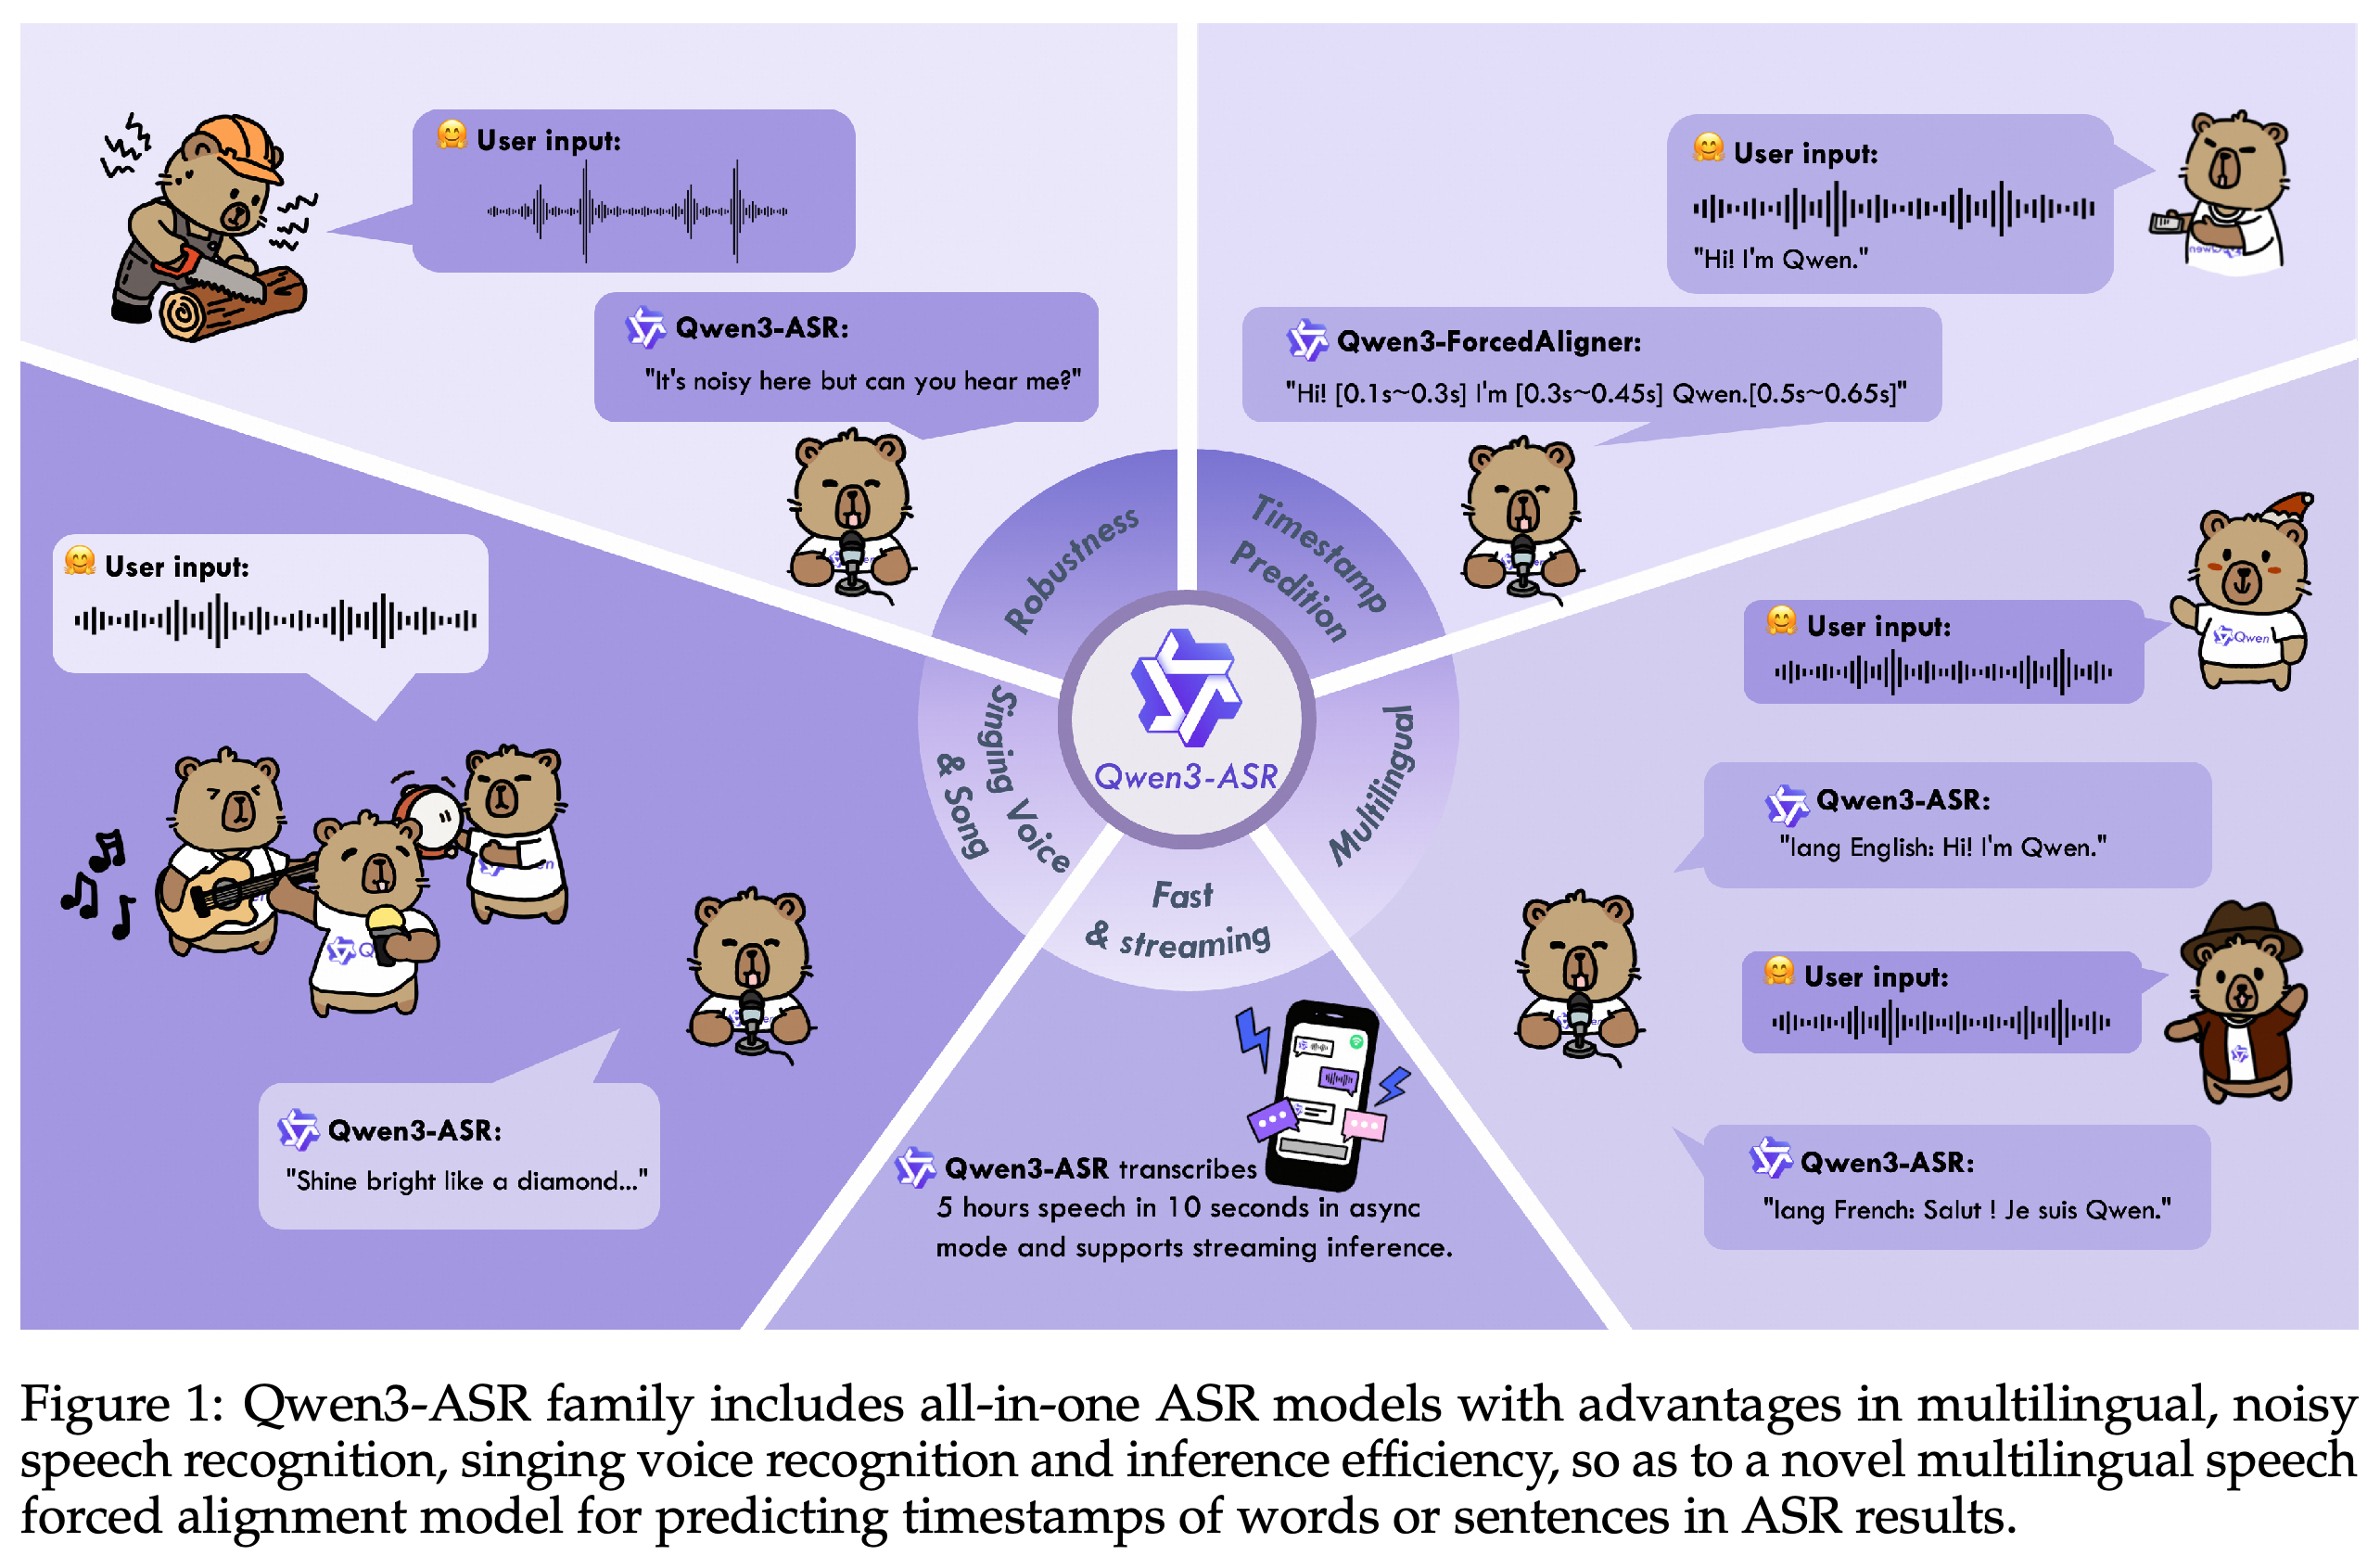
- Figure 1은 잡음 강건성, 가창 음성과 노래 전사, 다국어 인식, 스트리밍 효율, 타임스탬프 정밀도 등 목표 기능을 보여준다.
- 저자들은 일부 기존 테스트셋의 주석 오류 때문에 모델 간 성능 차이를 구분하기 어렵다고 보고, 공개 벤치마크에 내부 평가를 추가한다.
이 개요는 전사 기능과 타임스탬프 정렬을 구분한다. 강건성, 속도, 정렬 정확도를 정량적으로 입증하기보다는 목표로 하는 배포 범위를 보여준다.
2 Qwen3-ASR
Qwen3-ASR는 음성 인코더와 언어 모델을 결합한 구조를 사용하며, 2가지 크기로 제공된다. 학습은 AuT 및 Omni 사전학습과 지도학습 및 강화학습 기반 후속 학습으로 구성된다. 공개 모델은 오프라인 전사와 스트리밍 전사를 모두 지원한다.
2.1 Architecture
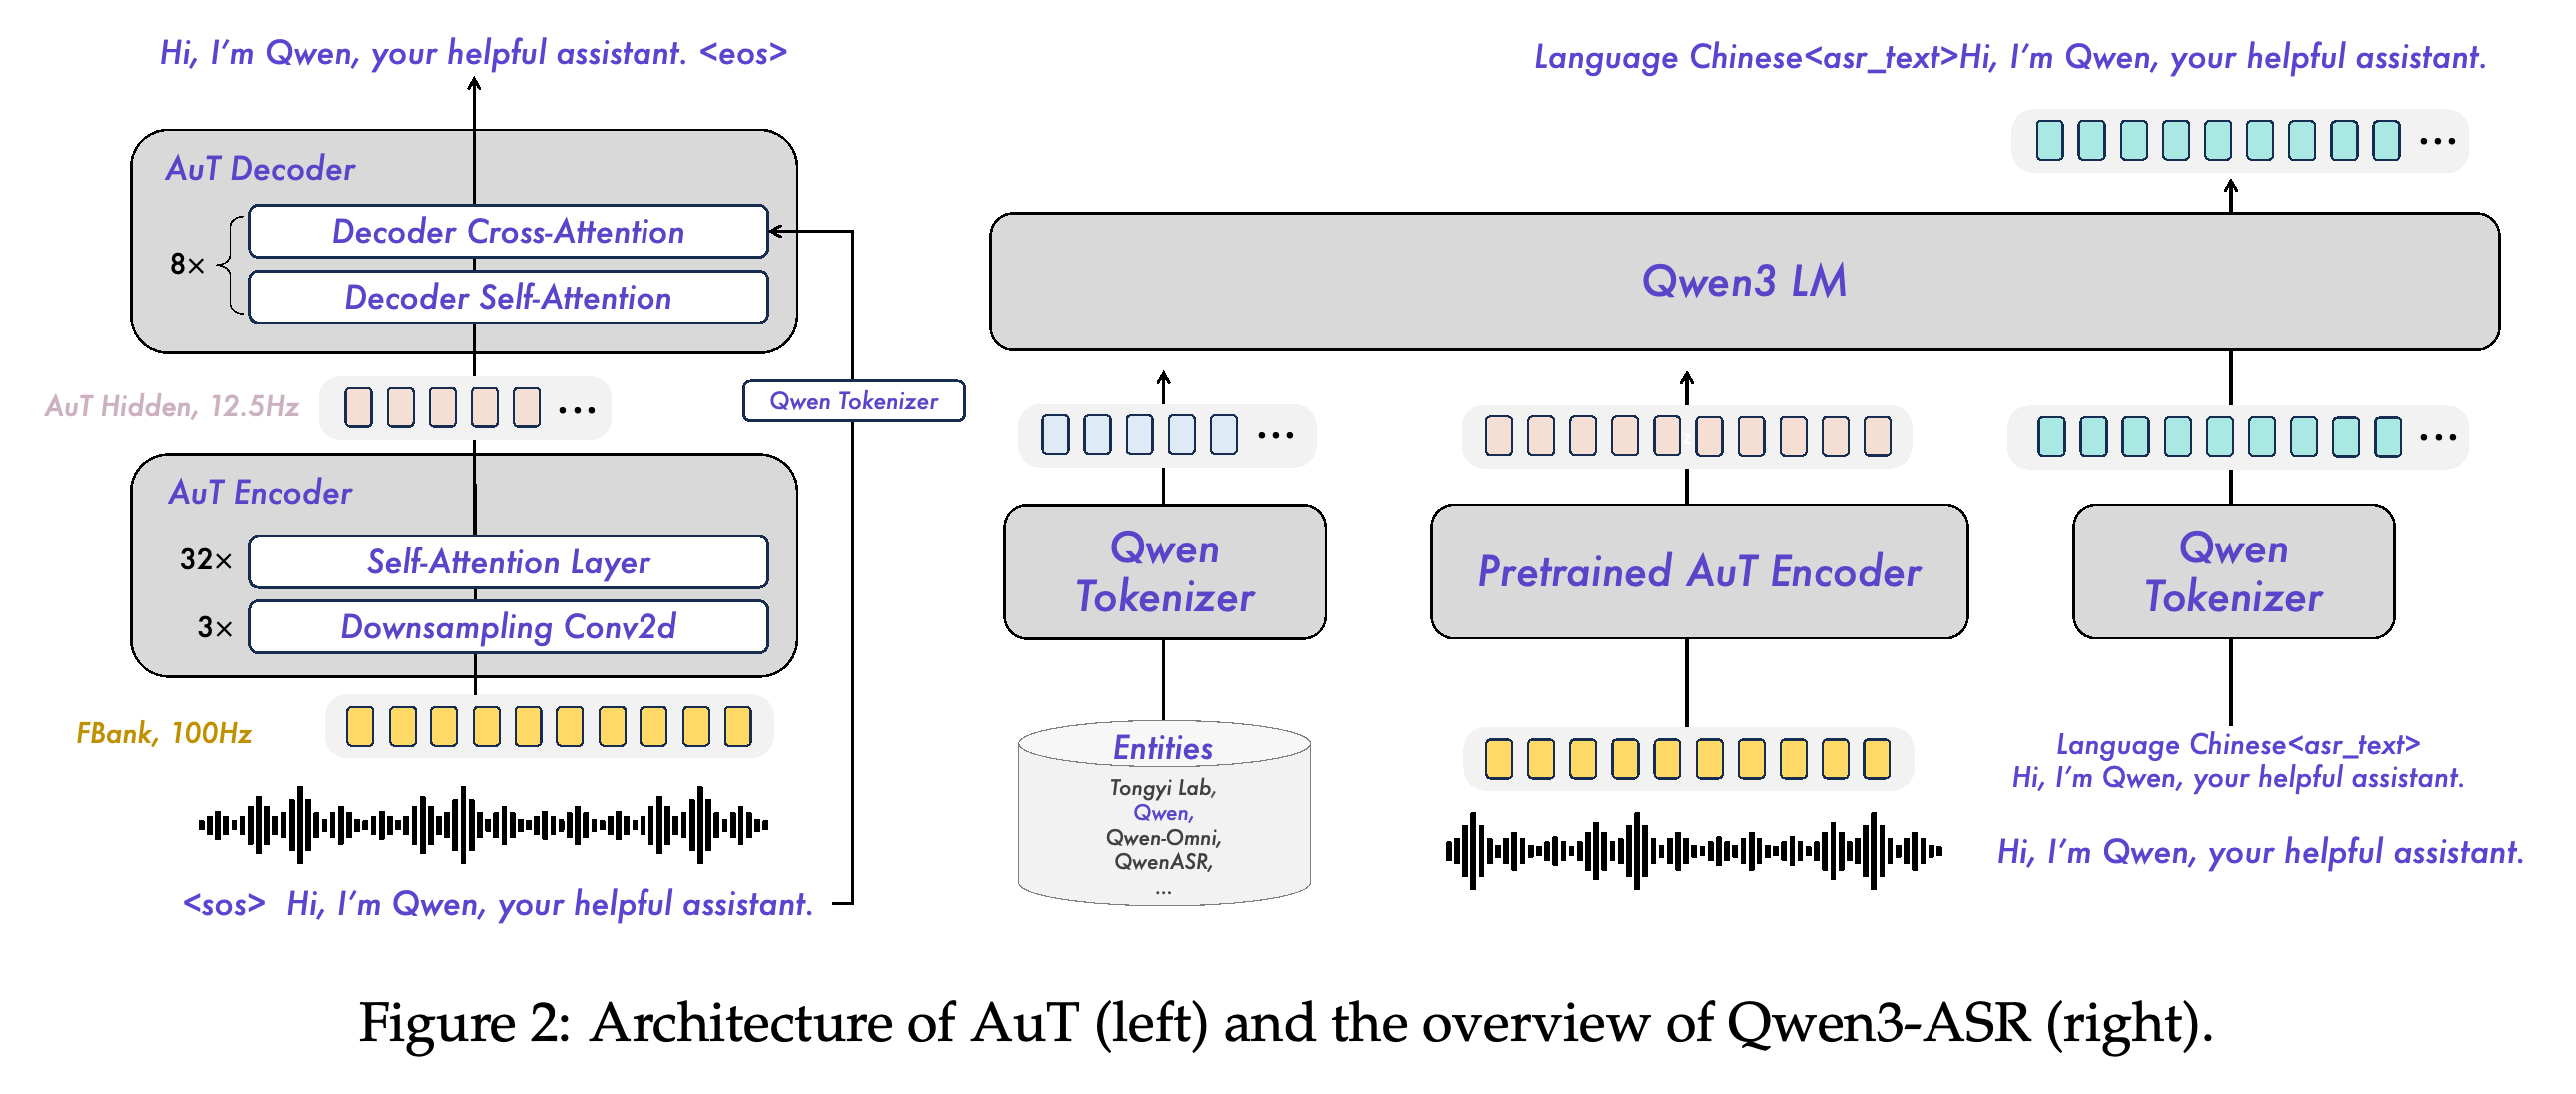
별도로 사전학습한 AuT 인코더는 128차원 Fbank 특징에 8 times 다운샘플링을 적용하여 음성 임베딩으로 변환한다. 출력 토큰 속도는 12.5Hz다. 크기가 1s부터 8s까지 변하는 동적 FlashAttention 윈도우를 통해 같은 구조에서 짧은 스트리밍 청크와 긴 오프라인 입력을 모두 처리한다.
- Qwen3-ASR-1.7B는 Qwen3-1.7B, 프로젝터, 은닉 차원 1024의 300M-parameter AuT 인코더를 결합한다.
- Qwen3-ASR-0.6B는 Qwen3-0.6B, 프로젝터, 은닉 차원 896의 180M-parameter AuT 인코더를 결합한다.
- Figure 2는 AuT의 attention-encoder-decoder 사전학습과 공개 ASR 파이프라인을 구분한다. ASR 파이프라인에서는 인코딩된 음성과 선택적으로 제공되는 개체 문맥이 Qwen3 LM의 조건으로 들어간다.
왼쪽 패널은 attention-encoder-decoder 작업을 통한 AuT 사전학습을 보여준다. 오른쪽 패널은 인코딩된 음성과 토큰화된 개체 문맥을 Qwen3의 조건으로 제공하는 구조를 보여준다. 이를 통해 음향 표현과 문맥 기반 언어 모델링이 전사 파이프라인에 어떻게 들어가는지 설명한다.
2.2 Training Strategies
학습은 AuT 사전학습, Omni 사전학습, ASR 지도 파인튜닝(SFT), ASR 강화학습(RL) 순서로 진행된다. 처음 2개 단계는 Qwen3-Omni를 따른다. 후속 학습에서는 모델을 전사, 언어 식별, 비음성 처리, 스트리밍, 문맥 바이어싱에 특화한다.
- AuT 사전학습에는 주로 중국어와 영어로 구성된 약 40 million hours 분량의 의사 라벨 ASR 데이터를 사용한다. Omni 사전학습에는 모델마다 오디오, 비전, 텍스트의 다중 작업 데이터 3 trillion tokens를 사용한다.
- SFT에는 사전학습 코퍼스와 겹치지 않는 훨씬 작은 다국어 데이터셋을 사용한다. 이 데이터셋에는 비음성, 스트리밍 강화, 문맥 바이어싱 예제가 포함된다. 지시 주입을 완화한다는 목표로 자연어 프롬프트의 지시를 따르지 않는 ASR 전용 동작을 학습하되, 문맥 토큰을 통해 배경 지식을 제공할 수 있도록 한다.
- 인식 가능한 음성이 있을 때의 출력 예시는 <|im_start|>assistant language English<asr_text>Today we release models including Qwen3-ASR-1.7B.<|im_end|>다. 음성이 감지되지 않을 때의 출력은 <|im_start|>assistant language None<asr_text><|im_end|>다.
- RL은 약 50k개 발화에 Group Sequence Policy Optimization (GSPO)을 적용한다. 데이터 구성은 중국어·영어 35%, 다국어 35%, 기능별 데이터 30%다. 저자들은 잡음 강건성과 전사 안정성이 RL로 개선되었다고 설명하지만, 보고서에는 학습 단계별 효과를 분리한 제거 실험이 없다.
2.3 Features
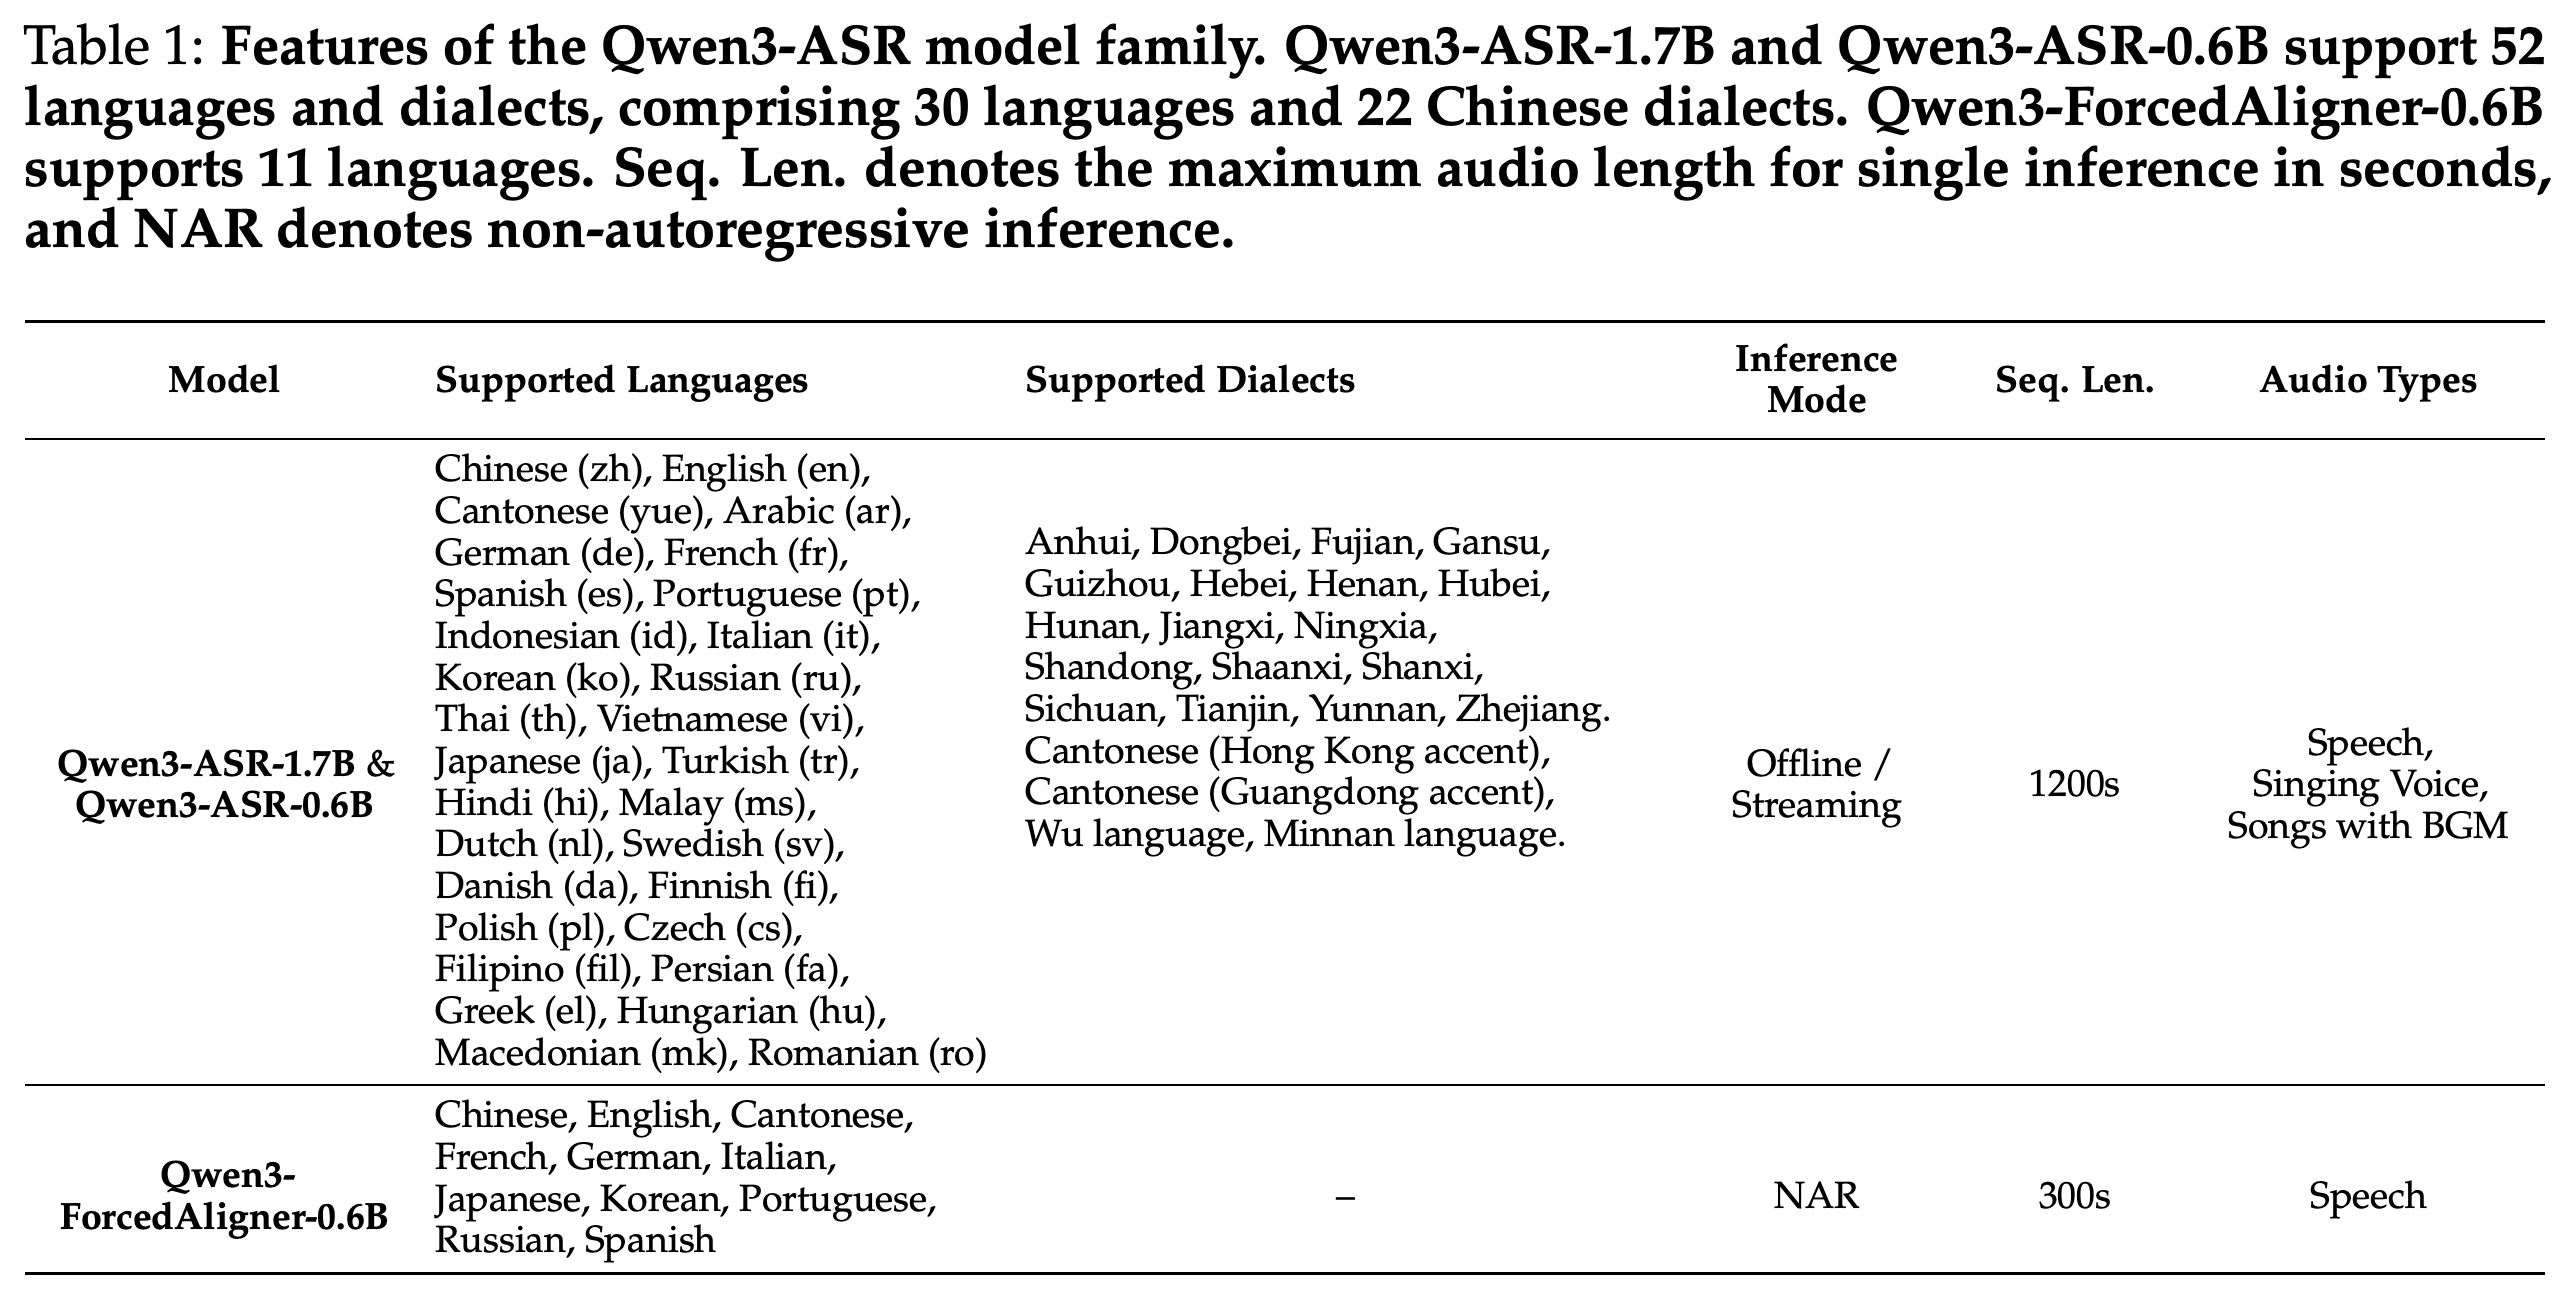
두 ASR 모델은 개별 오디오 입력에서 최대 1200s, 즉 20분까지 오프라인 및 스트리밍 추론을 지원한다. 명시된 지원 범위는 30개 언어, 22개 중국어 방언, 일반 음성, 가창 음성, 배경 음악이 있는 전체 노래다.
- Table 1은 지원 언어와 방언 목록, 추론 모드, 오디오 유형, 최대 입력 길이를 명시한다.
- Qwen3-ForcedAligner-0.6B의 지원 범위는 다르다. 11개 언어의 음성 입력에 비자기회귀 추론을 적용하며, 단일 입력의 최대 길이는 300s다.
- 정렬 모델에 명시된 언어는 Chinese, English, Cantonese, French, German, Italian, Japanese, Korean, Portuguese, Russian, Spanish다.
기능 비교는 ASR 모델 2개의 1200s 오프라인·스트리밍 전사 한도와 정렬 모델의 300s 비자기회귀 음성 정렬 한도를 구분한다. 명시적인 언어 및 방언 목록은 지원 범위를 정의한다. 오디오 유형 열은 음성 정렬과 음성·가창 음성·배경 음악이 있는 노래의 ASR을 구분한다.
2.4 Inference Efficiency
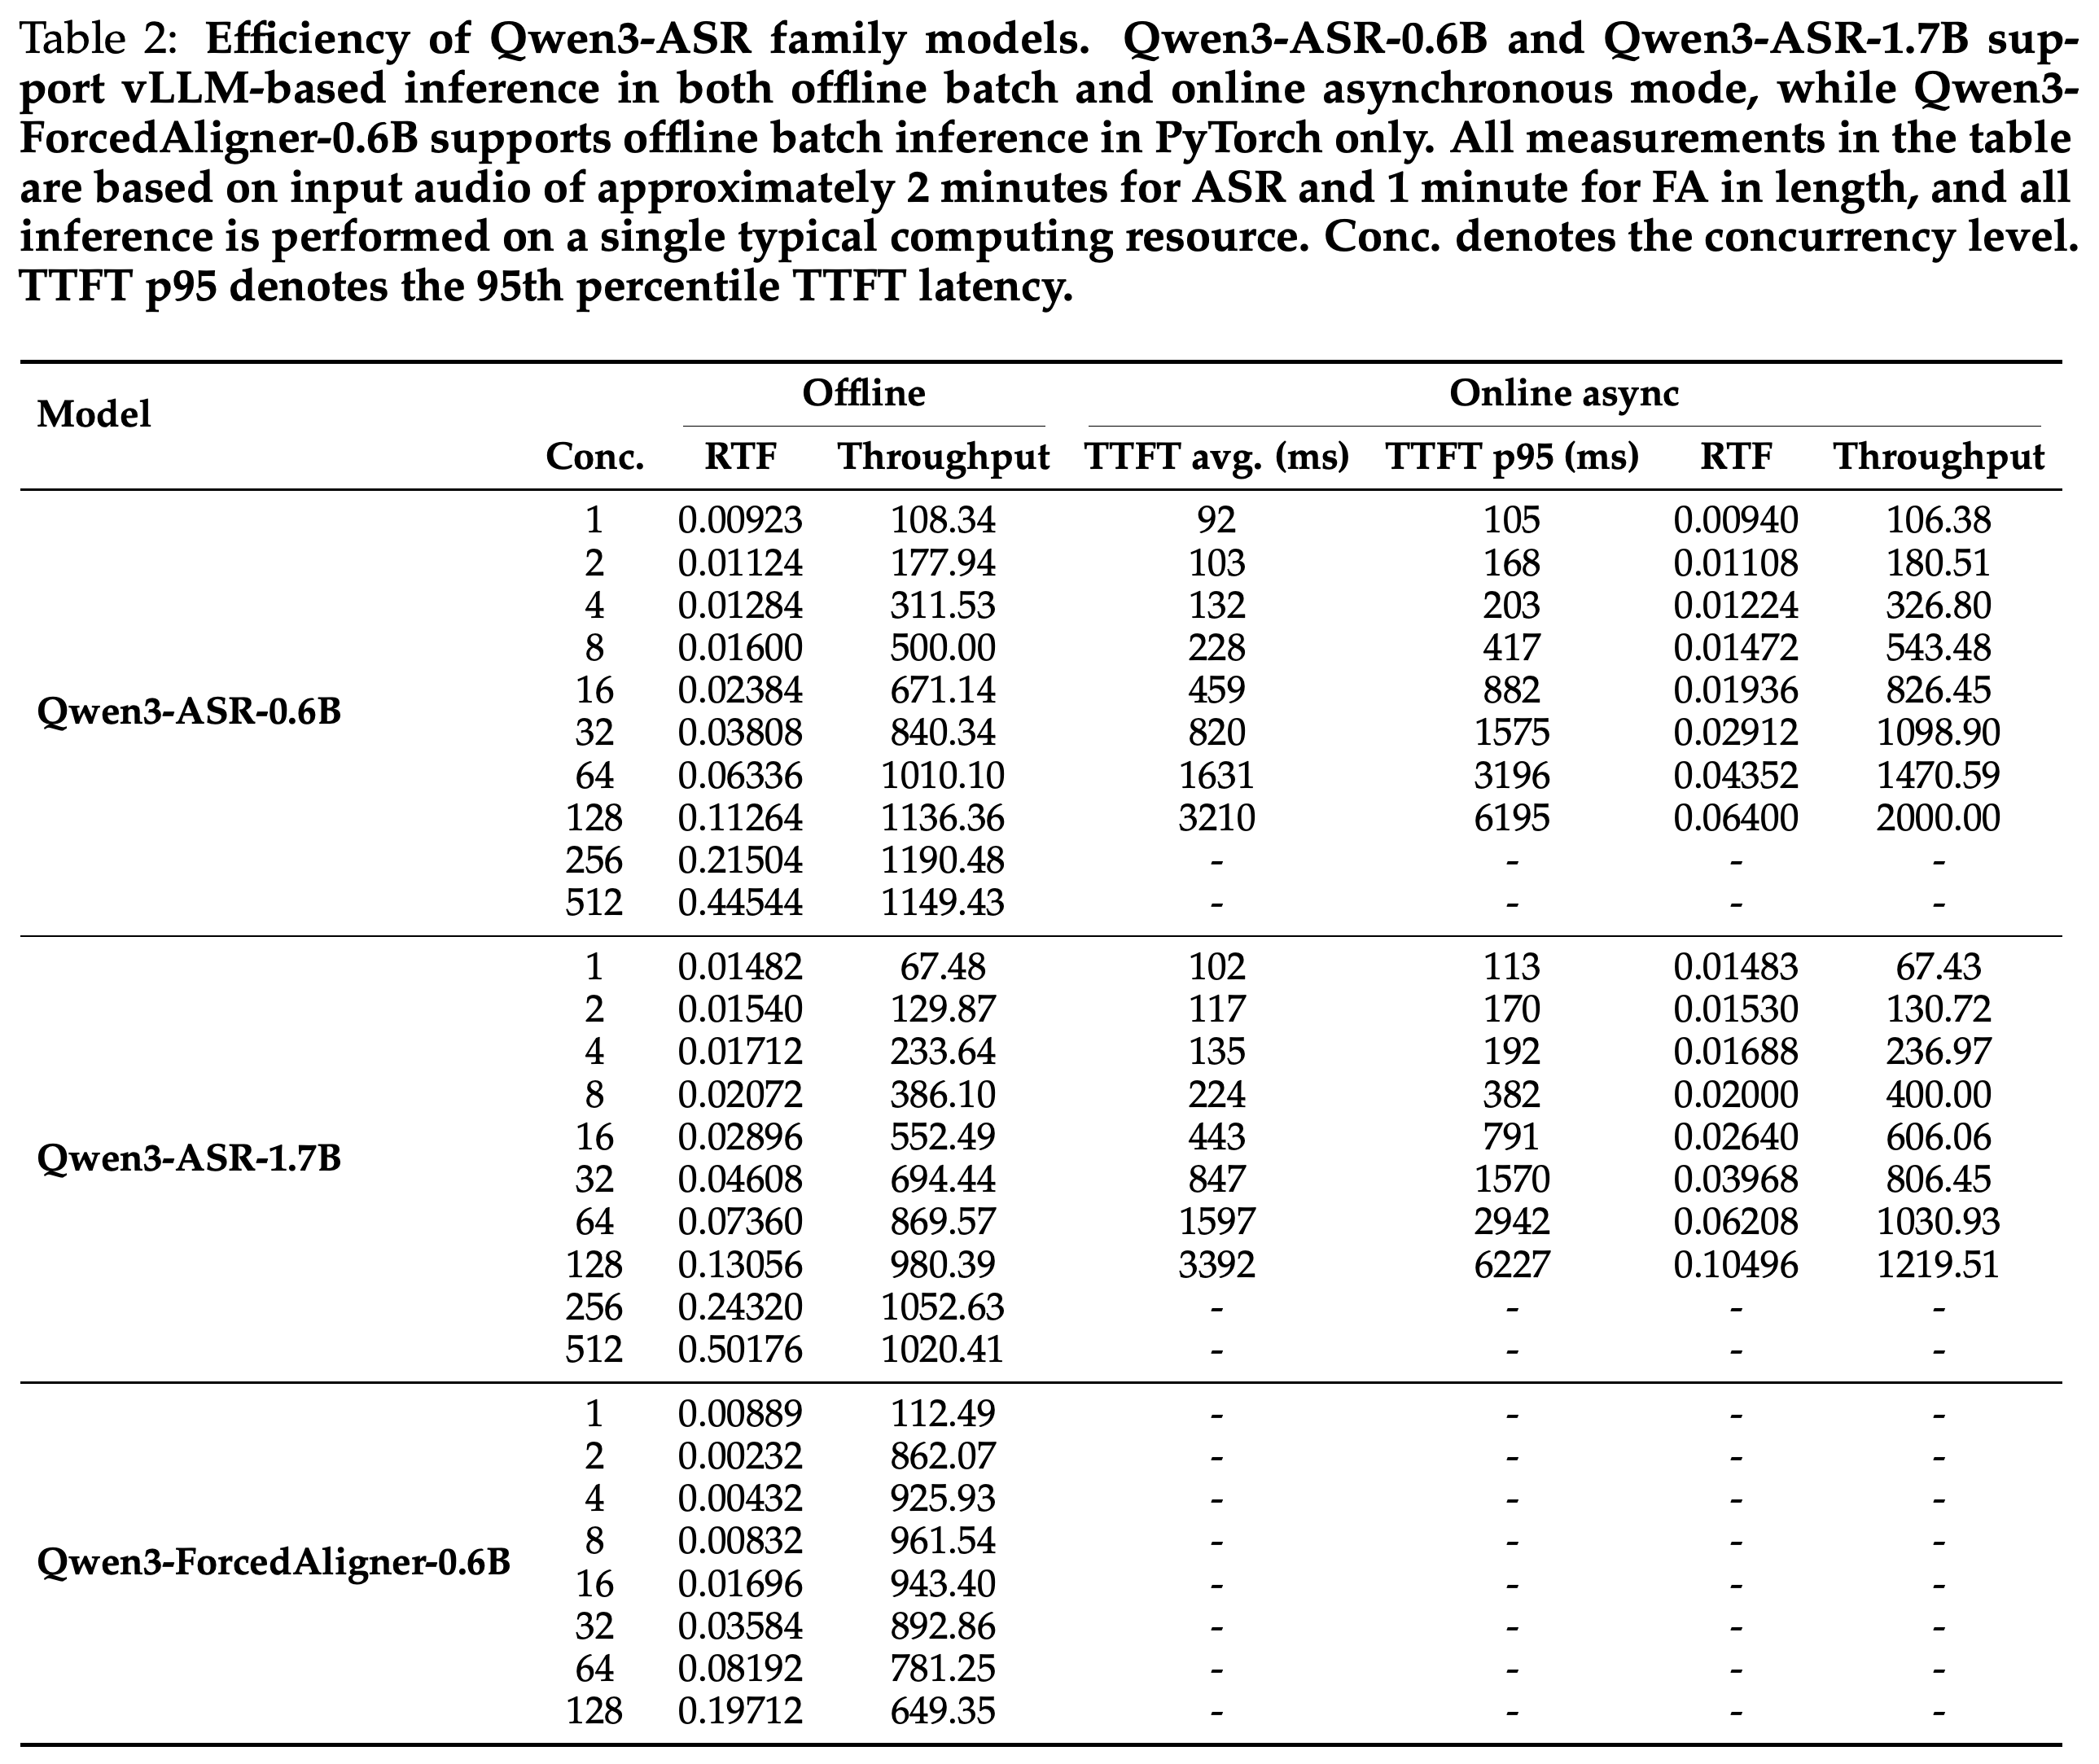
ASR 속도는 CUDA Graph를 활성화한 vLLM v0.14.0과 bfloat16 정밀도로 측정한다. 오프라인 배치 생성과 온라인 비동기 서빙을 별도로 평가한다. Table 2는 단일 컴퓨팅 자원에서 약 2분 길이의 ASR 입력을 사용하지만, 보고서는 하드웨어 모델을 밝히지 않는다.
- Qwen3-ASR-0.6B는 온라인 동시성 1에서 평균 TTFT 92ms, p95 TTFT 105ms, RTF 0.00940, 초당 오디오 106.38초의 처리량을 보인다.
- 같은 모델은 온라인 동시성 128에서 처리량 2000.00과 RTF 0.06400을 달성하지만, 평균 TTFT는 3210ms, p95 TTFT는 6195ms로 증가한다. 따라서 최대 처리량을 달성하는 조건에서 최소 첫 토큰 지연이 유지되지는 않는다.
- Qwen3-ASR-1.7B는 동시성 128에서 온라인 처리량 1219.51, 평균 TTFT 3392ms, RTF 0.10496을 보인다. 작은 모델은 두 추론 모드에서 동시성이 같을 때 모두 더 높은 처리량을 보이지만, 모든 온라인 조건에서 평균 TTFT가 더 낮은 것은 아니다.
동시성이 높아지면 전체 ASR 처리량이 증가하지만 첫 토큰 지연도 늘어난다. Qwen3-ASR-0.6B의 평균 TTFT 92ms는 동시성 1에서 측정되며, 처리량 2000.00은 평균 TTFT가 3210ms인 동시성 128에서 측정된다. 별도로 제시된 정렬 행에서는 동시성 8에서 오프라인 처리량이 최대가 된다.
3 Qwen3-ForcedAligner
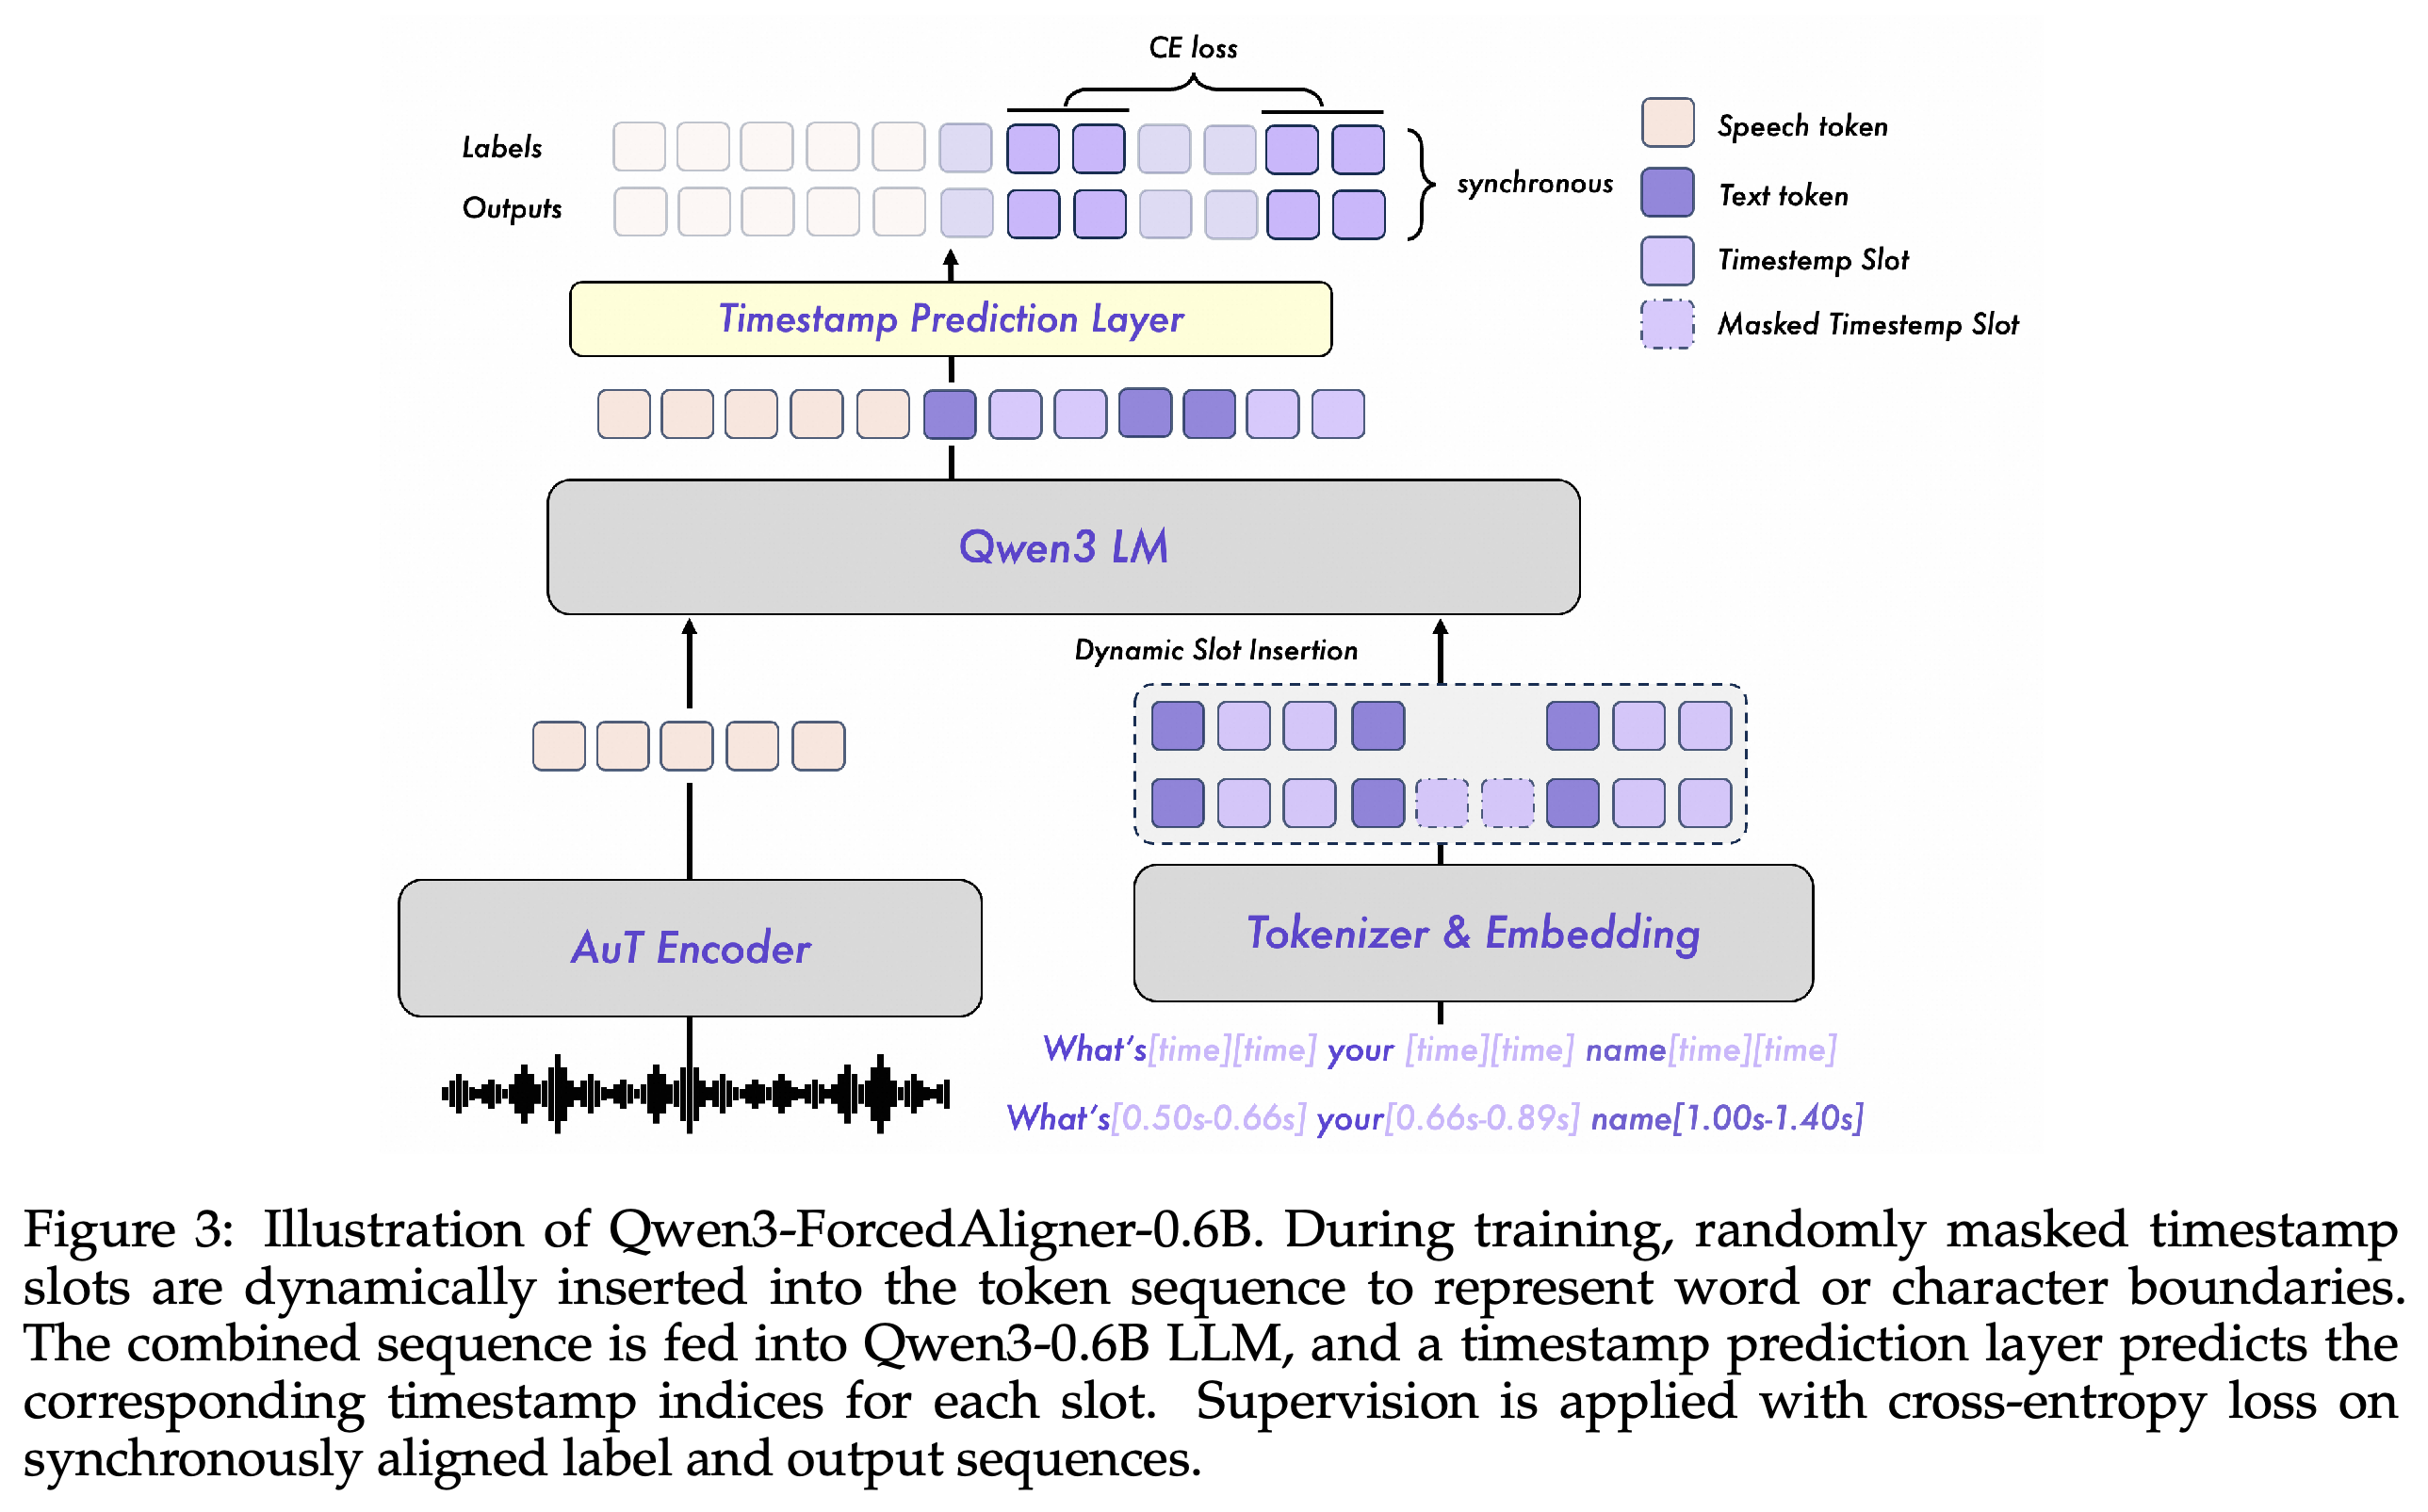
Qwen3-ForcedAligner-0.6B는 전사문 생성과 타임스탬프 추정을 분리한다. 음성과 전사문을 입력받으면 타임스탬프 시퀀스를 자기회귀적으로 생성하는 대신, LLM 기반 슬롯 채우기 작업으로 시간 경계를 예측한다.
3.1 Overview
전사문에 [time] 토큰을 추가하여 요청된 단어나 문자의 시작·종료 경계를 표시한다. 모델은 각 슬롯의 이산 타임스탬프 인덱스를 직접 예측한다. 경계 위치를 지정하여 선택적 정렬과 단어·문장·문단 단위 정렬을 수행할 수 있다.
- 보고서는 사람이 주석을 단 데이터셋에서 경쟁 정렬 방법보다 Accumulated Average Shift가 상대적으로 67%–77% 감소했다고 주장한다. 다만 방법별 전체 평균은 동일한 시나리오를 포함하지 않는다.
- 모델은 단일 가중치 세트로 언어 간 혼합 시나리오를 포함한 11개 언어의 음성을 최대 300초까지 지원한다.
- 비자기회귀 예측은 타임스탬프 슬롯에 대한 순차적 다음 토큰 디코딩을 없앤다.
3.2 Model Design
사전학습된 AuT 인코더는 음성 임베딩을 제공하고, 토크나이저는 [time] 슬롯이 포함된 전사문 임베딩을 제공한다. Qwen3-0.6B가 이들을 결합한 시퀀스를 처리하며, 선형 타임스탬프 예측 층이 요청된 각 경계를 분류한다.
- 학습 타임스탬프는 AuT 인코더의 프레임 길이인 80ms로 값을 나누어 이산화한다. 예측 층은 3,750개 클래스로 구성되며, 이는 명시된 입력 한도 300s에 해당한다.
- [time] 토큰과 예측 층 모두 언어별 음소 목록이나 사전을 필요로 하지 않는다. 다국어 처리 능력은 음성 인코더와 언어 모델에서 나온다.
- Figure 3은 출력과 라벨의 위치를 일치시킨 구조를 보여준다. 위치를 시프트한 다음 토큰 예측 목적함수 대신 타임스탬프 슬롯에 교차 엔트로피 손실을 적용한다.
음성 임베딩과 동적으로 삽입된 타임스탬프 슬롯을 포함한 전사문이 같은 언어 모델 백본에 들어간다. 위치를 일치시킨 라벨과 출력은 각 슬롯에서 타임스탬프 분류를 학습하는 방식을 보여준다. 타임스탬프를 자기회귀적으로 생성하지 않고 병렬로 계산한다.
3.3 Training Strategies
정렬 모델은 Montreal Forced Aligner (MFA)가 생성한 의사 타임스탬프 라벨로 학습하여 대규모 수작업 경계 주석 비용을 피한다. 저자들은 학습된 모델이 잡음이 있는 MFA 라벨을 증류하고 평활화한다고 설명한다. 사람이 주석을 단 데이터를 통한 평가는 의사 라벨 생성 도구와의 일치 여부를 넘어서는 성능을 검증한다.
- 학습에서는 인과적 처리를 유지하되 출력과 라벨 시퀀스를 시프트하지 않는다. 따라서 각 타임스탬프 슬롯은 자신의 위치에서 감독 신호를 받으며 앞선 문맥을 활용할 수 있다.
- 교차 엔트로피 손실은 타임스탬프 슬롯에서만 계산한다. 최적화는 전사문 생성이 아니라 경계 예측에 집중한다.
- 동적 슬롯 삽입은 각 단어나 문자 뒤에 시작·종료 슬롯을 추가할지 무작위로 결정한다. 이를 통해 다양한 경계 선택 패턴을 처리하도록 모델을 학습한다.
3.4 Inference and Usability
추론할 때 사용자는 선택한 단어나 문자 뒤에 경계 슬롯을 삽입하며, 모델은 모든 슬롯 인덱스를 동시에 예측한다. 예측한 각 인덱스에 80ms를 곱하면 타임스탬프로 변환된다.
- 정렬 속도는 약 1분 길이의 입력에서 Transformers, FlashAttention, bfloat16을 사용하여 측정한다. Table 2는 이를 오프라인 PyTorch 추론으로만 명시한다.
- 명시된 정렬 처리량의 최댓값은 동시성 8에서 초당 오디오 961.54초이며, RTF는 0.00832다. 동시성 128에서는 처리량 649.35, RTF 0.19712를 보인다.
- 높은 동시성에서 RTF가 0.001에 가깝다는 본문 주장은 Table 2의 요청별 RTF 값과 일치하지 않는다. 전체 처리량이 약 1,000배에 이른다는 사실을 요청별 지연과 혼동해서는 안 된다.
4 Experiments
실험은 전사 정확도, 언어 식별, 스트리밍 인식, 가창 음성과 노래 전사, 강제 정렬 정밀도를 평가한다. 공개 데이터셋에 더해 억양, 방언, 화자 연령 차이, 어려운 음향 조건, 대화 음성을 다루는 내부 테스트를 사용한다.
4.1 Evaluation Details
ASR 비교 모델에는 GPT-4o-Transcribe, Gemini-2.5-Pro, Doubao-ASR, Whisper-large-v3, FunASR-MLT-Nano가 포함되며, 다국어 평가에는 GLM-ASR-Nano도 포함된다. 문자 기반 언어의 인식 성능은 CER로, 단어가 구분되는 언어는 WER로 측정한다. 다국어 및 방언의 종합 결과에는 가중치 없는 매크로 평균을 사용한다.
- 내부 강건성 평가에는 영어 억양 16개 그룹, 중국어 방언 22개 변종, 고령자와 아동의 음성, SNR이 극히 낮은 오디오, 반복 발화, 여러 화자가 참여하는 표준 중국어 대화가 포함된다.
- 언어 식별은 정확도로 평가한다. 타임스탬프 정밀도에는 예측 타임스탬프와 기준 타임스탬프의 절대 차이를 평균한 Accumulated Average Shift (AAS)를 사용한다.
-
(\mathrm{AAS}=\frac{1}{N}\sum_{i=1}^{N}\left \hat{n}_i-n_i\right )이며, N은 타임스탬프 슬롯 수, n̂ᵢ는 예측 타임스탬프, nᵢ는 MFA로 생성하거나 사람이 주석을 단 기준 타임스탬프다.
4.2 English & Chinese ASR Performance
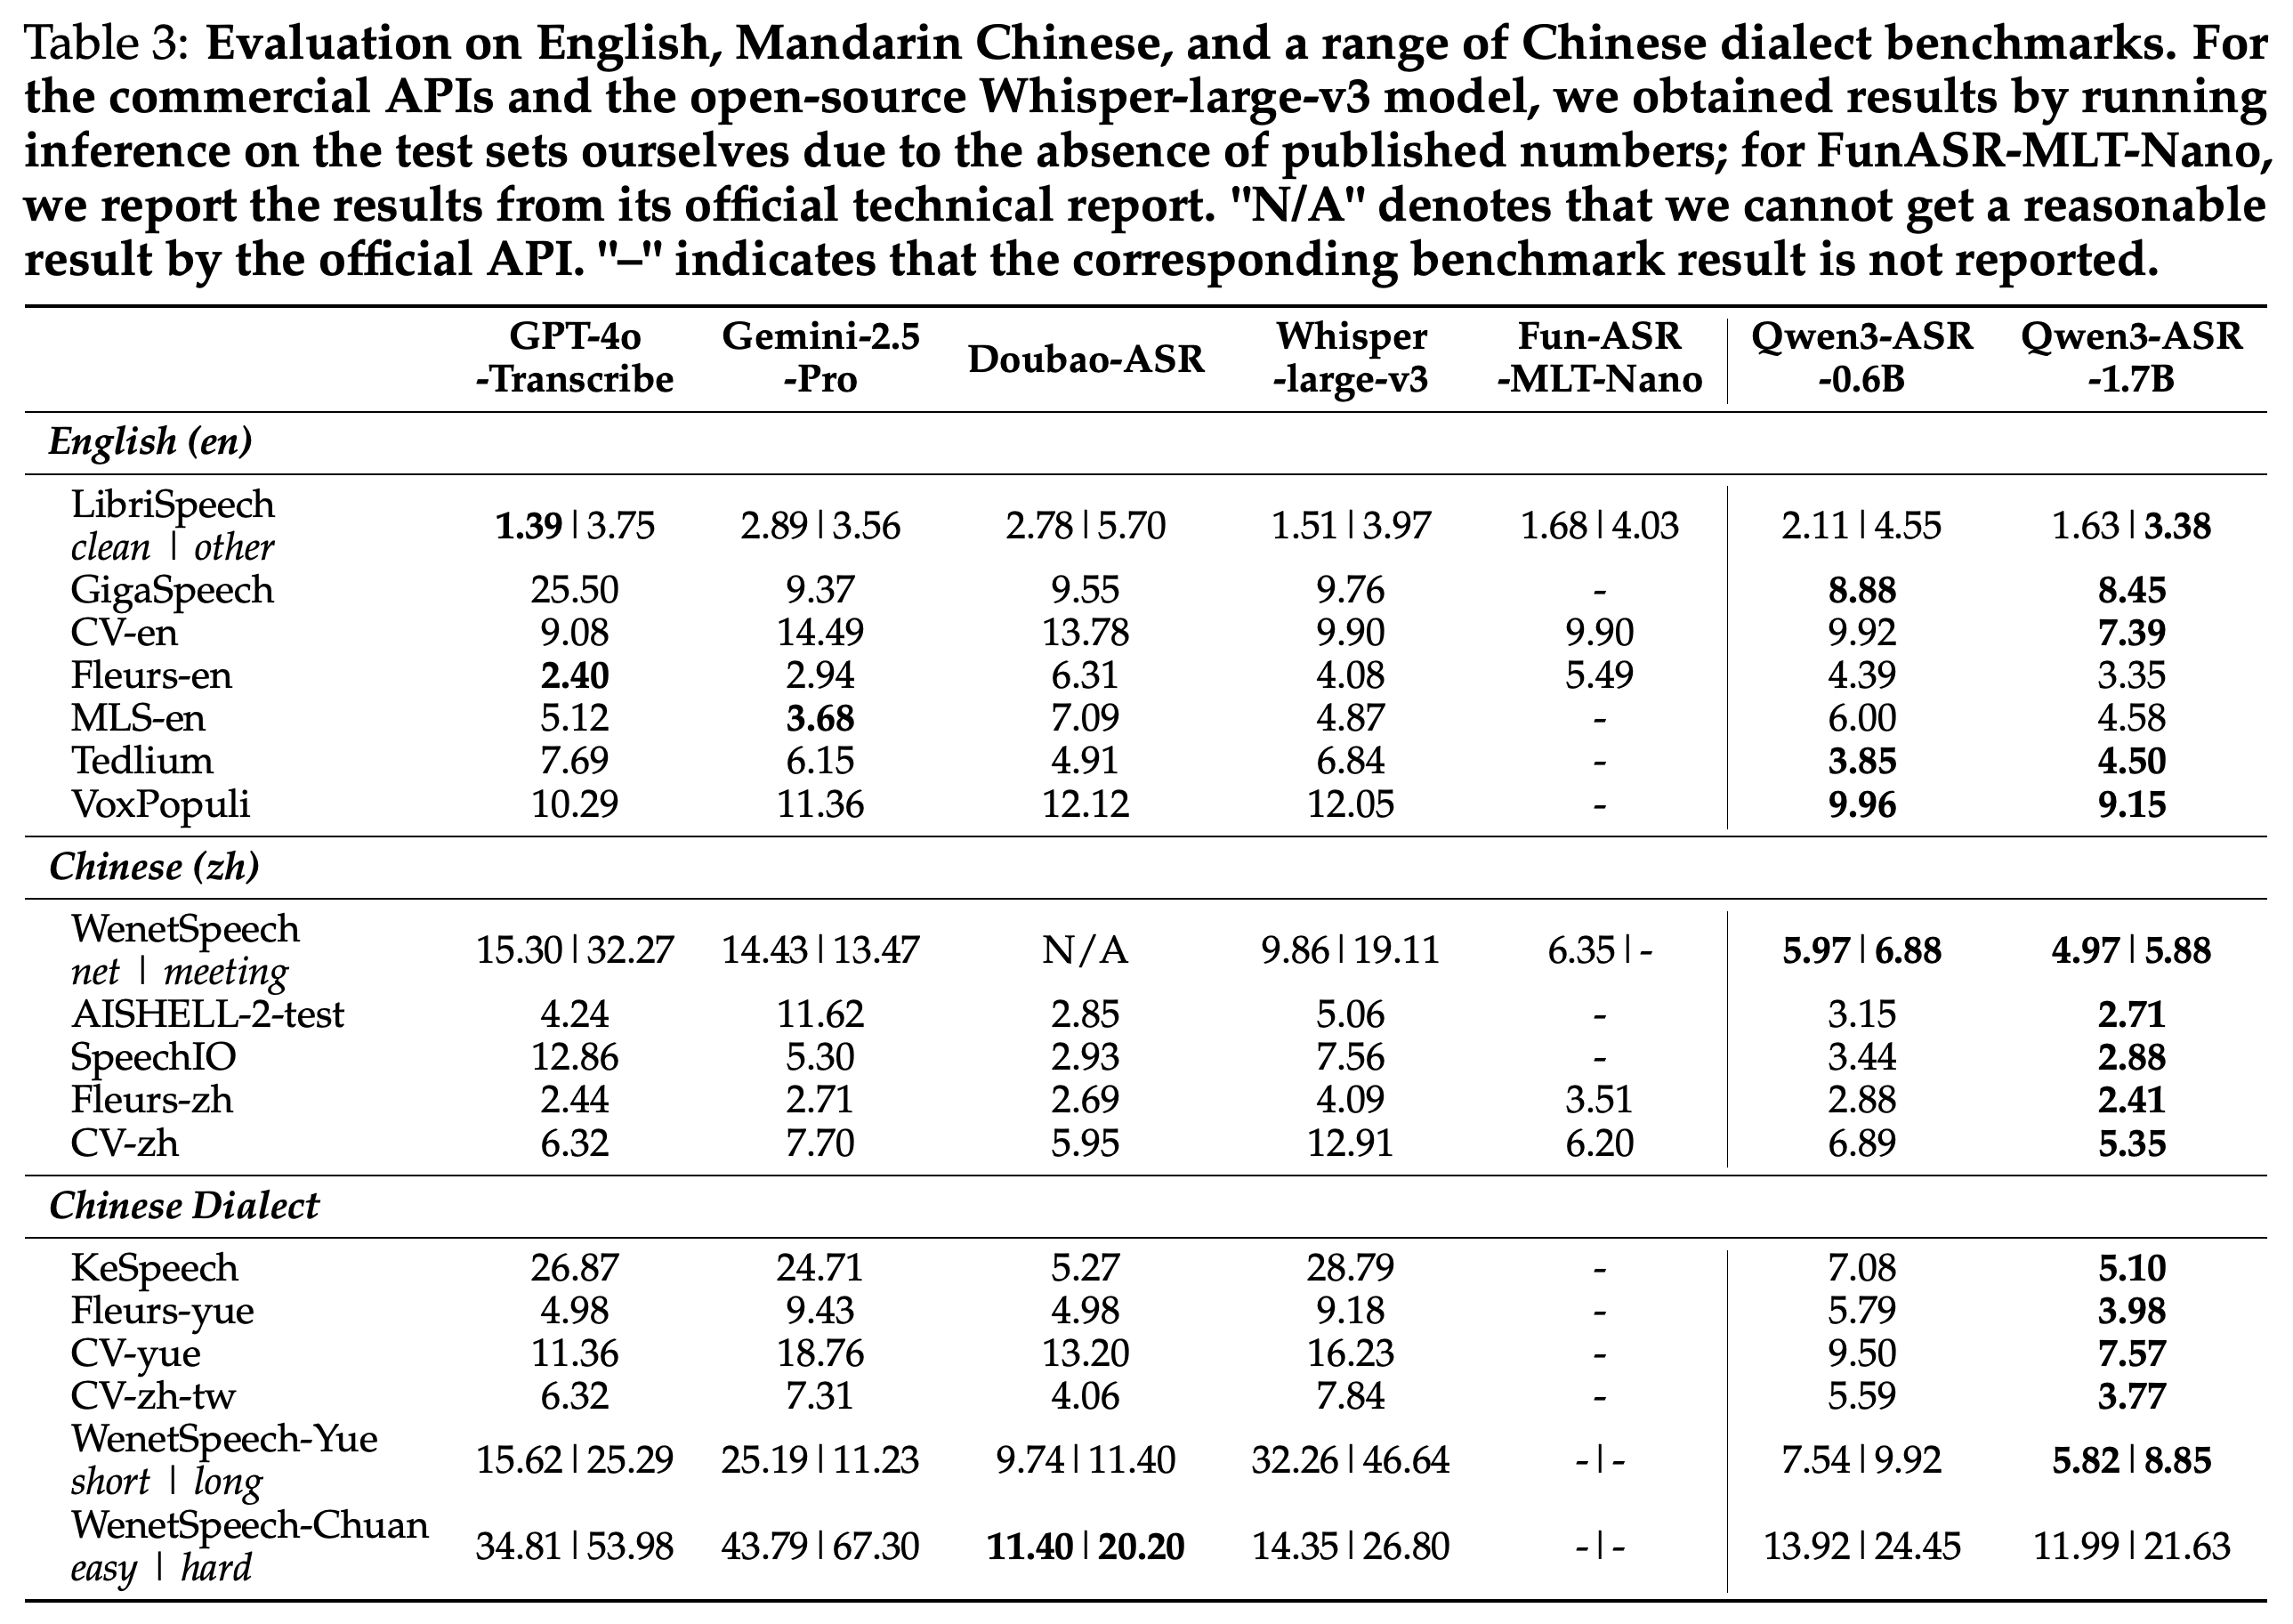
4.2.1 Opensource ASR Benchmarks: Table 3은 표준 중국어와 방언에서 강한 성능을 보여주지만, 영어에서는 순위가 엇갈린다. Qwen3-ASR-1.7B의 WenetSpeech net/meeting 오류는 4.97/5.88로, Whisper-large-v3의 9.86/19.11보다 낮다. WenetSpeech-Yue short/long 오류는 5.82/8.85다.
- 영어에서 1.7B 모델은 GigaSpeech 8.45, CV-en 7.39, VoxPopuli 9.15를 달성하며, 해당 데이터셋에서 명시된 결과 중 오류가 가장 낮다.
- 항상 가장 좋은 것은 아니다. LibriSpeech clean에서는 GPT-4o-Transcribe가 1.39, Qwen3-ASR-1.7B가 1.63을 보이며, Fleurs-en에서는 각각 2.40과 3.35를 보인다. Tedlium에서는 작은 Qwen 모델도 3.85로 4.50보다 더 좋은 점수를 낸다.
- WenetSpeech-Chuan easy/hard에서는 Doubao-ASR가 11.40/20.20으로 Qwen3-ASR-1.7B의 11.99/21.63보다 앞선다. 이는 특정 방언에서 나타나는 예외다.
- 상용 API와 Whisper 결과는 저자들이 직접 추론하여 얻었으며, FunASR-MLT-Nano 결과는 해당 기술 보고서에서 가져왔다. N/A는 저자들이 합리적인 방식으로 얻을 수 없었던 API 결과를 뜻하며, 대시는 보고되지 않은 결과를 뜻한다.
공개 결과는 표준 중국어와 광둥어에서 특히 강한 성능을 뒷받침하며, WenetSpeech에서는 Whisper보다 크게 개선된다. 영어와 쓰촨어 행에서는 일부 상용 시스템이나 작은 Qwen 모델의 오류가 더 낮다. 따라서 모든 조건에서 우세하다는 주장에는 예외가 있다.
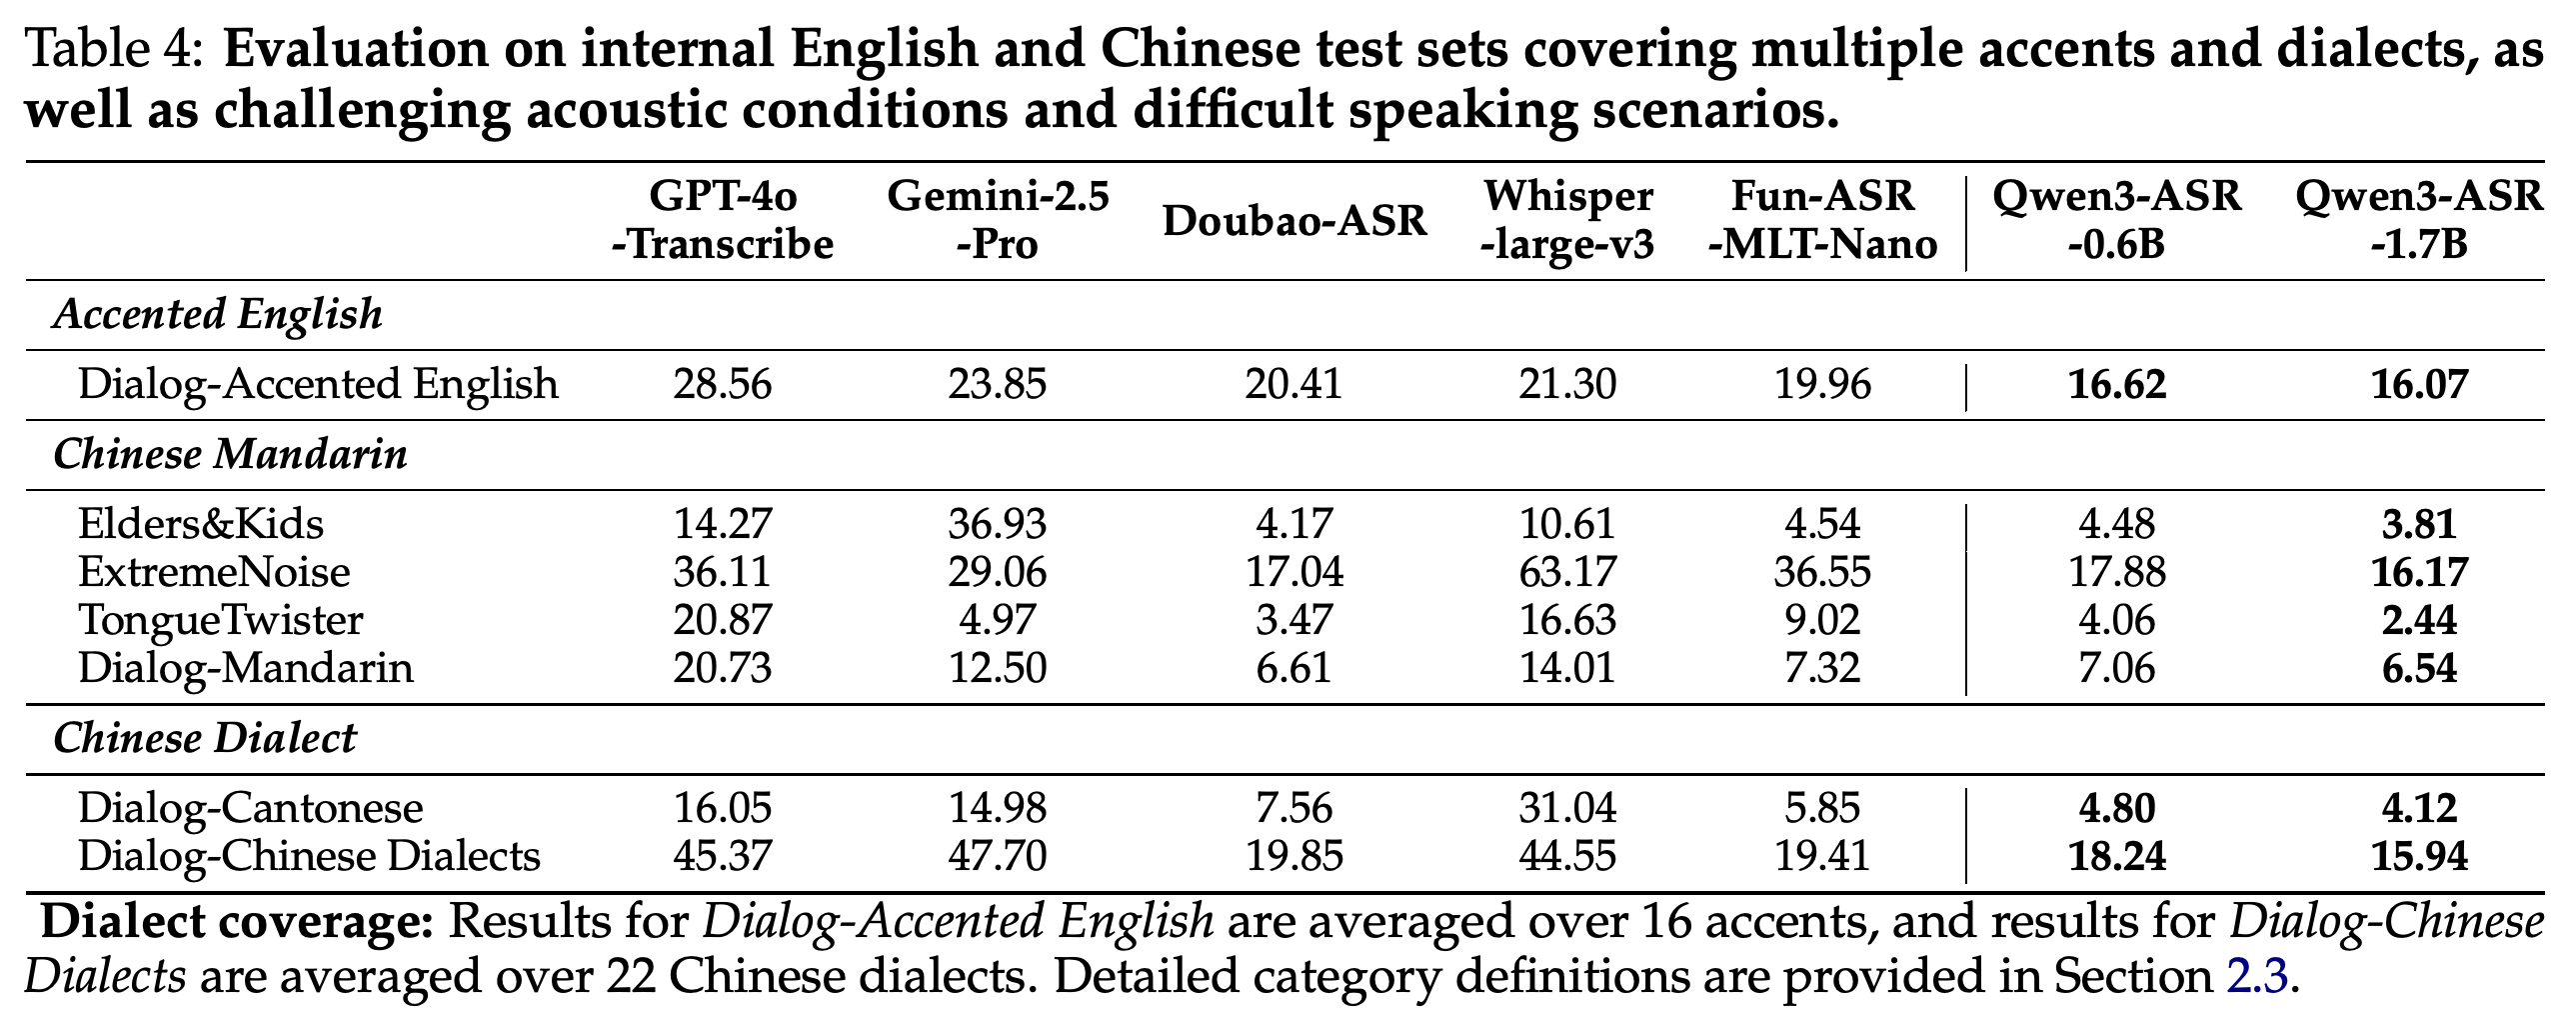
4.2.2 Internal ASR Benchmarks: Qwen3-ASR-1.7B는 Table 4의 내부 하위 집합 7개 모두에서 오류가 가장 낮다. 억양이 있는 영어의 WER는 16.07로, 0.6B 모델의 16.62와 명시된 비Qwen 모델 중 가장 좋은 결과인 19.96보다 낮다.
- 표준 중국어 결과는 Elders&Kids 3.81, ExtremeNoise 16.17, TongueTwister 2.44, Dialog-Mandarin 6.54다.
- 대화형 광둥어 오류는 4.12다. 중국어 방언 22개의 매크로 평균은 15.94로, Qwen3-ASR-0.6B의 18.24보다 낮다.
- 이 결과는 저자들의 테스트 범위에서 강건성을 뒷받침한다. 다만 보고서는 데이터셋 크기를 명시하지 않으며, 독립적인 재현을 위한 내부 테스트 공개본도 제공하지 않는다.
Qwen3-ASR-1.7B는 모든 내부 하위 집합에서 명시된 오류가 가장 낮으며, 0.6B 모델보다 일관되게 개선된다. 각 행은 깨끗한 음성을 넘어 억양, 화자 연령 차이, 잡음, 반복, 대화, 방언 다양성으로 평가를 확장한다. 다만 보고서는 이 테스트를 재현하는 데 필요한 세부 정보를 제한적으로 제공한다.
4.3 Multilingual ASR and Language Identification
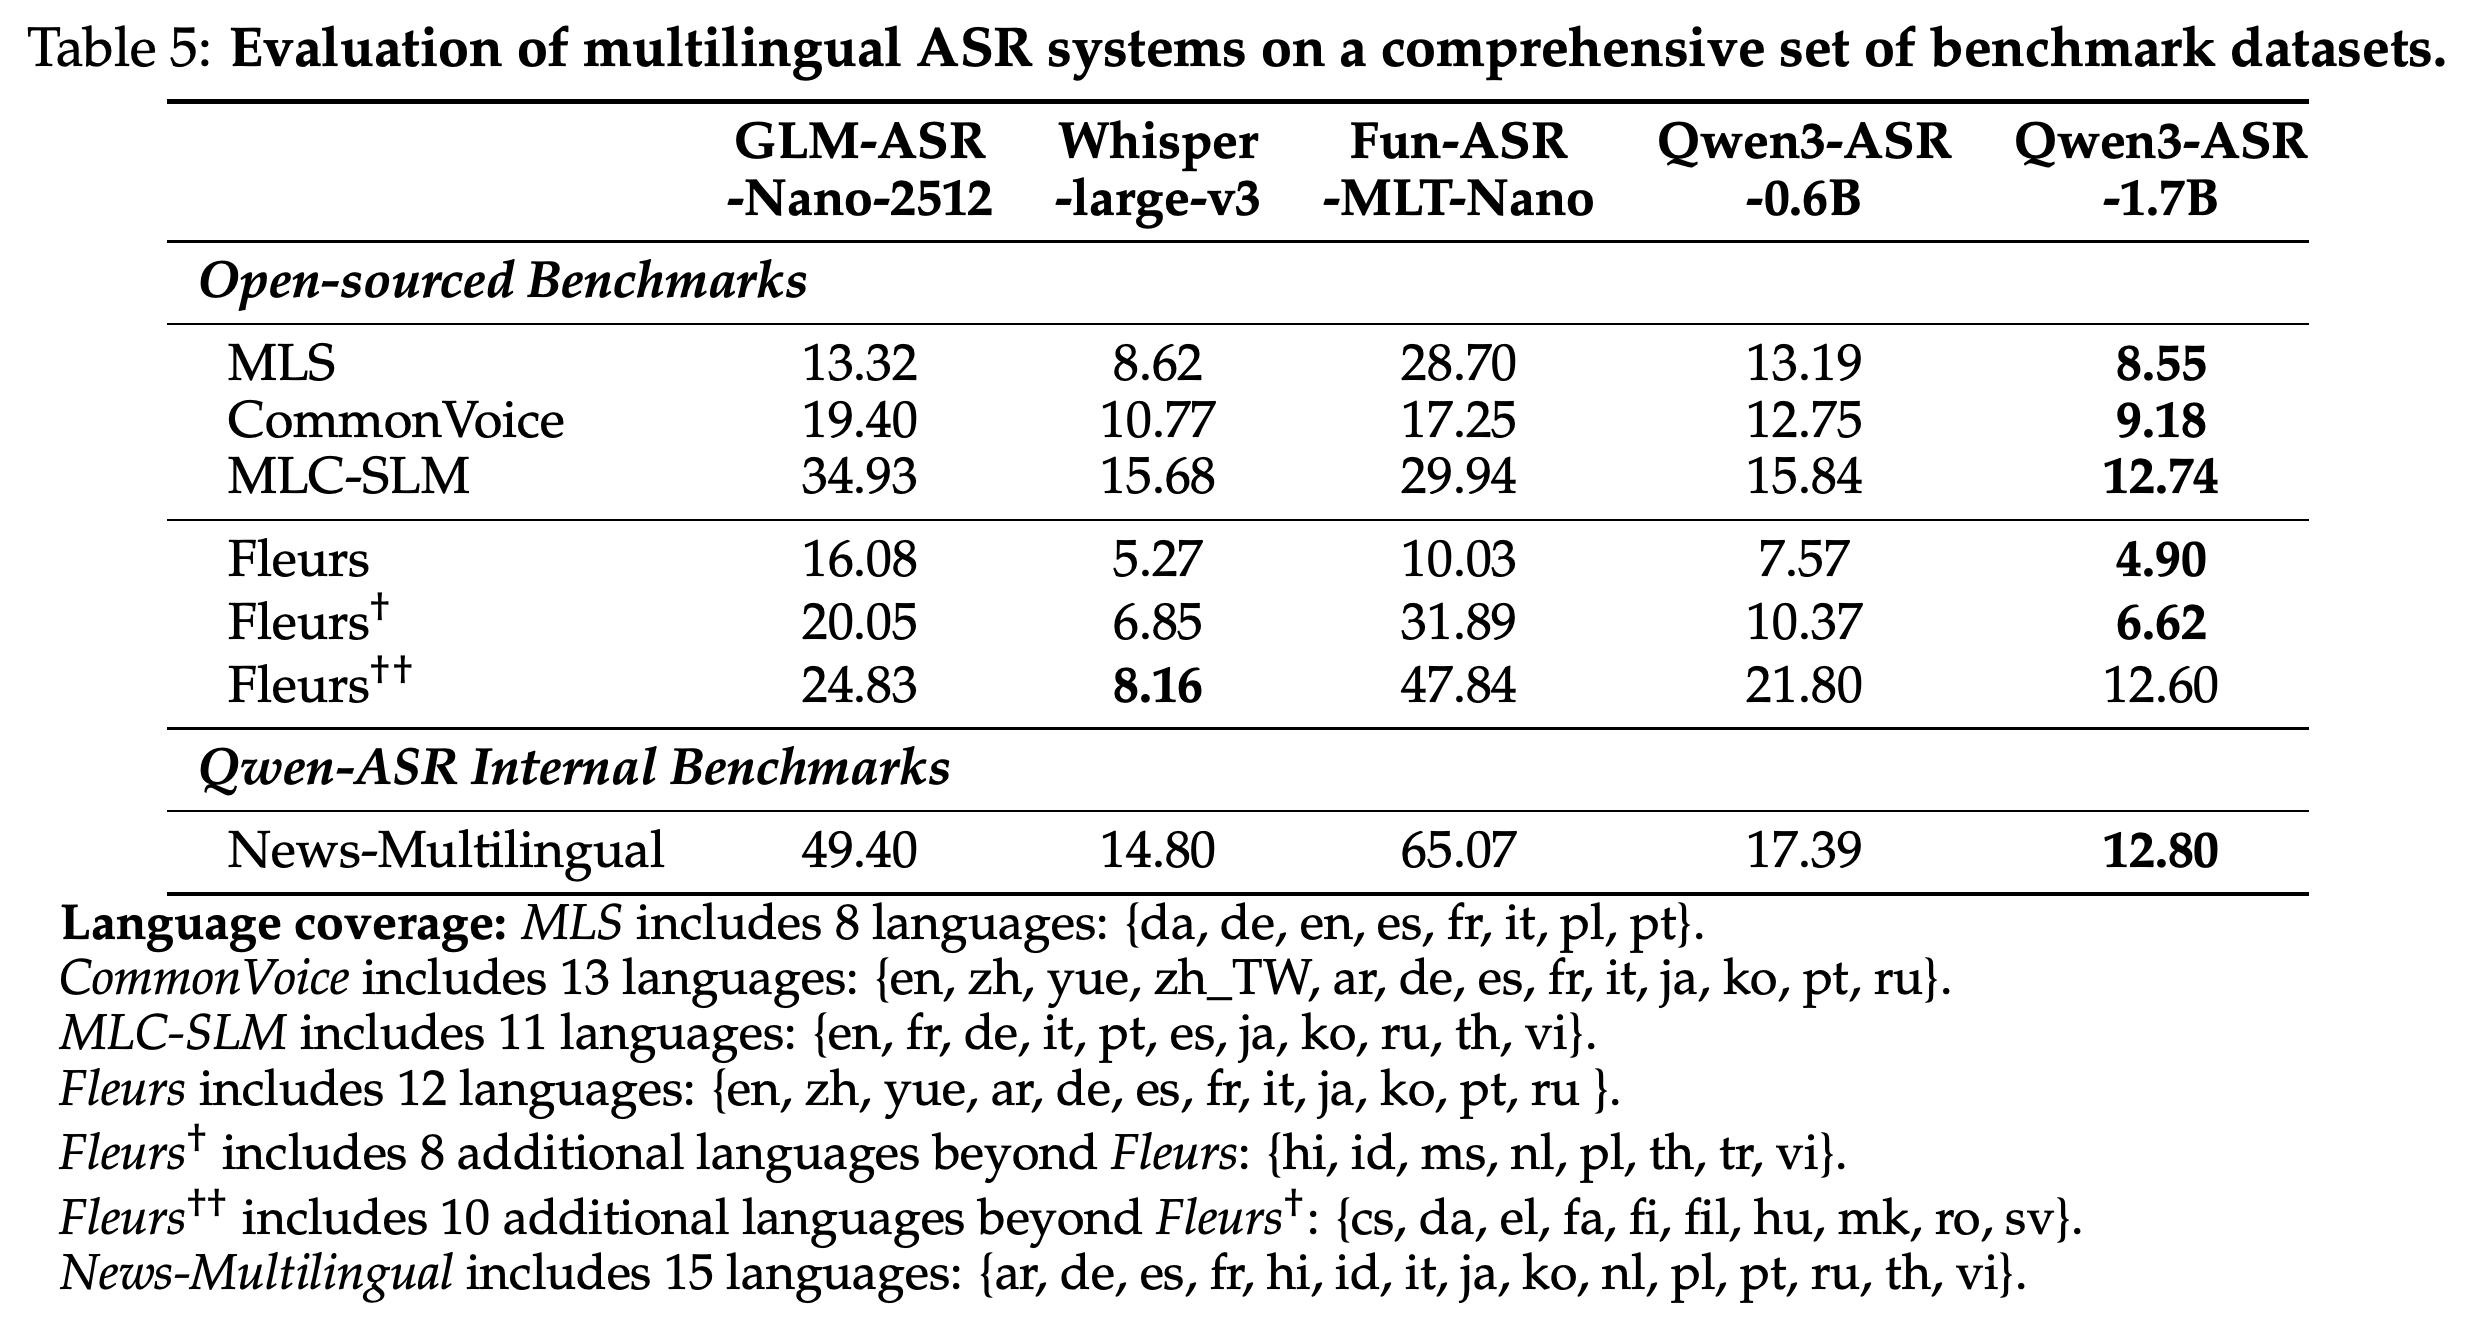
4.3.1 Multilingual ASR Performance: Qwen3-ASR-1.7B는 MLS, CommonVoice, MLC-SLM, 12개 및 20개 언어의 Fleurs 하위 집합, 내부 News-Multilingual에서 명시된 오픈소스 비교 모델보다 앞선다. 그러나 전체 30개 언어를 평가하는 Fleurs에서는 Whisper-large-v3의 평균 오류가 상당히 더 낮다.
- 1.7B 모델의 평균은 MLS 8.55, CommonVoice 9.18, MLC-SLM 12.74다. Whisper-large-v3의 결과는 각각 8.62, 10.77, 15.68이다.
- Fleurs, Fleurs†, Fleurs††는 각각 12개, 20개, 30개 언어로 평가 범위를 넓힌다. Qwen3-ASR-1.7B의 점수는 4.90, 6.62, 12.60이며, Whisper-large-v3의 점수는 5.27, 6.85, 8.16이다.
- 15개 언어의 News-Multilingual 테스트에서 1.7B 모델은 12.80을 보인다. Whisper-large-v3는 14.80, Qwen3-ASR-0.6B는 17.39다.
Fleurs의 언어 범위를 점차 넓히면 좁은 범위의 평균에서는 드러나지 않던 한계가 나타난다. Qwen3-ASR-1.7B는 12개와 20개 언어에서는 앞서지만, 30개 언어에서는 Whisper-large-v3보다 뒤처진다. 다른 행에서는 MLS, CommonVoice, 대화형 다국어 음성, 내부 뉴스 음성에서 명시된 비교 모델보다 평균 오류가 낮다.
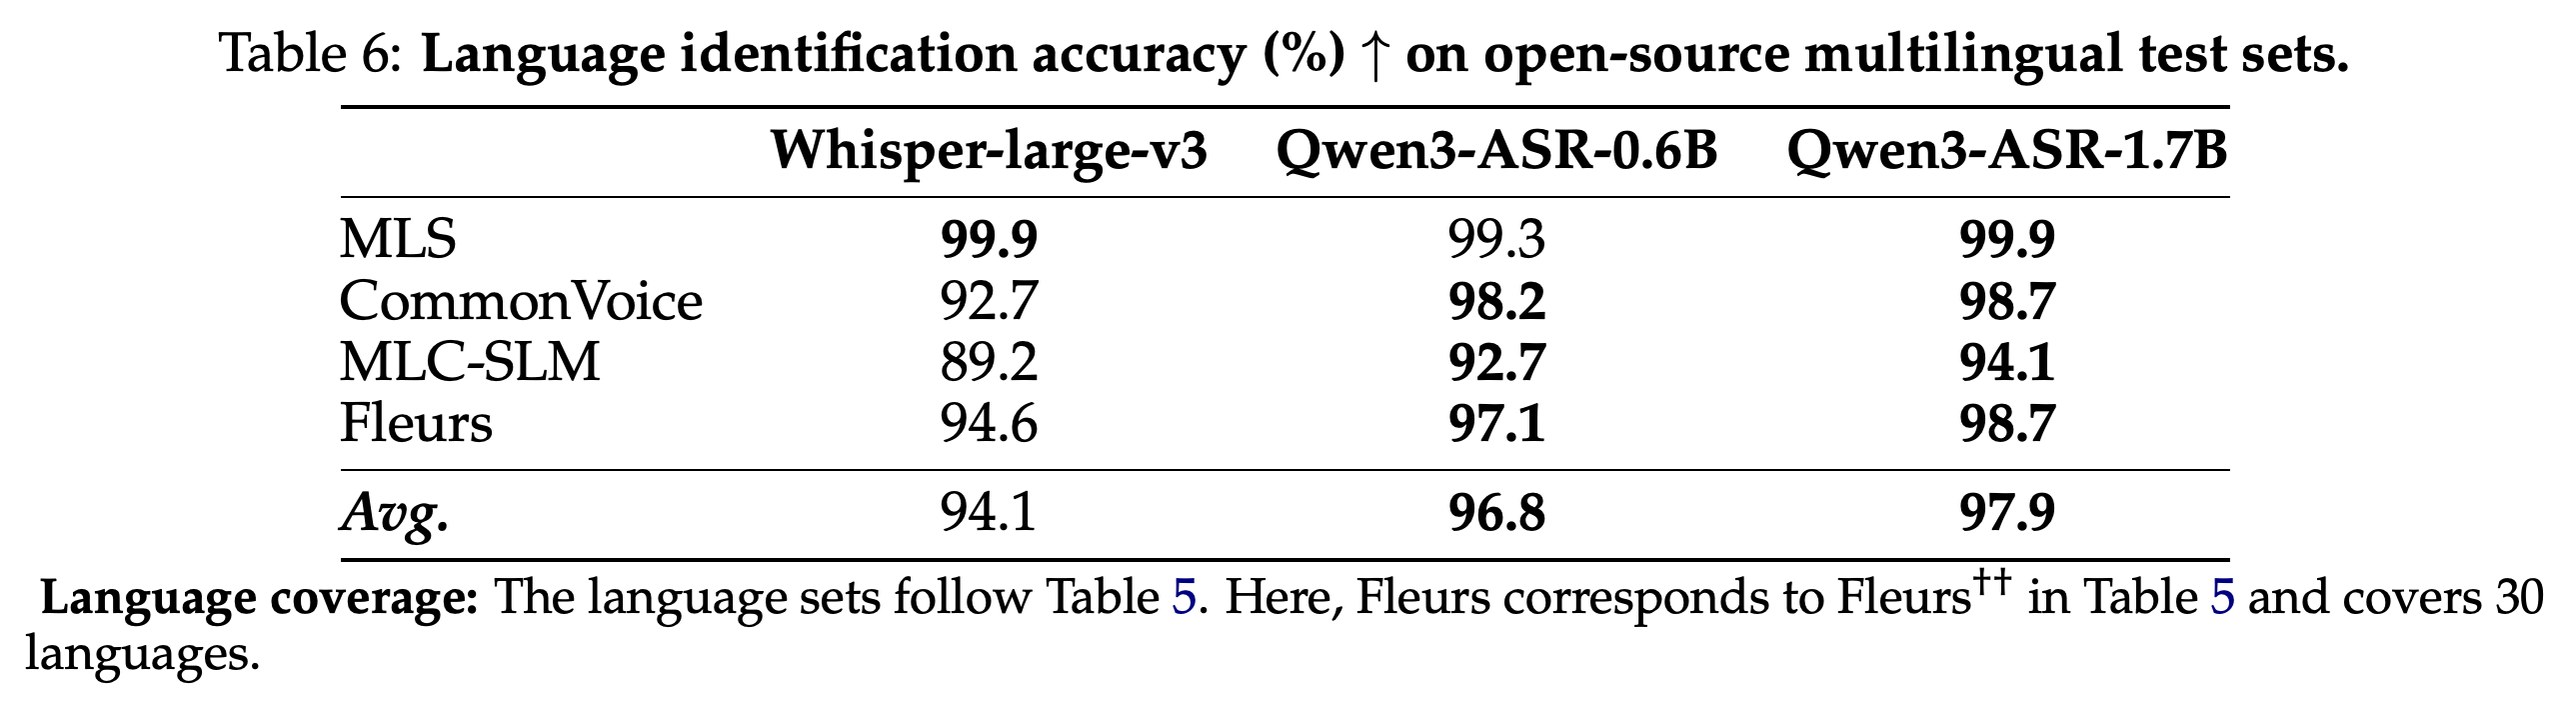
4.3.2 Language Identification Performance: 벤치마크 4개의 평균 언어 식별 정확도는 Qwen3-ASR-1.7B 97.9%, Qwen3-ASR-0.6B 96.8%, Whisper-large-v3 94.1%다. 1.7B 모델은 MLS에서 Whisper와 동률이며, CommonVoice, MLC-SLM, Fleurs에서는 더 높은 정확도를 보인다.
- Qwen3-ASR-1.7B는 MLS 99.9%, CommonVoice 98.7%, MLC-SLM 94.1%, 30개 언어의 Fleurs 98.7%를 달성한다.
- 저자들은 Fleurs의 남은 LID 오류를 주로 Malay와 Indonesian의 혼동으로 설명한다.
- 본문은 MLS가 9개 언어를 포함한다고 설명하지만, Table 5는 8개를 명시하며 Table 6은 Table 5의 언어 목록을 따른다고 밝힌다. 보고서에서는 이 평가 언어 수의 불일치를 해소하지 않는다.
30개 언어의 전사에서 나타나는 약점이 언어 식별에서도 같은 약점으로 이어지지는 않는다. Qwen3-ASR-1.7B는 전체 Fleurs에서 전사 오류가 더 높지만, 언어 식별 정확도는 98.7%로 Whisper의 94.6%보다 높다.
4.4 Singing Voice & Songs Recognition Performance
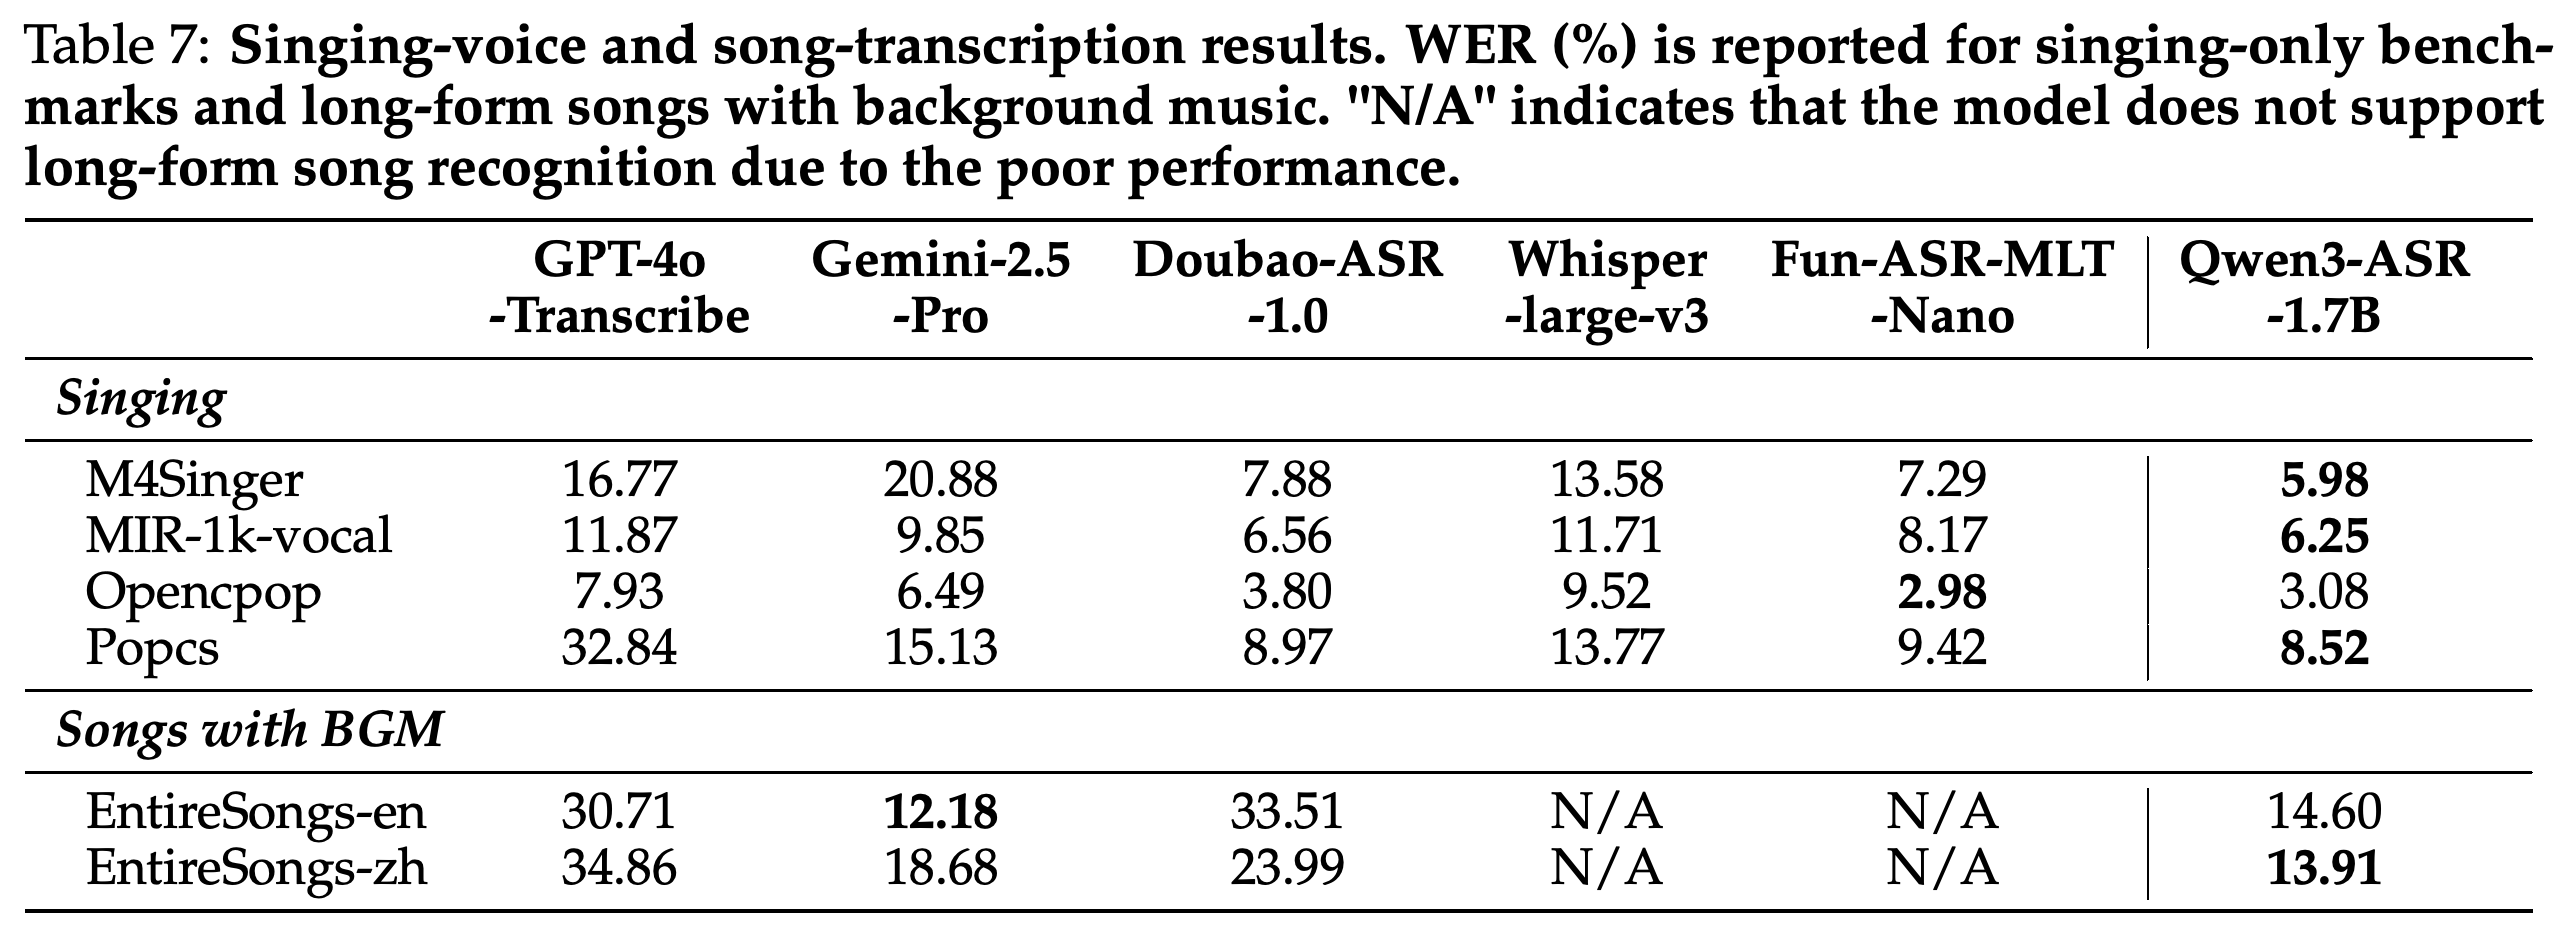
Table 7은 가창 음성만 있는 녹음과 배경 음악이 있는 전체 노래에서 Qwen3-ASR-1.7B를 평가한다. 이 모델은 M4Singer, MIR-1k-vocal, Popcs에서 앞서며, Opencpop에서는 FunASR-MLT-Nano가 근소하게 앞선다.
- 표에 보고된 WER (%)는 M4Singer 5.98, MIR-1k-vocal 6.25, Opencpop 3.08, Popcs 8.52다. FunASR-MLT-Nano는 Opencpop에서 2.98을 보인다.
- EntireSongs-zh에서는 Qwen3-ASR-1.7B가 13.91로 Gemini-2.5-Pro의 18.68보다 앞선다. EntireSongs-en에서는 Gemini가 12.18로 Qwen의 14.60보다 앞선다.
- Whisper-large-v3와 FunASR-MLT-Nano는 전체 노래 인식 성능이 낮아 N/A로 표시되며, 수치로 된 오류값은 부여되지 않는다. 이 표는 0.6B Qwen model을 평가하지 않는다.
가창 음성만 있는 녹음과 전체 노래를 구분하여 서로 다른 음악 조건에서 전사를 평가한다. Qwen3-ASR-1.7B는 가창 데이터셋 3개와 중국어 전체 노래에서 앞선다. FunASR는 Opencpop에서, Gemini는 영어 전체 노래에서 앞선다. 전체 노래 인식의 N/A 항목은 비교 모델의 수치 결과를 제공하지 않는다.
4.5 Streaming Speech Recognition
스트리밍 평가는 2초 청크와 5토큰 폴백을 사용하며, 마지막 4개 청크는 확정하지 않은 상태로 유지한다. Table 8은 오프라인과 스트리밍에서 공유하는 모델을 평가하지만, 스트리밍에서는 측정 가능한 정확도 손실이 발생한다.
- Qwen3-ASR-1.7B의 보고된 평균 오류는 오프라인 2.69에서 스트리밍 3.33으로 증가한다. LibriSpeech clean/other는 1.63/3.38에서 1.95/4.51로 변한다.
- Qwen3-ASR-0.6B의 평균 오류는 3.48에서 4.40으로 증가한다. LibriSpeech clean/other는 2.11/4.55에서 2.54/6.27로 변한다.
- 이 비교는 인식 오류를 보고하며, 종단 간 스트리밍 지연이나 전사문 수정 시점은 보고하지 않는다.
4.6 Precision of Timestamps
Table 9는 밀리초 단위 AAS로 Qwen3-ForcedAligner-0.6B를 Monotonic-Aligner, NFA, WhisperX와 비교한다. Qwen 모델은 언어 간 혼합 사례를 포함하여 원본 입력과 이어 붙인 입력 모두에서 낮은 오류를 유지한다. 반면 여러 비교 모델은 긴 입력에서 성능이 급격히 떨어진다.
- MFA 라벨 데이터에서 Qwen의 평균 AAS는 원본 입력 42.9ms, Concat-300s 52.9ms다. 같은 입력 유형에서 NFA의 평균은 129.8ms와 246.7ms이며, WhisperX의 평균은 133.2ms와 2708.4ms다.
- 사람이 주석을 단 데이터에서 Qwen은 Raw 27.8ms, Raw-Noisy 41.8ms, Concat-60s 25.3ms, Concat-300s 24.8ms, Concat-Cross-lingual 42.5ms를 보인다.
- 사람이 주석을 단 Concat-300s에서 Monotonic-Aligner와 NFA는 각각 410.8ms와 140.0ms를 보인다. 이 동일 조건 비교는 긴 입력에서 Qwen이 갖는 이점을 직접 뒷받침한다.
- 사람이 주석을 단 데이터에서 보고된 평균은 Qwen 32.4ms, Monotonic-Aligner 141.3ms, NFA 101.2ms다. 비교 모델의 누락 항목과 언어 또는 시나리오 범위 차이 때문에 종합 평균 열은 완전히 동일한 조건의 비교가 아니다.
5 Conclusion
보고서는 대규모 음성 사전학습, Qwen3-Omni 초기화, ASR 후속 학습을 통해 폭넓은 전사 능력을 갖춘 모델군을 만들었으며, 별도의 비자기회귀 모델로 다국어 정렬을 제공한다고 결론짓는다. 결과는 표준 중국어, 방언, 내부 강건성 평가, 타임스탬프에서 강한 성능을 뒷받침한다. 다만 모든 영어 및 다국어 벤치마크에서 일관되게 우세하지는 않다.
- 가중치, 추론 도구, 파인튜닝 지원은 https://huggingface.co/collections/Qwen/qwen3-asr, https://modelscope.cn/collections/Qwen/Qwen3-ASR, https://github.com/QwenLM/Qwen3-ASR 에서 공개한다.
- 명시된 단일 입력 한도는 ASR 1200s, 강제 정렬 300s다. 더 긴 녹음은 지원되는 단일 입력 범위를 넘어서는 처리가 필요하다.
6 Authors
보고서의 저자는 Qwen Team이며, 핵심 기여자와 알파벳순으로 정렬했다고 설명한 기여자 목록을 구분한다. Jin Xu와 Junyang Lin은 교신저자로 표시된다. PDF에는 기관 소속이 명시되지 않는다.
부록
- Table A.1은 공개된 ASR 모델 2개와 함께 Qwen3-ASR-Flash-1208 API 결과를 참고용으로 추가한다. Flash-1208은 LibriSpeech clean/other에서 1.33/2.40, WenetSpeech net/meeting에서 4.60/5.80을 보이지만 항상 더 좋은 것은 아니다. GigaSpeech에서는 Qwen3-ASR-1.7B가 8.45로 8.82보다 낮고, Tedlium에서는 Qwen3-ASR-0.6B가 3.85로 4.84보다 낮다.
- Table A.2는 MLS, CommonVoice, MLC-SLM, Fleurs의 언어별 결과를 제공하며, Flash-1208을 API 참고 모델로 포함한다. 1.7B 모델은 명시된 모든 언어 행에서 0.6B 모델보다 오류가 낮지만, 절대 오류가 상당히 높은 언어도 남아 있다. Fleurs에서 Hungarian은 34.22, Persian은 29.90, Greek은 28.08, Finnish는 25.23인 반면, Italian과 Chinese는 모두 2.41이다.
짧은 생각
강제 정렬 모델에서 타임스탬프 슬롯과 감독 위치를 일치시킨 목적함수는 이 보고서의 가장 독특한 방법론적 기여다. 언어별 사전 없이 인과적 언어 모델 백본으로 경계를 병렬 분류한다. 사람이 주석을 단 긴 입력의 결과, 특히 Concat-300s의 AAS 24.8ms는 MFA가 생성한 라벨과의 일치만으로 평가하는 것보다 이 설계를 더 강하게 뒷받침한다.
ASR 모델군은 폭넓은 작업을 지원하지만, 보고서는 개선 효과의 원인과 재현성에 관한 의문을 남긴다. RL, 문맥 바이어싱, 동적 어텐션 윈도우의 효과를 분리하는 제거 실험이 없고, 속도 벤치마크의 하드웨어를 밝히지 않으며, 내부 테스트 구성에 관한 설명도 제한적이다. 배포를 판단할 때는 30개 언어의 Fleurs에서 나타난 성능 격차를 고려하고, 처리량을 첫 토큰 지연 및 요청별 지연과 구분해야 한다.