


Reinforcement Learning with Metacognitive Feedback Elicits Faithful Uncertainty Expression in LLMs 요약 설명
30 Jun 2026 | Paper Review Faithful Calibration Reinforcement Learning Uncertainty Expression Metacognitive Feedback목차
이번 글에서는 Reinforcement Learning with Metacognitive Feedback Elicits Faithful Uncertainty Expression in LLMs 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 30일(Arxiv), Preprint
- Liu, Gabrielle Kaili-May, Caciularu, Avi, Yona, Gal, Szpektor, Idan, Cohan, Arman.
- Yale University, Google Research
- 논문 링크
- Github
요약
- 이 논문은 LLM이 표현한 불확실성과 샘플링한 응답의 일관성으로 추정한 내재적 확신도가 일치하는지를 뜻하는 faithful calibration(FC)을 다룬다. 이는 확신도와 정답 여부가 일치하는지를 보는 것과 다르다. 저자들은 메타인지 피드백을 활용한 강화학습(RLMF)과 메타인지 기반 데이터 선택으로 문장별 수치 확신도를 학습한 뒤, 출력을 편집해 불확실성을 언어로 표현한다.
- 영어 평가 데이터셋 10개에서 RLMF는 보고된 기준 방법보다 평균 FC가 높았으며, 수치 확신도 평가에서는 일반 RL 대비 최대 63% 개선됐다. 별도로 진행한 사람 평가에서는 RLMF가 재작성한 응답이 FUT보다 다양성, 자연스러움, 유용성, 맥락 적합성에서 선호됐다.
1 Introduction
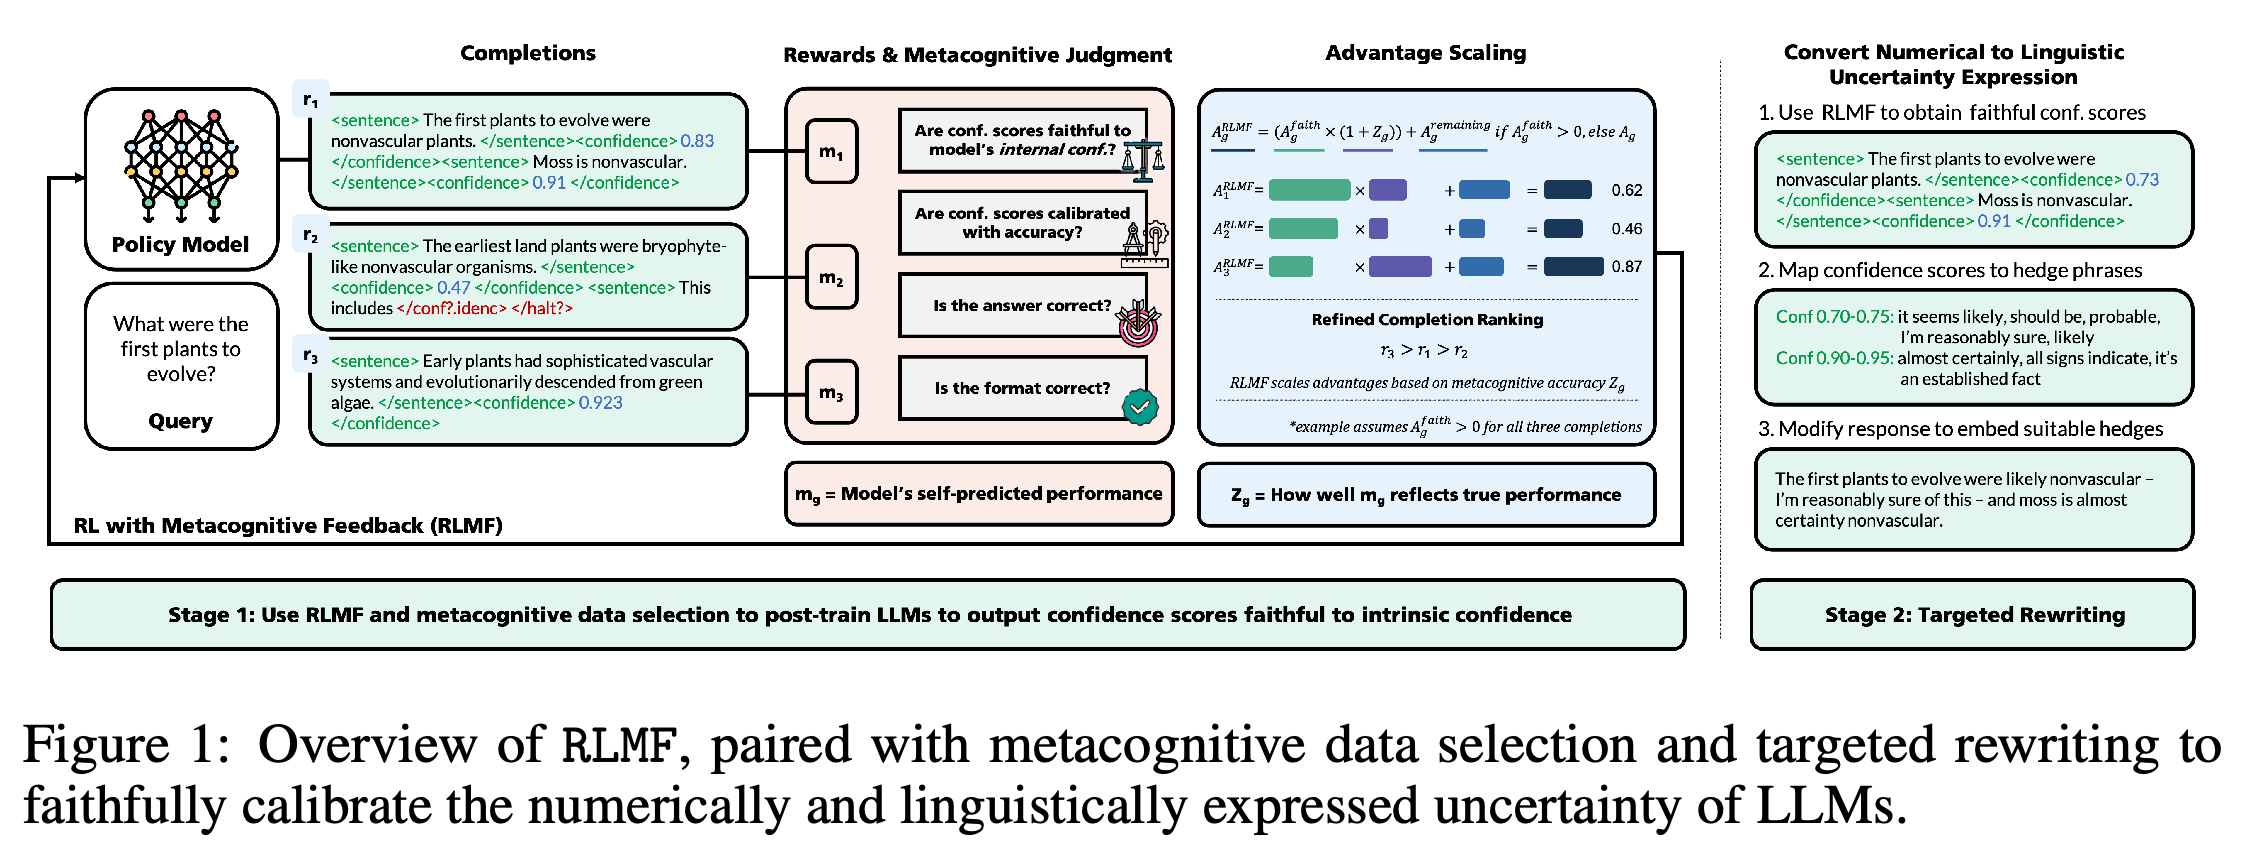
정답 여부를 기준으로 확신도를 보정하더라도, 모델이 전달하는 확신과 샘플링한 응답에서 드러나는 일관성 사이의 불일치는 드러나지 않을 수 있다. 저자들은 먼저 수치 확신도를 학습하고 이를 맥락에 맞는 유보 표현으로 바꾼다. 따라서 편집 단계에서 표현을 바꿀 때 RL 학습을 반복할 필요가 없다.
이 도식은 샘플링한 완성 응답, 보상, 자기 판단, advantage 스케일 조정을 이후의 확신도 점수 기반 유보 표현 변환과 분리해 보여준다. 편집은 수치 FC 학습 뒤에 수행되며, 그 학습에 쓰이는 보상을 제공하지 않는다.
2 Related Work
기존의 내부 피드백 기반 RL은 확신도와 엔트로피 등의 신호를 사용했다. 반면 RLMF는 모델이 자신의 FC 성과를 얼마나 정확히 판단하는지에 따라 학습 신호를 조정한다. 기존의 언어적 FC 연구에는 프롬프팅, 스티어링, 지도 미세조정이 쓰였지만, 논문은 이러한 방법들이 수치 FC와 자연스럽고 다양한 장문 유보 표현을 충분히 다루지 못했다고 주장한다.
3 Method
이 프레임워크는 확신도 학습과 언어적 편집을 분리한다. Stage 1에서는 학습 예제를 선택하고 문장과 확신도 점수로 이루어진 출력에 RLMF를 적용한다. Stage 2에서는 점수를 유보 표현으로 바꾸고, 편집 모델에 원래 답변의 사실 주장을 유지하도록 지시한다.
3.1 Reinforcement Learning Setup
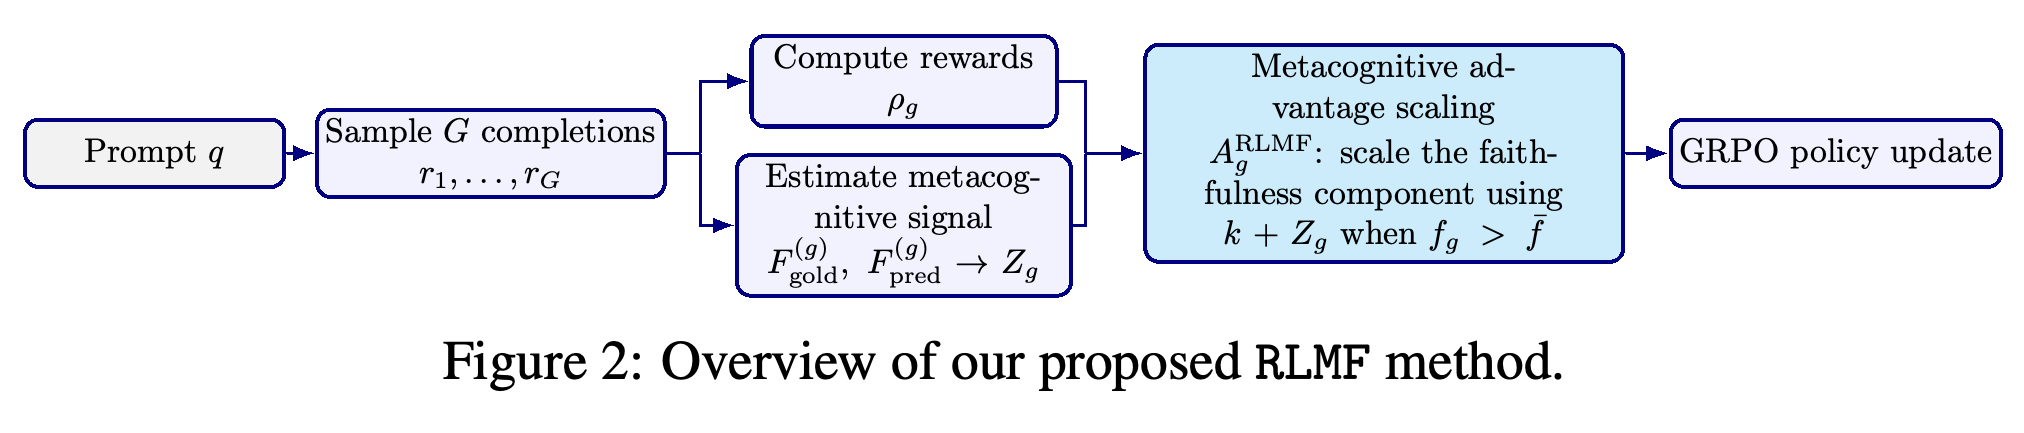
각 질의에 대해 GRPO는 문장별 확신도 점수를 포함한 완성 응답 G개를 샘플링한다. 가중 보상은 확신도 표현의 충실성, 정답 여부에 대한 확신도 보정, 정답 여부, 엄격한 형식 준수와 완화된 형식 준수를 반영한다. 보고된 구현에서는 그룹 평균 보상을 빼서 advantage를 계산하며, 표준편차로 나누지 않는다.
- 주요 보상 가중치는 충실성에 12, 정답 여부에 대한 확신도 보정과 정답 여부에 각각 1, 형식 관련 보상 2종에 각각 3이다.
도식에서 예측 FC 성과와 실제 FC 성과의 비교는 보상 계산과 GRPO 정책 업데이트 사이에 놓인다. 메타인지 평가 결과는 충실성이 평균보다 높은 완성 응답의 advantage 중 충실성 성분을 조정하며, 다른 보상을 대체하지 않는다.
3.2 Reinforcement Learning with Metacognitive Feedback (RLMF)
각 완성 응답에 대해 현재 정책은 FC 점수를 예측한다. 실제 FC 수준은 표현된 확신도와 샘플링으로 추정한 내재적 확신도의 차이가 τ = 0.10보다 작은 문장의 비율이다. RLMF는 Zg = 1 − (Fpred − Fgold)²로 정하고, 완성 응답의 가중 충실성 점수가 그룹 평균을 넘을 때만 해당 advantage의 충실성 성분에 k + Zg를 곱한다. 이때 k = 1이며 다른 보상 성분은 조정하지 않는다.
- 이 조건에 따라 자기평가의 정확도는 주된 목표인 충실성에서 평균 이상의 성과를 낸 완성 응답에 대해서만 학습 신호를 조정한다.
3.3 Metacognitive Data Selection
모델은 각 학습 후보 예제에 대해 유보 표현이 들어간 응답을 생성하고, 표현의 단정적인 정도가 내부 확신도와 얼마나 일치하는지를 0–100으로 평가한다. 이 방법은 낮은 평가를 받은 예제만 고르지 않고, 자기평가 점수 분포의 양끝에서 목표 학습 예제 수의 절반씩을 선택한다.
3.4 Rewriting Protocol
편집 모델에는 원래 답변, 각 문장의 수치 확신도에 대응하는 유보 표현 후보, 목표 문체나 사용자 맥락이 주어진다. 점수와 유보 표현의 대응표는 사람이 평가한 평균 확신도를 기준으로 표현을 폭 0.05의 구간에 묶는다. 주요 단일 패스 절차에서는 해당 구간에서 유보 표현 20개를 샘플링하고, 사실 주장을 바꾸지 않으면서 자연스럽게 편집하도록 요청한다.
4 Experimental Setup
실험에는 Llama3.1-Instruct(8B)와 Qwen3(1.7B, 4B, 8B)를 사용하고, 영어 데이터셋 10개에서 각각 테스트 예제 1,000개를 평가한다. 출력 형식을 위한 pre-SFT 이후, 주요 RLMF 설정은 메타인지 방식으로 선택한 PopQA 예제 2,000개로 학습한다. 대체 학습 데이터셋은 SelfAware, HaluEval, UMWP이며, 비교 대상에는 MetaFaith, FUT, 일반 RL, 프롬프트를 적용한 독점 모델이 포함된다.
FC는 관측된 확신도 범위에서 동일한 표본 수로 나눈 내재적 확신도 구간에 구간 폭에 따른 가중치를 적용하는 cMFG*로 측정한다. 문장별 내재적 확신도는 추가로 샘플링한 응답 20개에 대한 NLI 일관성 판단으로 추정한다. 정답 여부는 LLM이 판단하며, Brier Score(BS)는 내재적 확신도와 정답 여부의 일치 정도를 측정한다.
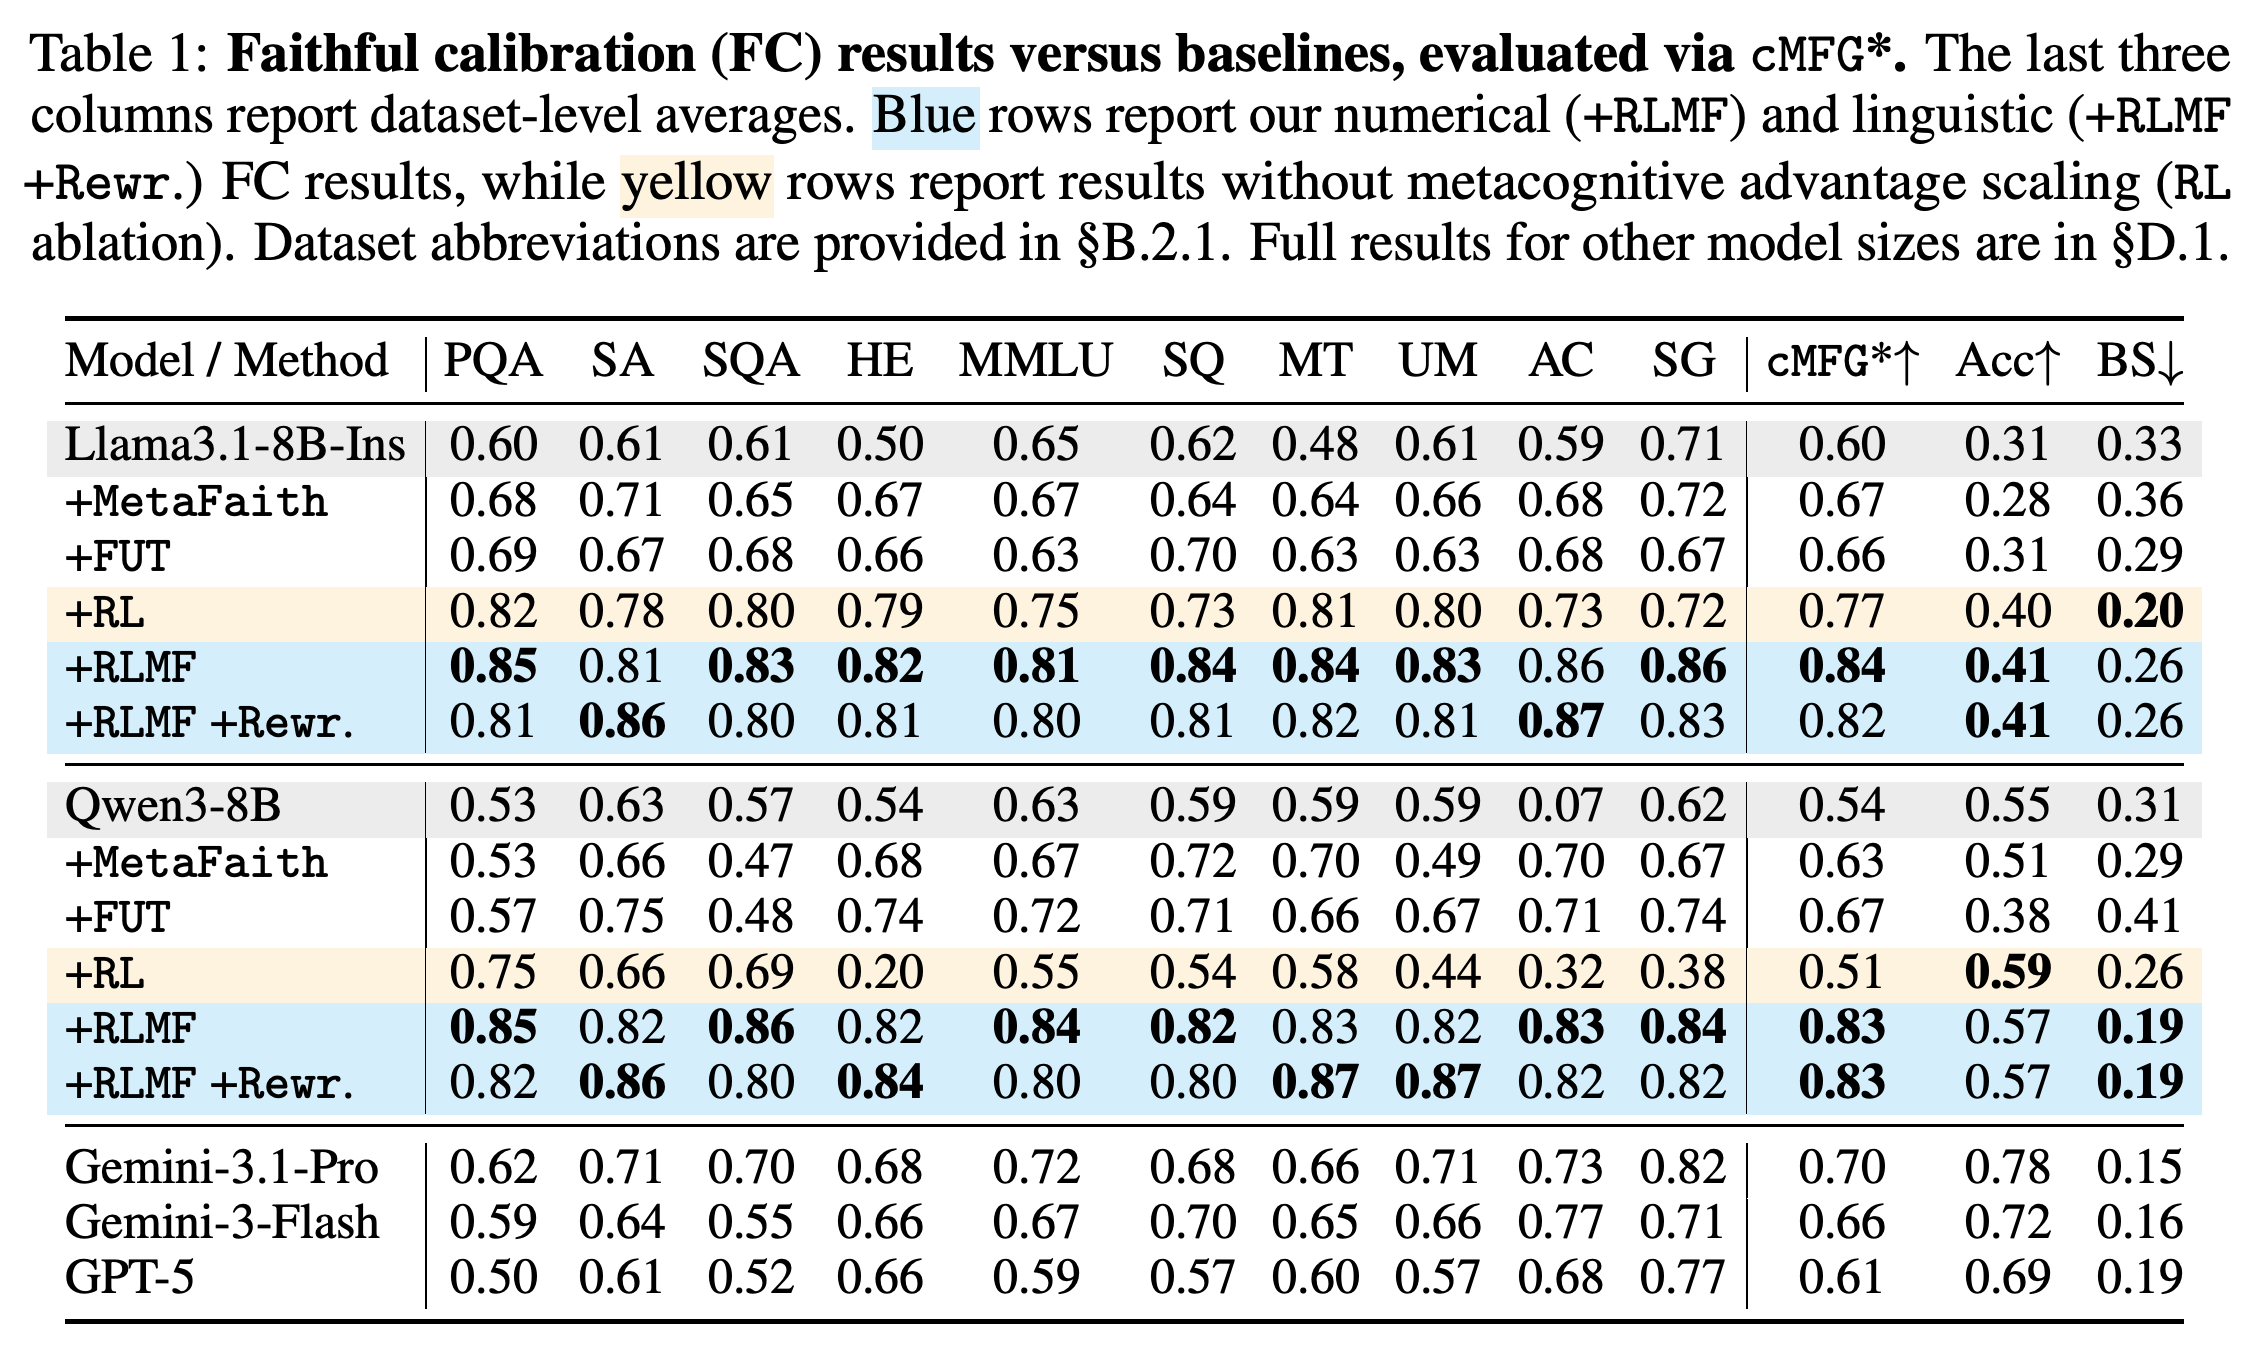
8B 공개 모델 2개의 RLMF 결과는 각각 해당 일반 RL 결과보다 평균 cMFG*가 높다. 수치 결과와 재작성 후 언어적 결과가 별도로 제시돼 편집의 영향을 살펴볼 수 있으며, 정확도와 BS는 FC 이외의 결과를 보여준다. 기존 방법과의 비교는 언어적 FC에 관한 것이다.
5 Results
Table 1에서 Llama3.1-8B-Instruct의 평균 수치 cMFG*는 RLMF 적용 시 0.84로, 일반 RL의 0.77보다 높다. 재작성 후 언어적 cMFG*는 0.82이며 MetaFaith는 0.67, FUT는 0.66이다. Qwen3-8B는 RLMF 적용 시 0.83이고 재작성 후에도 0.83인 반면 일반 RL에서는 0.51이다. 정확도는 RLMF 적용 시 0.57로, 원래 모델의 0.55보다 높다.
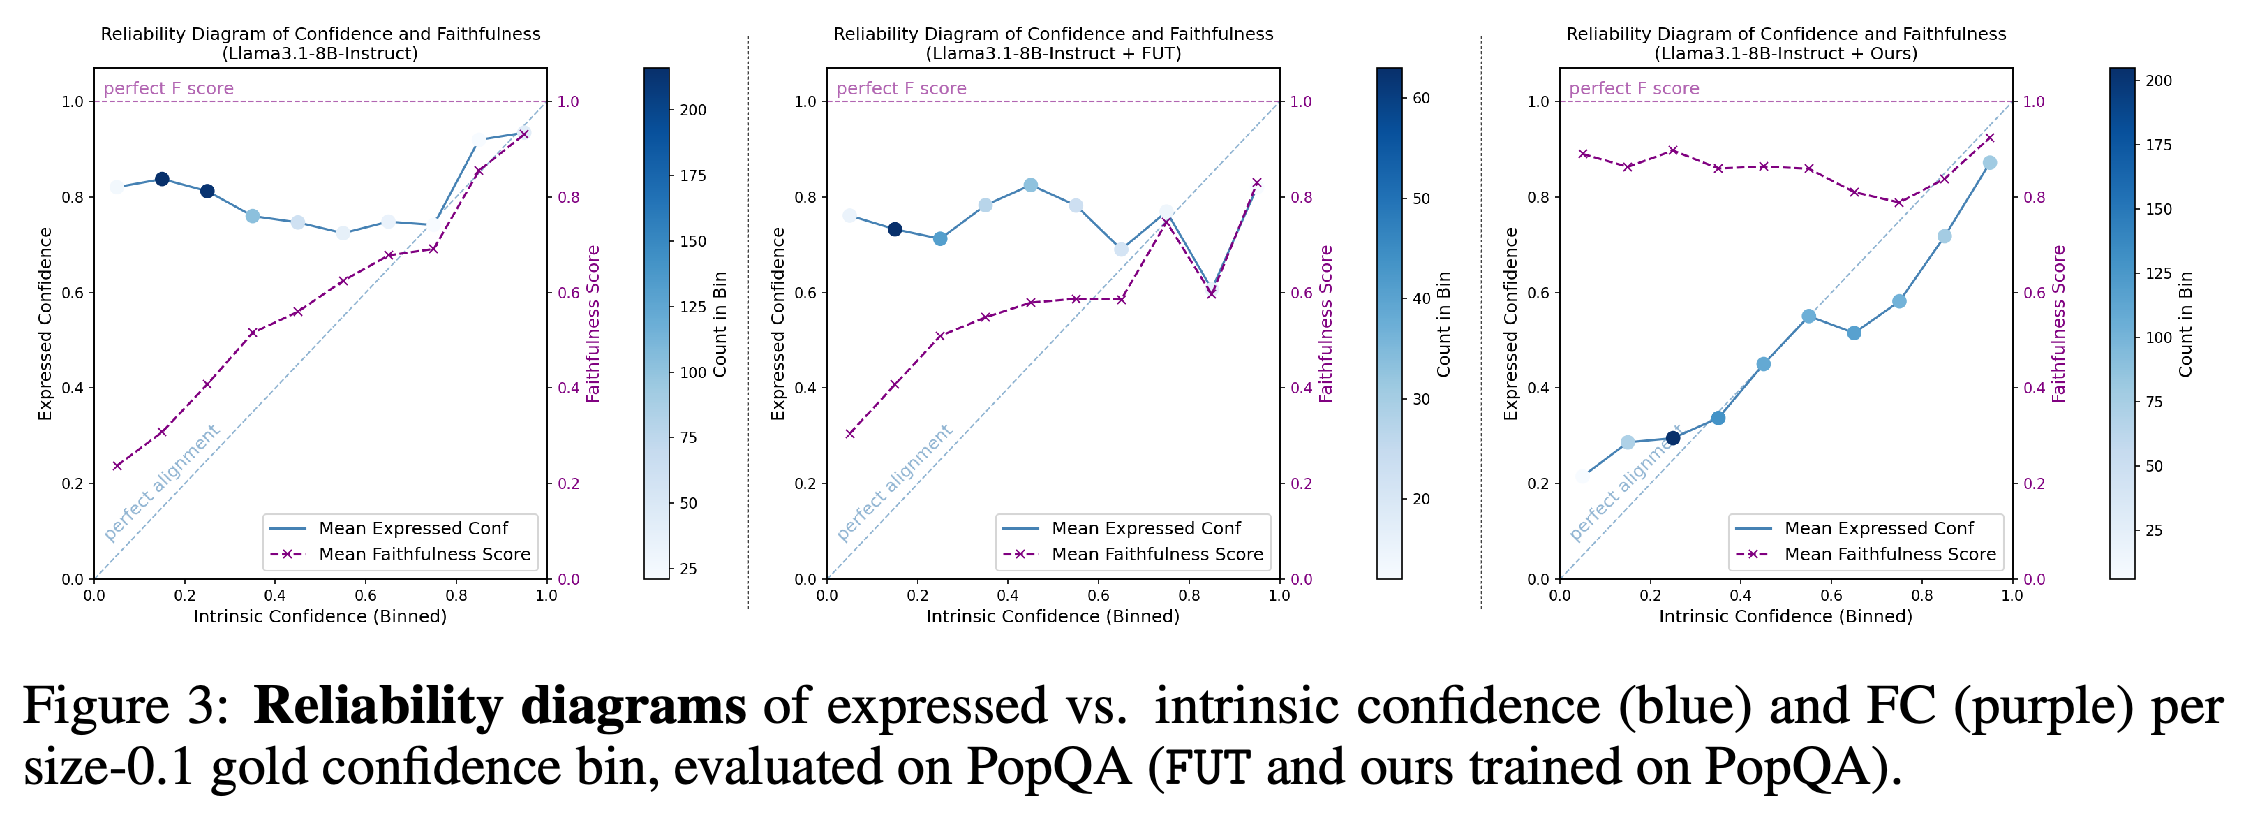
PopQA에서 원래 Llama3.1-8B-Instruct 모델과 FUT는 내재적 확신도가 낮은 구간에서도 비교적 높은 확신을 표현한다. RLMF로 학습한 모델은 표시된 구간 전반에서 표현된 확신도 곡선이 내재적 확신도에 더 가깝고 충실성 점수도 높다.
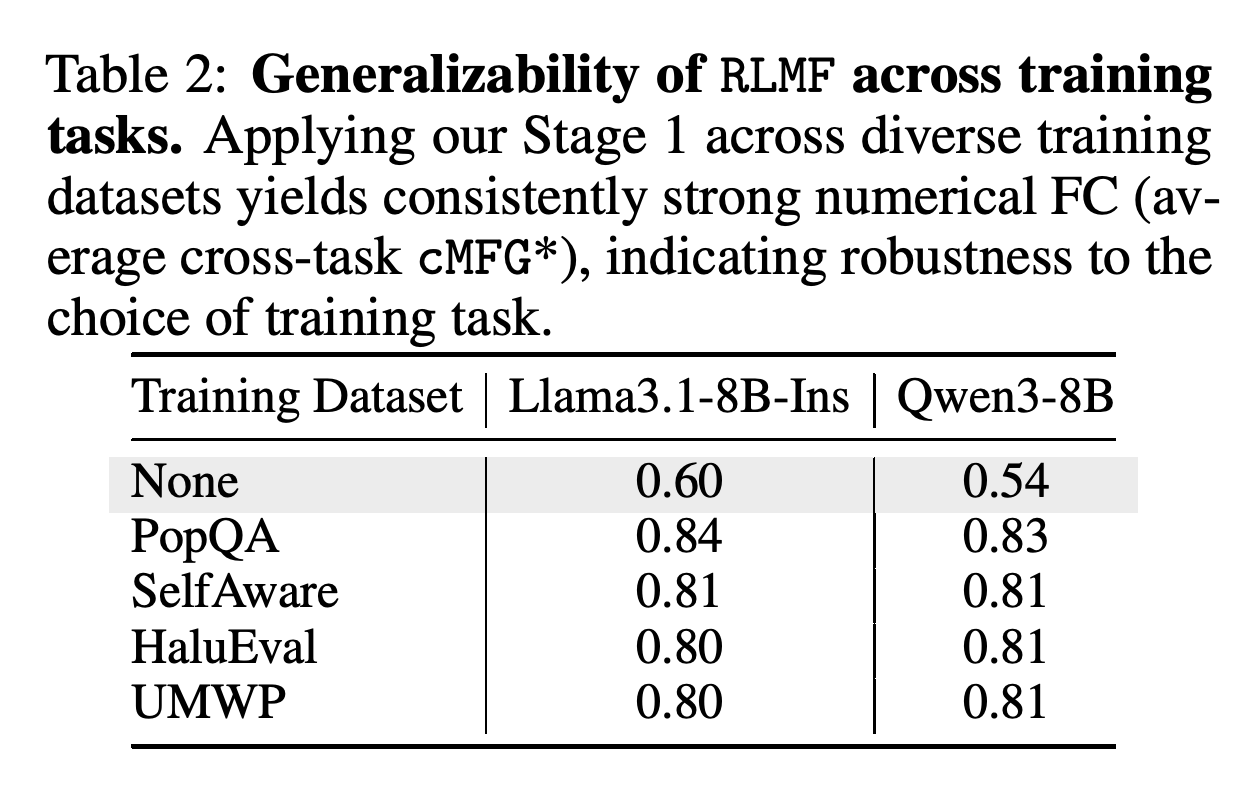
표에 제시된 RLMF 학습 데이터셋은 각각 원래 모델보다 평균 교차 과제 수치 cMFG*를 높인다. PopQA로 학습했을 때 점수가 제시된 데이터셋 중 가장 높으며, SelfAware, HaluEval, UMWP로 학습한 결과는 학습 데이터 출처가 달라도 성능이 유지되는지 보여준다.
시험한 선택 전략 3개 중 메타인지 기반 선택은 8B 모델 2개 모두에서 cMFG*가 가장 높다. 정확도와 BS가 항상 같은 순서를 보이지는 않는다. Llama3.1-8B-Instruct에서는 무작위 선택의 BS가 메타인지 기반 선택보다 낮다.
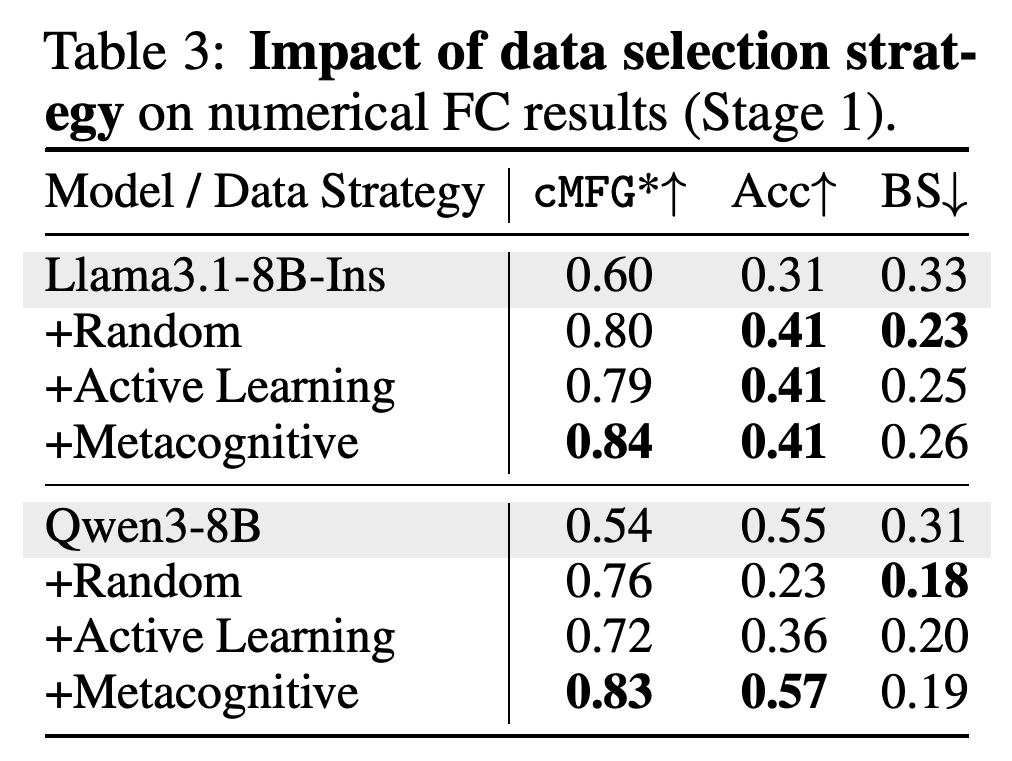
PopQA 대신 SelfAware, HaluEval 또는 UMWP로 학습했을 때 교차 과제 수치 cMFG*는 Llama3.1-8B-Instruct에서 0.80–0.81, Qwen3-8B에서 0.81이다. 메타인지 기반 선택은 두 모델 모두에서 시험한 선택 전략 중 cMFG*가 가장 높다. 다만 Llama3.1-8B-Instruct의 BS는 무작위 선택이 0.23으로, 메타인지 기반 선택의 0.26보다 낮다.
재작성한 RLMF 응답 묶음과 FUT 응답을 비교한 예제 120개의 연구에서 대학원생 평가자 3명은 제안 방법에 다양성 98%, 자연스러움 98%, 유용성 95%, 맥락 적합성 96%의 승률을 부여했다. 동률에는 절반의 가중치를 적용했다. 보고된 Krippendorff’s alpha는 0.93이며, 이 선호도 평가는 사실 여부를 독립적으로 검증하지 않는다.
6 Conclusion
실험은 측정한 과제에서 FC와 자기평가가 개선됐음을 보여주지만, 광범위한 메타인지 능력을 입증하지는 않는다. Ethics Statement는 충실한 불확실성 표현과 자기평가가 사실 주장에 대한 검증을 대체하지 못한다고 지적한다. 특히 결과가 중요한 용도에서는 안전장치와 감독이 필요하다고 강조한다.
부록
- Appendix A는 논문의 목표를 정답 여부에 대한 확신도 보정과 구분하고 수치적·언어적 불확실성 표현 방법을 살펴본다. Appendix B는 LoRA 기반 pre-SFT와 GRPO 설정, 데이터셋 10개와 약어, 프롬프트, 판단 절차를 상세히 설명한다. 응답 수준의 충실성은 문장별로 표현된 확신도와 내재적 확신도의 절댓값 차이를 평균해 구한다. cMFG*는 관측된 범위에서 표본 수가 같은 구간에 폭에 따른 가중치를 적용해, 비어 있을 수 있는 동일 폭 구간을 대체한다.
- Appendix C는 GRPO 목표와 보상 설계를 명시하고 보상 공식과 가중치, 시스템 프롬프트, advantage 정규화, 학습 데이터 크기, pre-SFT를 시험한다. RLMF 절제 실험에서는 자기평가 신호의 제곱식과 선형식을 비교하며, Llama3.1-8B-Instruct의 cMFG*는 각각 0.84와 0.77이다. 그룹 정규화 신호, advantage 전체 또는 그룹 전체의 스케일 조정, 메타인지를 추가 보상으로 사용하는 방식도 비교하고, k와 τ를 별도로 시험한다. 데이터 선택 분석에서는 높은 평가와 낮은 평가를 받은 예제를 샘플링 응답 기반 방법 및 능동학습 변형과 비교한다.
- Appendix C는 사람이 평가한 점수와 유보 표현의 대응표를 설명하고, 유보 표현 후보 수, 단일 패스와 2단계 편집, 재작성 모델을 비교한다. Appendix D는 소형 모델의 결과, 구간별 충실성, 학습 경과 분석, 생성 예시를 추가한다. Appendix E는 Natural Questions, SciQ, SelfAware에서 가져온 사람 평가용 비교 사례 120개를 설명하며, 방법별 응답 3개, 지정된 사용 맥락, 평가자 3명에 관한 절차를 제시한다.
짧은 생각
확신도 학습과 편집을 분리하면 정책을 재학습하지 않고도 같은 수치 점수를 서로 다른 언어적 표현으로 나타낼 수 있다. 다만 근거는 논문에서 정의한 측정 방식에 한정된다. 내재적 확신도는 샘플링 응답의 일관성을 뜻하고, 자기평가는 FC에 관한 것이며, 언어적 품질은 별도 편집 모델에도 일부 좌우된다.