


VibeVoice Technical Report 요약 설명
26 Aug 2025 | Paper Review Speech Generation Text-to-Speech Next-Token Diffusion목차
이번 글에서는 VibeVoice Technical Report 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 8월 26일(Arxiv)
- Peng, Zhiliang, Yu, Jianwei, Wang, Wenhui, Chang, Yaoyao, Sun, Yutao, Dong, Li, Zhu, Yi, Xu, Weijiang, Bao, Hangbo, Wang, Zehua, et al.
- Microsoft Research
- 논문 링크
- Github
- Project Page
요약
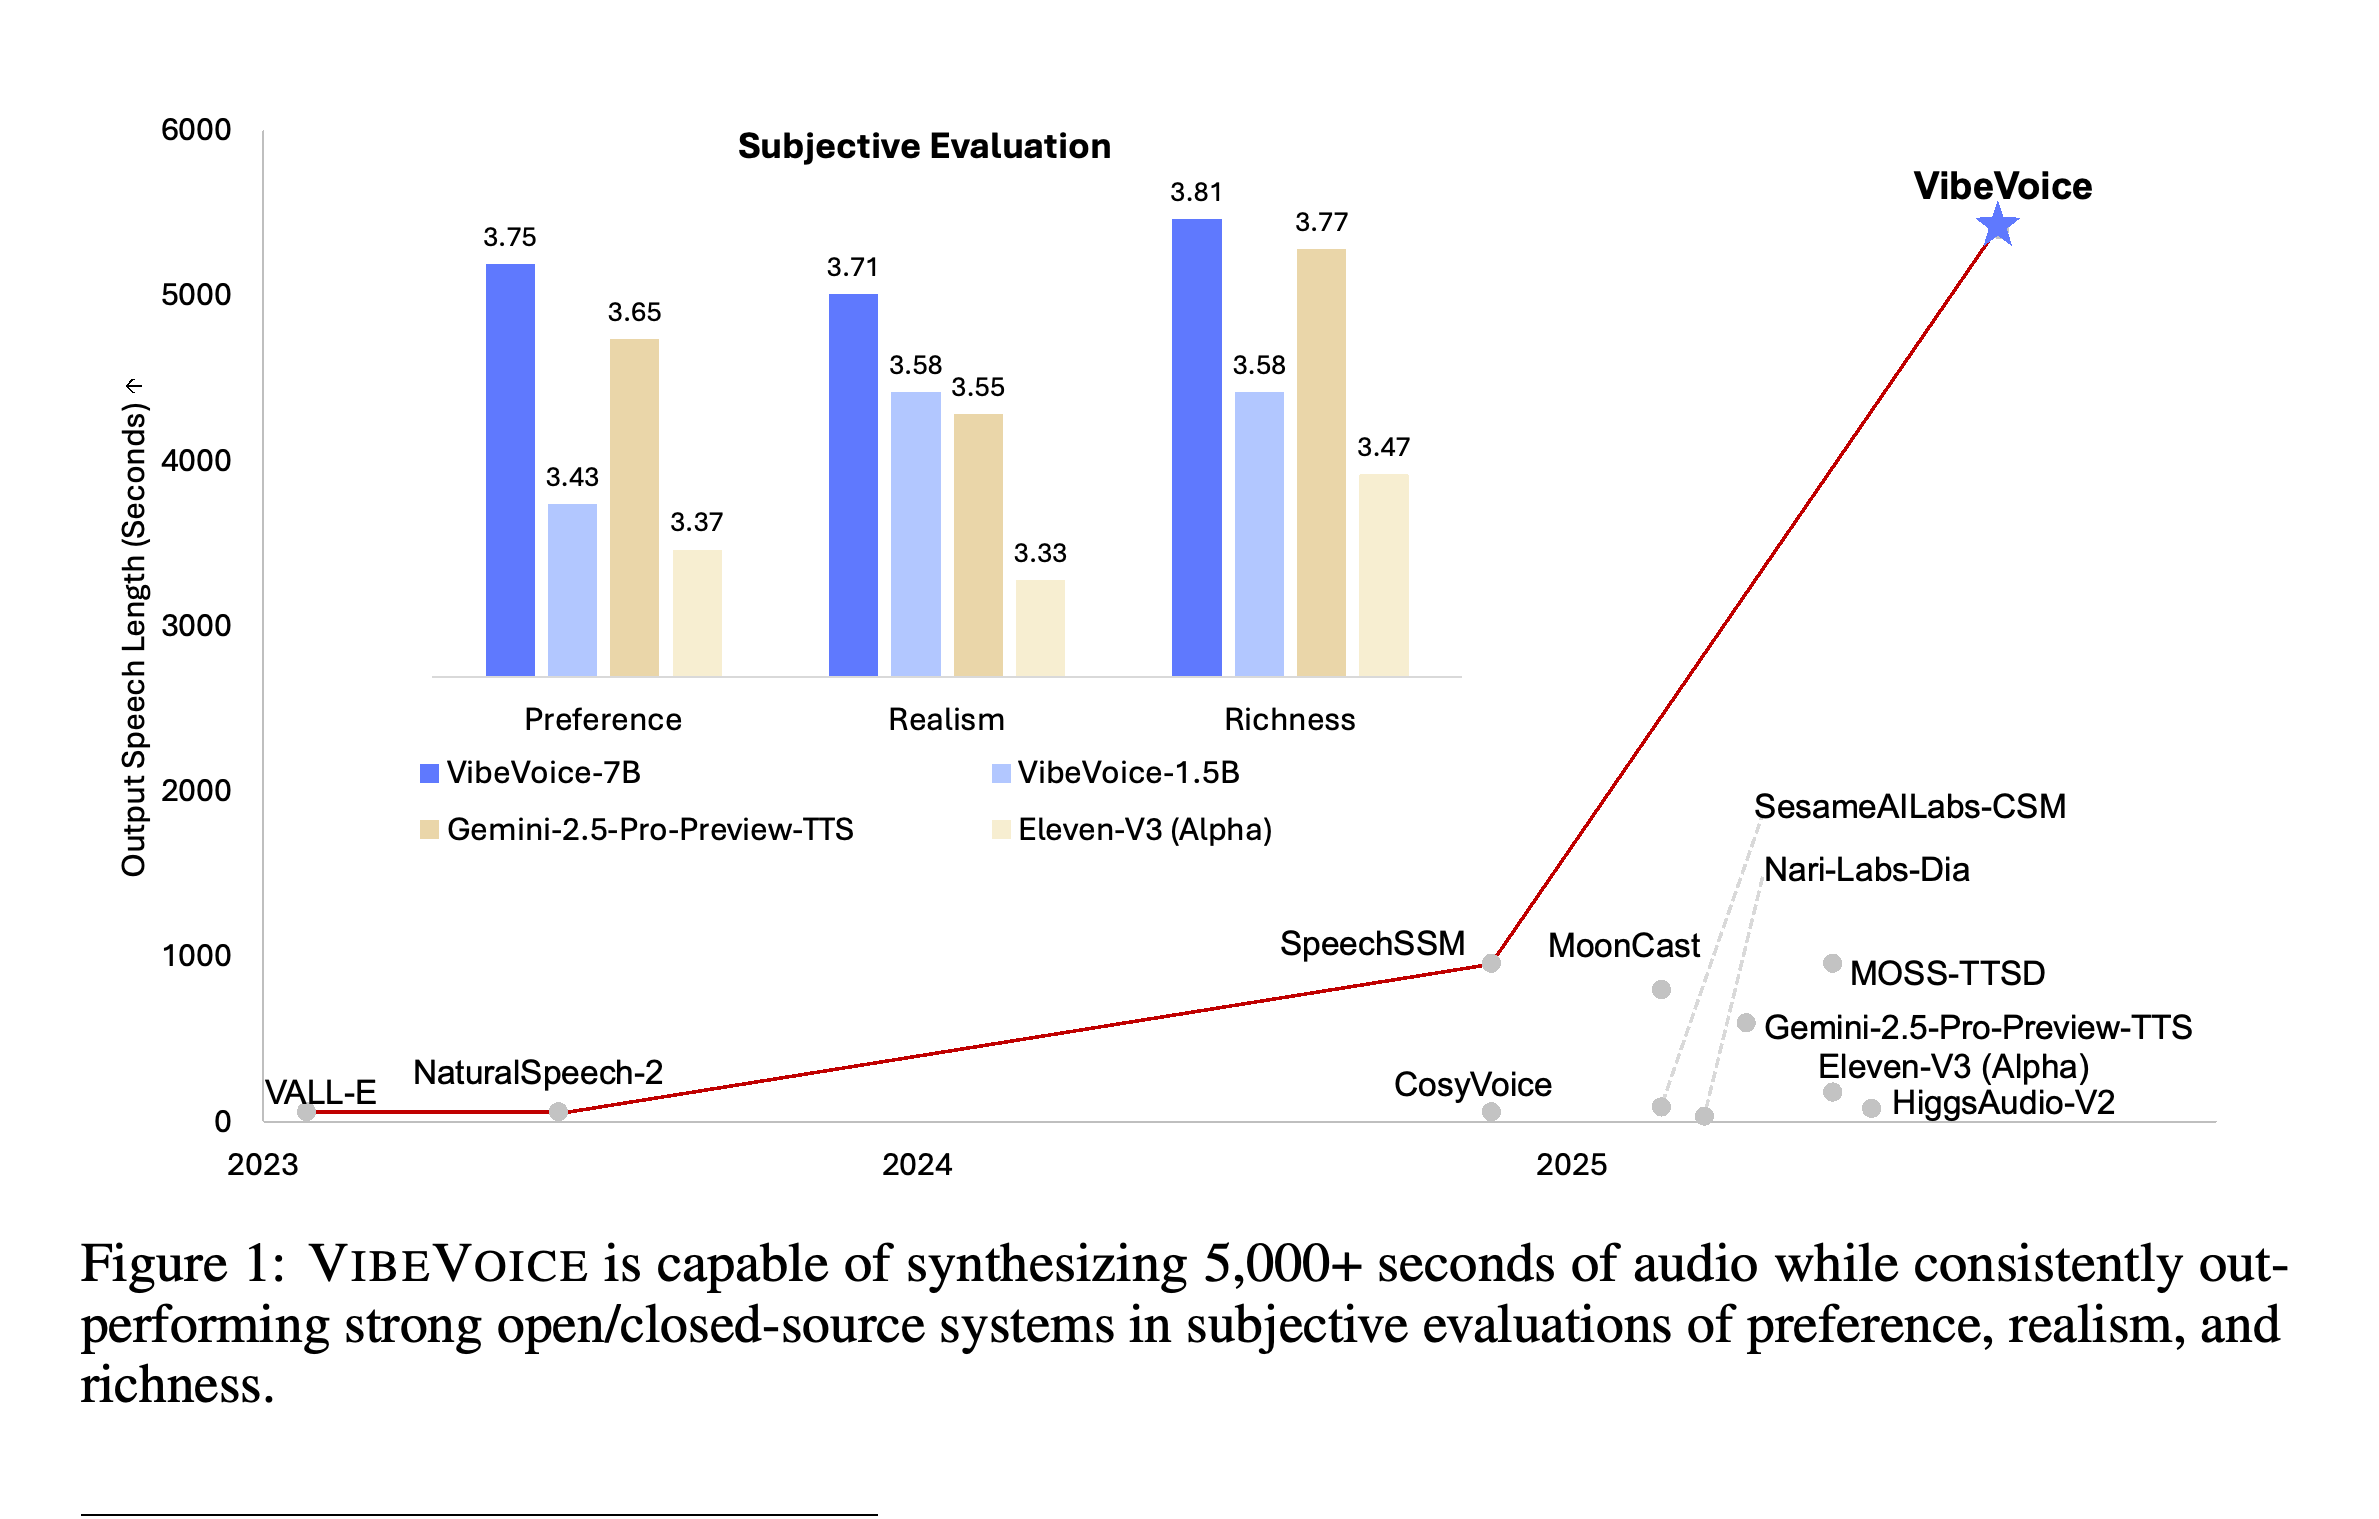
- VibeVoice는 화자의 일관된 목소리, 자연스러운 발화 전환, 표현력 있는 말하기가 필요한 긴 대화를 위한 text-to-speech(TTS)를 다룬다. TTS는 작성된 대본을 음성으로 합성하는 기술이다. 총 약 1시간 분량의 대화 대본 8개에서 VIBEVOICE-7B는 평가 대상 시스템 중 가장 높은 평균 청취자 평가 점수인 3.76을 기록했다. Gemini 2.5 Pro Preview TTS는 3.66을 기록했다. Gemini는 다른 시스템에 사용한 음성 프롬프트 제어를 지원하지 않아 기본 목소리를 사용했다.
- 이 방법은 오디오를 간결한 특징 벡터로 인코딩하는 연속형 음성 토크나이저와, 반복적으로 노이즈를 제거하여 벡터를 차례로 생성하는 next-token diffusion을 결합한다. 음향 토크나이저는 24 kHz 오디오에서 초당 7.5프레임을 생성한다. 보고서는 64K-token 컨텍스트 윈도에서 최대 4명의 화자가 참여하는 최대 90분 길이의 음성을 생성할 수 있다고 설명한다.
- VIBEVOICE-7B는 보고된 팟캐스트 청취자 평가에서 가장 높은 점수를 기록한다. 음향 토크나이저는 비교 대상보다 낮은 토큰 생성률로 재구성 품질 지표 2개에서 가장 높은 점수를 기록한다. 짧은 발화 평가에서는 지표에 따라 결과가 엇갈린다. 보고서는 구성 요소를 제거하거나 변경하여 기여도를 확인하는 통제된 ablation 실험이나 실행 시간 측정 비교를 제공하지 않는다.
이 그래프는 VIBEVOICE의 생성 길이를 5,000초 초과로 표시하고 이러한 생성 능력 주장과 일부 청취자 평가 점수를 함께 제시한다. 삽입 그래프에서는 7B 모델의 점수가 더 높지만 일부 값이 Table 1과 조금 다르므로 상세 평가에는 Table 1을 사용한다. 생성 길이 비교와 청취자 평가는 서로 별개의 근거다. 이 그림은 통제된 90분 테스트 전체에 걸친 품질을 입증하지 않는다.
1 Introduction
최근 TTS 시스템은 단일 화자의 짧은 발화를 자연스럽게 생성한다. 긴 대화에서는 일관된 목소리, 자연스러운 발화 전환, 내용에 맞는 말하기도 필요하다. 독립적으로 합성한 발화를 이어 붙이는 방식은 이러한 요구를 직접 해결하지 못한다. 서론은 기존 시스템의 한계로 생성 길이, 안정성, 소스 코드 미공개를 제시한다.
VIBEVOICE는 미래 샘플을 사용하지 않고 오디오를 처리하는 인과적 토크나이저로 음성 시퀀스를 줄인다. 파형을 3200배 다운샘플링하여 프레임률을 7.5 Hz로 낮춘다. 저자들은 음성 토큰과 텍스트 토큰의 비율이 약 2:1이라고 보고한다. 이는 음성 토큰 2개가 대략 BPE 텍스트 토큰 1개에 대응한다는 뜻이다. BPE 텍스트 토큰은 byte-pair encoding으로 만든 서브워드 단위다.
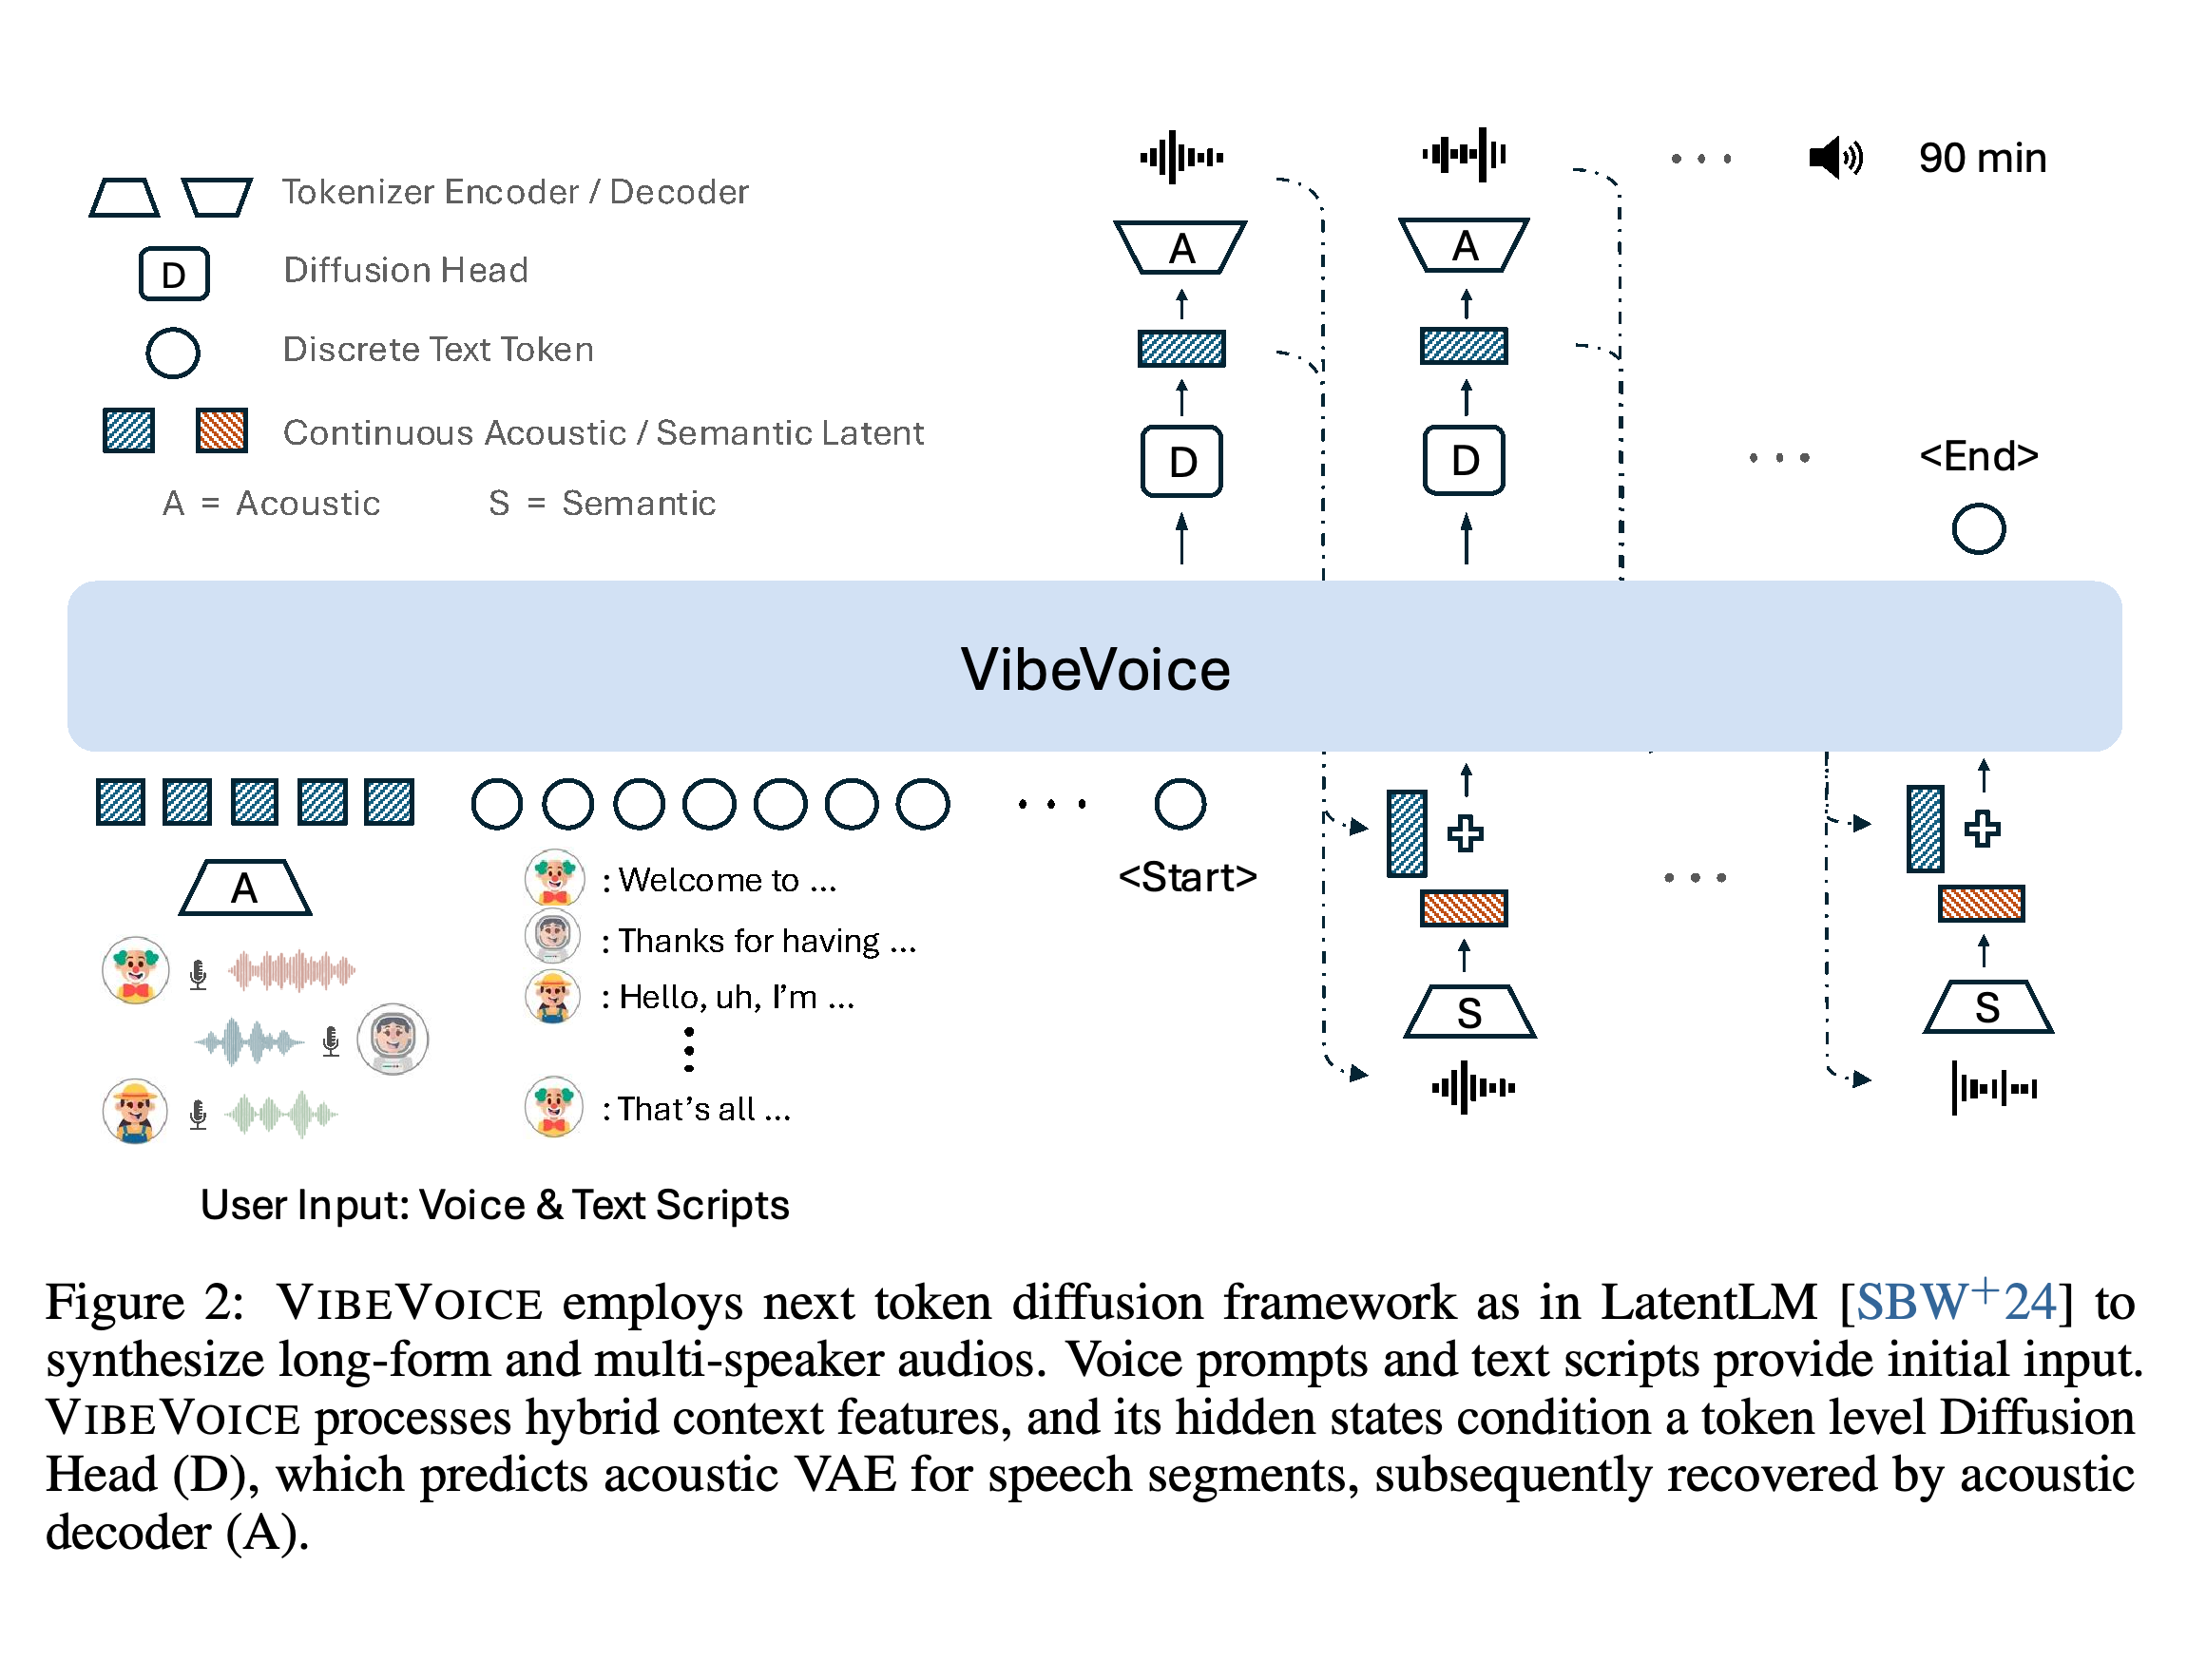
음성 프롬프트와 화자 표시가 있는 텍스트로 시퀀스 모델을 초기화한다. 모델의 은닉 상태는 diffusion head가 음향 특징을 생성할 때 조건으로 사용된다. 음향 디코더는 특징을 음성으로 변환한다. 생성된 음성의 음향 및 의미 인코딩 결과는 이후 예측을 위해 다시 컨텍스트에 포함된다.
2 Method
이 방법은 오디오 특성을 담는 음향 표현과 대본 관련 내용을 담는 의미 표현을 분리한다. 사전 학습된 대규모 언어 모델(Large Language Model, LLM)을 핵심 시퀀스 예측기로 사용하여 음성 프롬프트와 화자 표시가 있는 대본을 처리한다. 이후 LLM의 출력으로 diffusion head에 조건을 제공한다. diffusion head는 노이즈 제거를 통해 음향 특징을 생성하는 모듈이며 이 특징을 디코딩하여 오디오를 만든다.
2.1 Speech Tokenizers
음향 토크나이저는 σ-VAE를 사용한다. 이는 오디오를 잠재 분포로 인코딩하되, 노이즈의 변동성을 학습하지 않고 미리 정하는 변분 오토인코더(Variational Autoencoder) 변형이다. 이 설계는 앞서 제안된 next-token diffusion 모델인 LatentLM을 따른다. 각 예측이 앞선 문맥에 의존하는 자기회귀 모델링 과정에서 잠재 표현의 변동성이 사라지는 variance collapse를 완화하는 것이 목적이다. 인코더는 평균 μ를 예측한다. 보고서는 샘플링을 z = μ + σ ⊙ ϵ로 명시하며 ⊙는 원소별 곱셈을 뜻한다. 여기서 \(\epsilon \sim \mathcal{N}(0,1)\)이고 \(\sigma \sim \mathcal{N}(0,C_{\sigma})\)이며, N은 가우시안 분포를 뜻한다.
음향 인코더와 디코더는 서로 거울 대칭인 구조를 갖는다. 시퀀스를 처리하는 수정된 Transformer 블록을 7단계로 구성한다. 시퀀스 내부 위치 간 관계를 계산하는 self-attention 대신, 현재와 과거 입력으로 채널별 필터링을 수행하는 1차원 depth-wise causal convolution을 사용한다. 다운샘플링 계층 6개가 24 kHz 오디오를 초당 7.5프레임으로 줄인다. 인코더와 디코더는 각각 약 340M개의 파라미터를 갖는다. 학습은 신경망 기반 오디오 압축 방법인 DAC를 따르며, 재구성 오디오와 실제 오디오를 구분하는 판별기(discriminator)와 손실 설계도 포함한다.
의미 토크나이저는 음향 인코더와 같은 구조를 사용하되 VAE 구성 요소를 제외하고 결정론적 내용 특징을 추출한다. 음성에서 대본을 예측하는 자동 음성 인식(Automatic Speech Recognition, ASR)으로 사전 학습하며 이때 사용한 Transformer 디코더 계층은 사전 학습 후 제거한다. 저자들은 토크나이저를 분리하면 긴 음성 생성에 도움이 된다고 설명하지만 이 설계의 효과를 수치로 검증하는 ablation 결과는 제공하지 않는다.
2.2 VibeVoice
Input Representation은 화자 표시가 있는 음향 음성 특징과 텍스트 대본을 이어 붙인다. 표현식은 X = [Speaker₁: z₁, Speaker₂: z₂, …, Speakerₙ: zₙ] + [Speaker₁: T₁, Speaker₂: T₂, …, Speakerₙ: Tₙ]이다. 여기서 z는 오디오를 간결한 특징으로 인코딩한 음향 잠재 표현이고, T는 화자의 대본이다. 생성한 음성 구간은 양쪽 토크나이저로 인코딩하여 이후 예측에 사용하는 혼합 표현을 구성한다.
Token-Level Diffusion은 각 토큰에서 LLM의 내부 문맥 표현인 은닉 상태를 diffusion head의 조건으로 사용한다. 학습에서는 깨끗한 음향 특징에 추가한 노이즈를 예측하고 추론에서는 샘플링한 가우시안 벡터의 노이즈를 제거한다. 조건부 예측과 무조건부 예측을 결합하는 Classifier-Free Guidance(CFG)로 이 과정을 제어한다. 조건을 적용한 diffusion 샘플링용 솔버인 DPM-Solver++ 같은 샘플러는 반복 생성 과정을 가속한다.
핵심 모델은 사전 학습 언어 모델 계열인 Qwen2.5의 1.5B 및 7B 파라미터 버전과 4개 계층으로 구성된 diffusion head를 사용한다. 사전 학습된 양쪽 토크나이저의 파라미터는 갱신하지 않고 고정하며 LLM과 diffusion head를 학습한다. curriculum learning으로 입력 길이를 4,096토큰에서 65,536토큰까지 점진적으로 늘린다. 추론에서는 guidance scale 1.3과 노이즈 제거 단계 10회를 사용한다.
3 Results
평가는 대화 음성 품질, 영어와 중국어의 짧은 발화 성능, 음향 토크나이저의 재구성 품질을 측정한다. 각 실험은 시스템의 서로 다른 측면을 다룬다. 팟캐스트 평가 순위만으로 짧은 음성이나 모든 재구성 지표에서도 우수하다고 판단할 수는 없다.
3.1 VIBEVOICE Podcast
팟캐스트 테스트는 총 약 1시간 분량의 긴 대화 대본 8개로 구성된다. 시스템 간 목소리 특성을 맞추기 위해 음성 프롬프트를 사용하지만 Gemini 2.5 Pro Preview TTS는 기본 남성 및 여성 목소리를 사용한다. 대본 대비 전사 오류를 나타내는 단어 오류율(Word Error Rate, WER)은 음성 인식 시스템 2개인 Whisper-large-v3와 Nemo ASR로 측정한다. 임베딩을 통해 목소리 유사성을 측정하는 화자 유사도(SIM)는 WavLM-large로 화자의 수치 표현을 추출하여 계산한다.
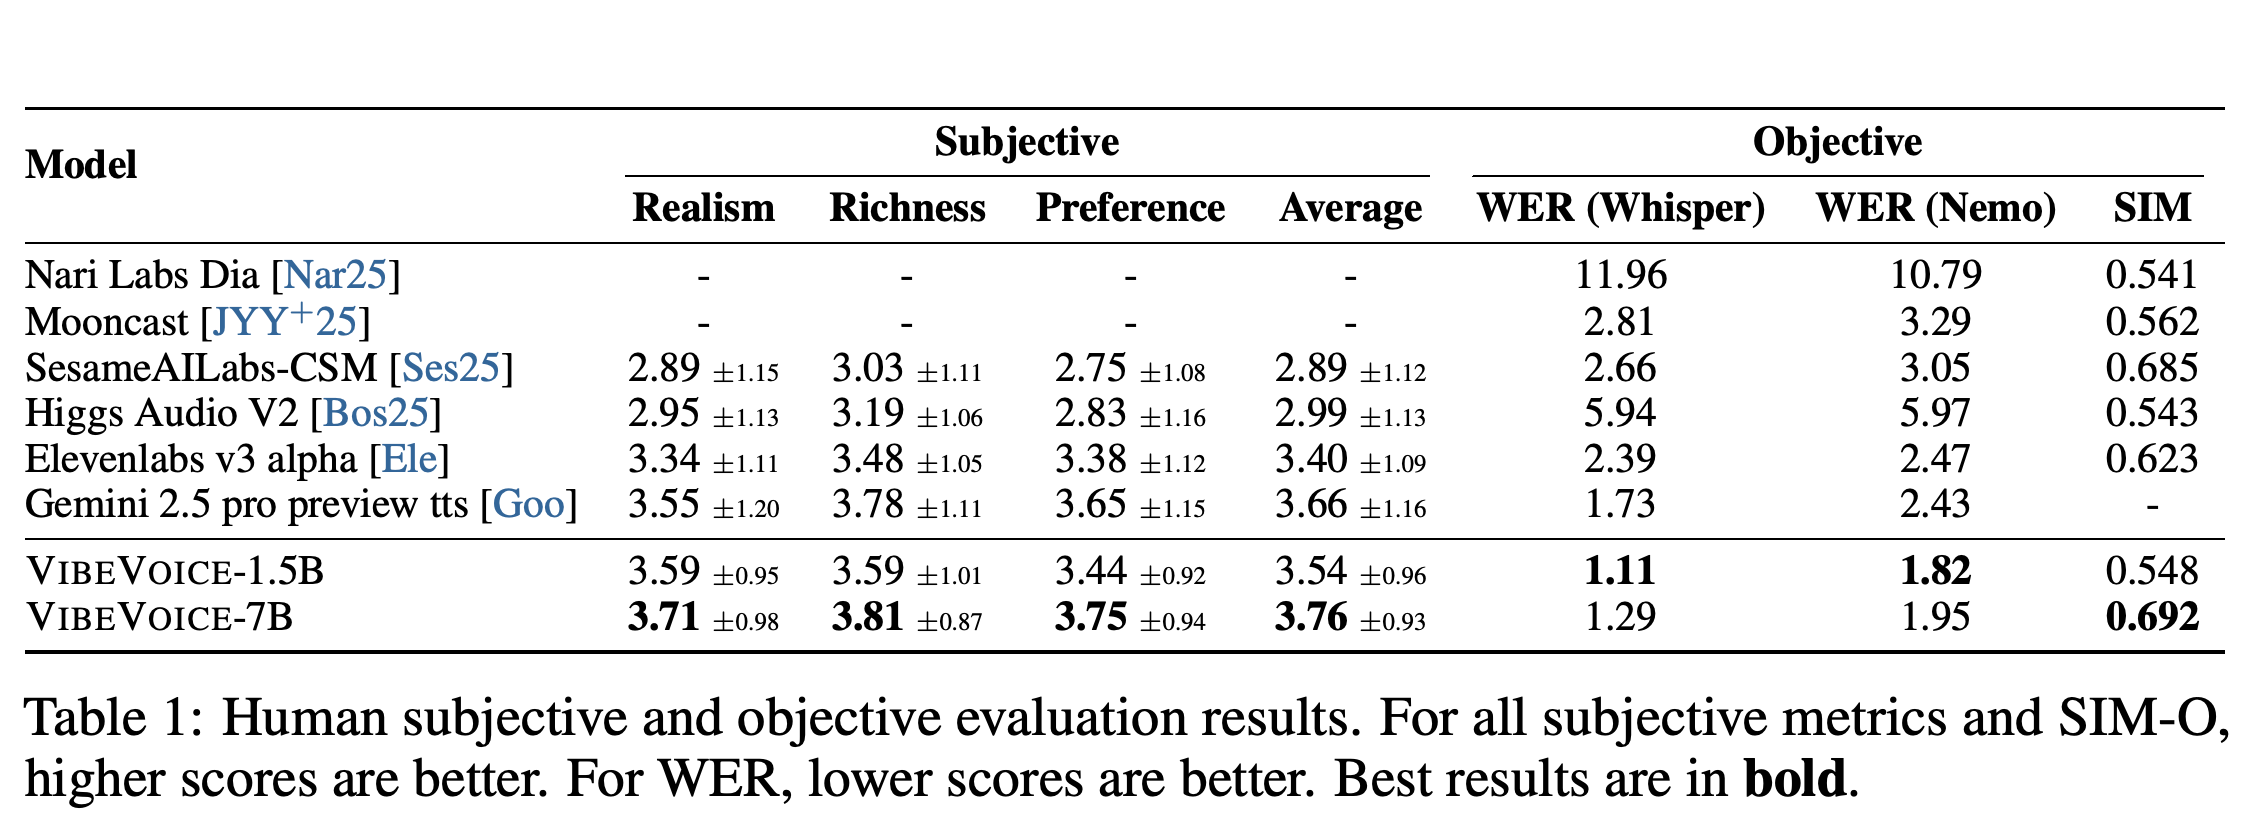
평가자 스물네 명이 청취자 평가 점수를 평균한 Mean Opinion Scores(MOS)를 제공한다. Realism은 자연스러움과 화자 간 발화 전환을, Richness는 표현력 있는 어조와 문맥에 따른 변화를, Preference는 청취자의 만족을 평가한다. 주관적 평가에는 모델 6개와 전체 샘플 8개가 포함되며, 각 평가자는 약 여섯 시간 분량의 오디오를 듣는다. Table 1에는 Nari Labs Dia와 Mooncast의 주관적 평가 점수가 제공되지 않는다.
VIBEVOICE-7B는 Realism 3.71 ± 0.98, Richness 3.81 ± 0.87, Preference 3.75 ± 0.94를 기록한다. Gemini의 점수는 각각 3.55 ± 1.20, 3.78 ± 1.11, 3.65 ± 1.15다. VIBEVOICE-1.5B는 양쪽 인식기에서 각각 1.11과 1.82로 가장 낮은 WER를 기록한다. VIBEVOICE-7B는 각각 1.29와 1.95를 기록하며 보고된 SIM 중 가장 높은 0.692를 기록한다. 따라서 더 큰 모델은 주관적 평가 점수와 화자 유사도가 높지만 전사 오류도 조금 더 높다.
7B 모델은 주관적 평가의 3개 항목과 보고된 화자 유사도에서 가장 높은 점수를 기록한다. 1.5B 모델은 전사 오류 지표 모두에서 가장 낮은 값을 기록한다. 이 결과는 더 큰 모델의 지각적 평가 점수가 높다는 점을 뒷받침하지만 모든 객관적 지표가 개선된다는 본문의 주장과는 맞지 않는다. 보고서는 ±로 표시한 수치의 의미를 정의하지 않으며 유의성 검정도 제공하지 않는다.
3.2 VIBEVOICE Short Utterance
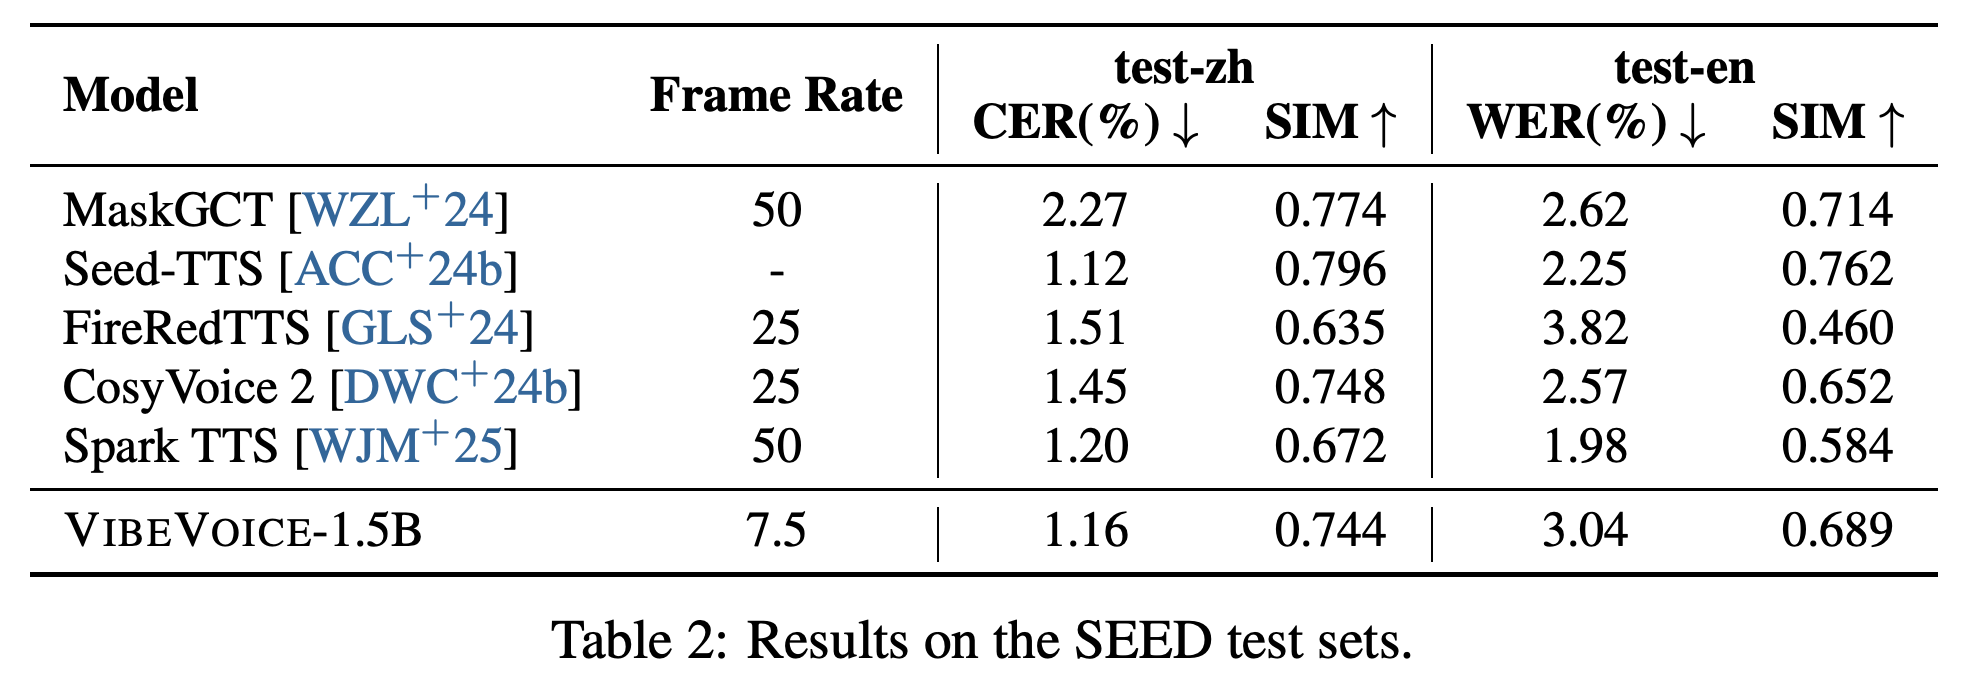
짧은 발화를 평가하는 SEED 벤치마크는 음성 데이터셋 CommonVoice에서 추출한 영어 샘플 약 1,000개와 중국어 샘플 약 2,000개로 구성되며, 각각 test-en과 test-zh라는 이름을 사용한다. Whisper-large-v3는 영어 전사를 평가하고 음성 인식 모델 Paraformer는 중국어 전사를 평가하며 WavLM-large는 화자 유사도를 측정한다. 본문은 전반적으로 WER를 언급하지만 Table 2는 문자 단위 전사 오류를 나타내는 중국어 문자 오류율(Character Error Rate, CER)을 보고한다.
초당 7.5프레임에서 VIBEVOICE-1.5B는 중국어 CER 1.16%와 SIM 0.744, 영어 WER 3.04%와 SIM 0.689를 기록한다. Seed-TTS는 중국어 CER 1.12%와 영어 WER 2.25%를 기록하며 2개 언어 모두에서 더 높은 유사도를 보인다. VIBEVOICE의 낮은 프레임률은 생성하는 음성 프레임 수를 줄이지만 이 표는 짧은 발화 정확도에서의 우위나 실제 실행 시간 절감을 입증하지 않는다.
VIBEVOICE-1.5B는 보고된 프레임률 중 가장 낮은 7.5를 사용하며 중국어 CER는 Seed-TTS에 근접한다. 영어 WER는 여러 비교 모델보다 높고, 화자 유사도는 2개 언어 모두 Seed-TTS보다 낮다. 따라서 간결한 표현을 사용한 짧은 발화 성능은 지표에 따라 엇갈린다.
3.3 Tokenizer Reconstruction
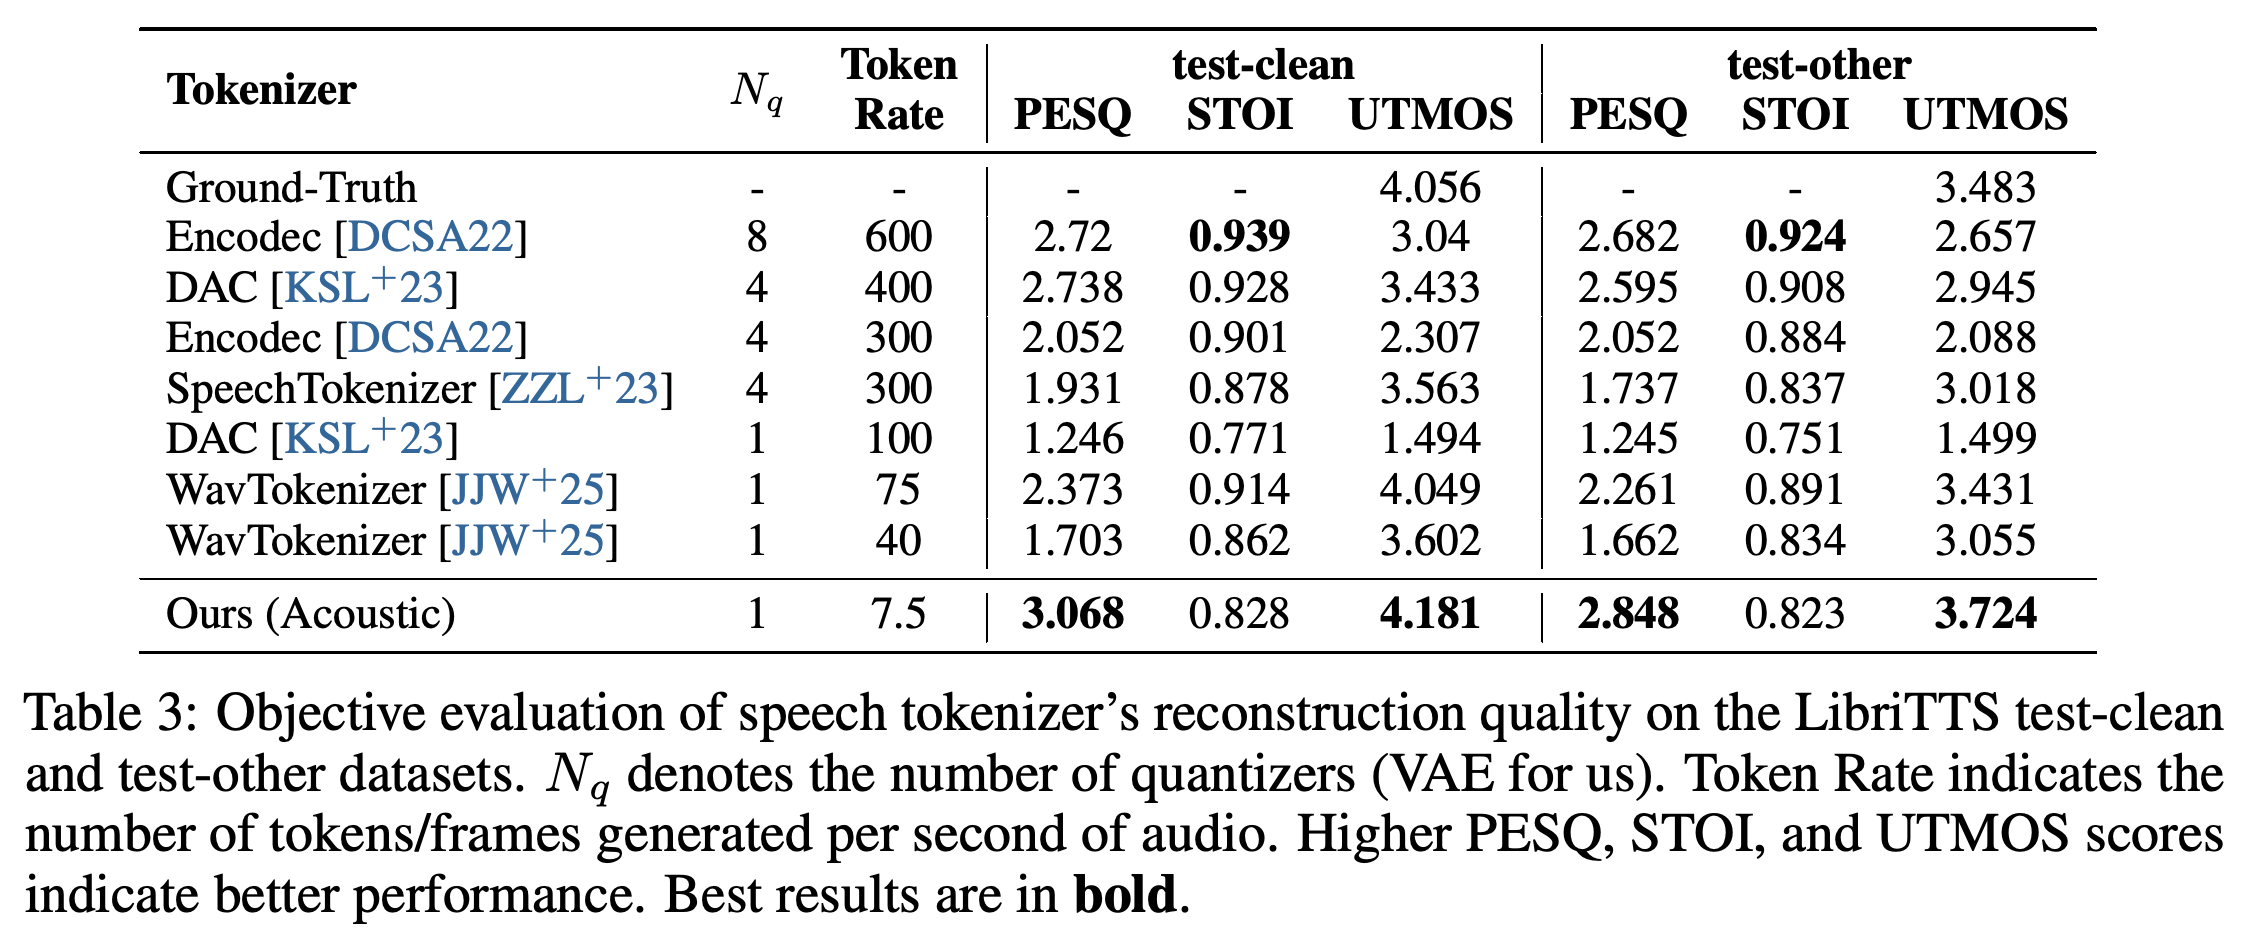
토크나이저 재구성은 LibriTTS 음성 데이터셋의 test-clean 및 test-other 하위 집합에서 평가한다. 지각적 음성 품질 지표인 PESQ, 객관적 명료도 지표인 STOI, 음성 품질 평가 점수를 자동으로 예측하는 UTMOS를 사용한다. 음향 토크나이저는 test-clean에서 PESQ 3.068과 UTMOS 4.181, test-other에서 PESQ 2.848과 UTMOS 3.724를 기록한다. 이 지표 2개에서 비교 대상 재구성 시스템 중 가장 높은 점수를 기록한다.
토큰 생성률이 초당 7.5인 표현은 Table 3에서 토큰 생성률이 초당 600인 Encodec 오디오 압축 설정에 비해 토큰 수가 80 times 적다. STOI는 0.828과 0.823으로 Encodec의 0.939와 0.924보다 낮으므로, 재구성 성능의 우위가 모든 지표에 적용되지는 않는다. 연속형 특징과 이산 토큰의 토큰 생성률 비율만으로 저장 비트 수도 같은 비율로 감소한다고 판단할 수는 없다.
음향 토크나이저는 초당 7.5토큰에서 양쪽 하위 집합 모두 PESQ와 UTMOS가 비교 대상 재구성 시스템 중 가장 높지만 STOI는 여러 비교 시스템보다 낮다. UTMOS 점수는 원본 음성 행의 점수도 웃돈다. 따라서 이 자동 평가 점수만으로 원본 파형을 더 충실하게 재현한다고 판단할 수는 없다.
4 Conclusion, Limitations, and Risks
보고서는 간결한 음향 표현과 의미 표현으로 최대 4명의 화자가 참여하는 최대 90분 길이의 음성을 생성할 수 있다고 결론짓는다. 명시된 한계는 영어와 중국어만 지원한다는 점, 배경 소음과 음악 및 음향 효과를 처리하지 못한다는 점, 화자들이 동시에 말하는 중첩 발화를 명시적으로 모델링하거나 생성하지 않는다는 점이다.
저자들은 사실적인 합성 음성이 사칭, 사기, 허위 정보 유포에 악용될 가능성을 지적한다. 신뢰할 수 있는 대본과 콘텐츠 검사를 요구하고 오해를 유발하는 사용을 피할 것을 권고한다. 모델의 용도는 연구 및 개발이라고 밝히며, 상업적 사용이나 실제 환경에서의 사용에 앞서 추가 테스트와 개발을 권고한다.
부록
- 제공된 8페이지 보고서에는 원문 부록이 없다. 페이지 6–8에는 위험 논의의 마지막 부분과 References가 실려 있다. 논문 식별자는 arXiv:2508.19205v1이며, 날짜는 26 Aug 2025다. 원문은 프로젝트 페이지 https://microsoft.github.io/VibeVoice, 코드 https://github.com/microsoft/VibeVoice, 모델 모음 https://huggingface.co/collections/microsoft/vibevoice-68a2ef24a875c44be47b034f, 데모 https://aka.ms/VibeVoice-Demo를 제공한다.
짧은 생각
공학적 기여는 재구성 지표 2개에서 높은 점수를 유지하면서 경쟁력 있는 대화 음성 생성을 지원하는 짧은 음성 표현이다. Table 3은 토큰 생성률 감소를 뒷받침하고 Table 1은 더 큰 시퀀스 모델에서 지각적 평가 점수가 높아짐을 보여준다. 어느 실험도 의미 특징이나 diffusion head의 기여도를 분리하여 검증하지는 않는다.
대화 평가는 대본 8개와 평가자 24명을 대상으로 하며, Gemini에는 다른 시스템과 다른 목소리 제어 조건을 적용한다. 보고서는 통계적 유의성 검정, 체계적인 90분 안정성 평가, 학습 데이터 규모, 실행 시간 및 메모리 측정값을 제공하지 않는다. 이러한 정보의 부재는 보고된 차이, 재현 가능성, 배포 비용을 평가하는 데 제약이 된다.