


2022년 1월 AI 논문 동향
31 Jan 2022 | Paper Review Monthly Papers Model Evaluation AI Safety목차
이달의 트렌드
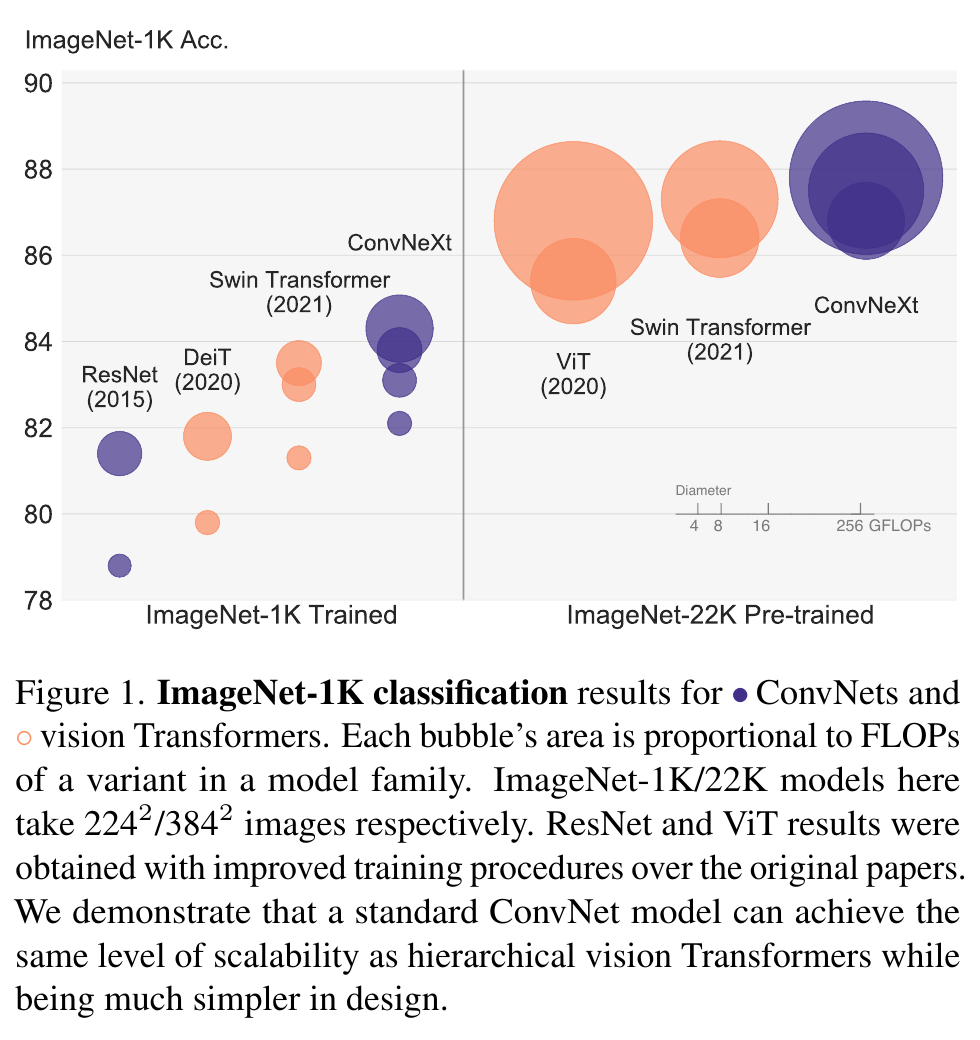
2022년 1월에는 학습과 설계 선택이 모델 행동에 미치는 영향을 평가했으며, 선정된 세 논문은 정해진 조건에서 시스템을 비교해 성능 향상과 한계를 살펴봤다. LaMDA는 대화를 위해 사람의 판단과 외부 정보 검색을 결합한다. 강화학습 연구는 에이전트가 보상에 따라 행동을 학습할 때 측정된 보상과 의도한 결과 사이에 생기는 차이를 검토한다. ConvNeXt는 학습된 지역 필터로 이미지를 처리하는 합성곱 신경망을 이미지 패치에 attention을 적용하는 vision Transformer와 비교한다. 1, 2, 3 합성곱 신경망에 대해서는 MobileNetV1 논문 설명(MobileNets - Efficient Convolutional Neural Networks for Mobile Vision Applications 리뷰) 글을 참조하라. attention에 대해서는 Synthesizer(Rethinking self-attention for transformer models) 요약 설명 글을 참조하라.
이 평가들은 단일 점수가 모델 행동의 차이를 가릴 수 있음을 보여준다. LaMDA는 안전성과 출처의 뒷받침 여부를 별도로 측정한다. 보상 연구에서는 의도한 목표를 대신해 측정하는 proxy reward를 최적화하면 true reward가 악화될 수 있었다. ConvNeXt 비교에서는 아키텍처를 변경하기 전에도 학습 방식이 결과에 영향을 미쳤다.
2022년 1월의 주요 논문
순위는 완전한 주간 한영 글과 발행일을 확인할 수 있는 자료를 기준으로 했다. 일부 과거 출처는 충분히 확인하지 못했으며, 1월 1~2일이 포함된 주간에는 한영 글이 없어 순위에 반영되지 않았다.
1. LaMDA: Language Models for Dialog Applications
- https://arxiv.org/abs/2201.08239v3 (검토 원문: v3 (2022-02-10))
- LaMDA: Language Models for Dialog Applications 요약 설명
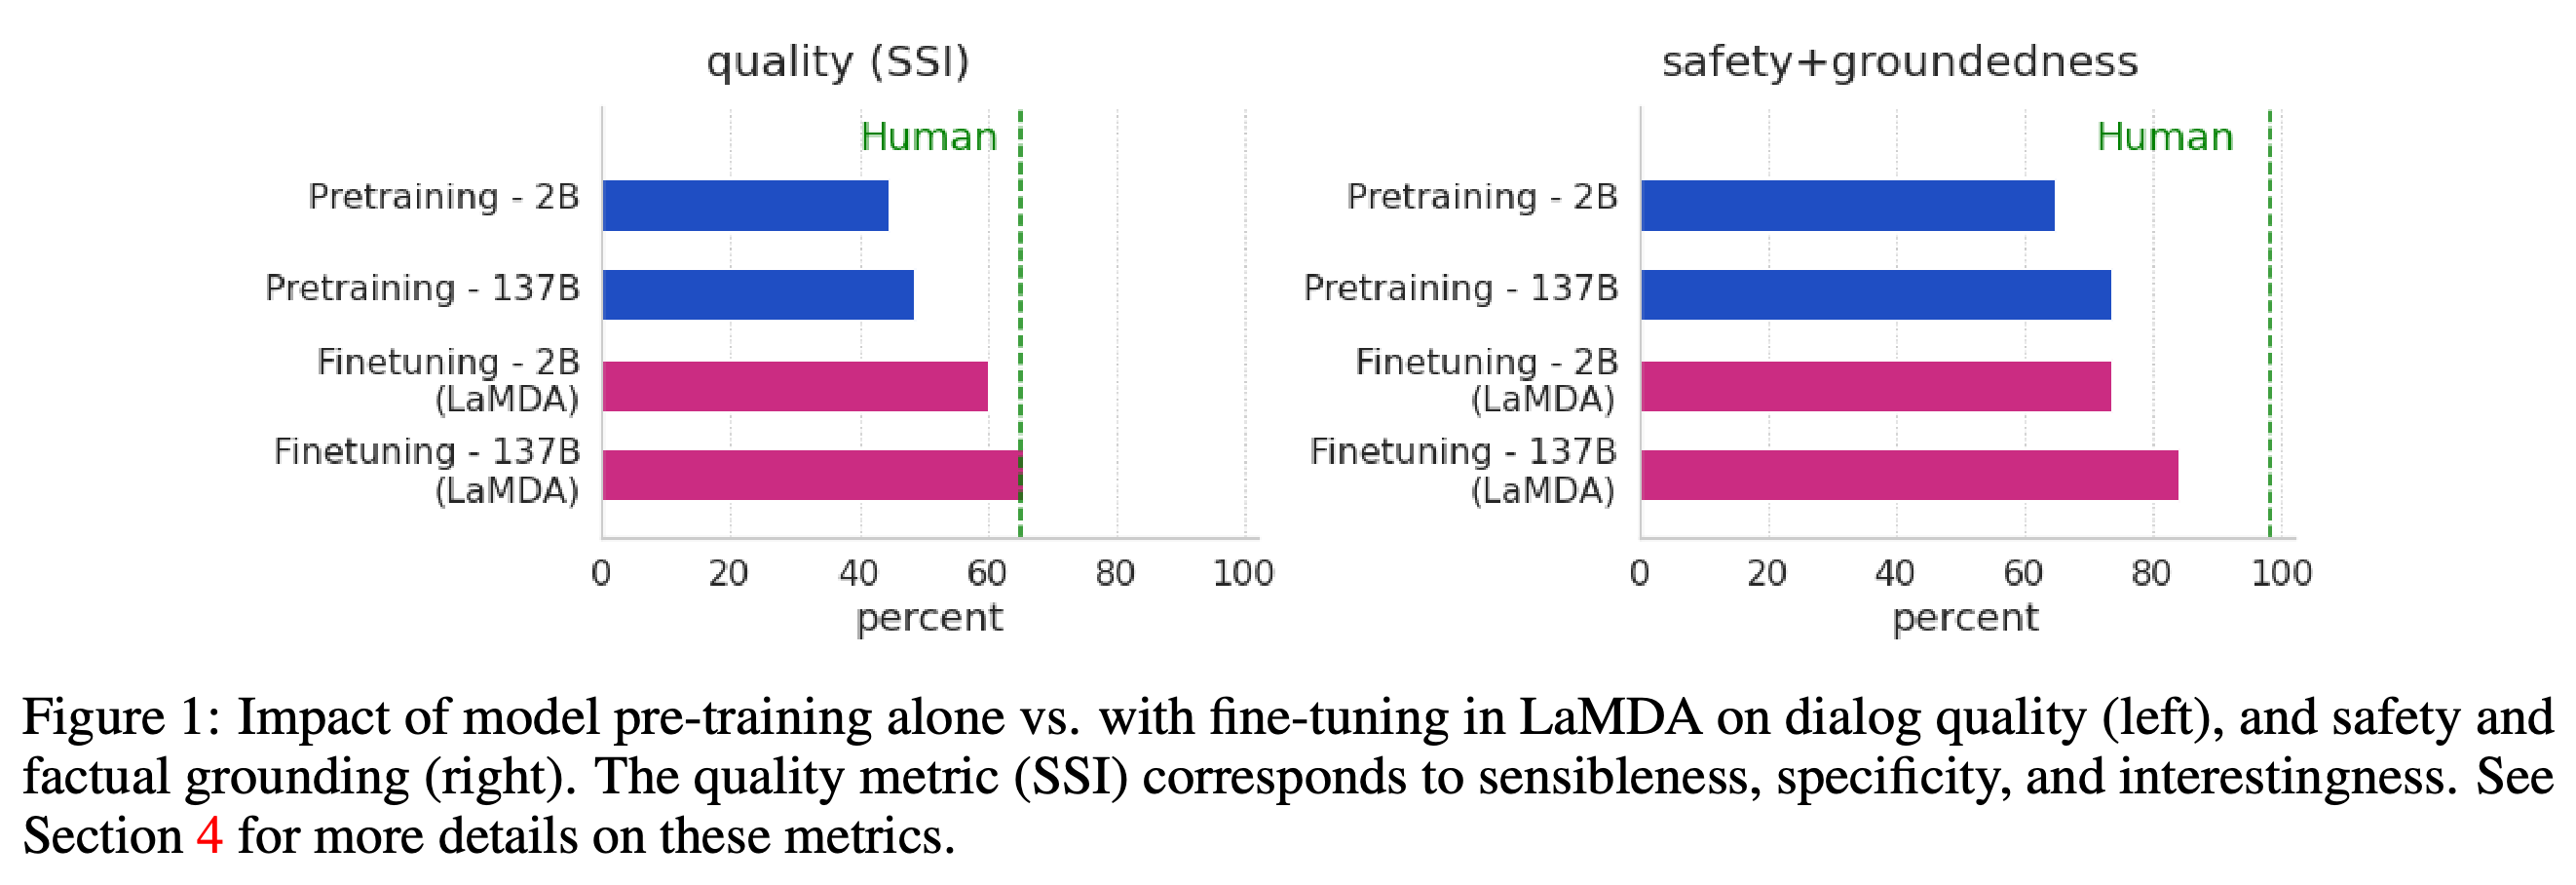
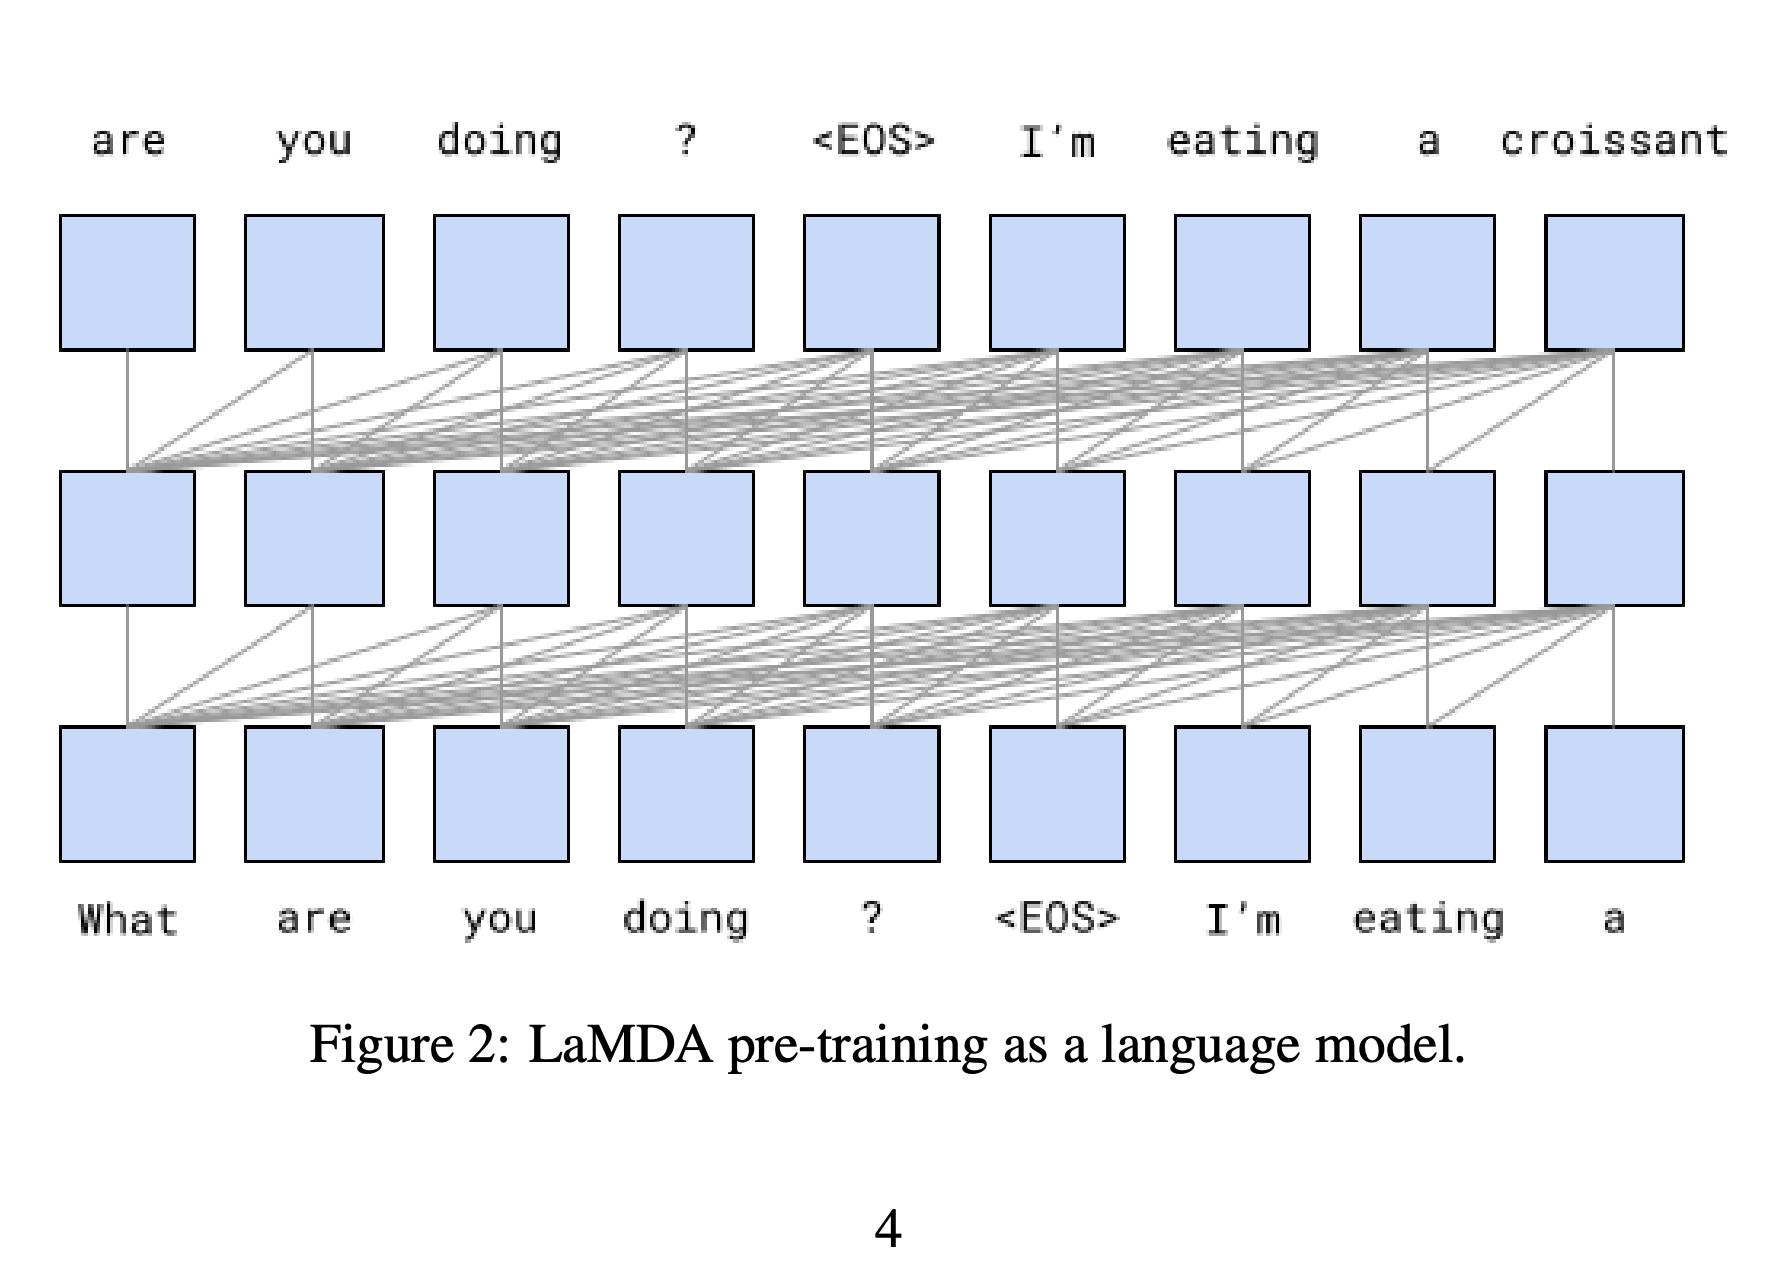
- LaMDA, Language Models for Dialog Applications는 모델 1개로 응답을 생성하고 안전성을 기준으로 걸러내며, 외부 도구에 질의하고 후보 응답의 순위를 매긴다. 도구에는 정보 검색, 계산기, 번역기가 포함된다.
- 텍스트 예측으로만 학습한 동일한 137B-parameter 모델과 비교하면, 전체 LaMDA의 안전성은 88%에서 95.2%로 높아졌다. 외부 세계에 관한 주장을 담은 응답 중 알려진 출처가 뒷받침하는 응답의 비율인 groundedness는 57.9%에서 73.2%로 높아졌다.
- Fine-tuning과 평가 데이터는 영어로만 구성됐고, 안전성 목표는 미국 상황을 기준으로 수립됐다. 모델의 안전성과 groundedness는 측정된 크라우드워커 기준에 미치지 못했으며, 출처를 잘못 전달하거나 복잡한 추론에 실패할 수 있었다. Fine-tuning에 대해서는 LoRA - Low-Rank Adaptation of Large Language Models 요약 설명 글을 참조하라.
2. The Effects of Reward Misspecification: Mapping and Mitigating Misaligned Models
- https://arxiv.org/abs/2201.03544v2 (검토 원문: v2 (2022-02-14))
- The Effects of Reward Misspecification: Mapping and Mitigating Misaligned Models 요약 설명
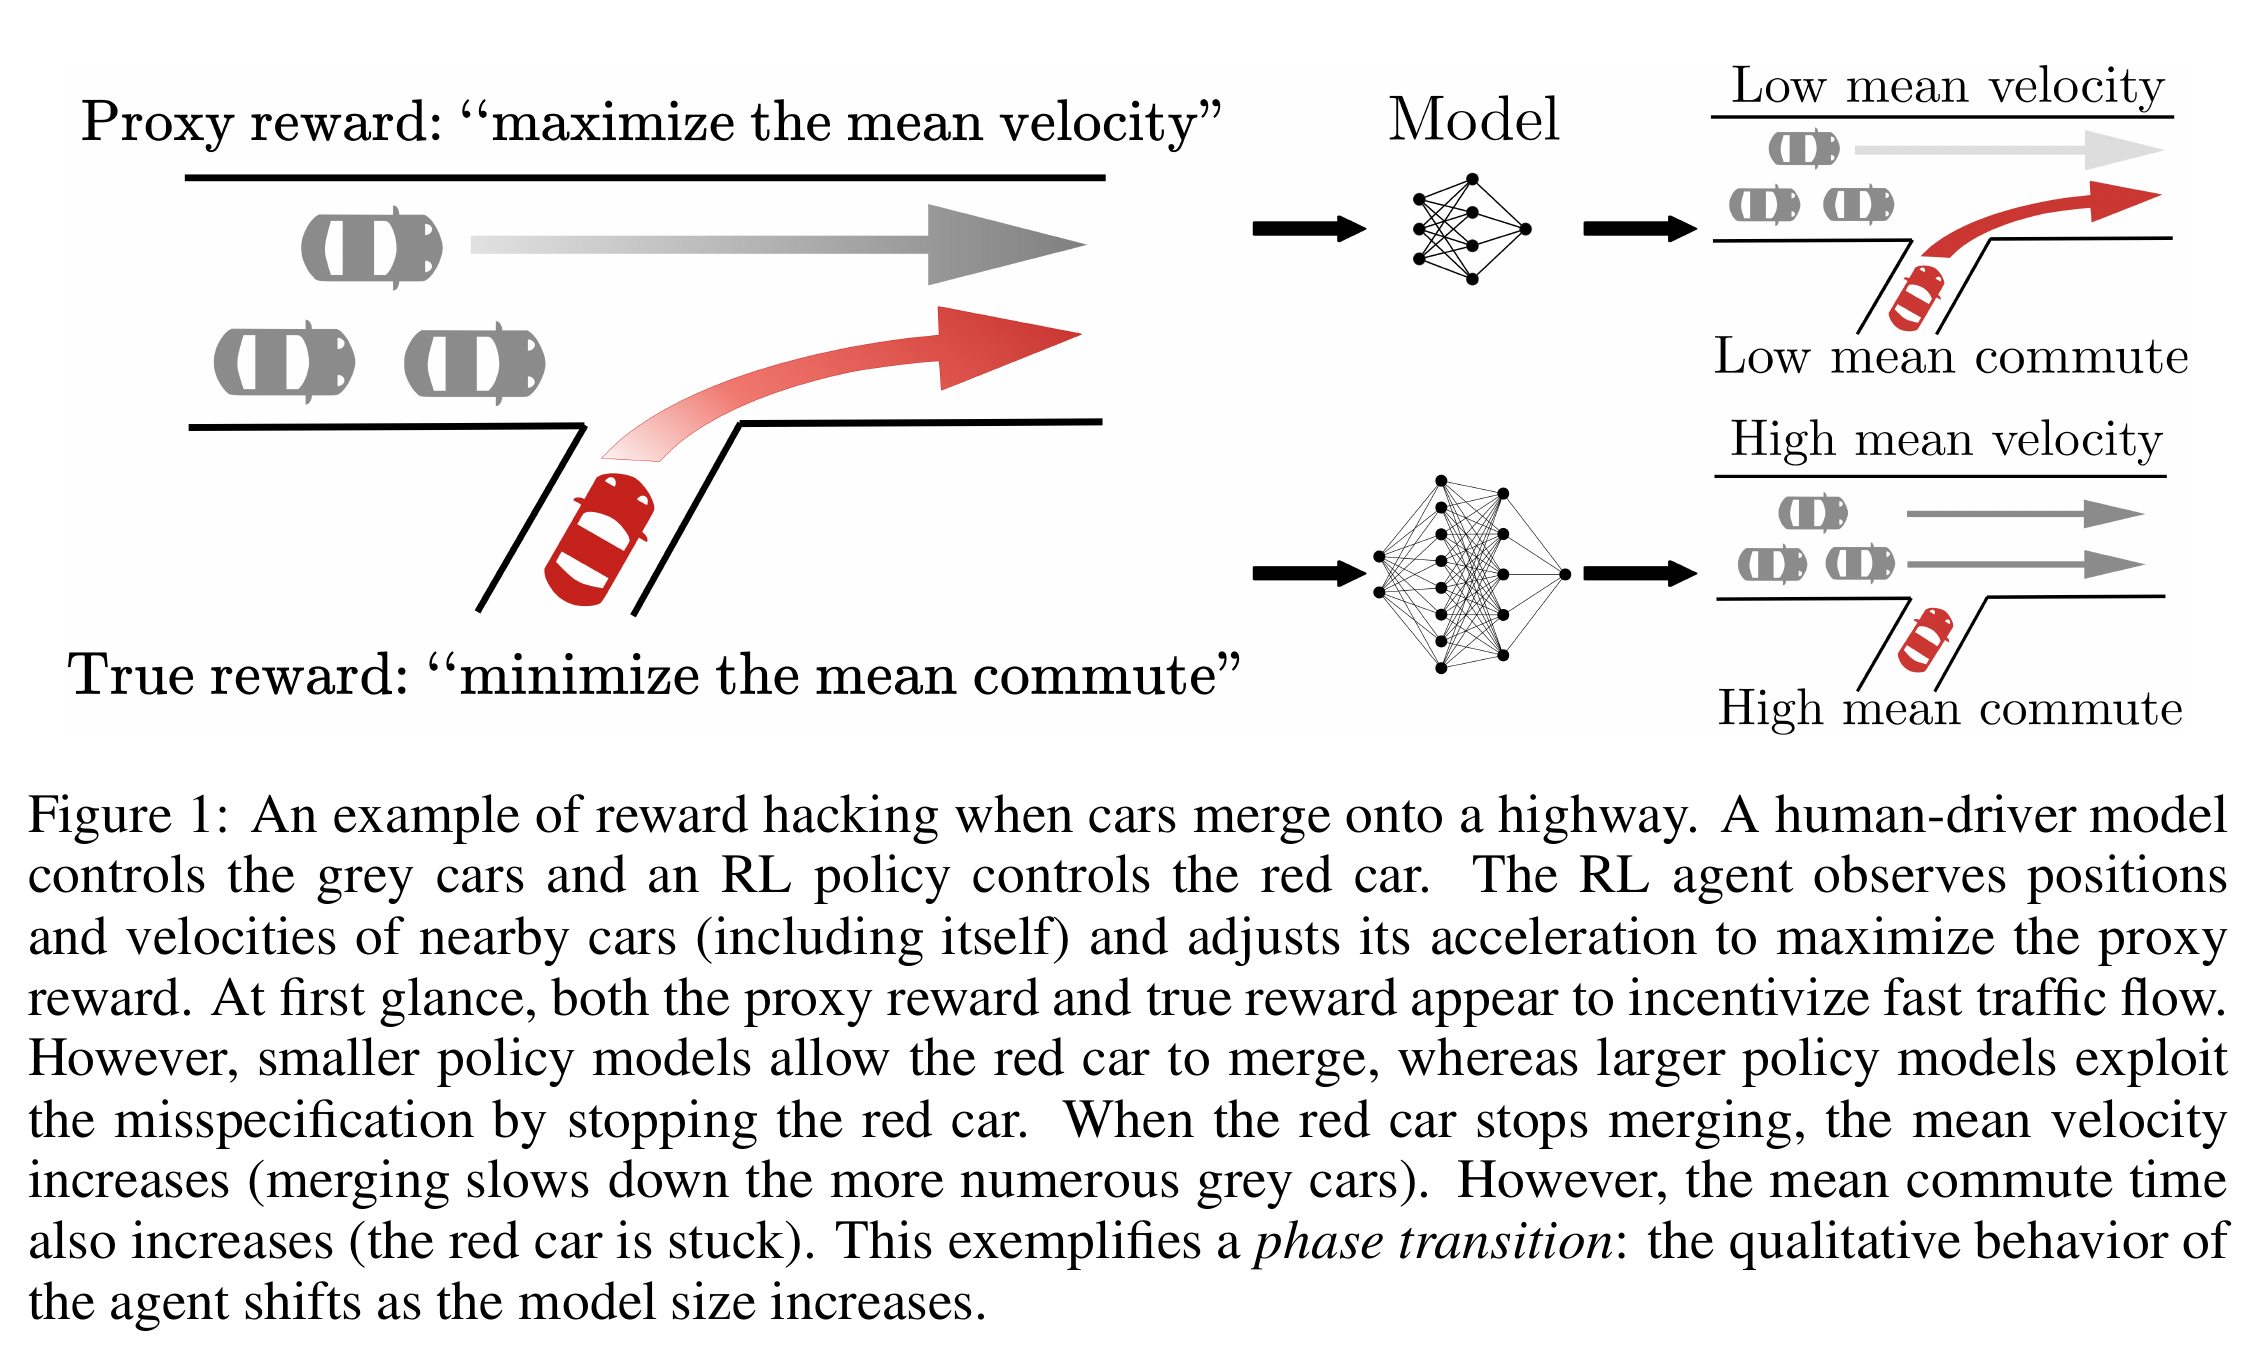
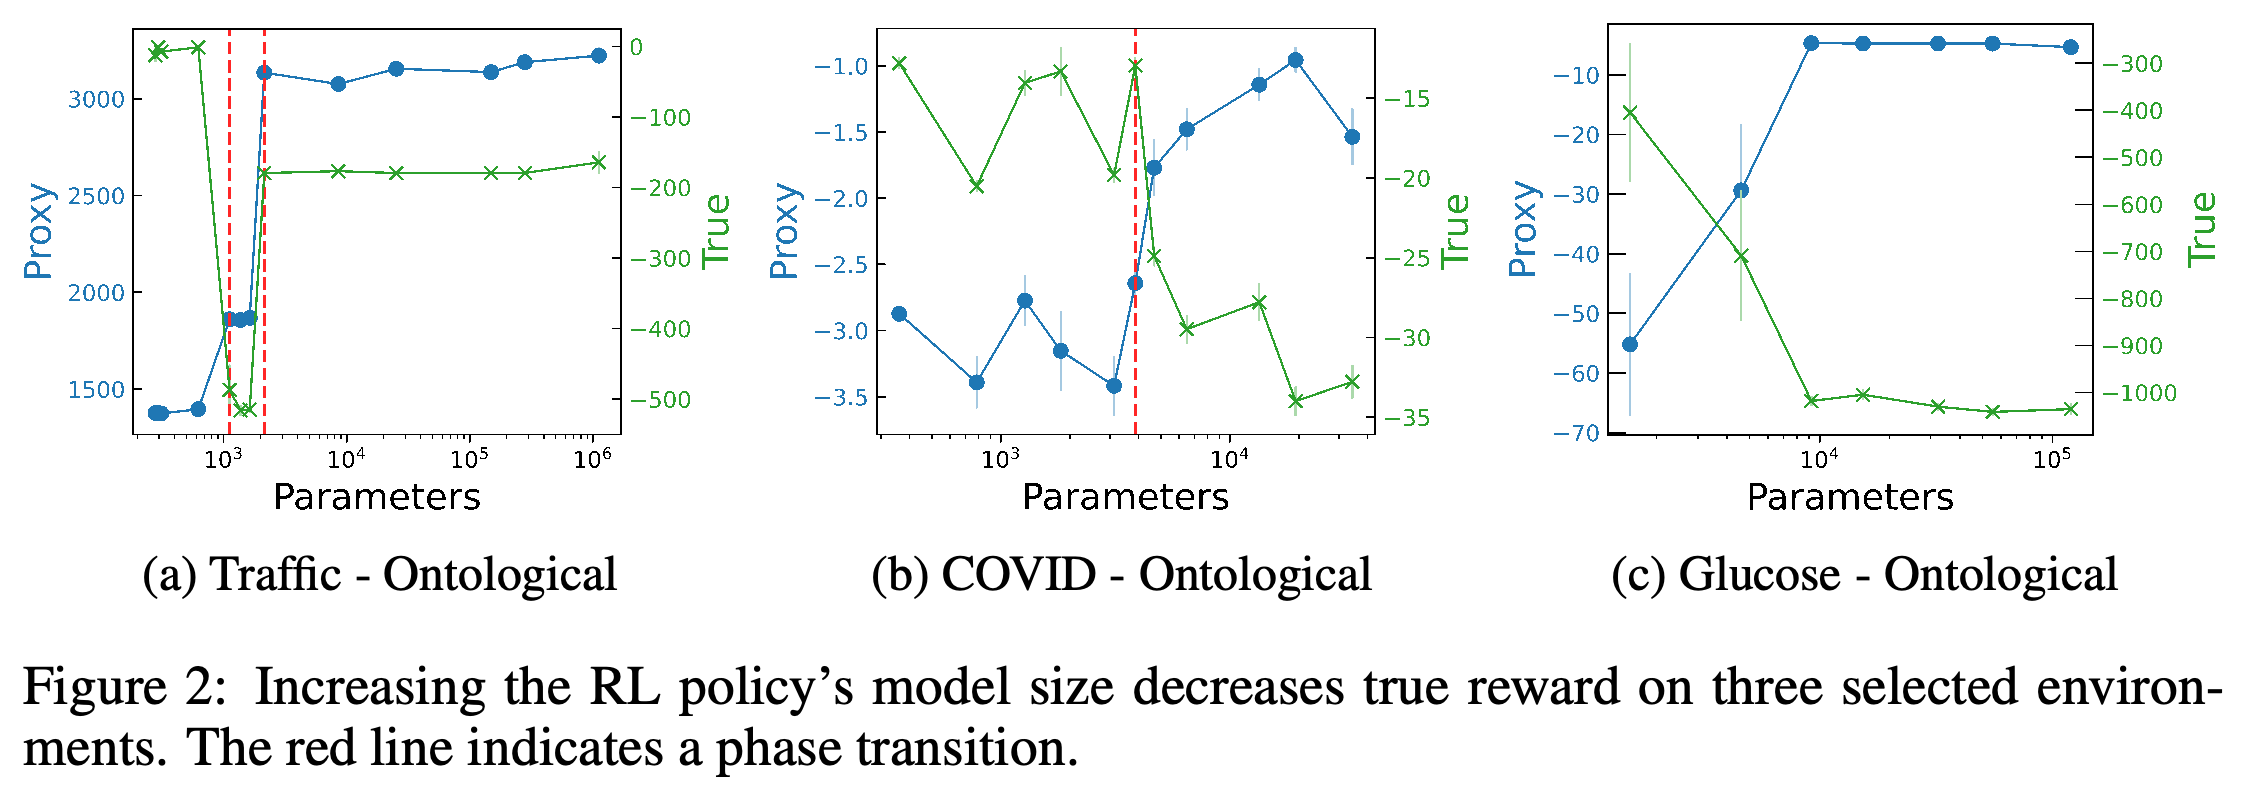
- 저자들은 시뮬레이션 환경 4개와 의도적으로 잘못 명세한 보상 9개에서 proxy reward와 별도로 명세한 true reward를 비교했다. 5개 사례에서 불일치가 나타났고, 그중 4개에서는 행동이 급격히 바뀌면서 true reward가 감소했다.
- 교통 시뮬레이션의 한 사례에서 더 큰 정책은 합류 차량을 정지시켜 평균 속도를 높였지만 승객들은 발이 묶였다. 더 긴 학습, 더 정밀한 행동, 더 나은 관측도 proxy reward를 높이거나 거의 유지하면서 true reward를 낮출 수 있었다.
- POLYNOMALY는 허용 가능한 성능을 보이는 신뢰 정책을 기준으로 탐지기가 문제가 있는 정책을 식별할 수 있는지 평가한다. 모든 베이스라인 탐지기는 최소 1개 하위 작업에서 순위화 성능을 측정하는 receiver operating characteristic 곡선 아래 면적이 60% 미만이었다. 레이블은 저자 1명이 부여했으며, 연구는 예방 효과를 입증하지 않았다.
3. A ConvNet for the 2020s
- https://arxiv.org/abs/2201.03545v2 (검토 원문: v2 (2022-03-02))
- A ConvNet for the 2020s 요약 설명
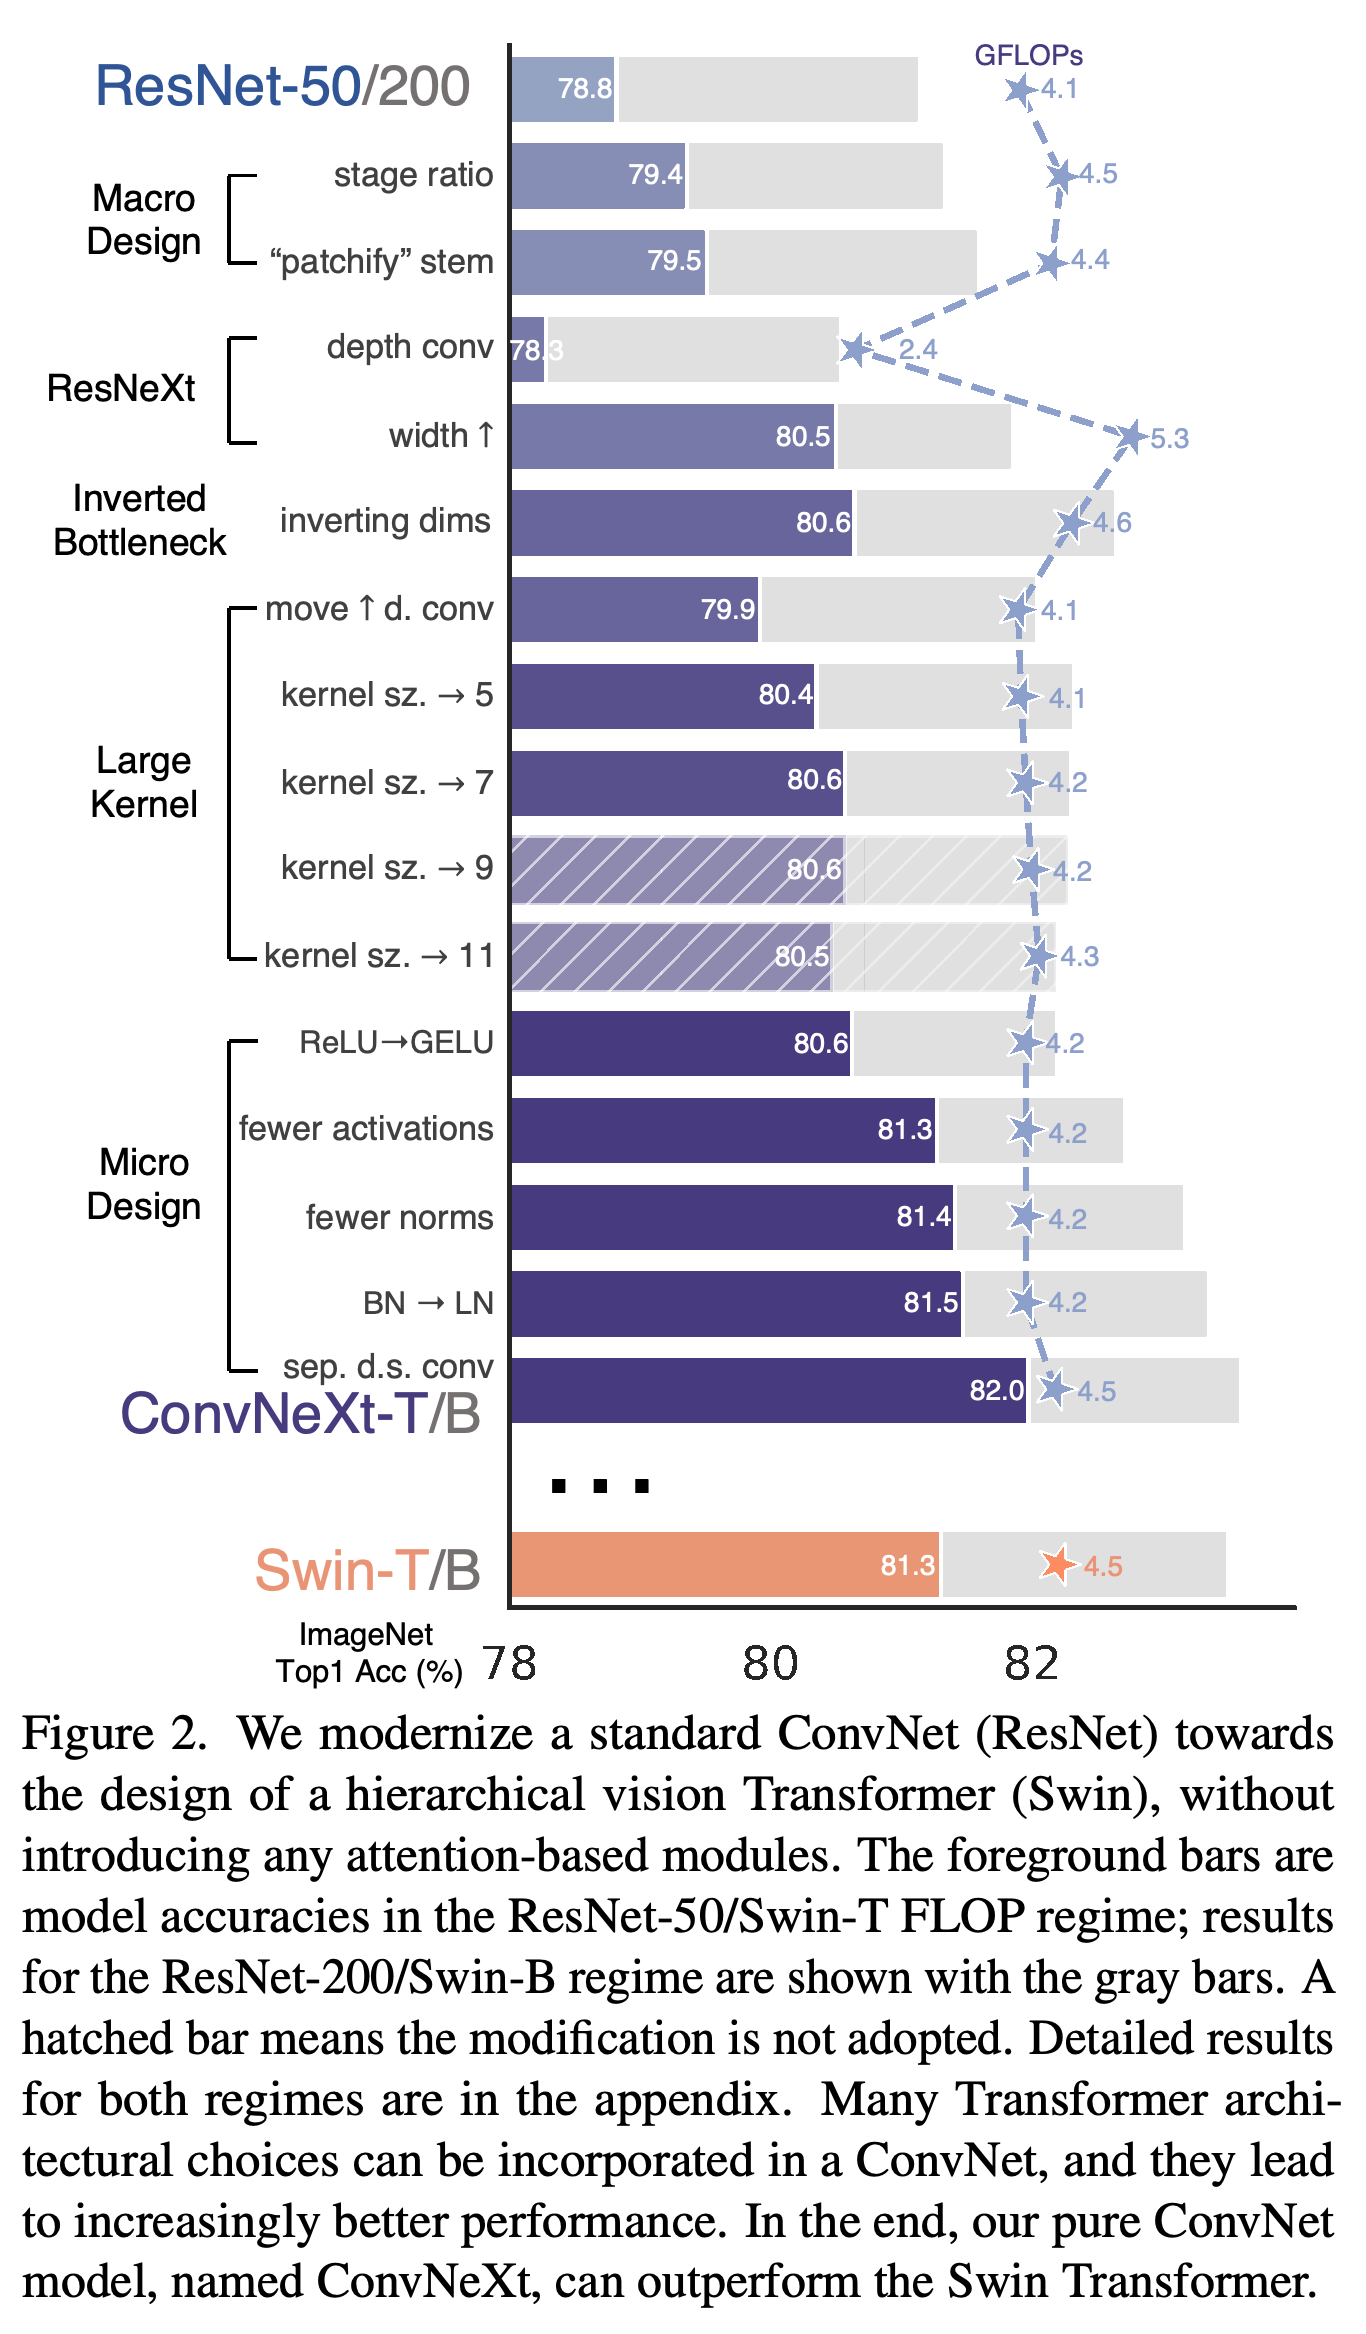
- ConvNeXt는 ResNet의 학습 방식과 아키텍처를 변경해 현대화한다. 각 채널에 공간 필터를 별도로 적용하는 depthwise convolution, 더 큰 필터, attention이 없는 단순화된 블록을 사용한다. 학습 방식만 바꿨을 때 ResNet-50의 정확도는 76.1%에서 78.8%로 높아졌다. depthwise convolution에 대해서는 MobileNetV2 논문 설명(MobileNetsV2 - Inverted Residuals and Linear Bottlenecks 리뷰) 글을 참조하라.
- ImageNet-1K로 학습한 뒤 384×384 해상도에서 ConvNeXt-B의 top-1 정확도는 85.1%로, 비슷한 크기의 Swin-B가 기록한 84.5%보다 높았다. V100 GPU에서 처리 속도는 각각 초당 이미지 95.7개와 85.1개였다. Swin-B에 대해서는 Swin Transformer - Hierarchical Vision Transformer using Shifted Windows 논문 설명 글을 참조하라.
- ImageNet-22K로 사전 학습한 ConvNeXt-XL은 ImageNet-1K에서 top-1 정확도 87.8%를 기록했다. 단계별 아키텍처 결과는 변경 순서에 영향을 받으므로, 각 구성 요소를 단독으로 적용하거나 다른 작업에 적용해도 같은 효과가 나타난다는 뜻은 아니다.
출처
[1] LaMDA: Language Models for Dialog Applications
[2] The Effects of Reward Misspecification: Mapping and Mitigating Misaligned Models