


2025년 5월 AI 논문 동향
31 May 2025 | Paper Review Monthly Papers Model Evaluation Reasoning Strategies Reinforcement Learning목차
이 글은 2025년 5월 선정 논문을 이후 개정본까지 반영해 돌아본 요약입니다. 검토 버전은 2504.20879v2 (2025년 5월 12일), 2505.10185v1 (2025년 5월 15일), 2505.10320v3 (2025년 10월 13일)입니다. 수치와 분석은 J1의 10월 개정본을 포함한 이 버전들을 기준으로 합니다.
이달의 트렌드
2025년 5월의 주제는 평가를 통한 모델 행동의 측정과 조정이며, 선정된 세 논문은 테스트 절차, 추론 지시, 평가 모델 학습이 보고된 성능에 미치는 영향을 살펴본다. The Leaderboard Illusion은 사용자가 익명 모델의 응답 중 선호하는 쪽을 선택하는 Chatbot Arena를 감사한다. CoT Encyclopedia는 답변 전에 생성하는 중간 추론 텍스트인 chain-of-thought를 전략별로 분류하고 지시에 활용한다. J1은 다른 모델의 응답을 평가하는 대규모 언어 모델인 LLM-as-a-Judge를 학습한다. 이 연구들은 점수의 수치와 함께 그 점수가 산출된 과정도 살펴볼 근거를 제공한다. 1, 2, 3
평가 조건은 성능 향상을 해석하는 데 큰 영향을 미친다. Arena에 특화된 학습은 해당 평가 분포에서 추출한 프롬프트의 성능을 높이지만, 별도의 지식 벤치마크에서는 성능을 개선하지 못한다. CoT Encyclopedia는 모델이 처음에 오답을 낸 질문만 다시 풀게 하고 처음부터 정답이었던 답변을 전체 집계에 유지한 조건에서 성능 향상을 보고한다. J1은 응답 쌍의 순서를 무작위로 정했을 때의 정답률인 random-order accuracy와, 응답 순서 두 가지 모두에서 올바른 판정을 요구하는 position-consistent accuracy를 구분한다. 이 결과들은 성능을 비교할 때 학습 중 평가 데이터에 노출된 조건, 오답을 낸 질문 중 다시 풀게 한 질문의 범위, 응답 순서에 따른 정답 요건을 함께 보고할 근거가 된다.
생성된 추론은 분석 대상이면서 개입 대상이 된다. CoT Encyclopedia는 성공한 응답에서 관찰한 전략을 사용해 질문별 지시를 선택한다. J1은 생성한 출력에 부여한 보상으로 학습하는 강화학습을 통해 추론과 판정을 함께 개선한다. 두 연구 모두 벤치마크 성능 향상을 보고하지만, 생성된 추론이 모델 내부의 계산 과정을 충실하게 나타낸다는 점은 입증하지 않는다. 따라서 이 실험들에서 읽기 쉬운 설명을 생성한다는 주장과 결과가 개선된다는 주장은 별도로 판단해야 한다.
2025년 5월의 주요 논문
1. The Leaderboard Illusion
- https://arxiv.org/abs/2504.20879
- The Leaderboard Illusion 요약 설명
- The Leaderboard Illusion은 제공자 42곳의 모델 243개를 다룬 약 2M건의 배틀, 즉 모델 간 쌍대 비교 기록을 시뮬레이션 및 실제 제출 실험과 결합한다. 모델 정체를 공개하기 전의 비공개 테스트, 점수의 선택적 공개, 사용자 프롬프트 접근권의 불균형, 모델 평가 중단을 리더보드 결과에 영향을 줄 수 있는 메커니즘으로 살펴본다.
- 학습을 1.3K스텝과 배치 크기 128로 고정한 상태에서 Arena 데이터 비중을 0%에서 70%로 늘리면, 7B 파라미터 모델의 Llama-3.1-8B-Instruct 상대 승률이 23.5%에서 49.9%로 높아진다. 평가는 Arena에서 추출한 영어 ArenaHard 프롬프트 500개를 사용하며, 자동 평가자는 gpt-4o-2024-11-20이다. 지식 벤치마크인 Massive Multitask Language Understanding, 즉 MMLU의 정확도는 66.5%에서 65.9%로 바뀌어 별도의 평가에서는 개선이 나타나지 않는다.
- 저장된 모델 가중치가 동일한 Aya-Vision-8B 체크포인트 두 개는 Arena Score 1052와 1069를 받으며, 보고된 불확실성 구간은 서로 겹친다. 이는 모델을 바꾸지 않아도 유리하게 관측된 점수만 공개할 기회가 있음을 보여준다. 실제로 서로 다른 후보 중에서 선택하면 후보 간 품질 차이도 반영되므로, 선택으로 얻는 이점 전체를 측정 잡음으로 설명할 수는 없다. 기록이 불완전하고 모델의 자기소개 응답으로 소유자를 추정하므로 개별 제공자에 대한 해석에는 한계가 있다. 이 감사는 각 메커니즘이 실제 공개 순위에 얼마나 기여했는지 정량화하지 않는다.
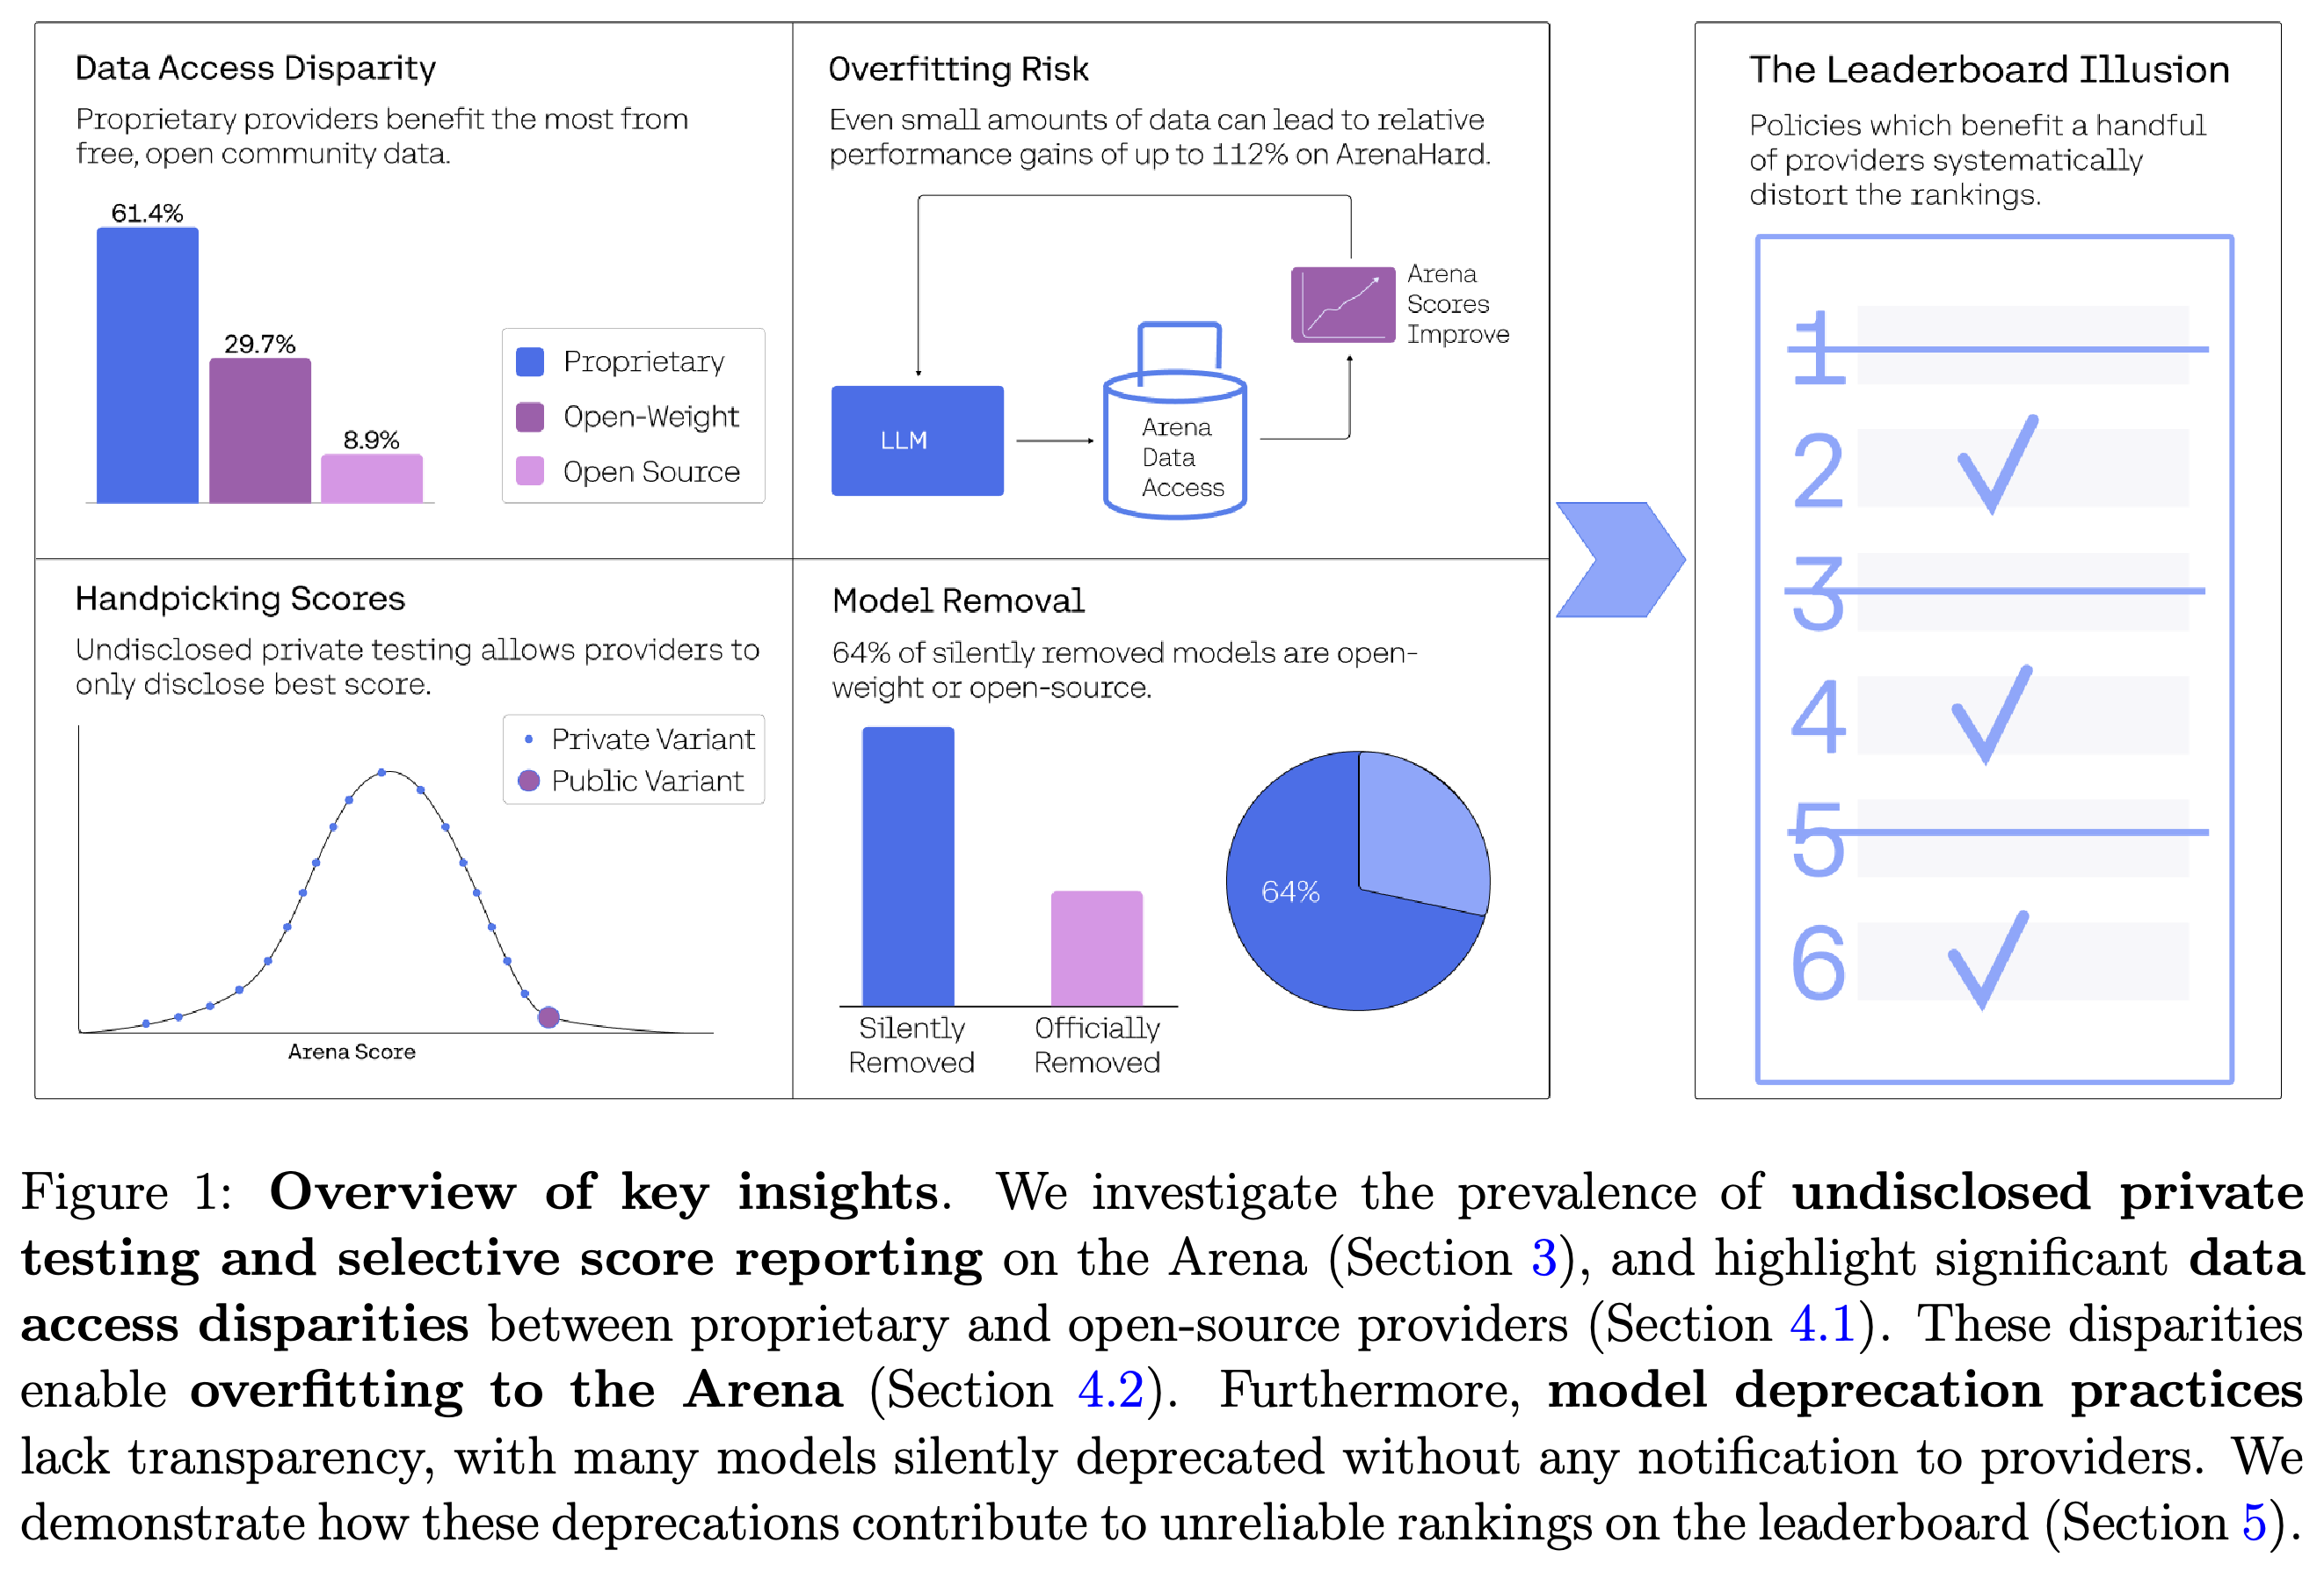
그림 1. Arena의 데이터 접근 격차, 과적합, 선택적 점수 공개와 모델 제거
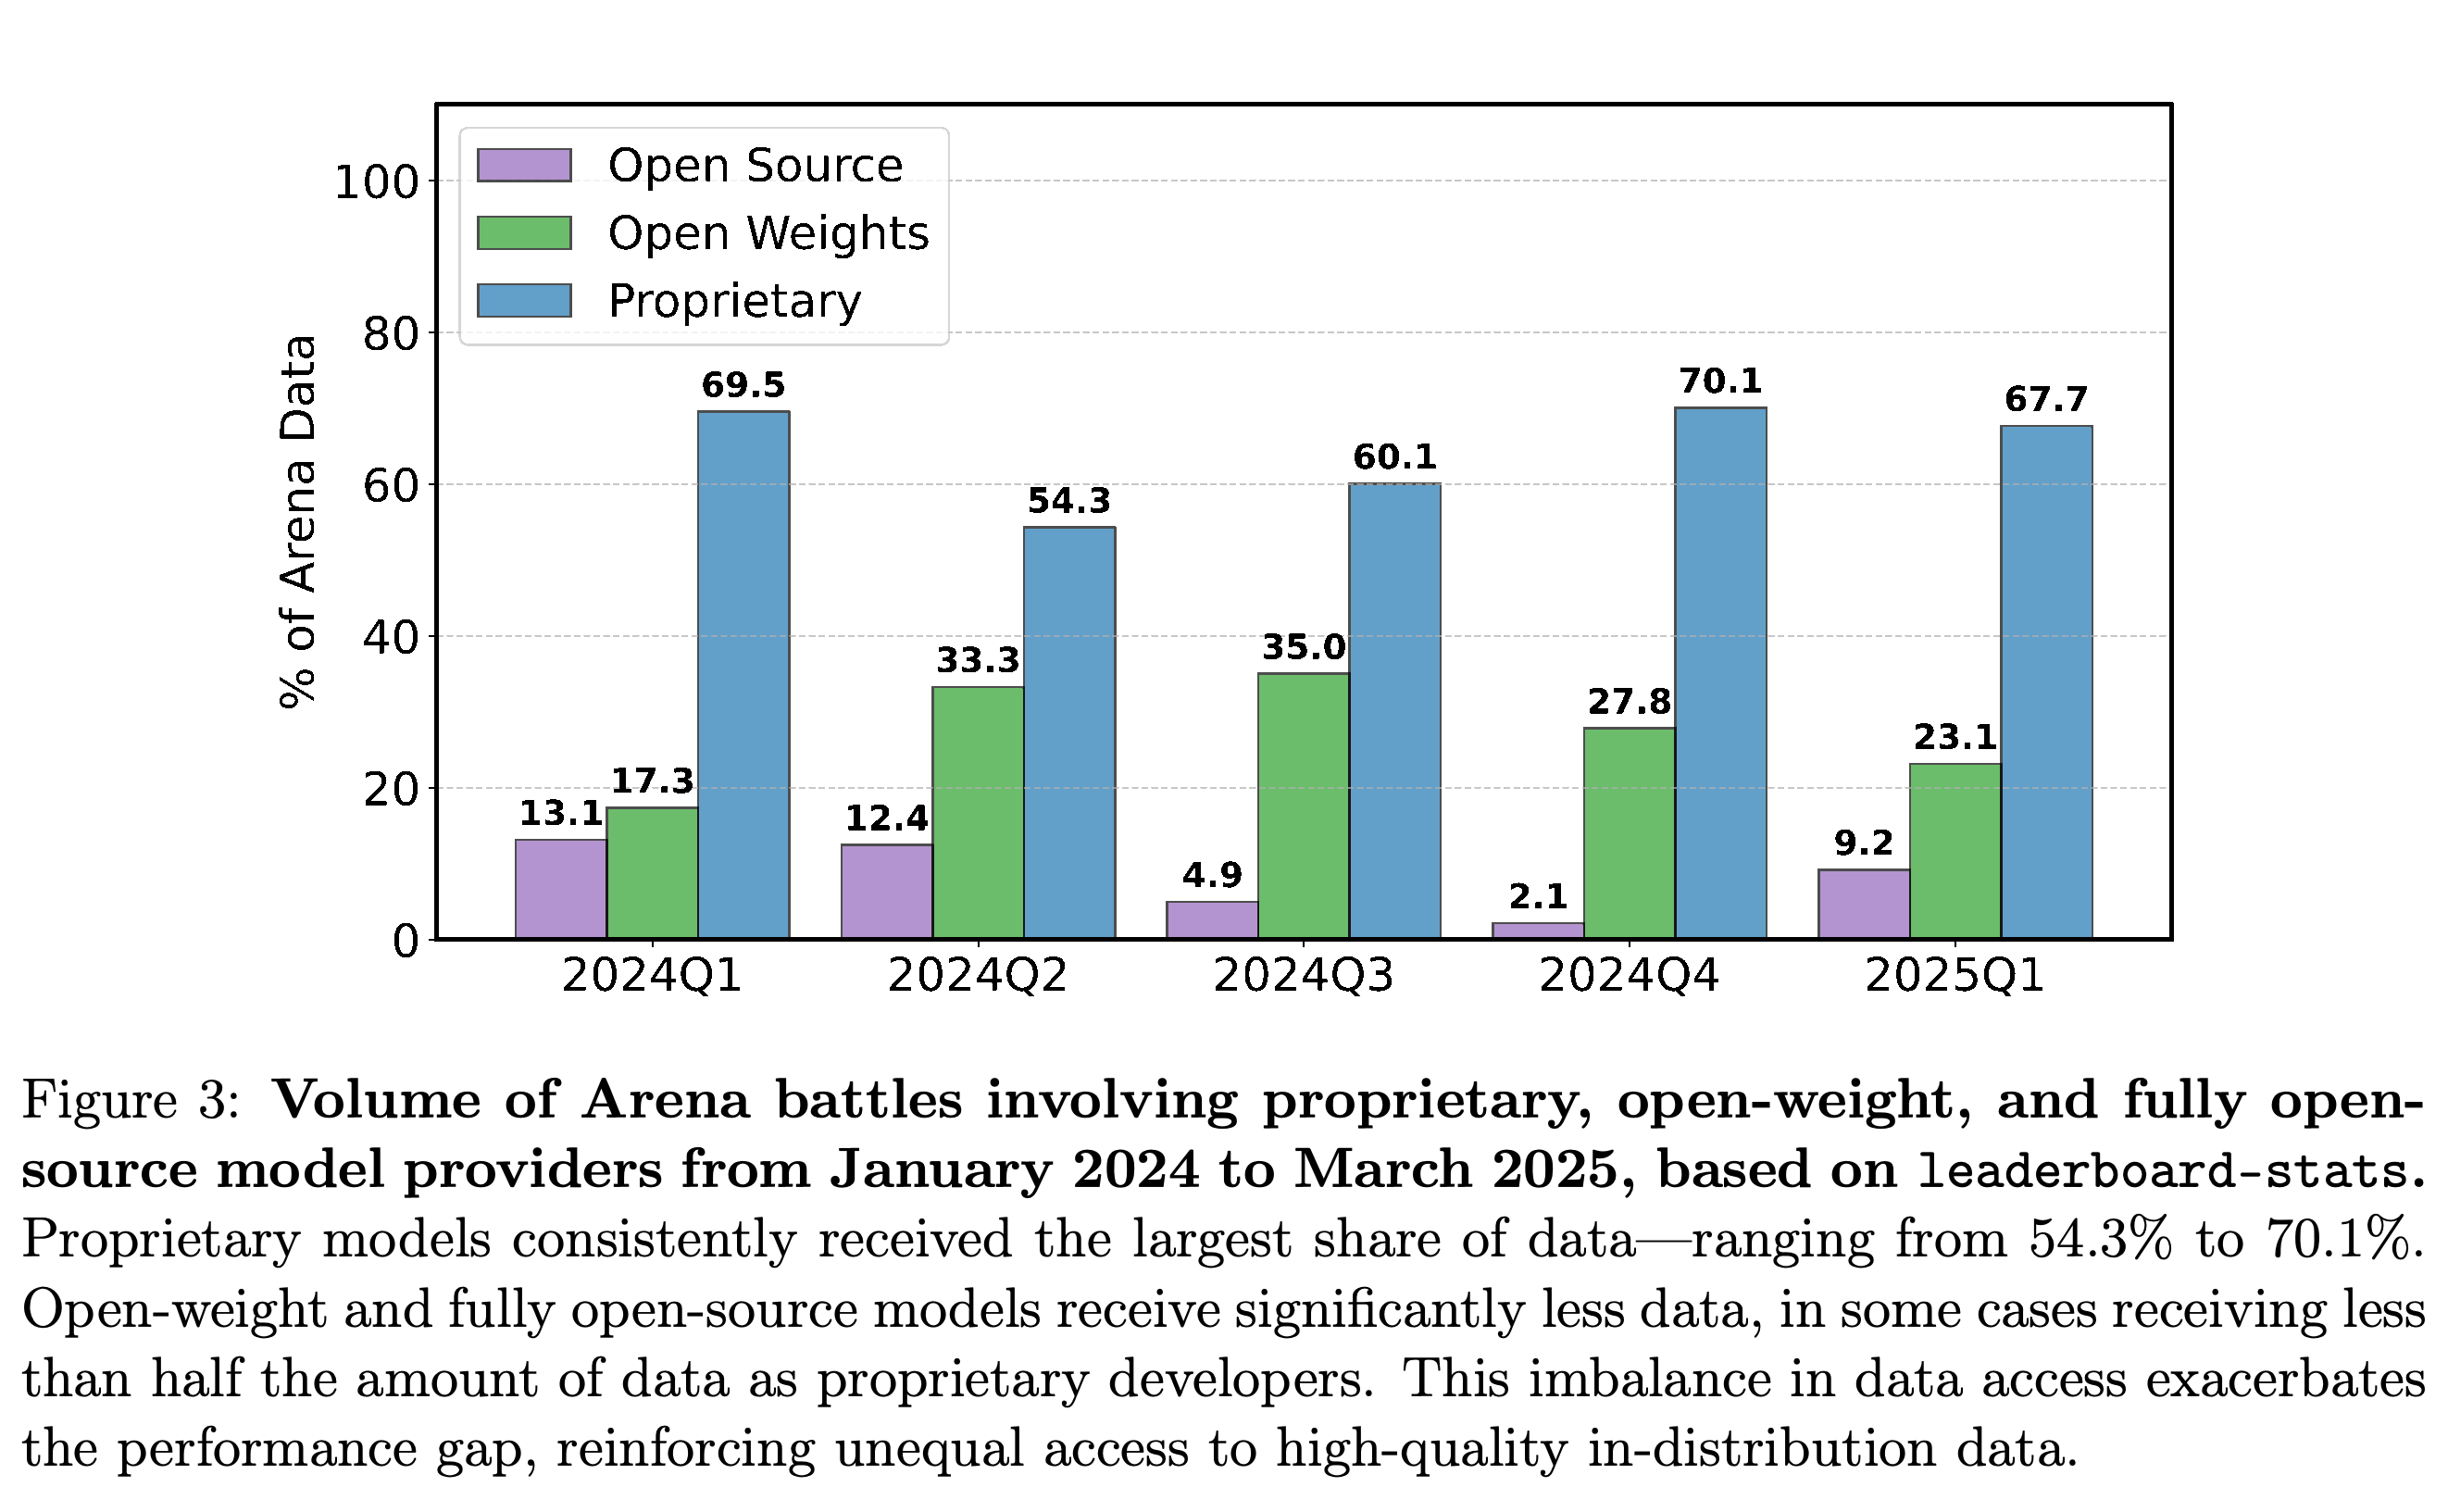
그림 3. 2024년 1월부터 2025년 3월까지 모델 라이선스 범주별 분기 Arena 배틀 비중
2. The CoT Encyclopedia: Analyzing, Predicting, and Controlling how a Reasoning Model will Think
- https://arxiv.org/abs/2505.10185
- The CoT Encyclopedia: Analyzing, Predicting, and Controlling how a Reasoning Model will Think 요약 설명
- The CoT Encyclopedia: Analyzing, Predicting, and Controlling how a Reasoning Model will Think는 생성된 응답에서 서로 대립하는 전략 설명을 추출하고, 비슷한 설명을 묶은 뒤 응답 행동을 분류할 평가 기준인 루브릭을 만든다. 주요 문제 해결 분석에서는 기준 4,057개를 여섯 차원으로 압축한다. 응답 100개를 대상으로 한 사람 평가에서 이 방법의 분석을 긍정적으로 평가한 비율은 92%이며, 사전에 정의한 행동을 사용한 분석은 51%다. 이 평가는 분석이 타당해 보이는지를 측정한다.
- 처음에 정답을 낸 질문으로 학습한 분류기가 처음에 틀린 질문에 적용할 전략 지시를 선택한다. 보고된 전체 정확도는 추론 벤치마크인 GPQA-Diamond에서 72.7%에서 81.0%로, 지식 벤치마크인 MMLU-Redux에서 88.9%에서 92.3%로, 수학 벤치마크인 MATH-500에서 78.2%에서 80.7%로 높아진다. 이 집계는 기존에 정답이었던 응답을 유지하고 수정에 성공한 응답을 추가한다. 따라서 이 실험은 들어오는 모든 질문에 지시를 적용했을 때의 효과를 측정하지 않는다.
- 학습 데이터의 제시 형식도 측정된 응답 행동을 바꾼다. 지시 이행 벤치마크인 Arena-Hard에서 객관식 데이터로 학습한 모델의 평균 생성 길이는 1301토큰이며, 자유 형식 데이터로 학습한 모델은 2561토큰이다. 토큰은 생성된 텍스트를 세는 단위다. 여러 접근법을 사용하는 비율은 각각 75.4%와 57.4%다. 두 모델의 가중치를 선형 보간하면 추가 학습 없이 전략 분포가 바뀌지만, 논문은 중간 혼합 모델의 정확도나 안전성이 개선되었다는 결과를 보고하지 않는다.
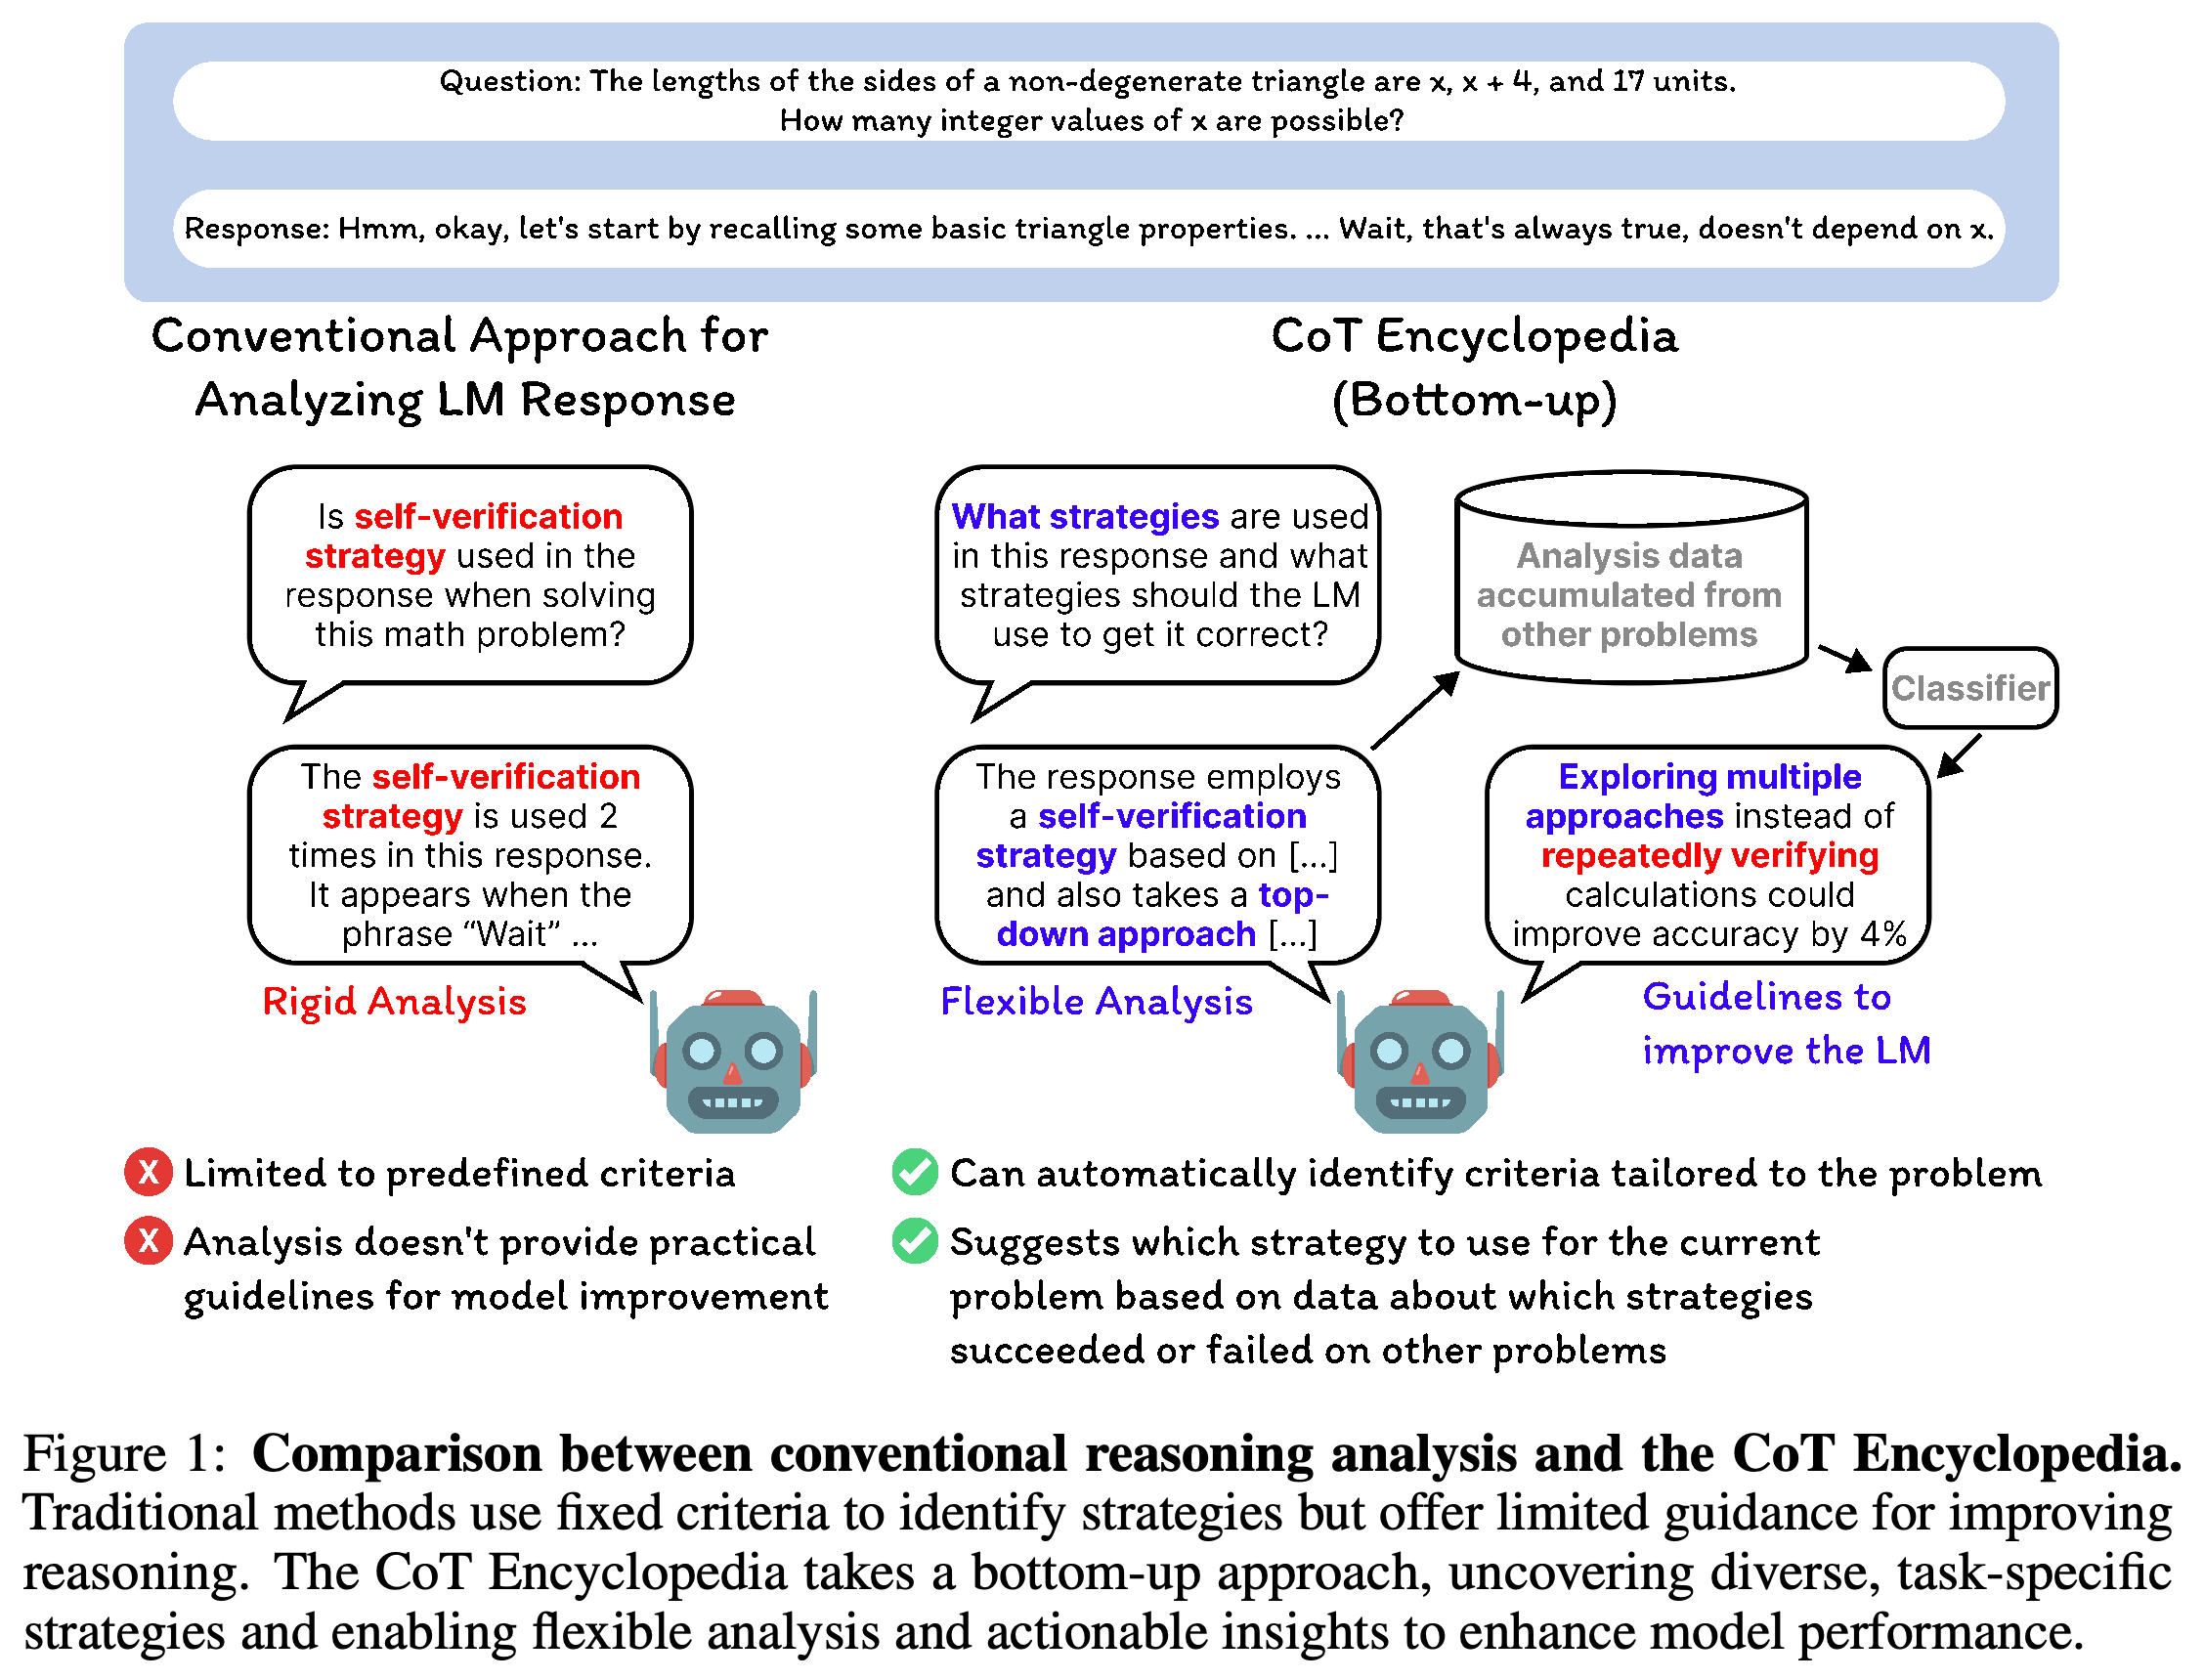
그림 1. 고정 기준 추론 분석과 상향식 CoT Encyclopedia 접근법의 비교
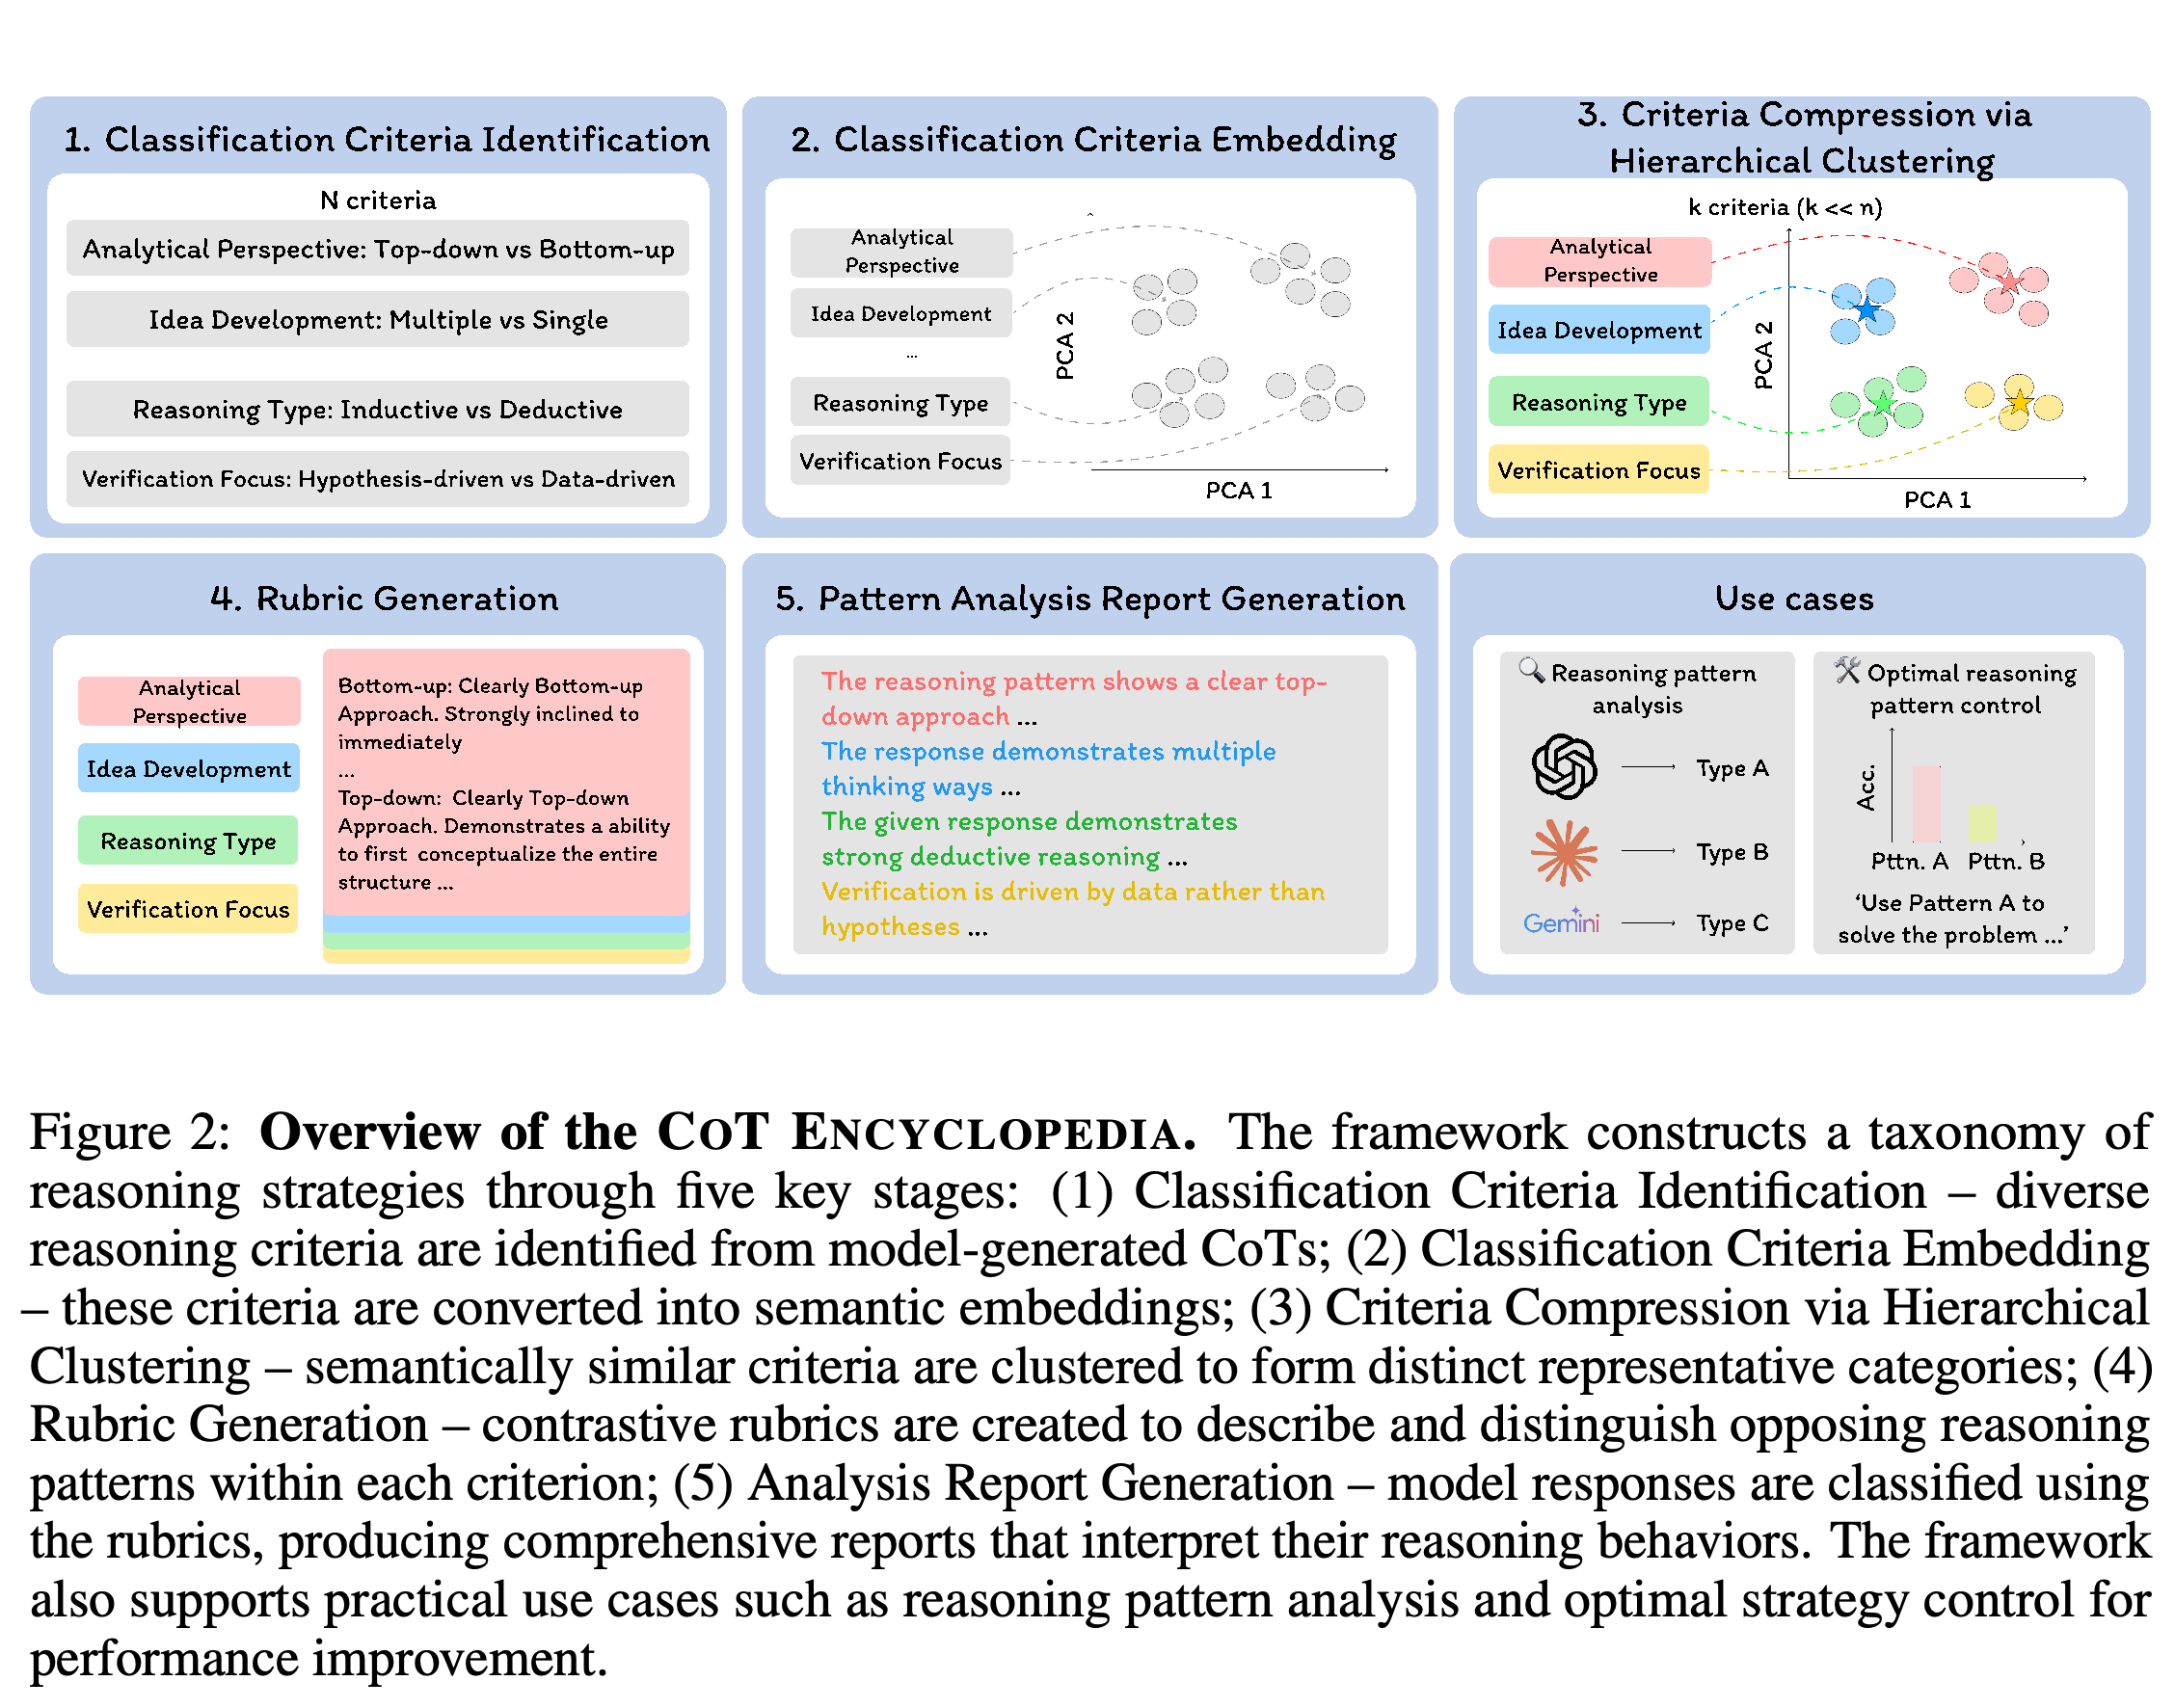
그림 2. 기준 식별부터 추론 패턴 분석과 후속 활용까지의 CoT Encyclopedia 절차
3. J1: Incentivizing Thinking in LLM-as-a-Judge via Reinforcement Learning
- https://arxiv.org/abs/2505.10320
- J1: Incentivizing Thinking in LLM-as-a-Judge via Reinforcement Learning 요약 설명
- J1: Incentivizing Thinking in LLM-as-a-Judge via Reinforcement Learning은 선호 응답과 비선호 응답으로 구성된 합성 선호 쌍 22K개로 평가 모델을 학습한다. 학습에는 응답 순서 두 가지를 모두 포함하며, 응답 두 개를 함께 비교하는 pairwise 평가와 각 응답에 독립적으로 점수를 부여하는 pointwise 평가를 결합한다. 보상은 구성한 선호 레이블을 기준으로 판정이 맞는지 확인한다. 주관적인 프롬프트에서는 이 레이블이 인간의 선호를 반영하는지 독립적으로 확인하지 않는다.
- Pairwise 평가에서 J1-Qwen-32B-MultiTask는 검증 가능한 응답 쌍으로 구성된 벤치마크인 Preference Proxy Evaluations(PPE) Correctness에서 정확도 76.8%를 기록한다. Qwen3-32B의 66.5%보다 10.3%포인트 높다. 각각의 지표를 사용하는 벤치마크 다섯 개에서 보고된 종합 점수는 80.8이며, Qwen3-32B는 77.3, DeepSeek-R1-671B는 78.4다. 이 벤치마크 중 하나인 RewardBench는 모델 선택 기준으로도 사용된다.
- 응답 순서를 바꿔 확인하면 남아 있는 한계가 드러난다. 멀티태스크 모델의 pairwise 정확도는 응답 순서 두 가지에서 각각 76.8%와 76.2%지만, 두 순서 모두에서 정답을 요구하면 67.0%에 그친다. Pointwise 평가의 position-consistent accuracy는 70.6%이며, 동점 비율은 10.5%다. 응답 순서를 바꾼 뒤 선호 응답이 달라지는 비율인 pairwise verdict-flip 비율은 17.0%로 남는다. 이 결과들은 응답 순서가 바뀌어도 판정이 유지되는지를 별도의 운영 요건으로 확인할 근거가 된다. 논문은 추론 생성이나 추가 샘플링에 따른 지연 시간과 비용을 비교하지 않는다.
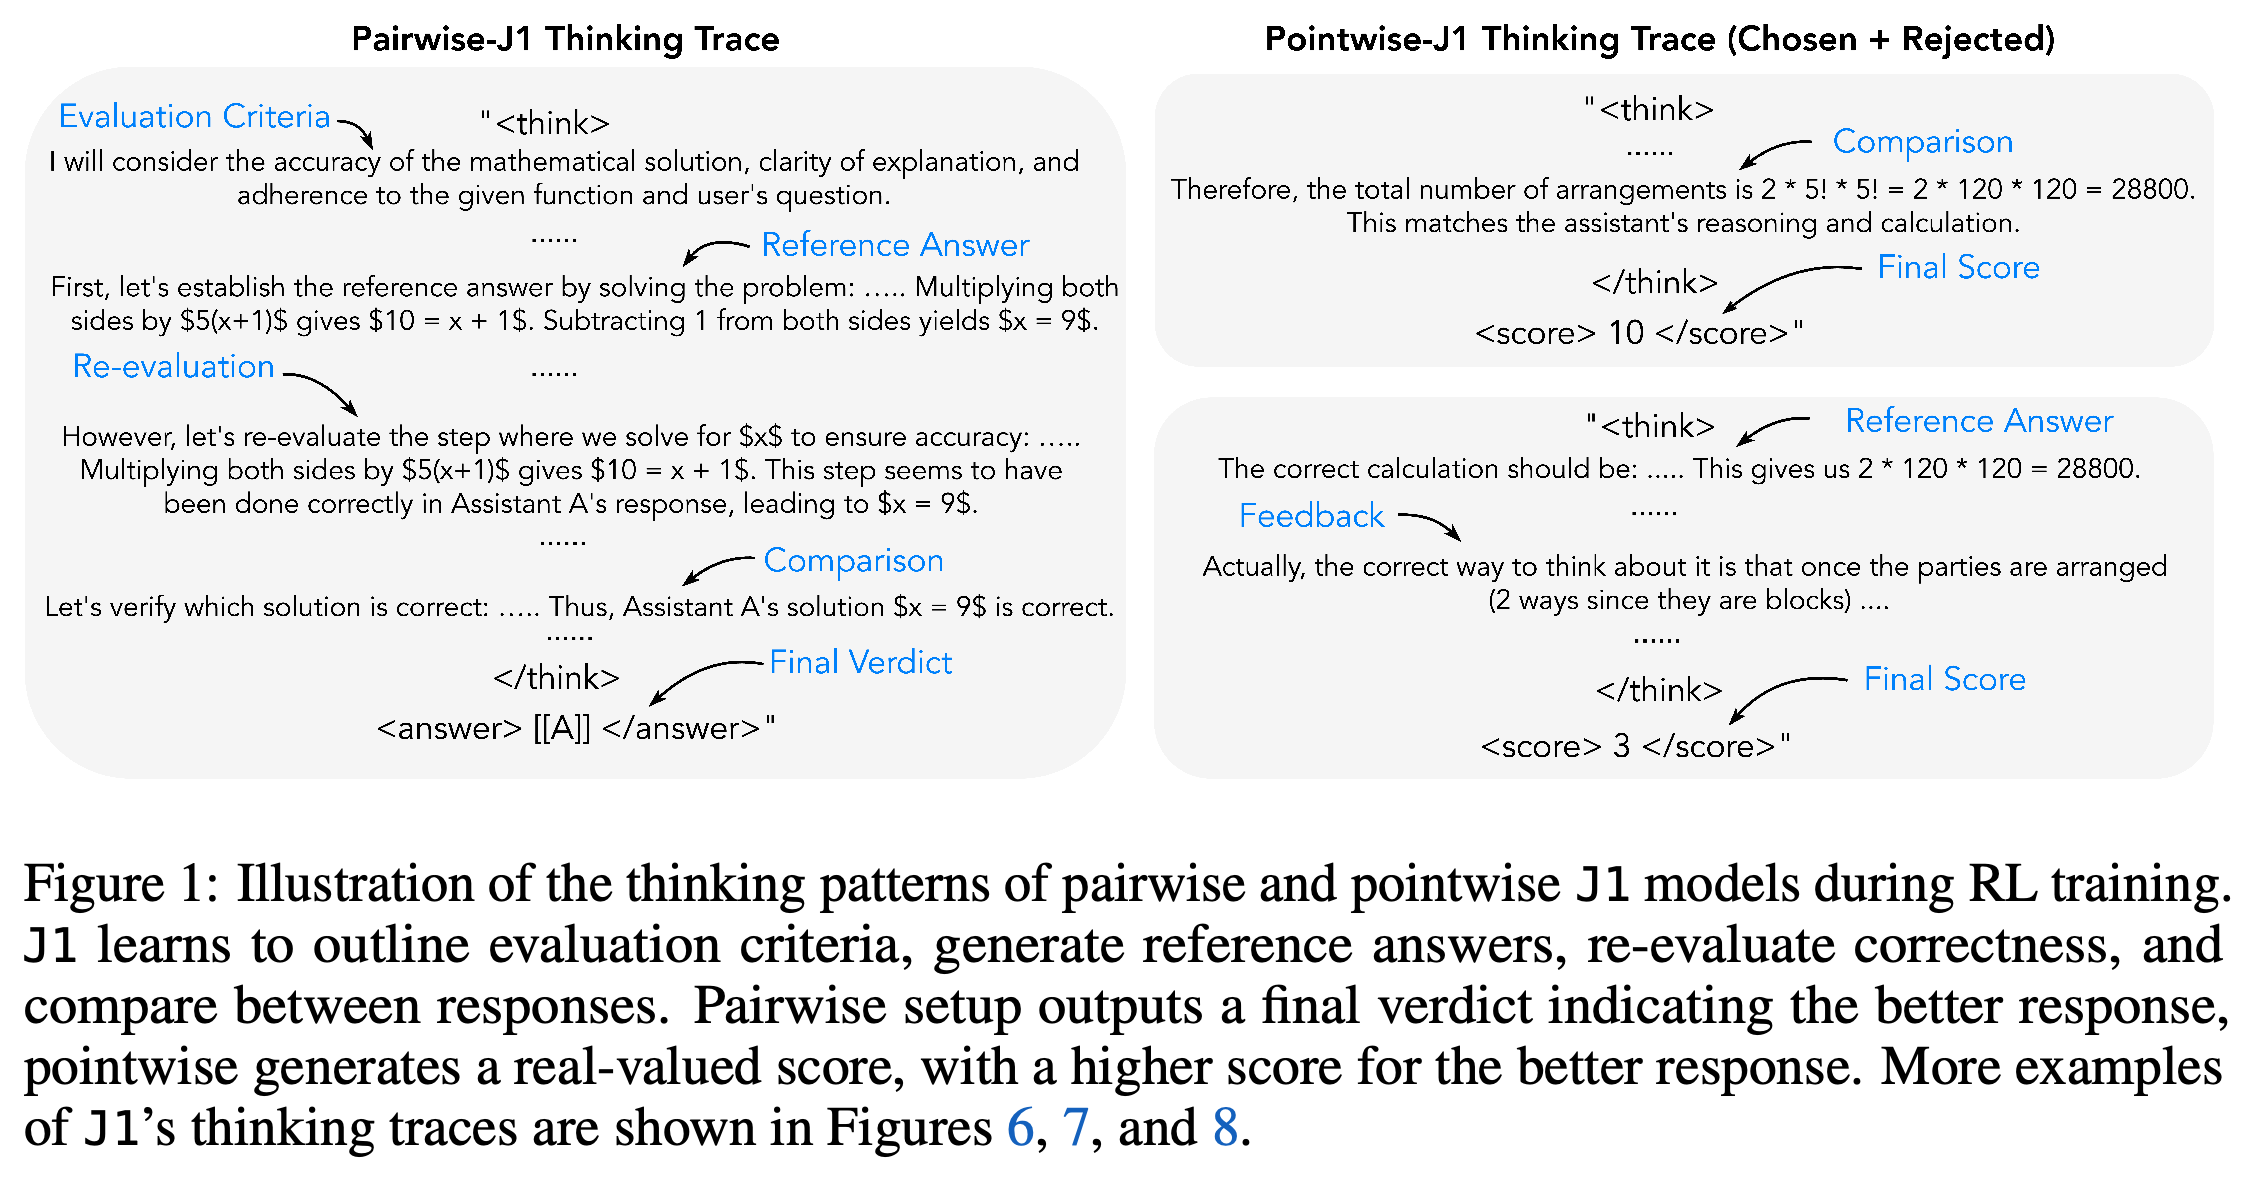
그림 1. 강화학습 중 pairwise 및 pointwise J1 추론 과정 예시
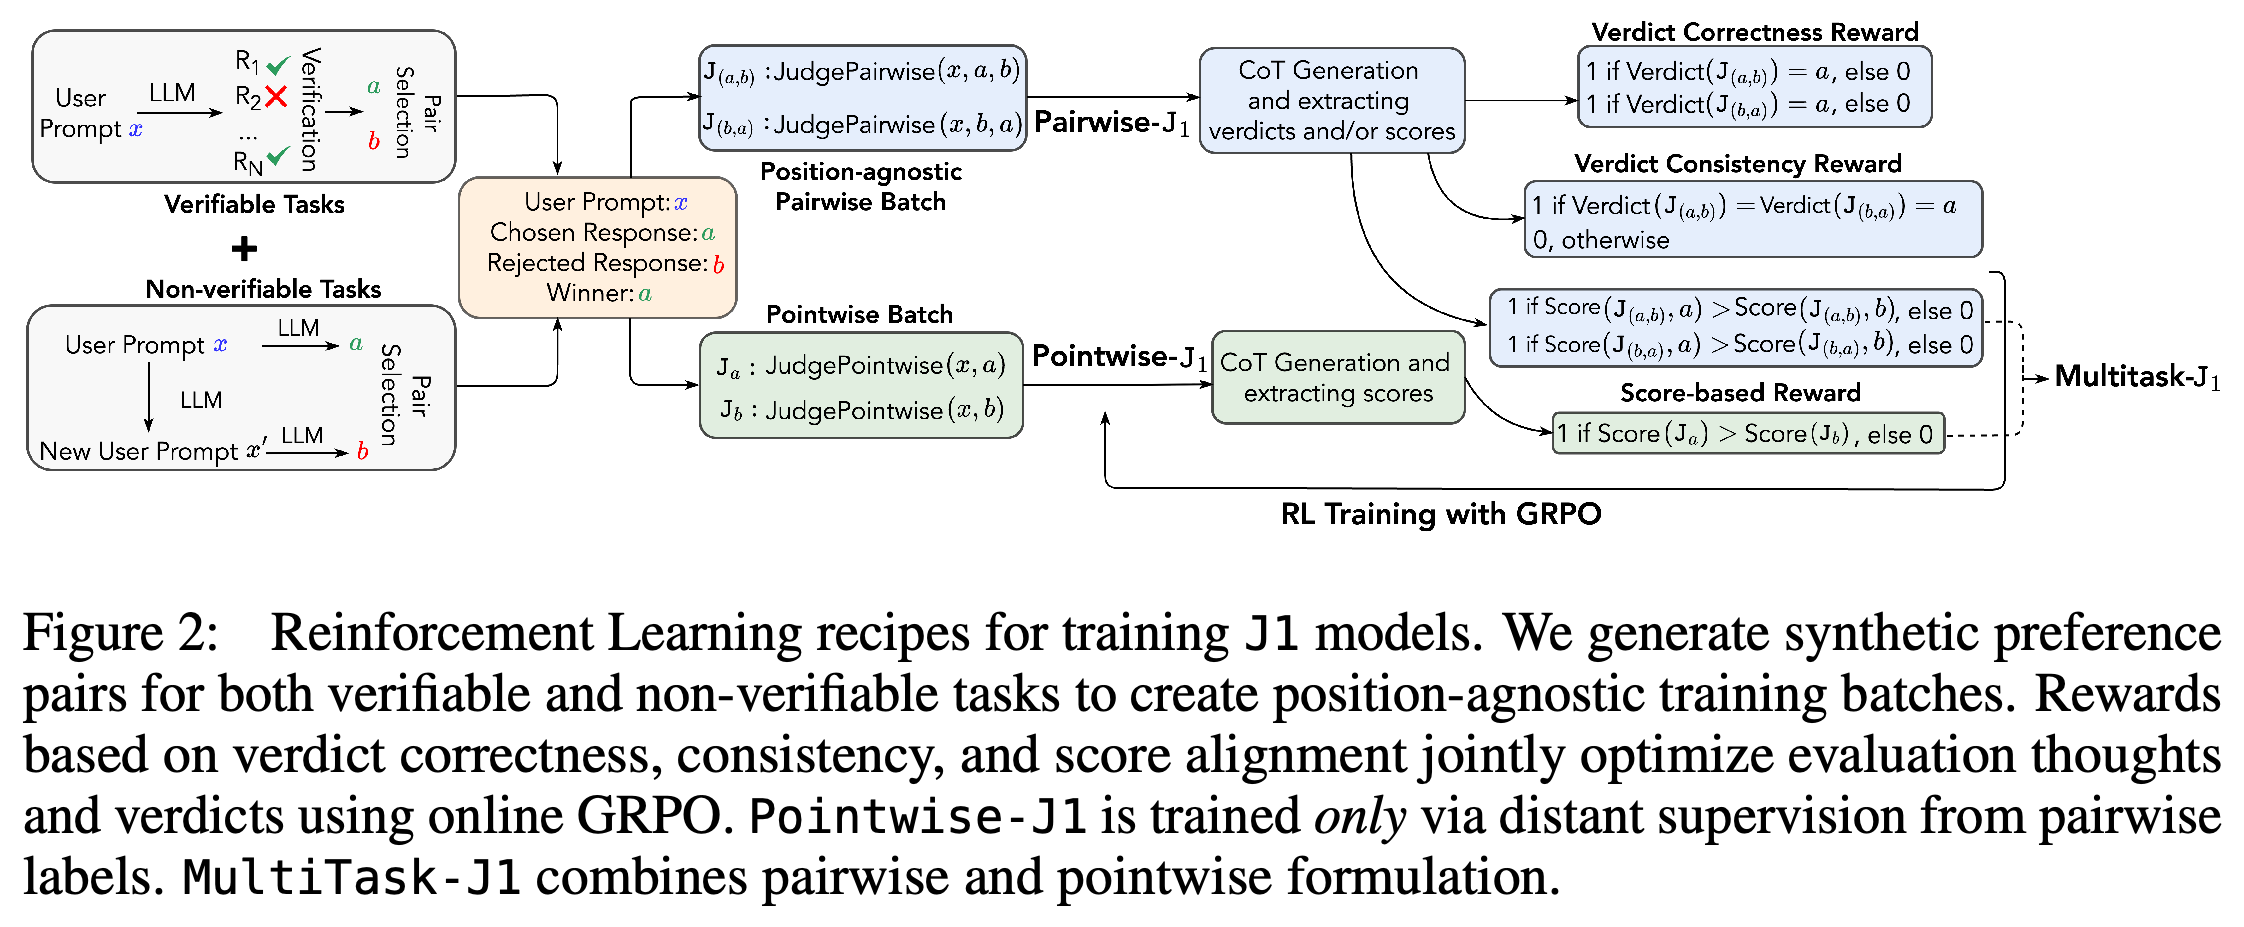
그림 2. J1 변형의 합성 선호 데이터, 보상 계산과 GRPO 학습
출처
[2] The CoT Encyclopedia: Analyzing, Predicting, and Controlling how a Reasoning Model will Think
[3] J1: Incentivizing Thinking in LLM-as-a-Judge via Reinforcement Learning