


2025년 7월 AI 논문 동향
31 Jul 2025 | Paper Review Monthly Papers Reasoning Model Safety Local Inference Efficiency Reinforcement Learning목차
이달의 트렌드
2025년 7월의 주제는 모델 설계가 실제 사용 환경의 신뢰성에 미치는 영향이며, 선정된 3편의 논문은 아키텍처와 학습이 추론의 가시성, 로컬 실행 효율, 보상 기반 학습의 안정성을 어떻게 바꾸는지 살펴본다. 답변이나 행동 전에 생성하는 중간 추론 텍스트인 chain of thought(CoT)는 일부 유해한 의도를 드러낼 수 있다. SmallThinker는 선택적 연산을 메모리 제약을 고려한 실행 방식과 연결하고, Group Sequence Policy Optimization(GSPO)은 보상 기반 업데이트의 단위를 응답 전체에 맞춘다. 이 연구들은 모델의 행동을 평가할 때 그 행동을 생성하고 실행하는 메커니즘도 함께 살펴야 한다는 근거를 제시한다. 1, 2, 3 chain of thought(CoT)에 대해서는 The CoT Encyclopedia: Analyzing, Predicting, and Controlling how a Reasoning Model will Think 요약 설명 글을 참조하라.
토큰마다 전문가 네트워크 일부만 활성화하는 Mixture-of-Experts(MoE)는 배포 효율과 학습 안정성을 연결한다. SmallThinker는 attention 전에 전문가를 선택하여 attention 연산 중에 저장장치에서 가중치를 가져오고, 선택한 전문가 내부의 비활성 뉴런을 활용해 연산을 줄인다. GSPO는 선택적 연산에서 발생하는 다른 문제를 다룬다. 학습 업데이트 후 전문가 선택이 달라지면 토큰 확률이 변동할 수 있다. 이전 전문가 선택을 재사용하지 않고도 안정적으로 학습했다는 결과는, 실험한 조건에서 최적화 규칙이 라우팅에 특화된 안정화 장치에 대한 의존도를 줄일 수 있음을 시사한다. Mixture-of-Experts(MoE)에 대해서는 Expert Race: A Flexible Routing Strategy for Scaling Diffusion Transformer with Mixture of Experts 요약 설명 글을 참조하라.
제시된 근거는 특정 조건에서의 공학적 개선을 뒷받침한다. SmallThinker의 디코딩 속도 향상은 메모리 제약이 엄격할 때 가장 크며, 큰 모델은 가중치를 메모리에 모두 올린 PC 실험에서 비교 모델보다 느리다. GSPO는 학습 연산량과 사용한 쿼리 수를 맞춘 비교에서 더 나은 학습 곡선을 보이지만, 구체적인 연산 예산이나 반복 실행에 따른 불확실성은 제시하지 않는다. CoT 논문은 새로운 실험 없이 기존 모니터링 결과를 종합하며, 학습이나 아키텍처가 바뀌면 읽고 이해할 수 있는 추론 기록이 사라질 수 있다고 경고한다. 따라서 효율, 안정성, 모니터링은 실제로 사용할 운영 조건에서 평가해야 한다.
2025년 7월의 주요 논문
1. Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety
- https://arxiv.org/abs/2507.11473
- Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety 요약 설명
- Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety는 중간 추론을 자동으로 검사하면 행동만으로는 놓치는 부적절한 행동을 탐지할 수 있는지 살펴본다. 기존 연구를 인용하며, 새로운 실험이나 모니터링 방법 간의 정량적 비교는 제시하지 않는다.
- 핵심은 필요성과 성향을 구분하는 데 있다. 모델은 과제를 풀기 위해 중간 추론을 텍스트로 작성해야 할 수도 있고, 내부 계산만으로 진행할 수 있는데도 작성할 수 있다. 생성한 텍스트는 충분히 긴 순차 계산에서 작업 기억 역할을 할 수 있다. 그러나 어느 조건도 유해한 추론이 기록에 나타나거나 이해 가능한 형태로 유지된다고 보장하지는 않는다.
- 모니터링 가능성은 최종 결과에 보상을 주는 결과 기반 강화학습(RL), 중간 추론을 직접 조정하는 과정 감독, 간접적인 최적화 압력, 중간 계산을 연속적인 내부 표현으로 수행하는 잠재 추론 아키텍처로 인해 약해질 수 있다. 이는 저자들이 제안한 저하 메커니즘이며, 각각의 영향이 얼마나 큰지는 밝혀지지 않았다.
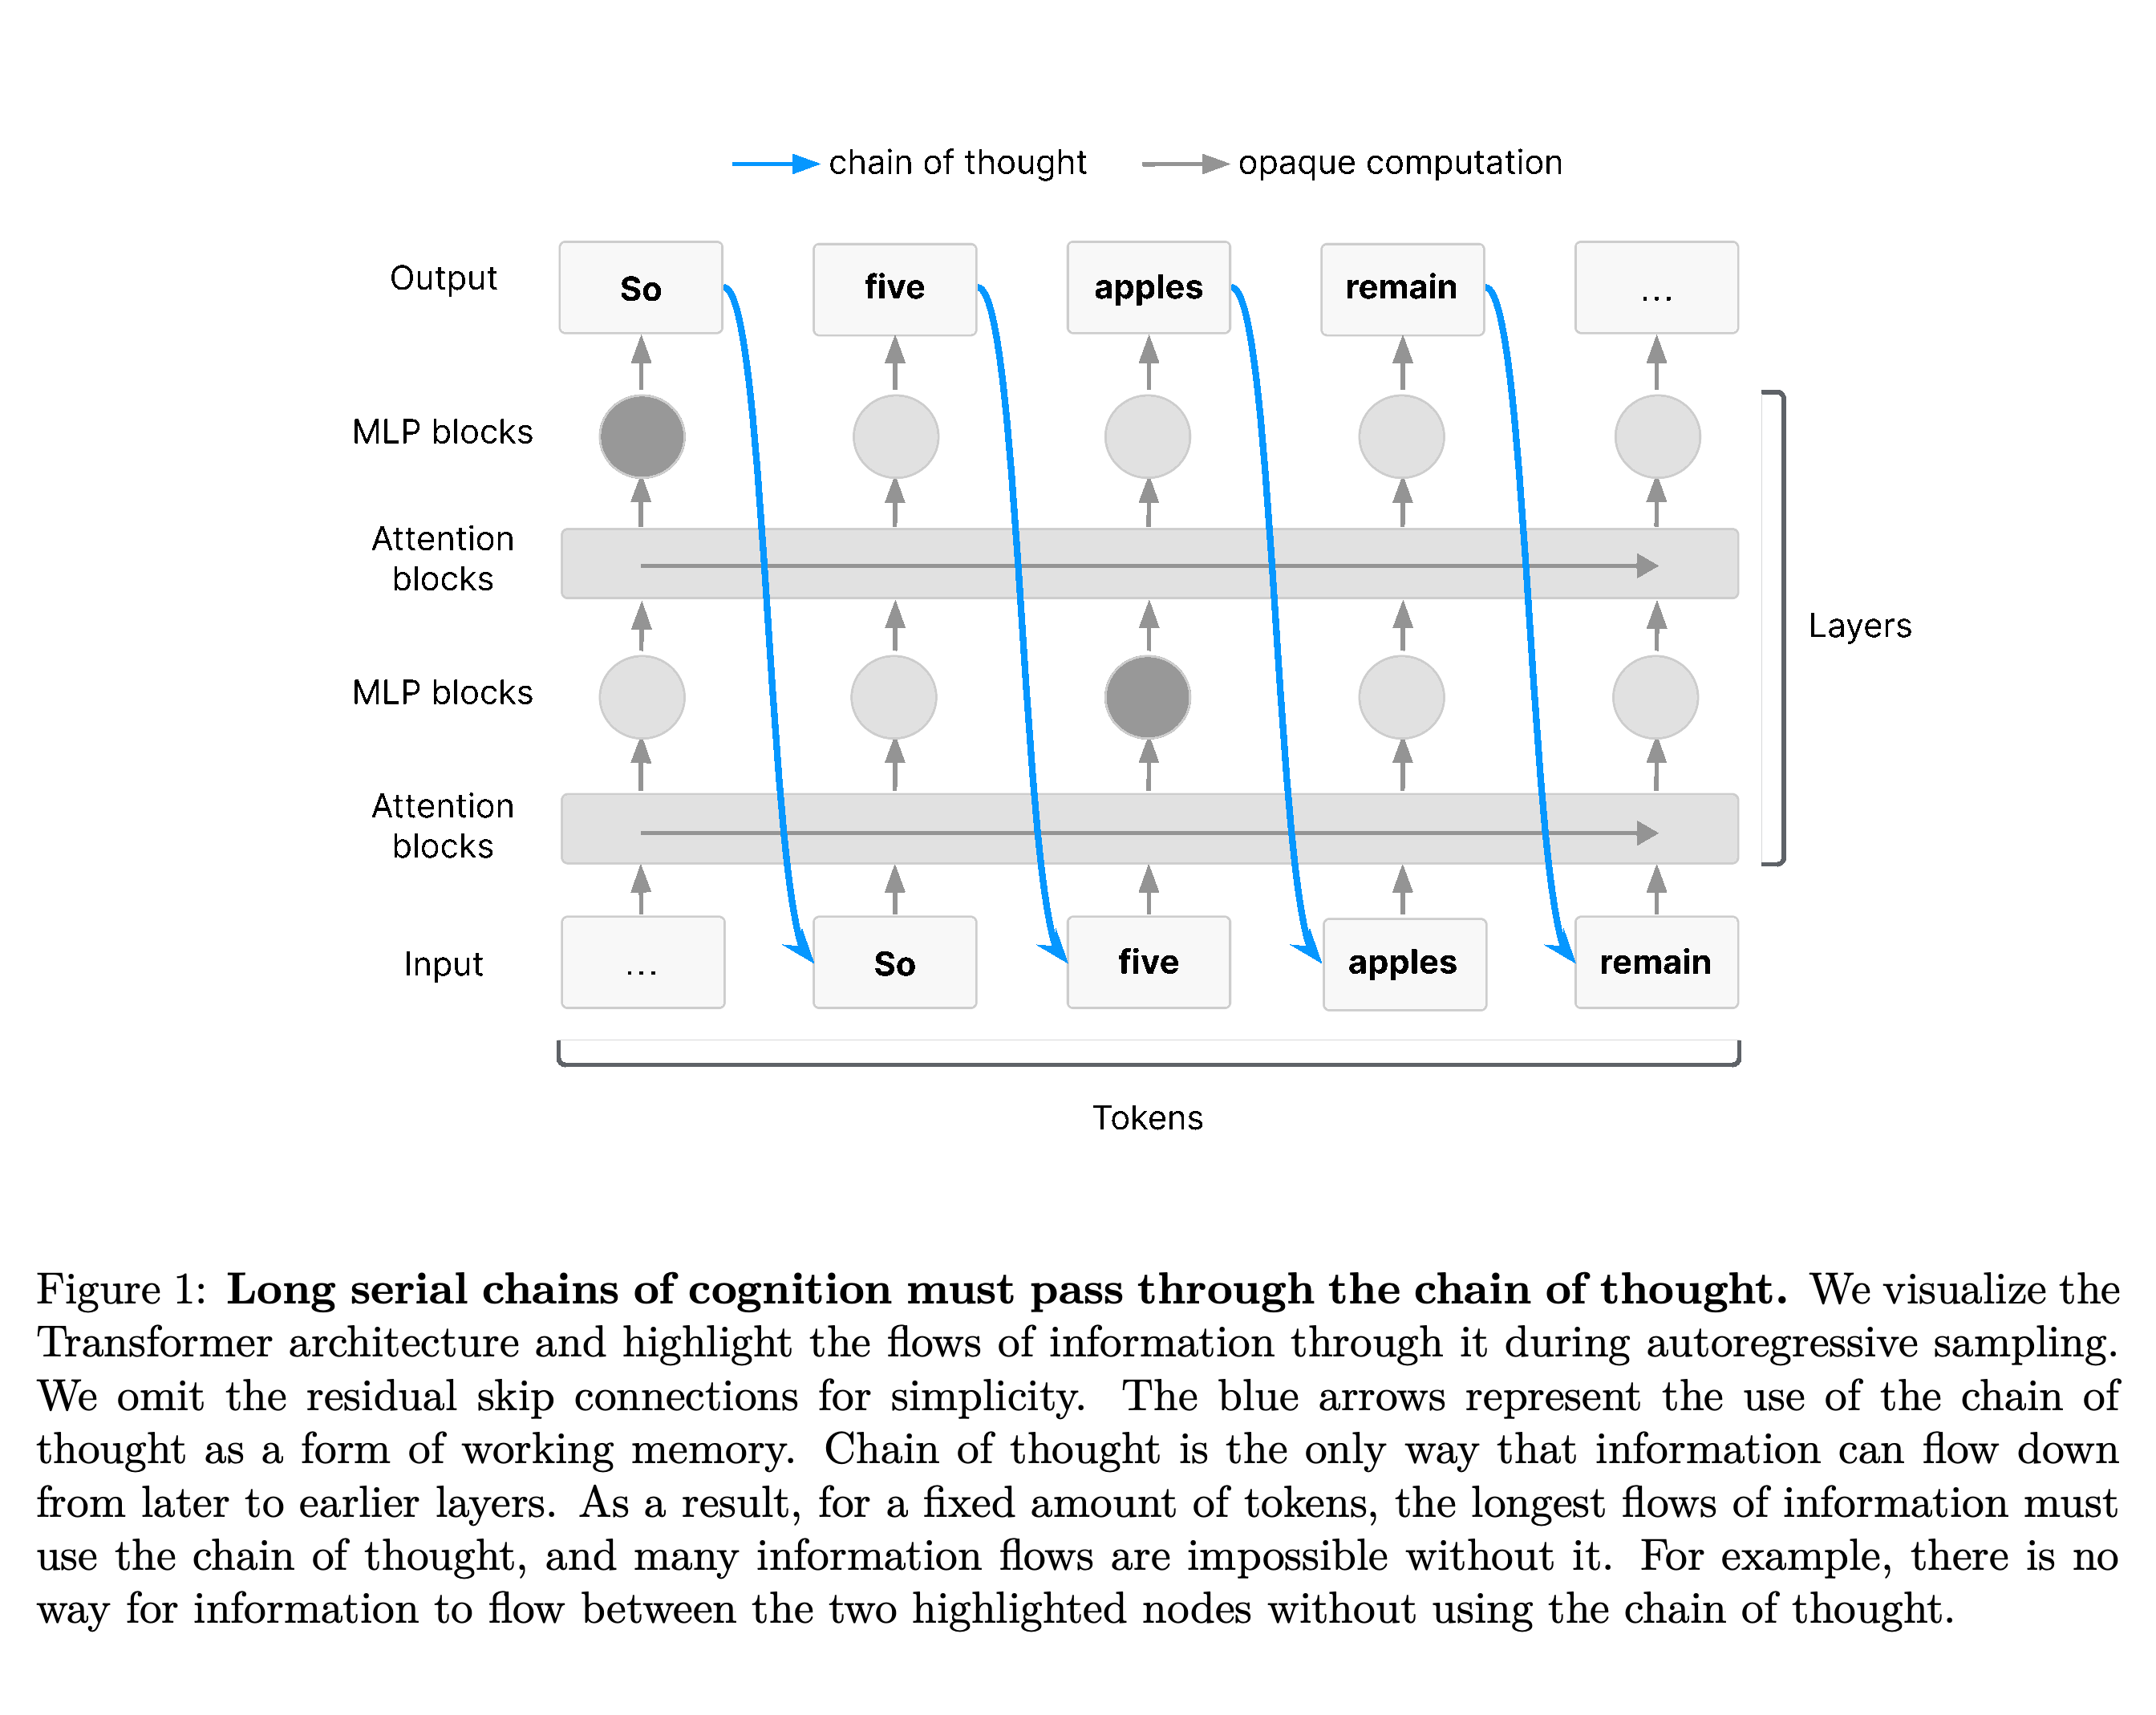
자기회귀 생성 중 Transformer의 정보 흐름: 사고 과정 피드백과 불투명한 내부 계산의 구분, 잔차 스킵 연결 생략
2. SmallThinker: A Family of Efficient Large Language Models Natively Trained for Local Deployment
- https://arxiv.org/abs/2507.20984
- SmallThinker: A Family of Efficient Large Language Models Natively Trained for Local Deployment 요약 설명
- SmallThinker: A Family of Efficient Large Language Models Natively Trained for Local Deployment는 전문가 선택, 전문가 내부의 비활성 뉴런, 조기 라우팅, 전역 및 지역 attention의 혼합을 결합한다. 조기 라우팅은 전문가 가중치 로딩을 attention 연산과 겹쳐 수행하도록 한다. 지역 attention은 생성 중 사용하는 attention 상태를 저장하는 key-value(KV) 캐시를 줄인다.
- 측정에 사용한 추론 시스템 PowerInfer와 저정밀 가중치 형식인 Q4_0 양자화를 적용했을 때, SmallThinker-21B-A3B는 8 GiB 메모리 제한을 둔 i9 14900K PC에서 20.30 tokens/s를 기록한다. 같은 조건에서 Qwen3-30B-A3B는 10.11 tokens/s를 기록한다. 일반 지식을 평가하는 MMLU 점수는 각각 84.4와 85.1이다. 가중치를 메모리에 모두 올리면 PC 처리량의 순위가 바뀌어 각각 30.19와 33.52 tokens/s를 기록한다.
- 21B 모델에서 보고된 가장 큰 속도 향상은 8 GiB 제한을 둔 OnePlus 13에서 나타난다. 처리량은 비교 모델의 0.18 tokens/s에 비해 15.50 tokens/s로, 약 86.1배다. 개별 변경의 효과를 분리하는 구성요소별 제거 실험이 없고, 프롬프트 길이, 생성 길이, 배치 크기, 스레드 설정, 저장장치 특성, 측정 변동성을 명시하지 않아 향상의 원인을 구분하고 재현하는 데 한계가 있다.
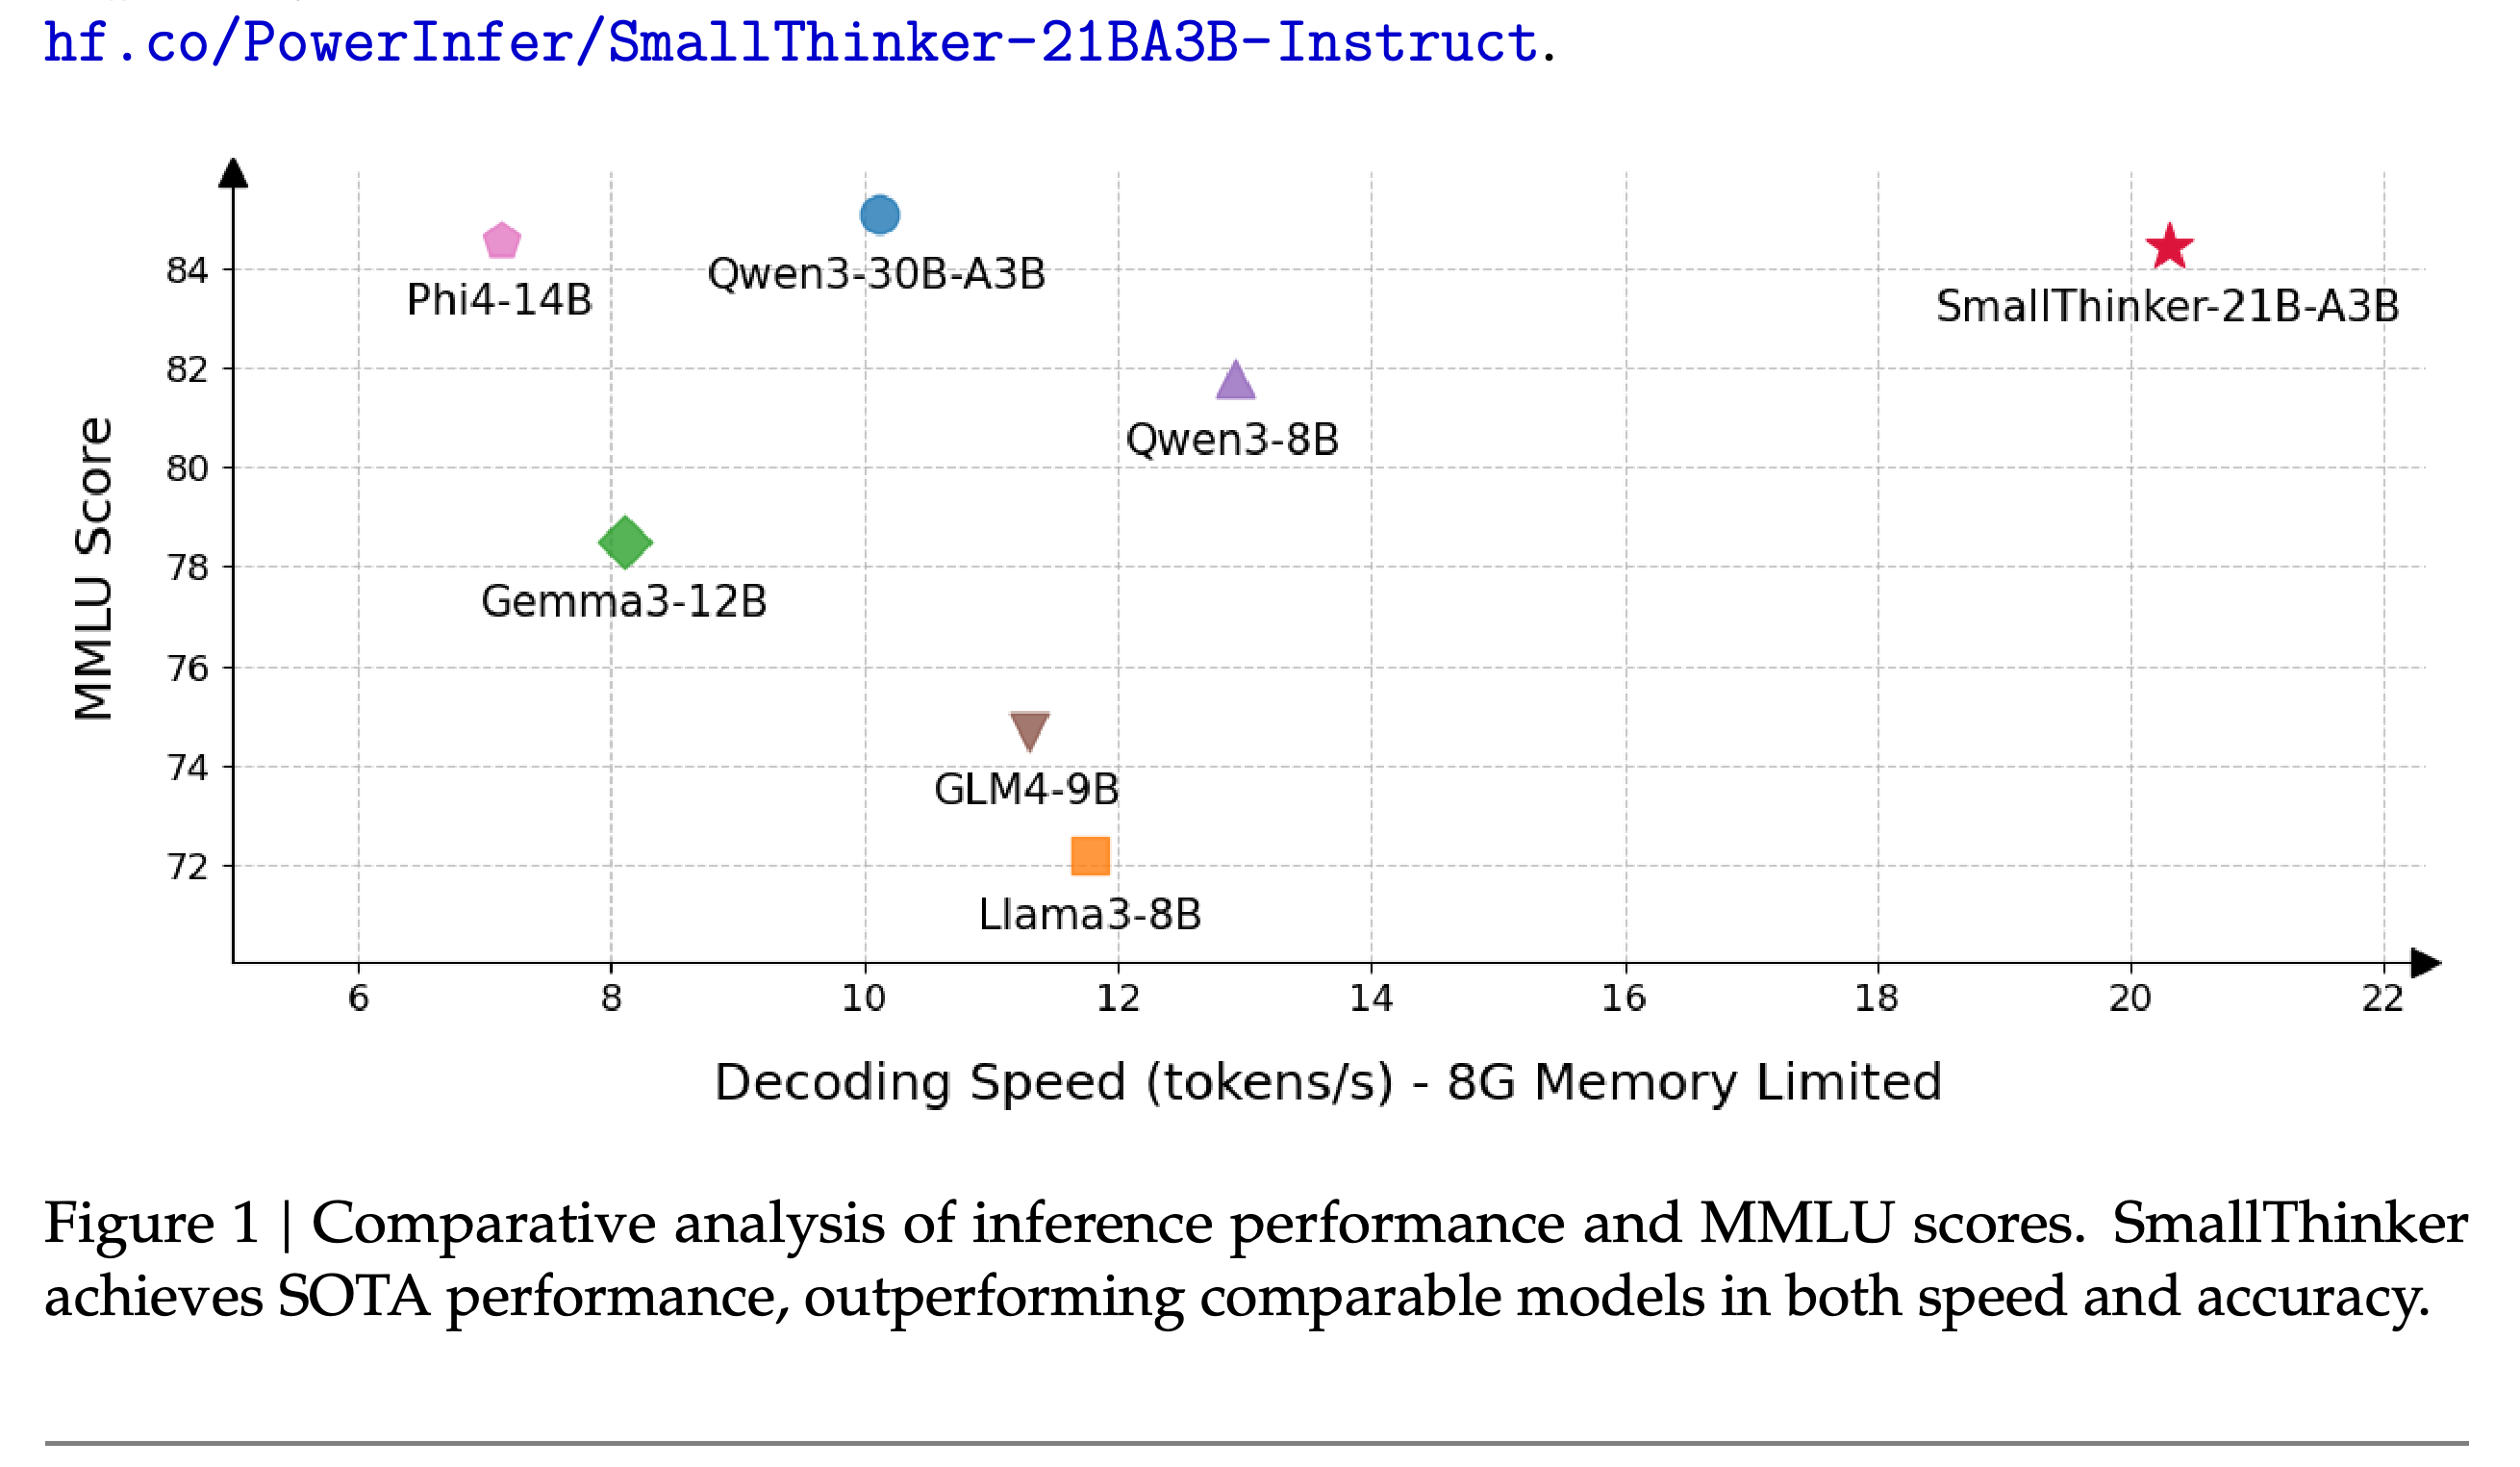
그림에 명시된 8G 메모리 제한에서의 MMLU 점수와 디코딩 속도 비교
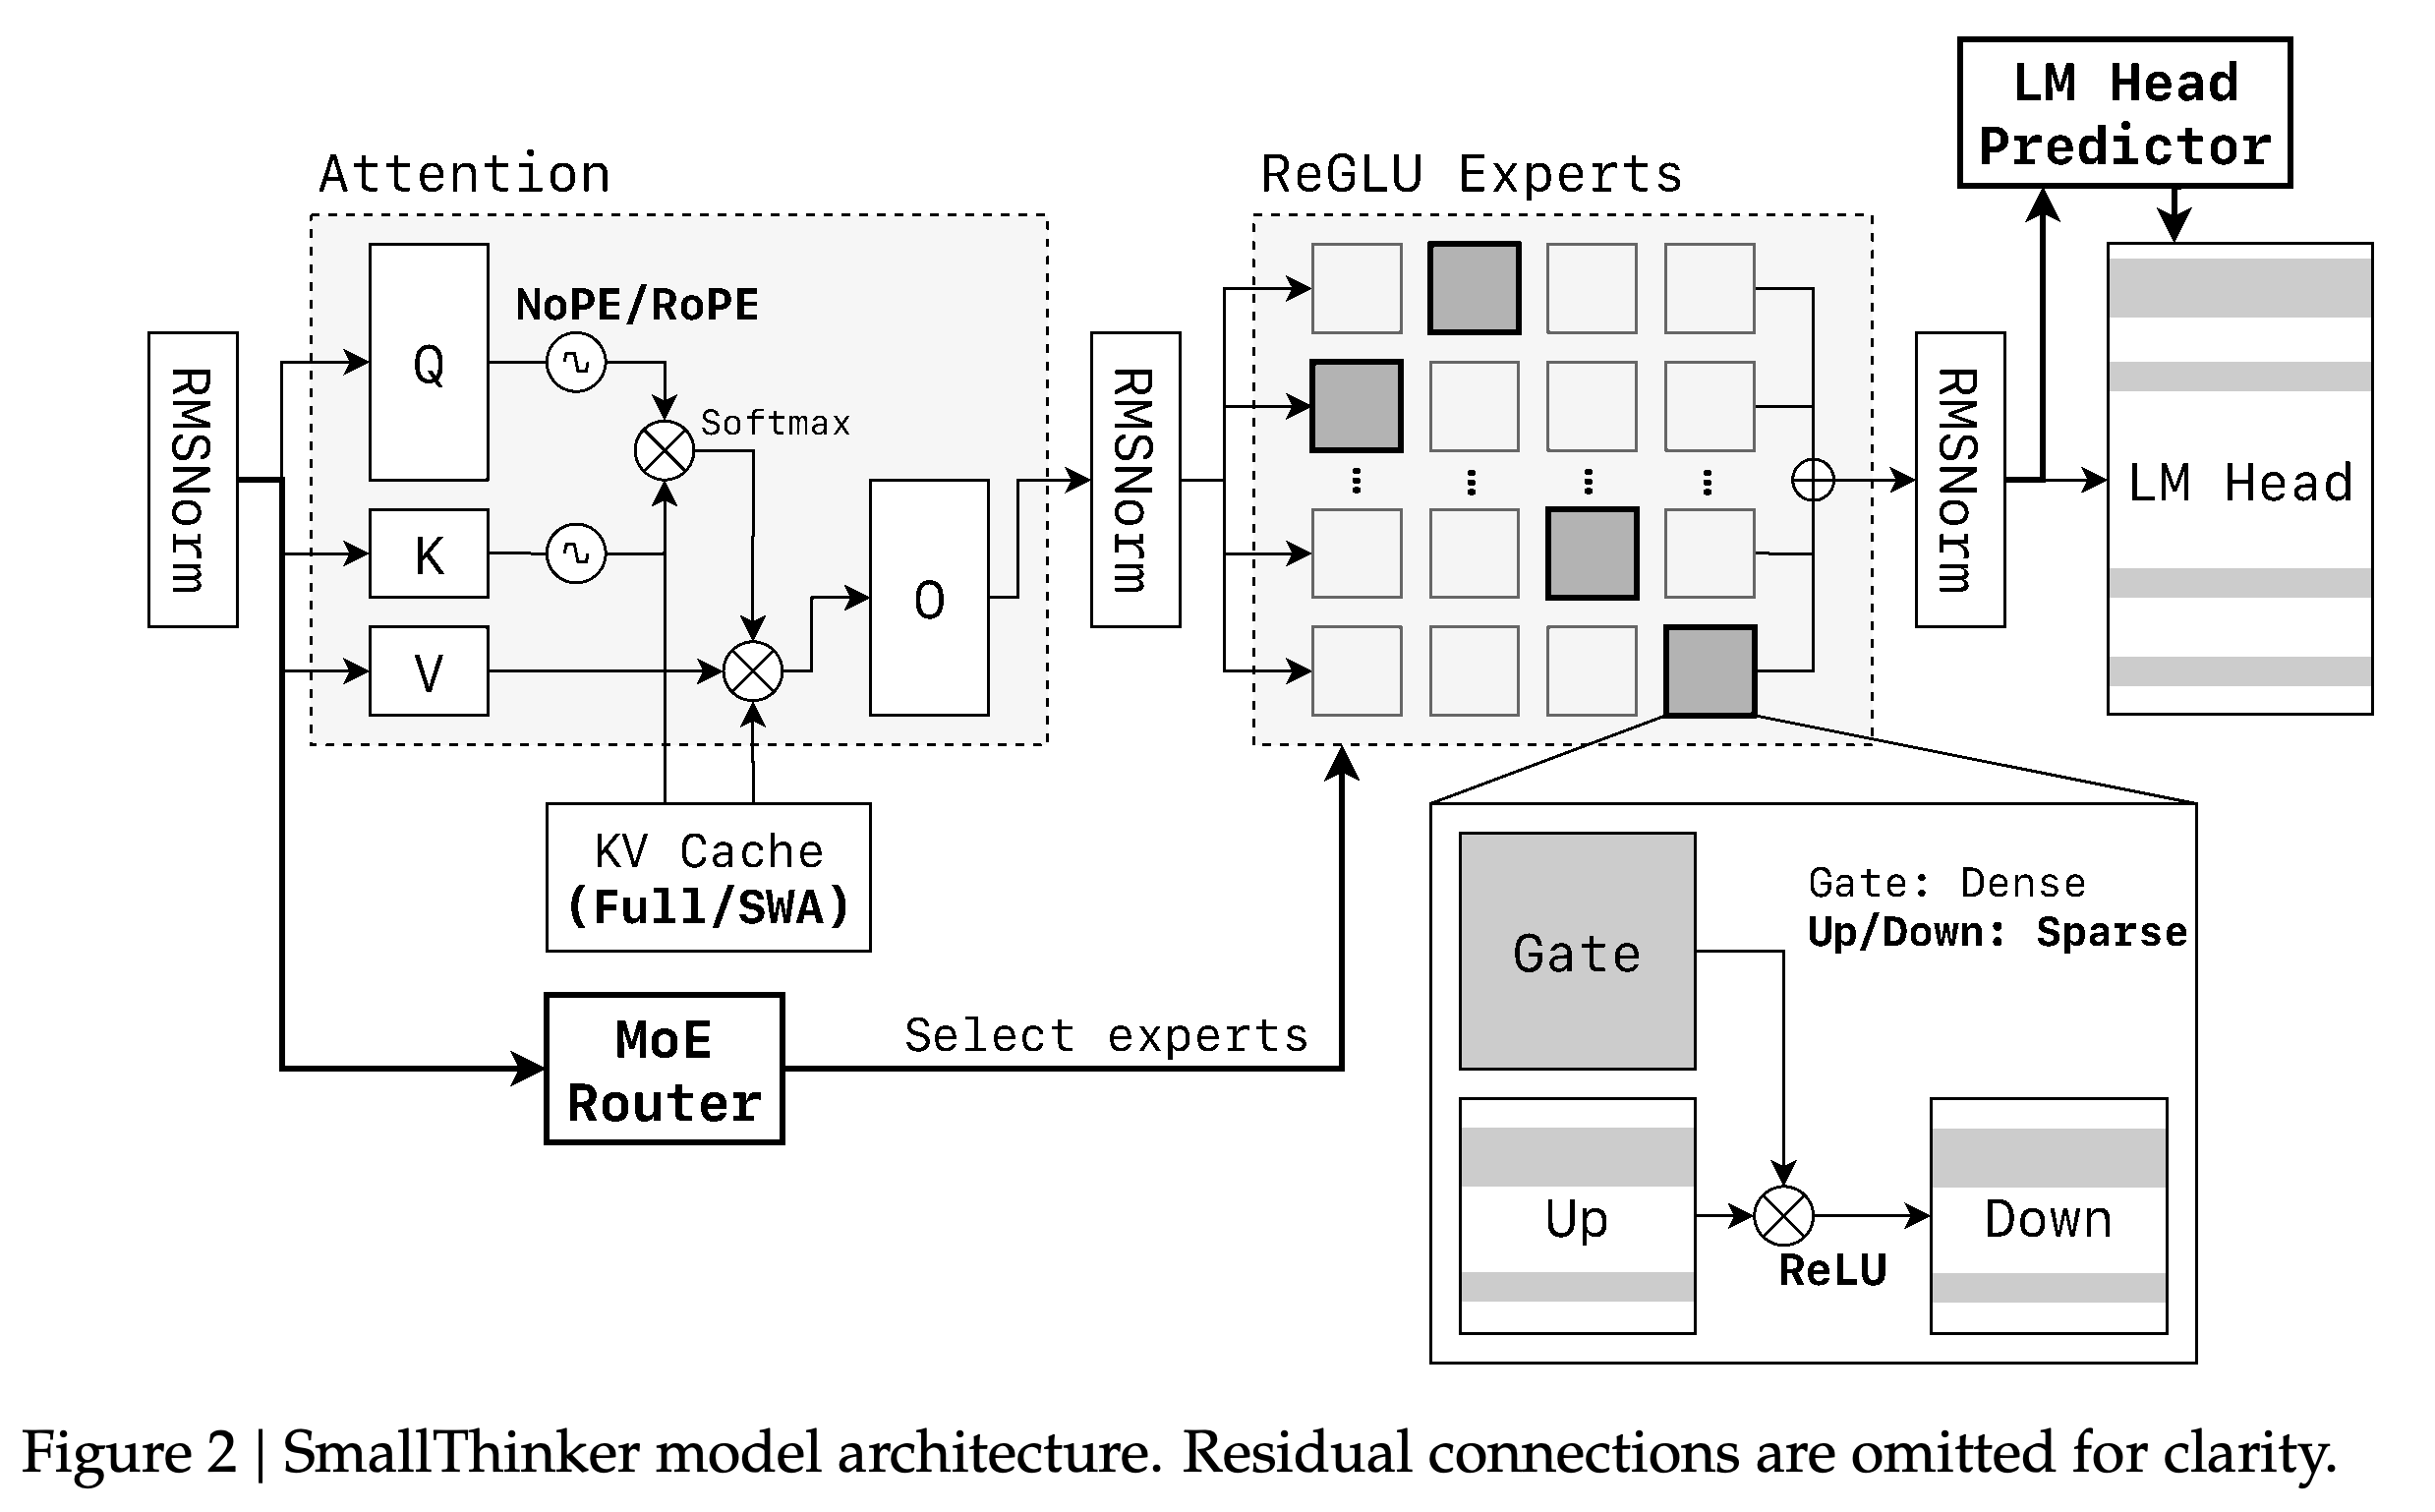
잔차 연결을 생략하고 조기 라우팅, 혼합 attention, 희소 expert, language model head 예측을 나타낸 SmallThinker 아키텍처
3. Group Sequence Policy Optimization
- https://arxiv.org/abs/2507.18071
- Group Sequence Policy Optimization 요약 설명
- Group Sequence Policy Optimization은 같은 쿼리에 대한 응답 그룹 안에서 정규화한 보상과, 길이로 정규화한 응답 전체의 확률 비율을 사용한다. 이 비율은 현재 모델과 데이터를 생성한 모델 사이의 토큰별 확률 비율을 기하평균한 값이다. 비율이 임계값을 넘을 때 일부 업데이트를 억제하는 clipping은 개별 토큰이 아닌 응답 전체에 적용한다.
- Qwen3-30B-A3B-Base를 미세 조정한 모델에서 학습을 시작한 비교에서, GSPO는 학습 연산량과 사용한 쿼리 수를 맞췄을 때 토큰별 확률 비율을 사용하는 Group Relative Policy Optimization(GRPO)보다 높은 보상과 수학 및 프로그래밍 벤치마크 성능을 보인다. GRPO에는 데이터를 생성한 모델의 전문가 선택을 업데이트 중에 재사용하는 Routing Replay를 적용한다. 보고된 비교에서 GSPO는 이를 사용하지 않고도 안정적으로 학습한다.
- 평균 clipping 토큰 비율은 GSPO가 0.15, GRPO가 0.0013이지만, 보고된 학습 효율은 GSPO가 더 높다. 이 관찰은 해당 비교에서 경사 추정에 더 많은 토큰을 남기는 것만으로 학습이 더 잘된다고 보장할 수 없음을 보여준다. 다만 경사 잡음을 직접 측정한 결과는 아니다. 실험은 초기 모델 1개만 명시하며, 구체적인 연산량 척도, 반복 실행에 따른 불확실성, 실측한 인프라 절감량은 제공하지 않는다.
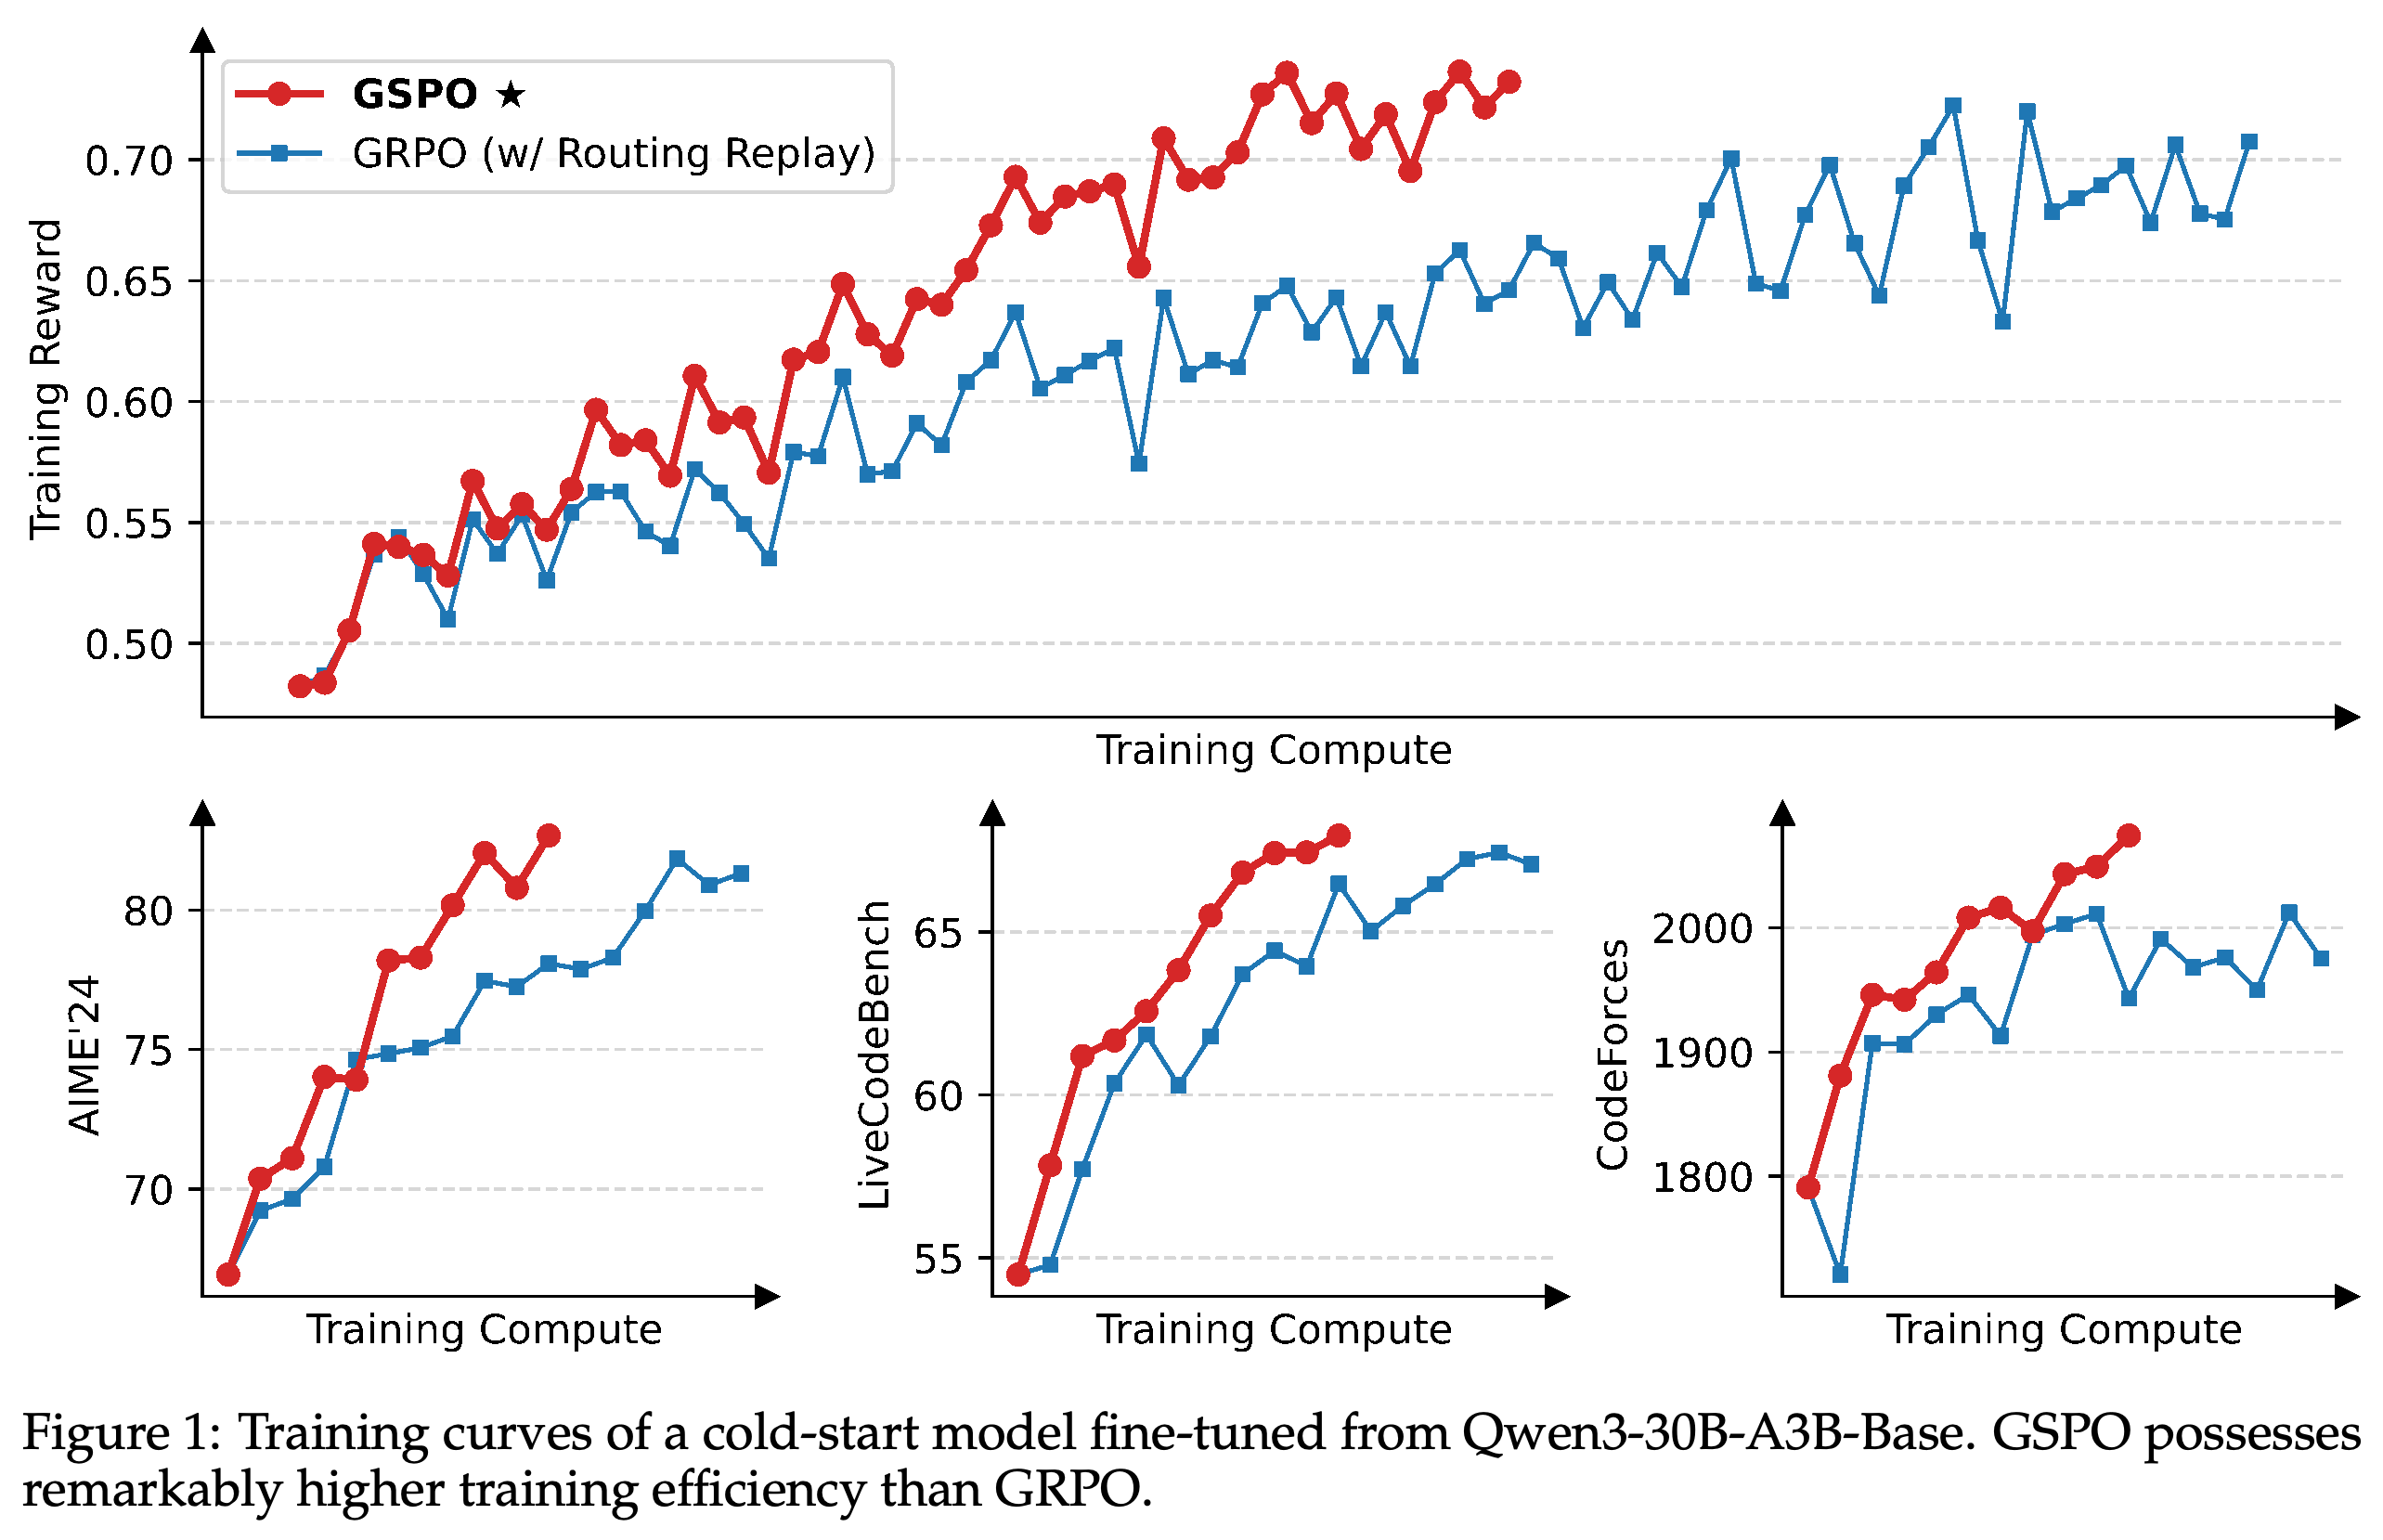
Qwen3-30B-A3B-Base를 미세 조정한 cold-start 모델에서 GSPO와 Routing Replay를 적용한 GRPO의 학습 연산량에 따른 학습 보상 및 벤치마크 성능 비교
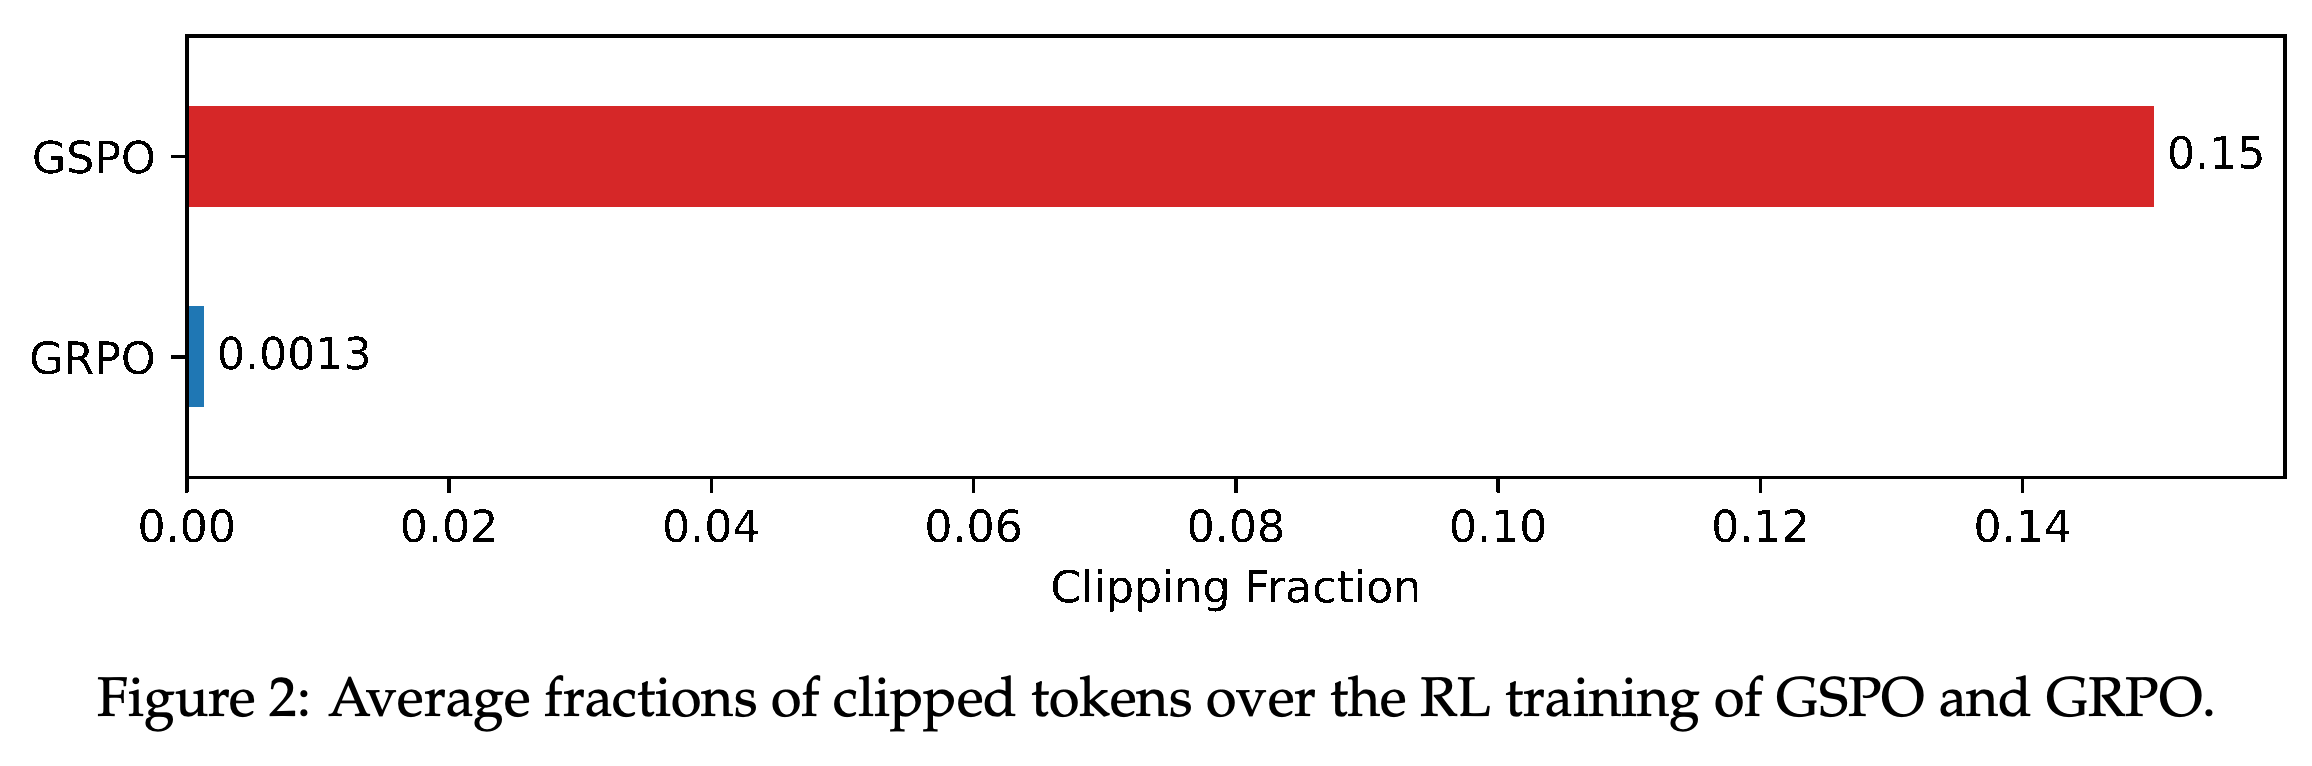
GSPO와 GRPO 강화학습 중 평균 clipping 토큰 비율
출처
[1] Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety
[2] SmallThinker: A Family of Efficient Large Language Models Natively Trained for Local Deployment