Stronger Normalization-Free Transformers 요약 설명
11 Dec 2025 | Paper Review Normalization Transformer Architectures Normalization-Free Training목차
이번 글에서는 Stronger Normalization-Free Transformers 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 11일(Arxiv)
- Chen, Mingzhi, Lu, Taiming, Zhu, Jiachen, Sun, Mingjie, Liu, Zhuang.
- Princeton University, New York University, Carnegie Mellon University
- 논문 링크
- Github
요약
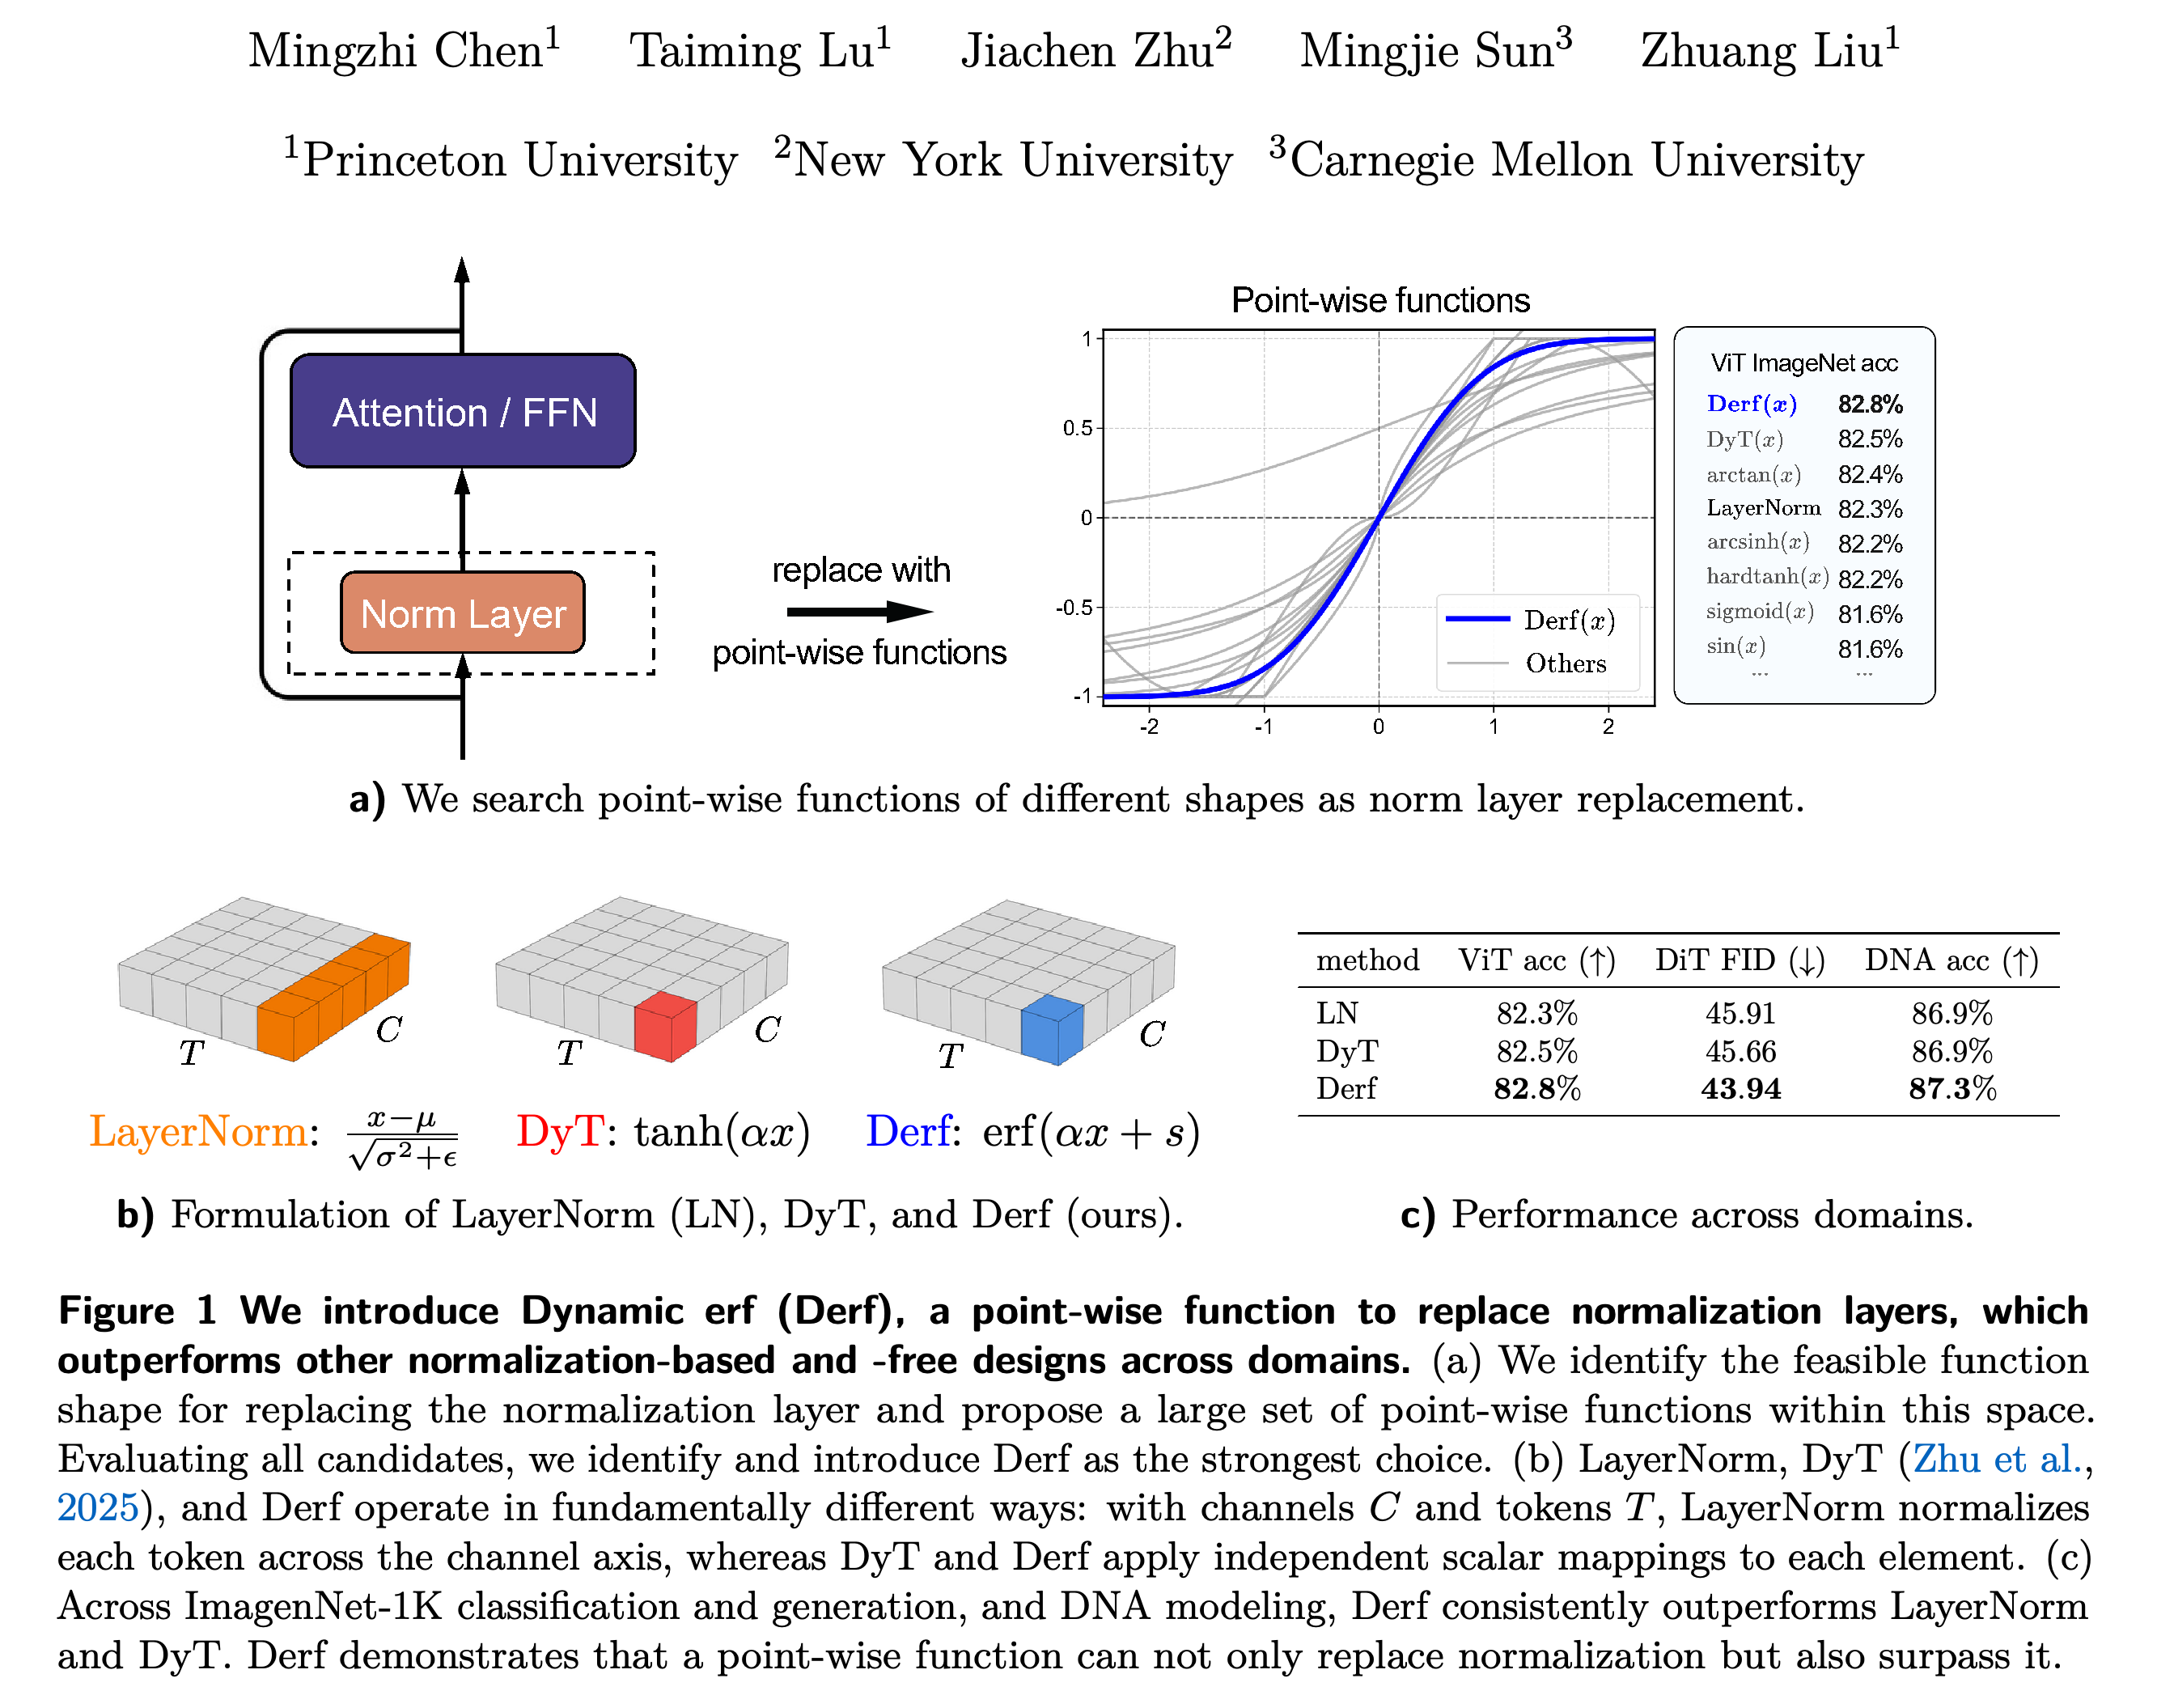
- Transformer의 정규화 계층은 계산한 통계량으로 활성값의 크기를 조정한다. 이 논문은 각 활성값을 독립적으로 변환하는 점별 함수로 정규화 계층을 대체하고 성능을 높일 수 있는지 살펴본다. 보고된 ImageNet-1K 이미지 분류 설정에서 Gaussian 오차 함수에 학습 가능한 변환을 적용한 Dynamic erf (Derf)는 Vision Transformer Base (ViT-Base)에서 top-1 정확도 82.8%를 달성한다. 이 정확도는 가장 높은 점수를 받은 예측이 정답인 사례의 비율이다. 각 토큰의 특징 채널에 걸쳐 정규화하는 LayerNorm은 82.3%, 학습 가능한 쌍곡탄젠트 기반 대체 함수인 Dynamic Tanh (DyT)는 82.5%를 기록한다.
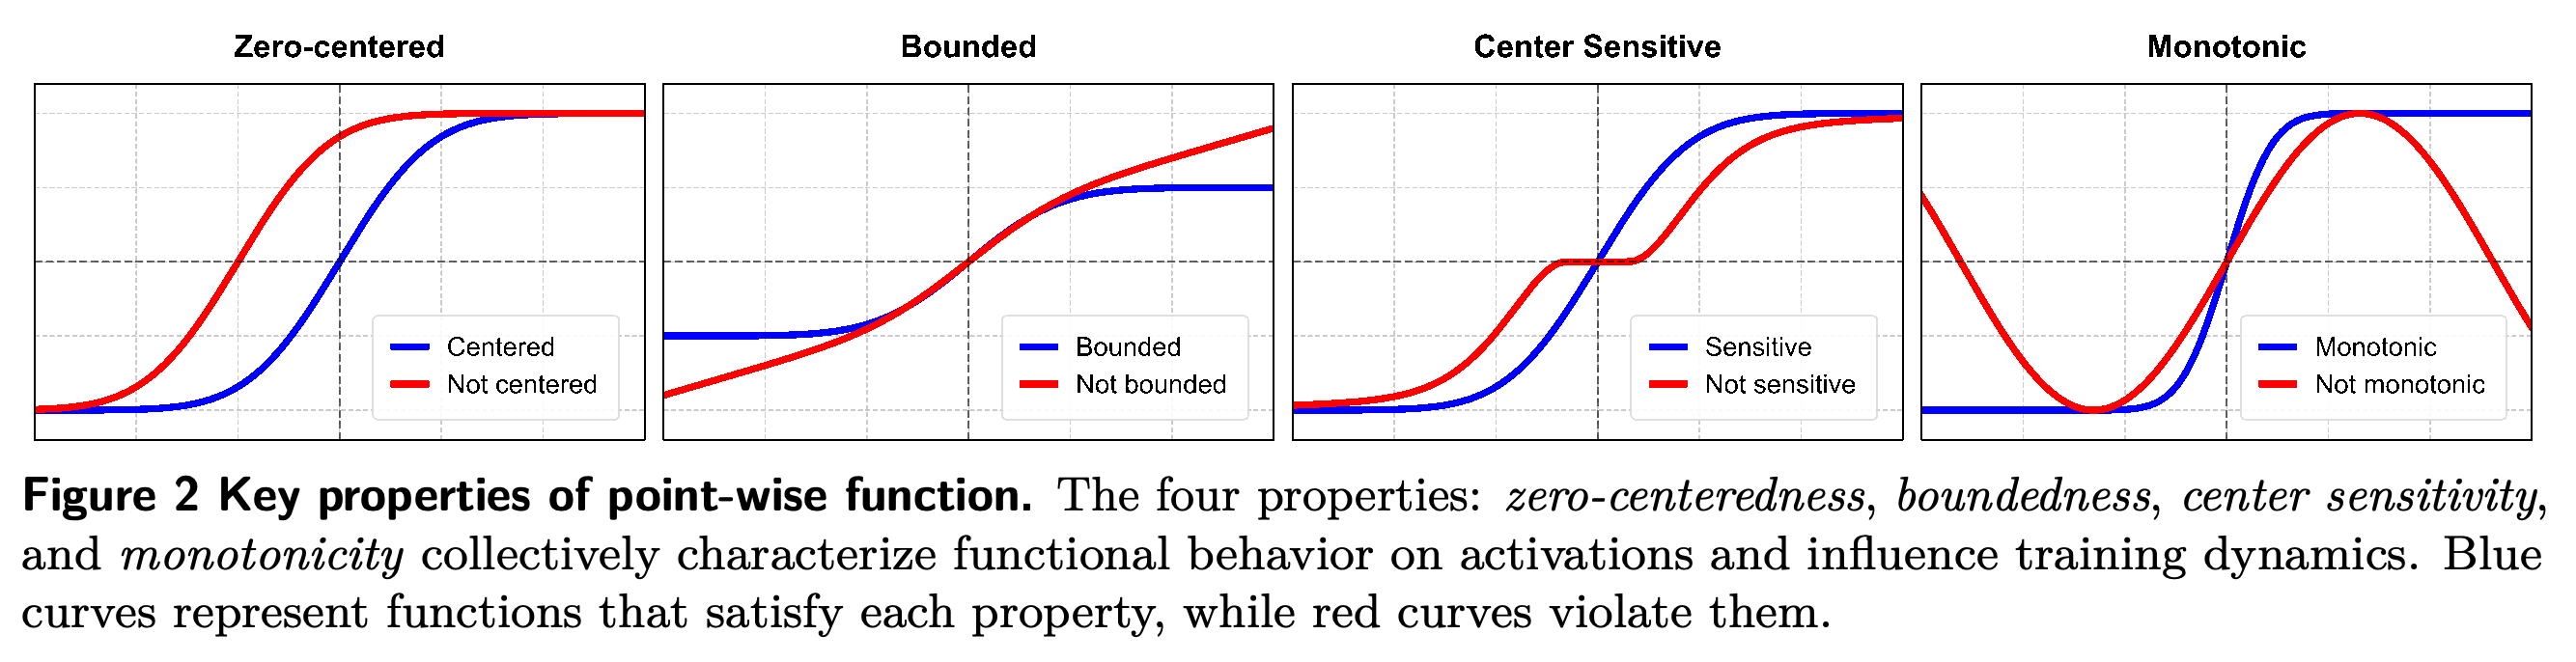
- 통제된 ViT-Base 실험에서 4가지 성질을 살펴본다. 영 중심성은 출력이 0을 중심으로 균형을 이루는 성질이고, 유계성은 출력 범위가 유한한 성질이다. 중심 민감도는 0 근처 입력에 반응하는 정도이며 단조성은 일관되게 증가하거나 감소하는 성질이다. 16개 후보 함수를 탐색한 결과, 유계인 S자형 오차 함수 erf를 선택한다. Derf는 여기에 학습 가능한 입력 스케일과 이동량, 채널별 출력 스케일과 편향을 더한다.
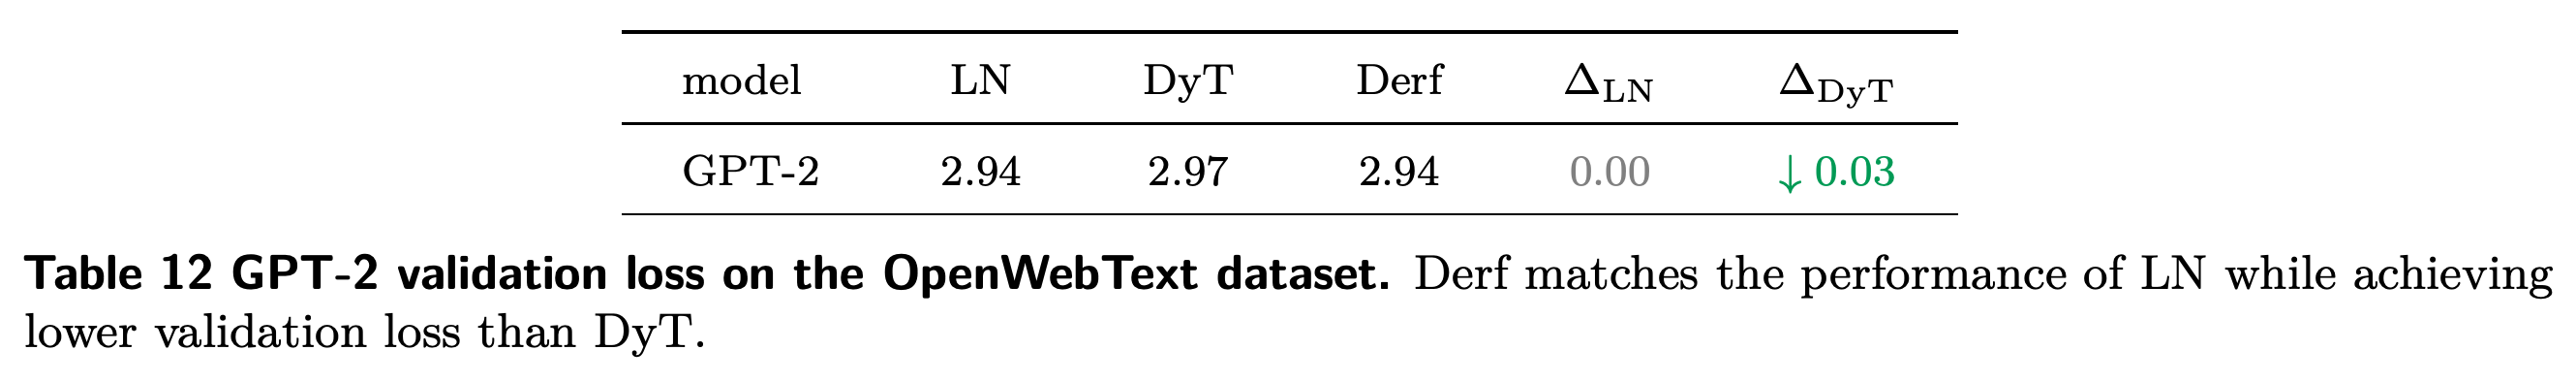
- 보고된 설정에서 Derf는 이미지 생성, 음성 사전학습 손실, 유전체 분류를 개선한다. 텍스트 데이터셋 OpenWebText에서는 매개변수가 124 million개인 언어 모델 GPT-2 (124M)의 검증 손실이 2.94로, LayerNorm과 같다. 학습 후 평가 모드에서 측정한 학습 데이터 손실이 더 높다는 결과는 저자들의 일반화 가설을 뒷받침하지만 제안한 작동 원리를 입증하지는 않는다. 언어 모델 결과, 음성 모델에 남겨 둔 정규화 계층, 모델별 초기화 변경을 고려하면 정규화 대체에 관한 주장의 범위는 제한된다.
LayerNorm은 채널을 함께 사용해 통계량을 계산하지만 DyT와 Derf는 개별 원소를 변환한다. 제시된 분류, 생성, 유전체 결과에서는 Derf가 개선된 성능을 보인다. 뒤에서 다루는 언어 모델 실험에서는 LayerNorm과 동등한 결과를 보고한다.
1 Introduction
논문은 정규화에 따르는 메모리 접근과 동기화 비용, 일부 정규화 방법의 배치 크기 민감도를 근거로 통계량을 사용하지 않는 대체 방법을 연구한다. 안정적인 학습을 지원하는 함수 형태를 분석하고 그 범위에서 함수를 탐색하며 선택한 함수를 여러 과제에서 검증해 DyT를 확장한다. 과제에는 레이블이 있는 사례로 학습하는 지도학습과 데이터 자체에서 학습 목표를 구성하는 자기지도학습이 포함된다.
2 Background
LayerNorm은 시퀀스의 개별 요소인 각 토큰마다 특징 채널에 걸쳐 평균과 분산을 계산하고 학습 가능한 출력 스케일과 편향을 적용한다. 점별 대체 함수는 배치, 토큰, 채널 통계량을 계산하지 않고 각 활성값에 학습 가능한 변환을 독립적으로 적용한다. DyT는 DyT(x) = γ * tanh(αx) + β를 사용하며 α는 학습 가능한 입력 스케일이고 γ와 β는 출력 스케일과 편향이다. 배경에서는 제곱평균제곱근 크기에 기반한 정규화 대안인 Root Mean Square Normalization (RMSNorm)도 소개한다.
3 Function Property Analysis
함수 성질 분석에서는 정규화 계층을 \(y=\gamma\cdot f(\alpha x)+\beta\)로 대체하고 통제된 변환으로 쌍곡탄젠트 tanh, erf, 역탄젠트 arctan을 수정한다. 모든 실험은 ViT-Base를 사용하고 ImageNet-1K top-1 정확도를 보고한다. 따라서 여기서 얻은 설계 원칙은 해당 아키텍처와 학습 설정에서 관찰한 경험적 결과다.
각 패널은 제안한 성질을 만족하는 함수와 만족하지 않는 함수를 비교한다. 곡선은 실험에서 살펴보는 형태 변화를 정의하며 해당 성질이 필수라는 점을 입증하지는 않는다.
3.1 Zero-centeredness
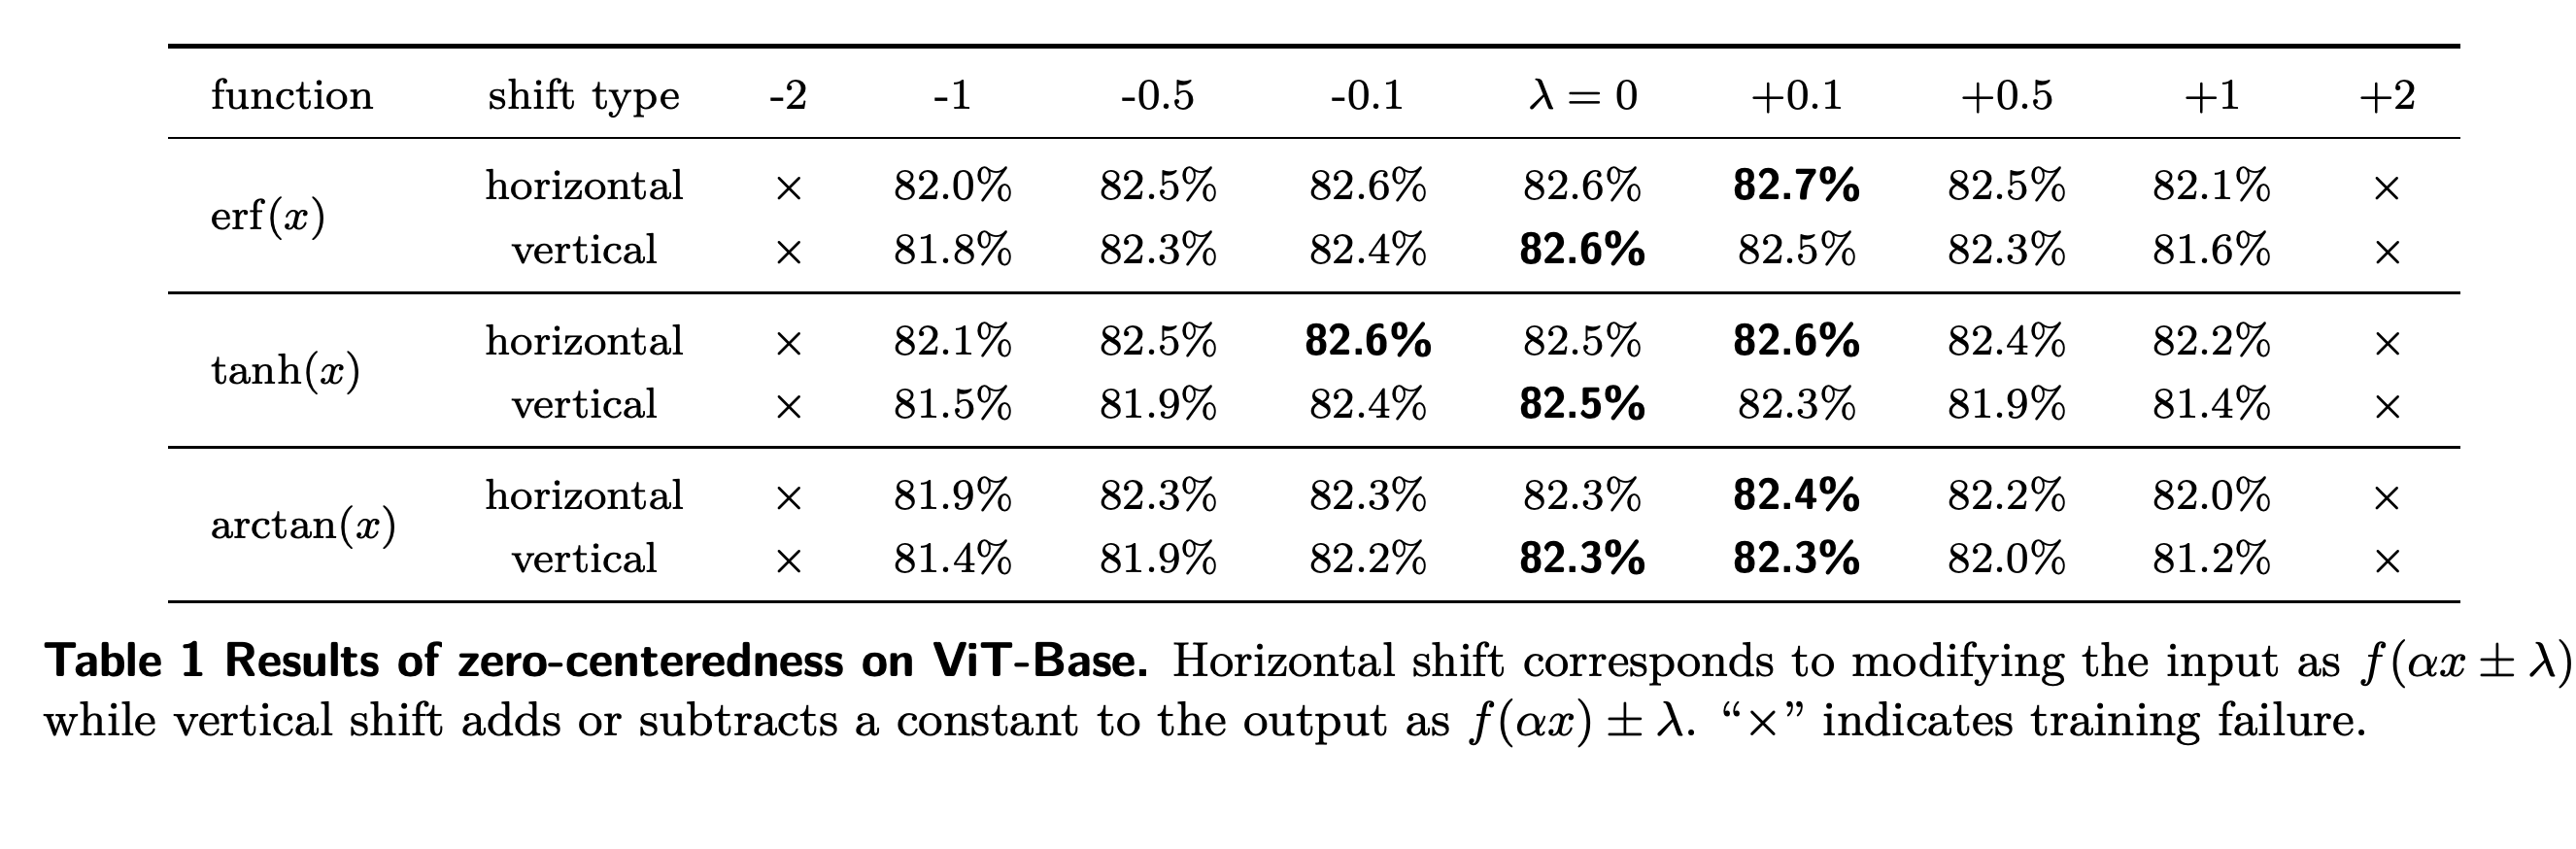
수평 이동은 함수의 입력을 바꾸고, 수직 이동은 출력에 상수를 더한다. Table 1은 ±0.1과 ±0.5를 포함해 −2부터 +2까지의 이동 결과를 보고한다. 작은 수평 이동은 정확도를 유지하며 erf는 이동이 없을 때 82.6%, +0.1에서 82.7%를 기록한다. 반면 수평 또는 수직 이동이 커지면 정확도가 낮아지고, ±2에서는 시험한 모든 함수가 실패한다. 이 결과는 대략적인 중심 정렬이 유리함을 보여 주지만 정확한 영 중심성이 필수라는 점을 입증하지는 않는다.
작은 수평 이동은 기본 함수의 정확도를 유지하며 erf는 +0.1에서 82.7%를 기록한다. −2와 +2에서 모두 실패하고 수직 이동이 커질수록 정확도가 낮아지는 결과는 대략적인 중심 정렬에서 크게 벗어나지 않는 편이 유리함을 뒷받침한다.
3.2 Boundedness
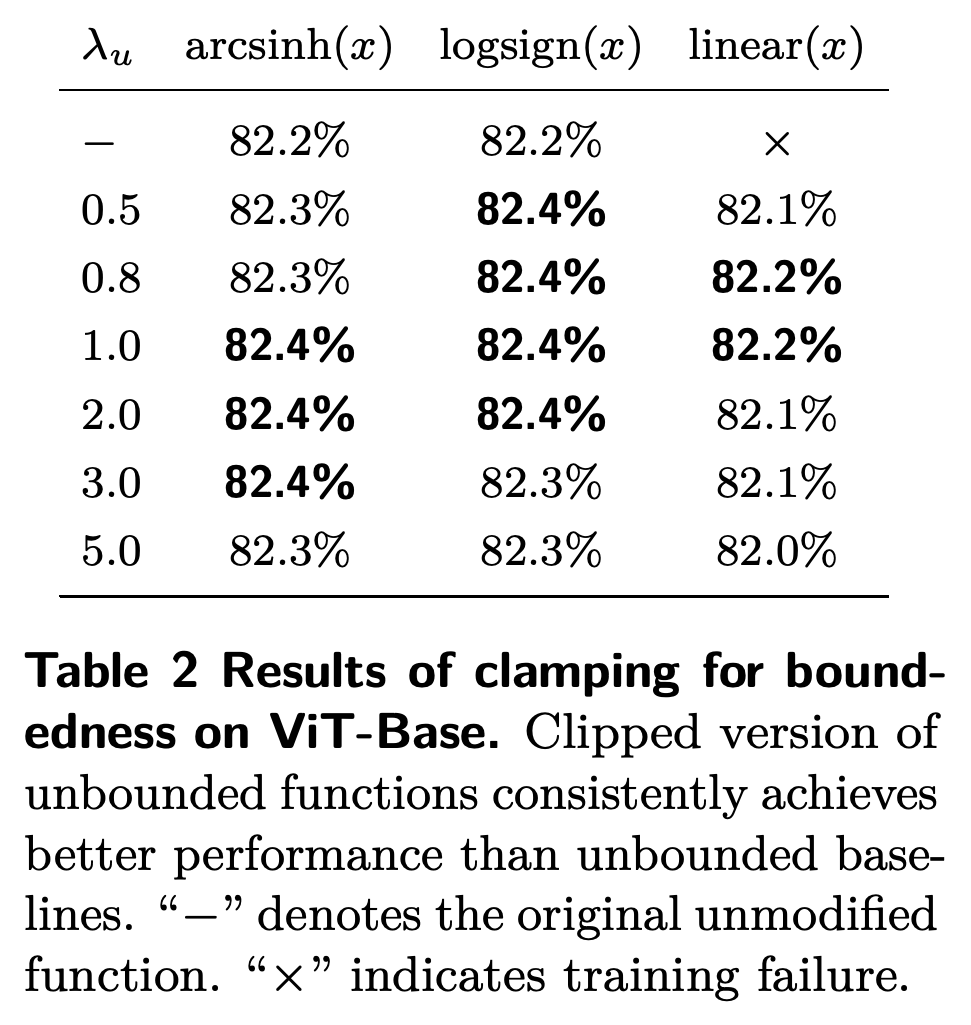
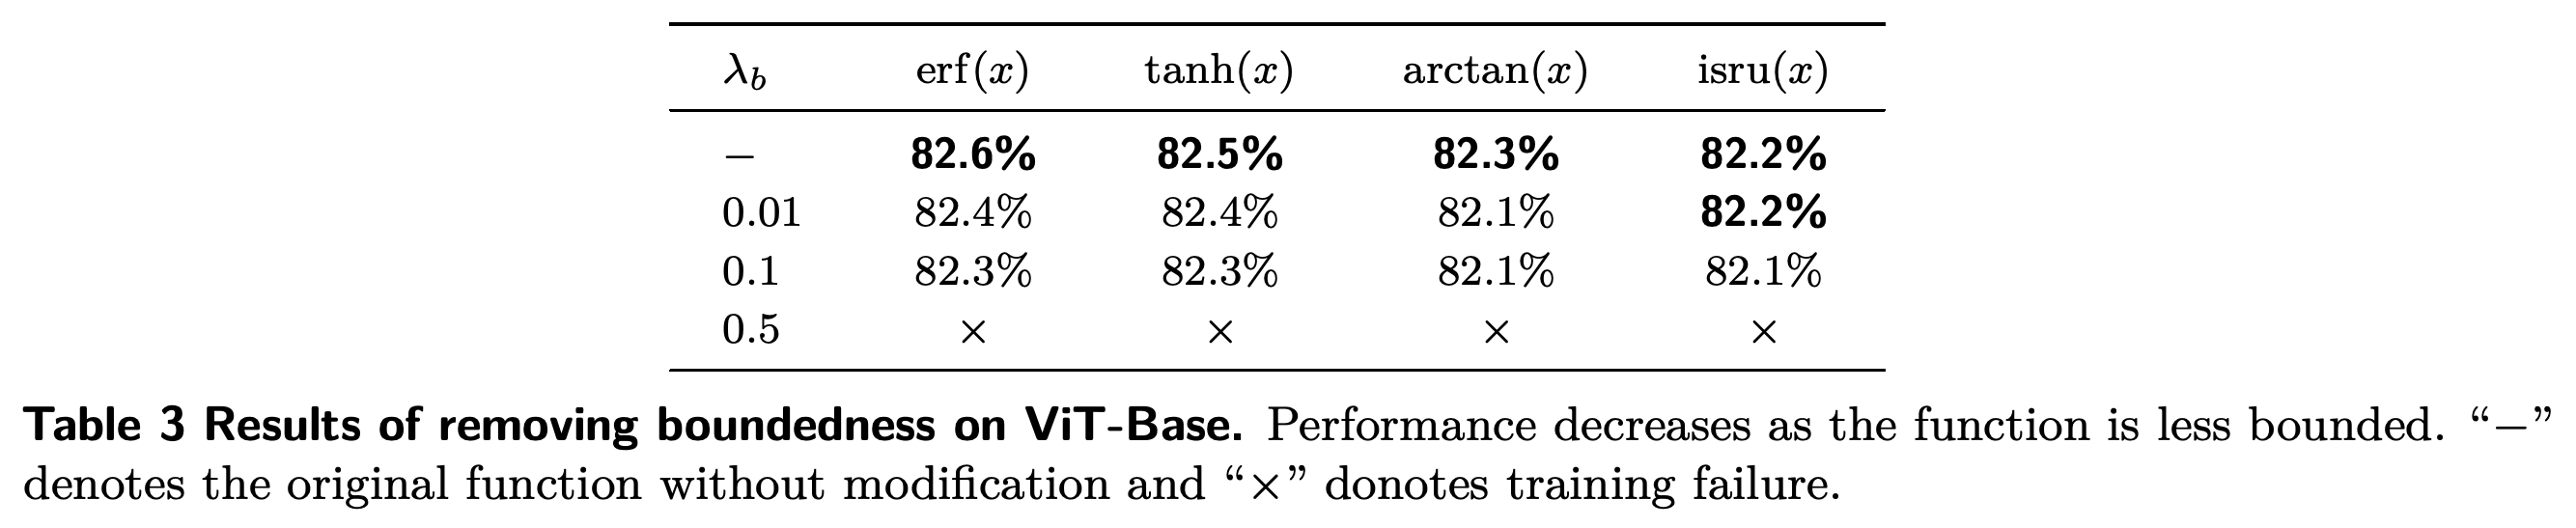
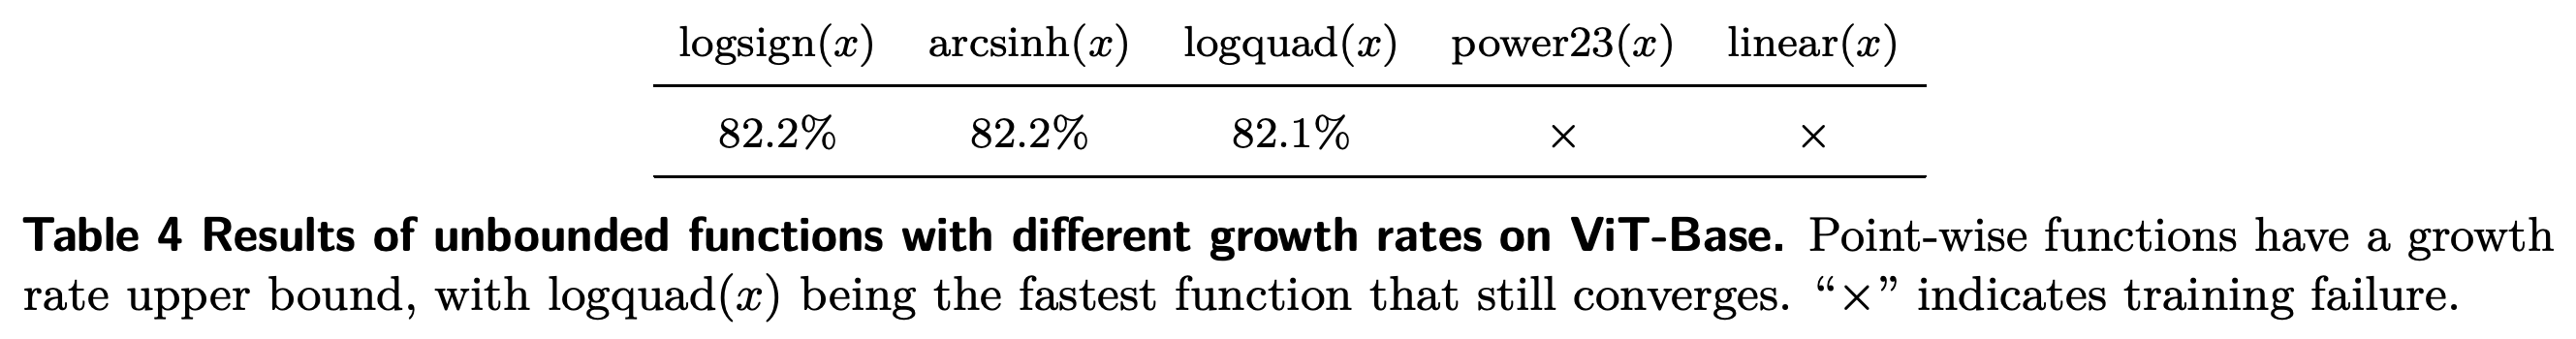
비유계 함수의 출력을 지정된 구간으로 제한하는 클리핑을 λu ∈ {0.5, 0.8, 1.0, 2.0, 3.0, 5.0}에서 적용하면, 역쌍곡사인 arcsinh와 부호를 적용한 로그 함수 logsign이 모두 기준 정확도 82.2%보다 개선되고 선형 함수도 학습에 성공한다. 유계 함수에 λb ∈ {0.01, 0.1, 0.5}의 선형 성분을 더하면 대체로 정확도가 낮아지며, 0.5에서는 시험한 모든 함수가 실패한다. 시험한 비유계 함수 중 x² + 1의 로그에 부호를 적용한 logquad는 82.1%로 수렴하지만 부호를 적용한 2/3승 함수 power23과 linear는 실패한다. 따라서 이 설정에서 유계성은 도움이 되지만 수렴의 필수 조건은 아니다.
곡선은 시험한 함수들이 양의 입력에서 증가하는 양상을 비교한다. 이 집합에서 logquad는 수렴한 함수 중 가장 빠르게 증가한다. 이는 경험적 비교 결과이며 일반적인 증가율 상한을 제시하지는 않는다.
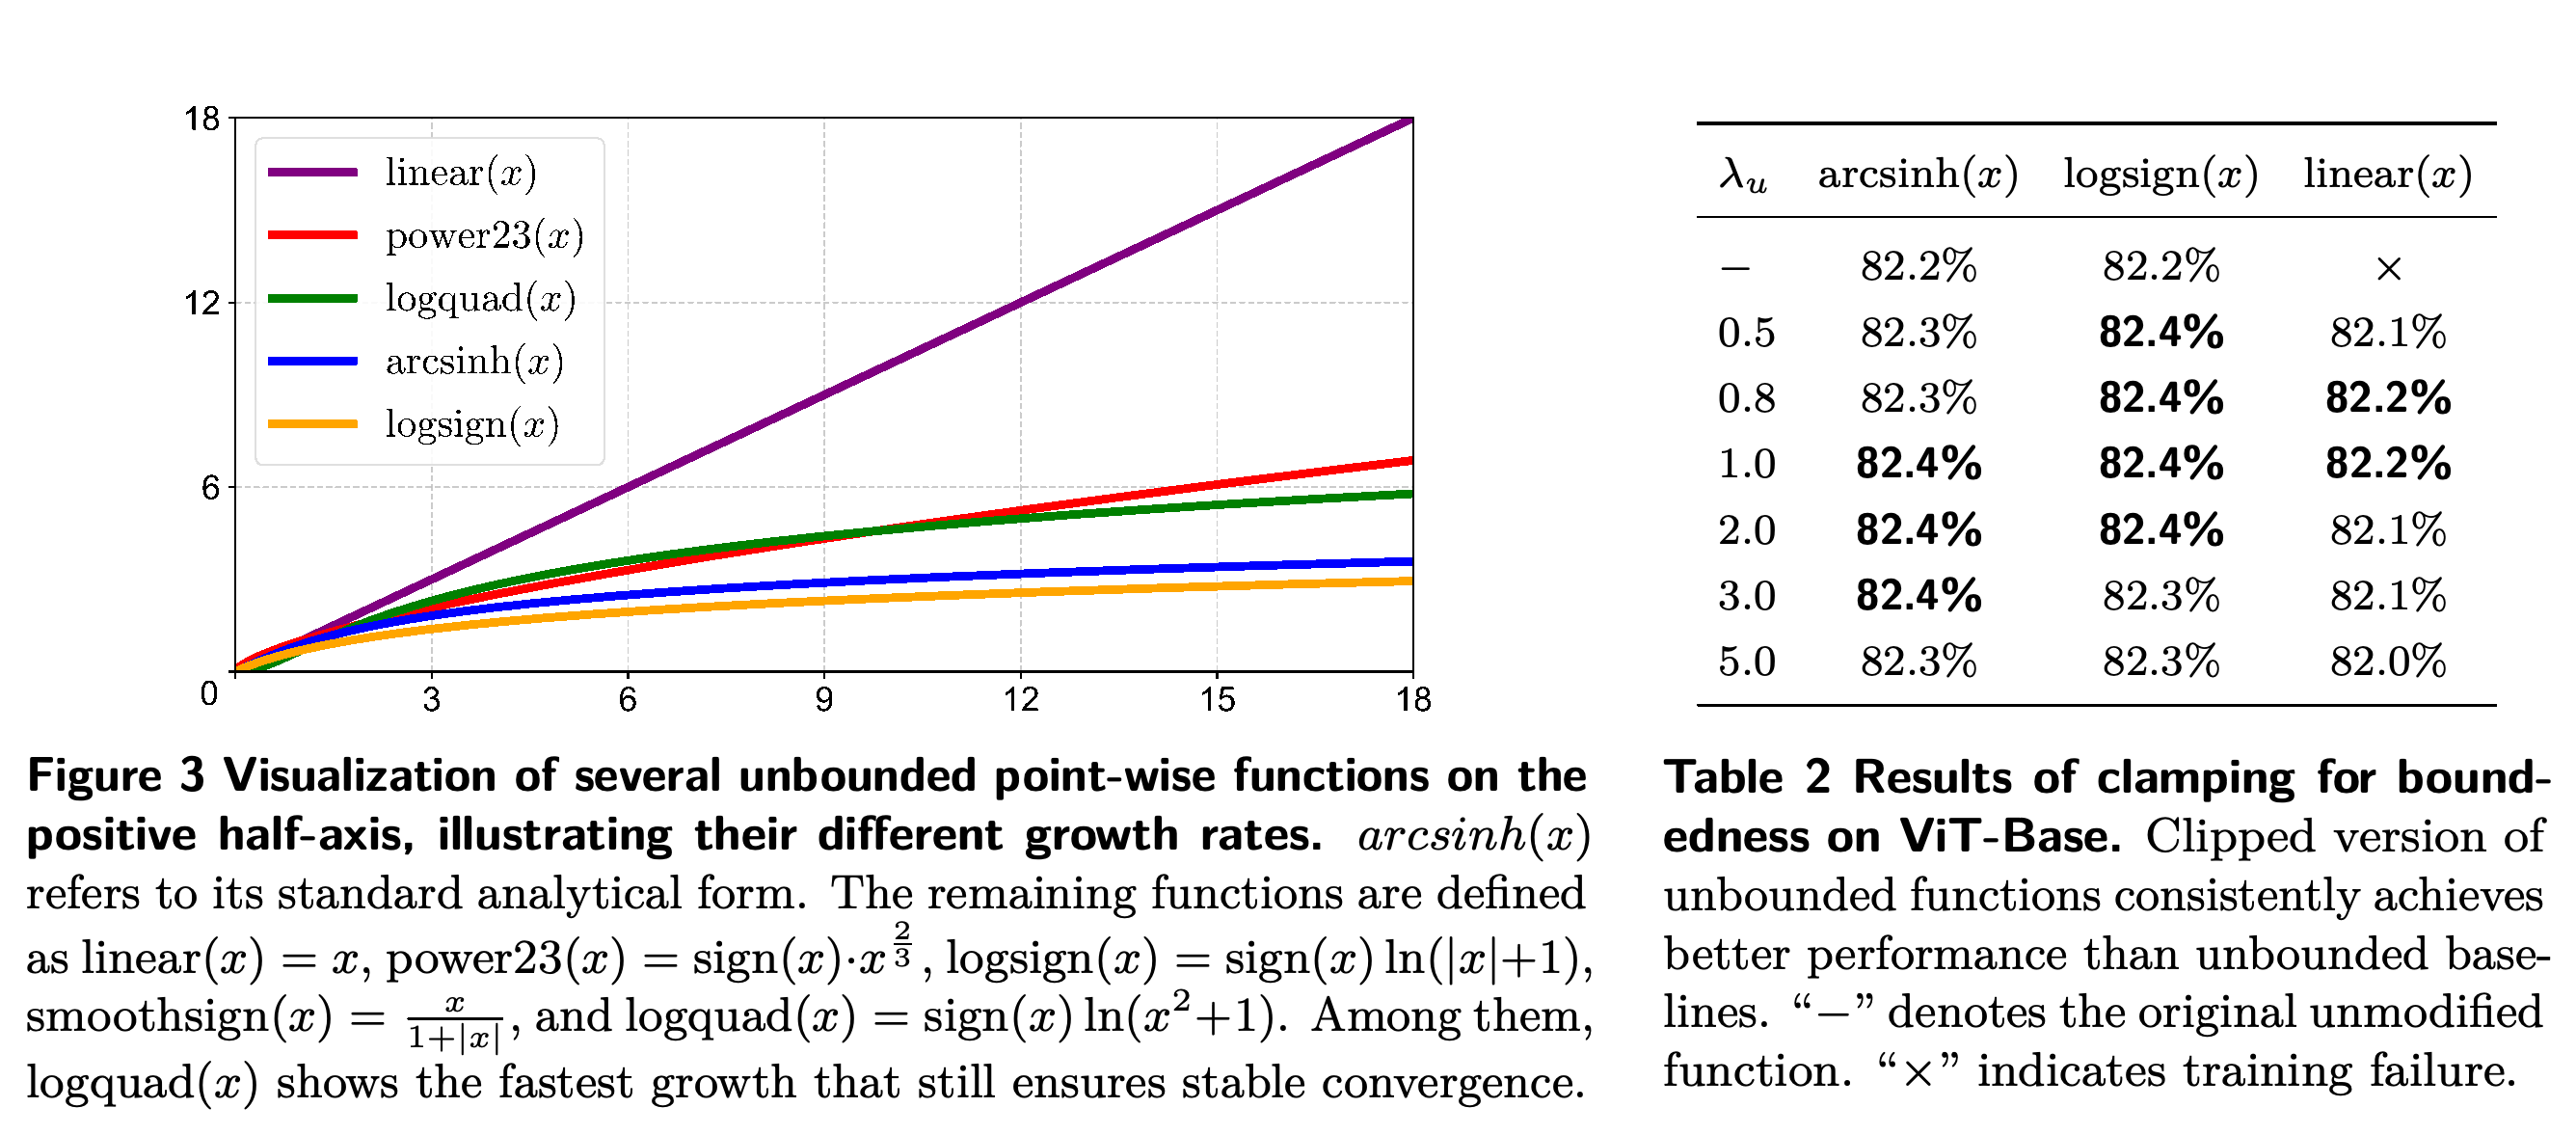
클리핑을 적용하면 arcsinh와 logsign의 정확도가 모두 82.2%에서 최대 82.4%로 높아진다. 수정하지 않은 선형 함수는 실패하지만 클리핑한 변형은 82.0%–82.2%를 기록한다. 극단적인 출력을 제한하면 학습이 가능해질 수 있음을 보여 준다.
작은 선형 성분을 추가하면 대체로 유계 함수 기준보다 정확도가 낮아진다. λb = 0.5에서는 시험한 4개 함수가 모두 실패한다. 이 학습 설정에서는 큰 선형 증가가 불안정성과 연결된다.
Logsign, arcsinh, logquad는 각각 82.2%, 82.2%, 82.1%로 수렴하지만 power23과 linear는 실패한다. 학습에 성공한 비유계 함수 사례는 이 설정에서 유계성이 수렴의 필수 조건이 아님을 보여 준다.
3.3 Center Sensitivity
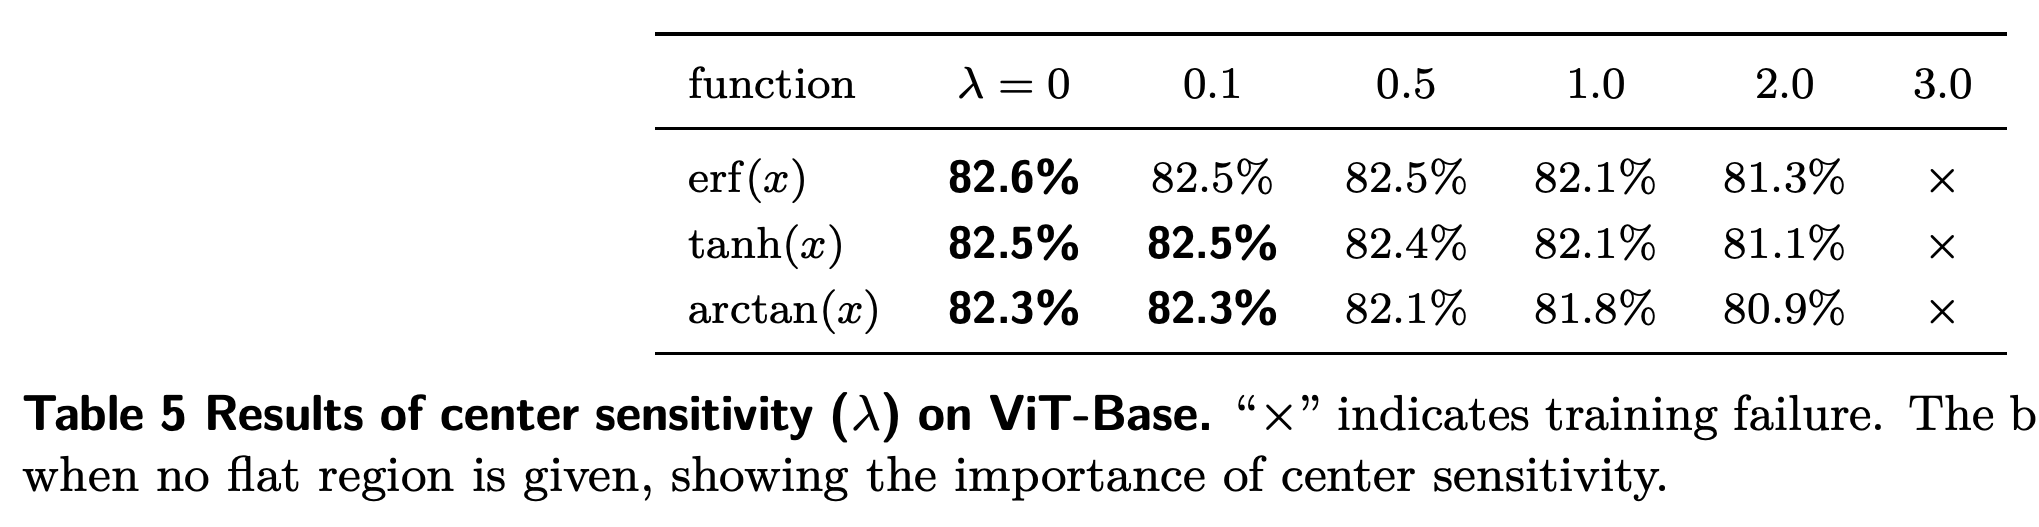
중심 민감도는 [−λ, λ]에서 f(x) = 0이 되도록 하고, 나머지 함수 구간을 연속성을 유지하며 바깥쪽으로 이동시켜 시험한다. λ ∈ {0.1, 0.5, 1.0, 2.0, 3.0}을 사용한다. erf의 정확도는 평탄 구간이 없을 때 82.6%에서 λ = 1.0일 때 82.1%, λ = 2.0일 때 81.3%로 낮아진다. λ = 3.0에서는 3개 기본 함수가 모두 실패한다. 이 실험은 0 근처의 반응성을 유지하는 것이 유리함을 뒷받침하지만 저자들도 이 성질을 독립적으로 분리해 검증하기 어렵다고 인정한다.
반응하지 않는 구간이 넓어지면 모든 기본 함수의 정확도가 낮아지며, erf는 λ = 2.0에서 81.3%로 떨어진다. λ = 3.0에서는 모든 함수가 실패한다. 이는 원점 근처의 작은 신호를 보존하는 것이 유리함을 뒷받침한다.
3.4 Monotonicity
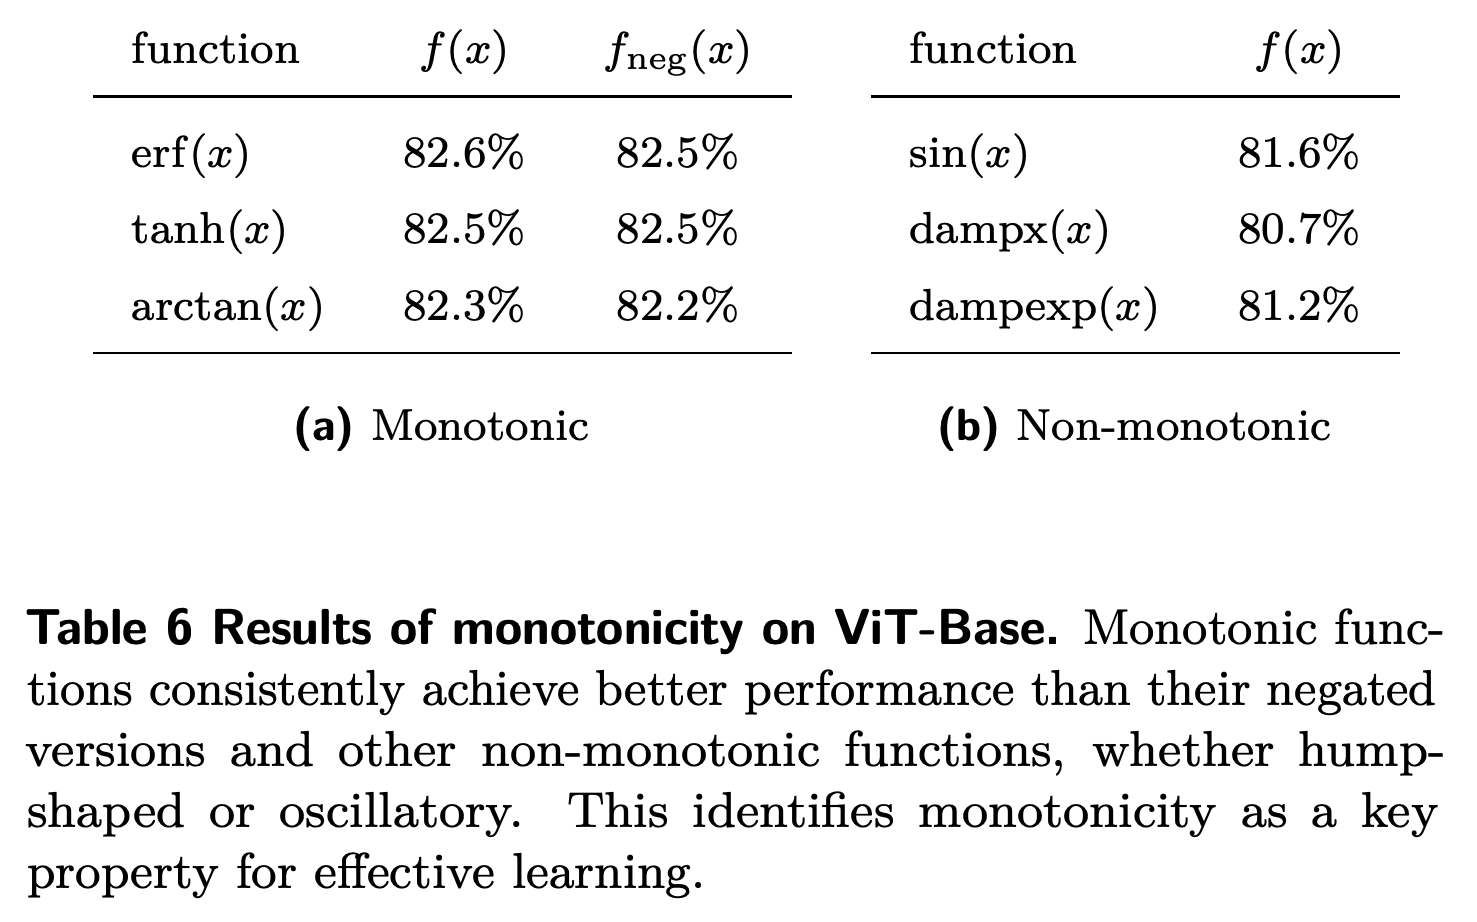
단조성 실험은 증가 함수, 부호를 반전한 감소 함수, 출력이 진동하거나 증가한 뒤 감소하는 비단조 함수를 비교하며 비교를 위해 출력 범위의 크기를 조정한다. 증가하는 erf와 감소하는 erf는 각각 82.6%와 82.5%를 달성한다. 사인 함수 sin, 유리 함수 형태의 봉우리형 함수 dampx, 지수적으로 감쇠하는 봉우리형 함수 dampexp는 각각 81.6%, 80.7%, 81.2%를 기록한다. 결과는 단조 함수가 유리하며 감소 함수도 효과적으로 학습할 수 있음을 보여 준다.
증가, 감소, 진동, 봉우리 형태의 함수는 출력 범위가 비슷해도 입력 순서를 보존하는 방식이 다르다. 부호를 반전한 erf도 단조성을 유지하므로, 감소 함수 역시 단조 함수 비교에 포함된다.
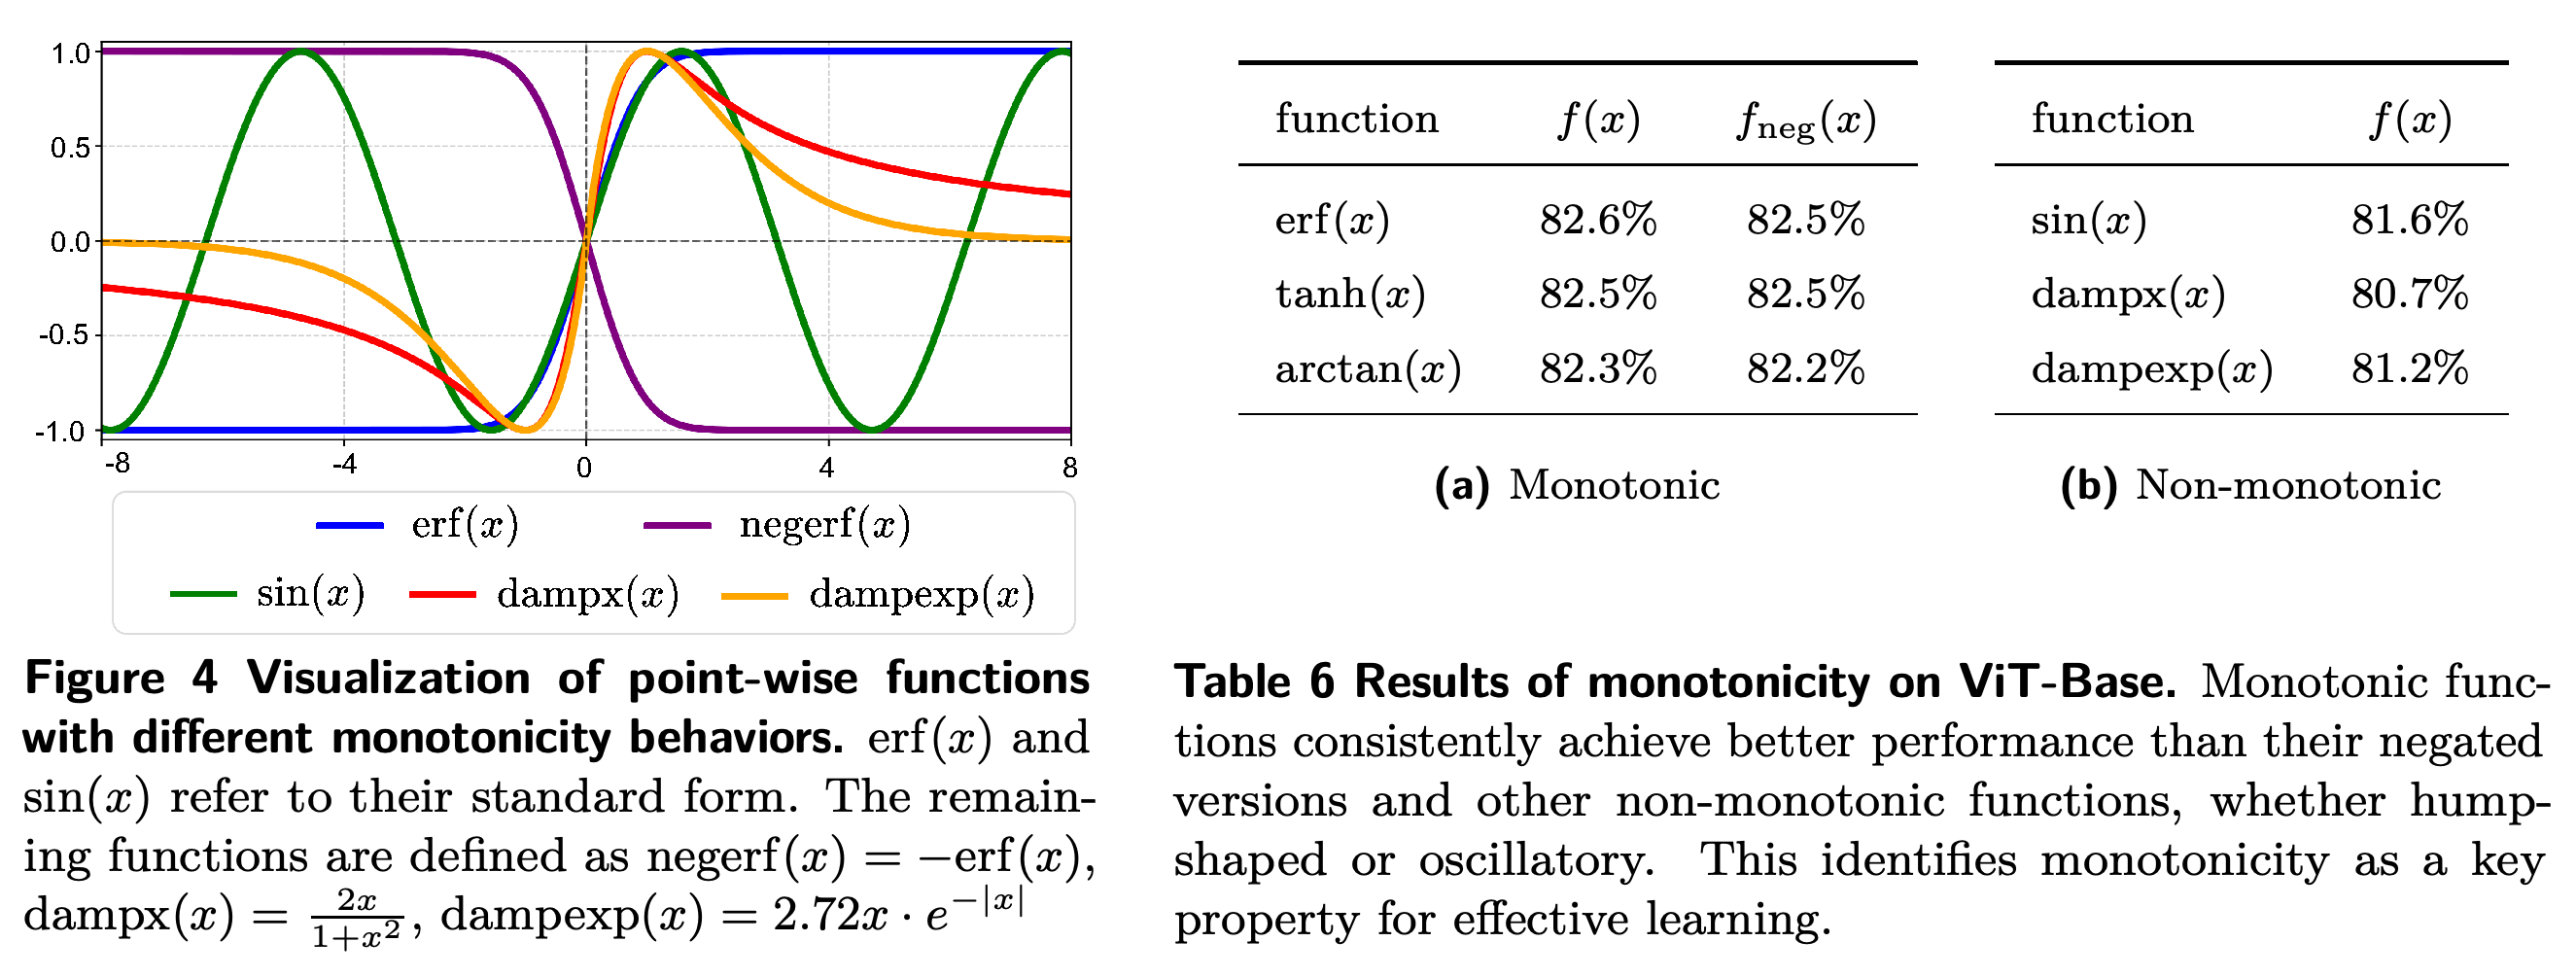
증가하는 단조 함수와 감소하는 단조 함수는 비슷한 성능을 보이며 tanh와 부호를 반전한 tanh는 모두 82.5%를 기록한다. 비단조 함수의 점수는 더 낮다. 이 결과는 증가 방향을 필수 조건으로 두지 않으면서 단조성이 유리함을 뒷받침한다.
4 Function Search
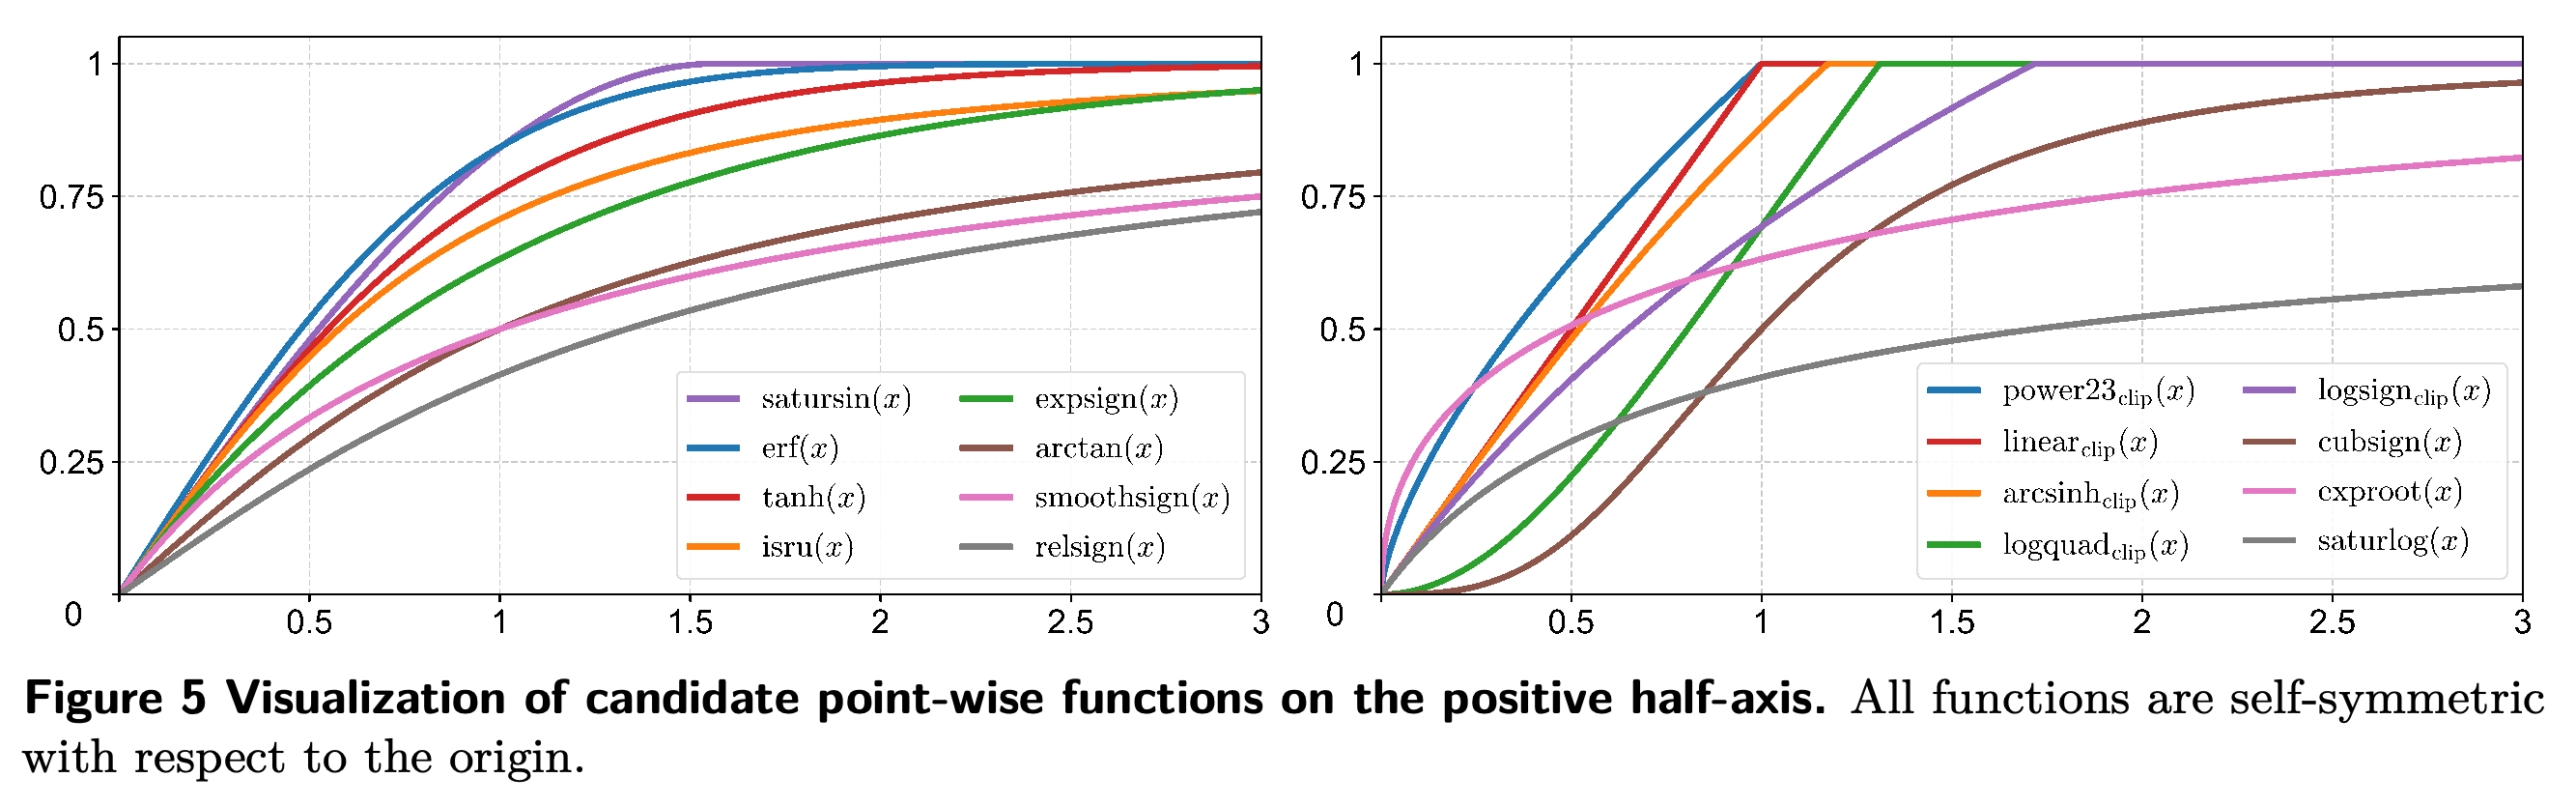
함수 탐색에서는 표준 스칼라 함수와 누적 확률을 나타내는 누적분포함수에 스케일 조정, 반사, 클리핑 등의 변환을 적용해 16개 후보를 만든다. 각 후보는 학습 가능한 입력 스케일 α와 이동량 s를 포함한 \(y=\gamma * f(\alpha x+s)+\beta\)를 사용한다. ImageNet-1K에서 ViT-Base와, 반복적으로 잡음을 제거해 이미지를 생성하는 Diffusion Transformers (DiT)로 평가한다. erf 후보는 분류 정확도 82.8%, DiT-B/4에서 63.23, DiT-L/4에서 43.94의 Fréchet Inception Distance (FID)로 보고된 모든 후보 중 가장 좋은 결과를 기록한다. FID는 논문에서 사용하는 이미지 생성 품질 지표이며 낮을수록 좋다.
erf 후보는 보고된 3개 지표 모두에서 16개 함수와 LayerNorm보다 좋은 결과를 기록한다. ViT-Base 정확도는 82.8%, DiT-B/4 FID는 63.23, DiT-L/4 FID는 43.94다. 일부 후보는 제안한 형태 조건을 만족해도 생성 성능이 LayerNorm보다 낮다. 따라서 해당 조건만으로 성능을 완전히 결정할 수는 없다.
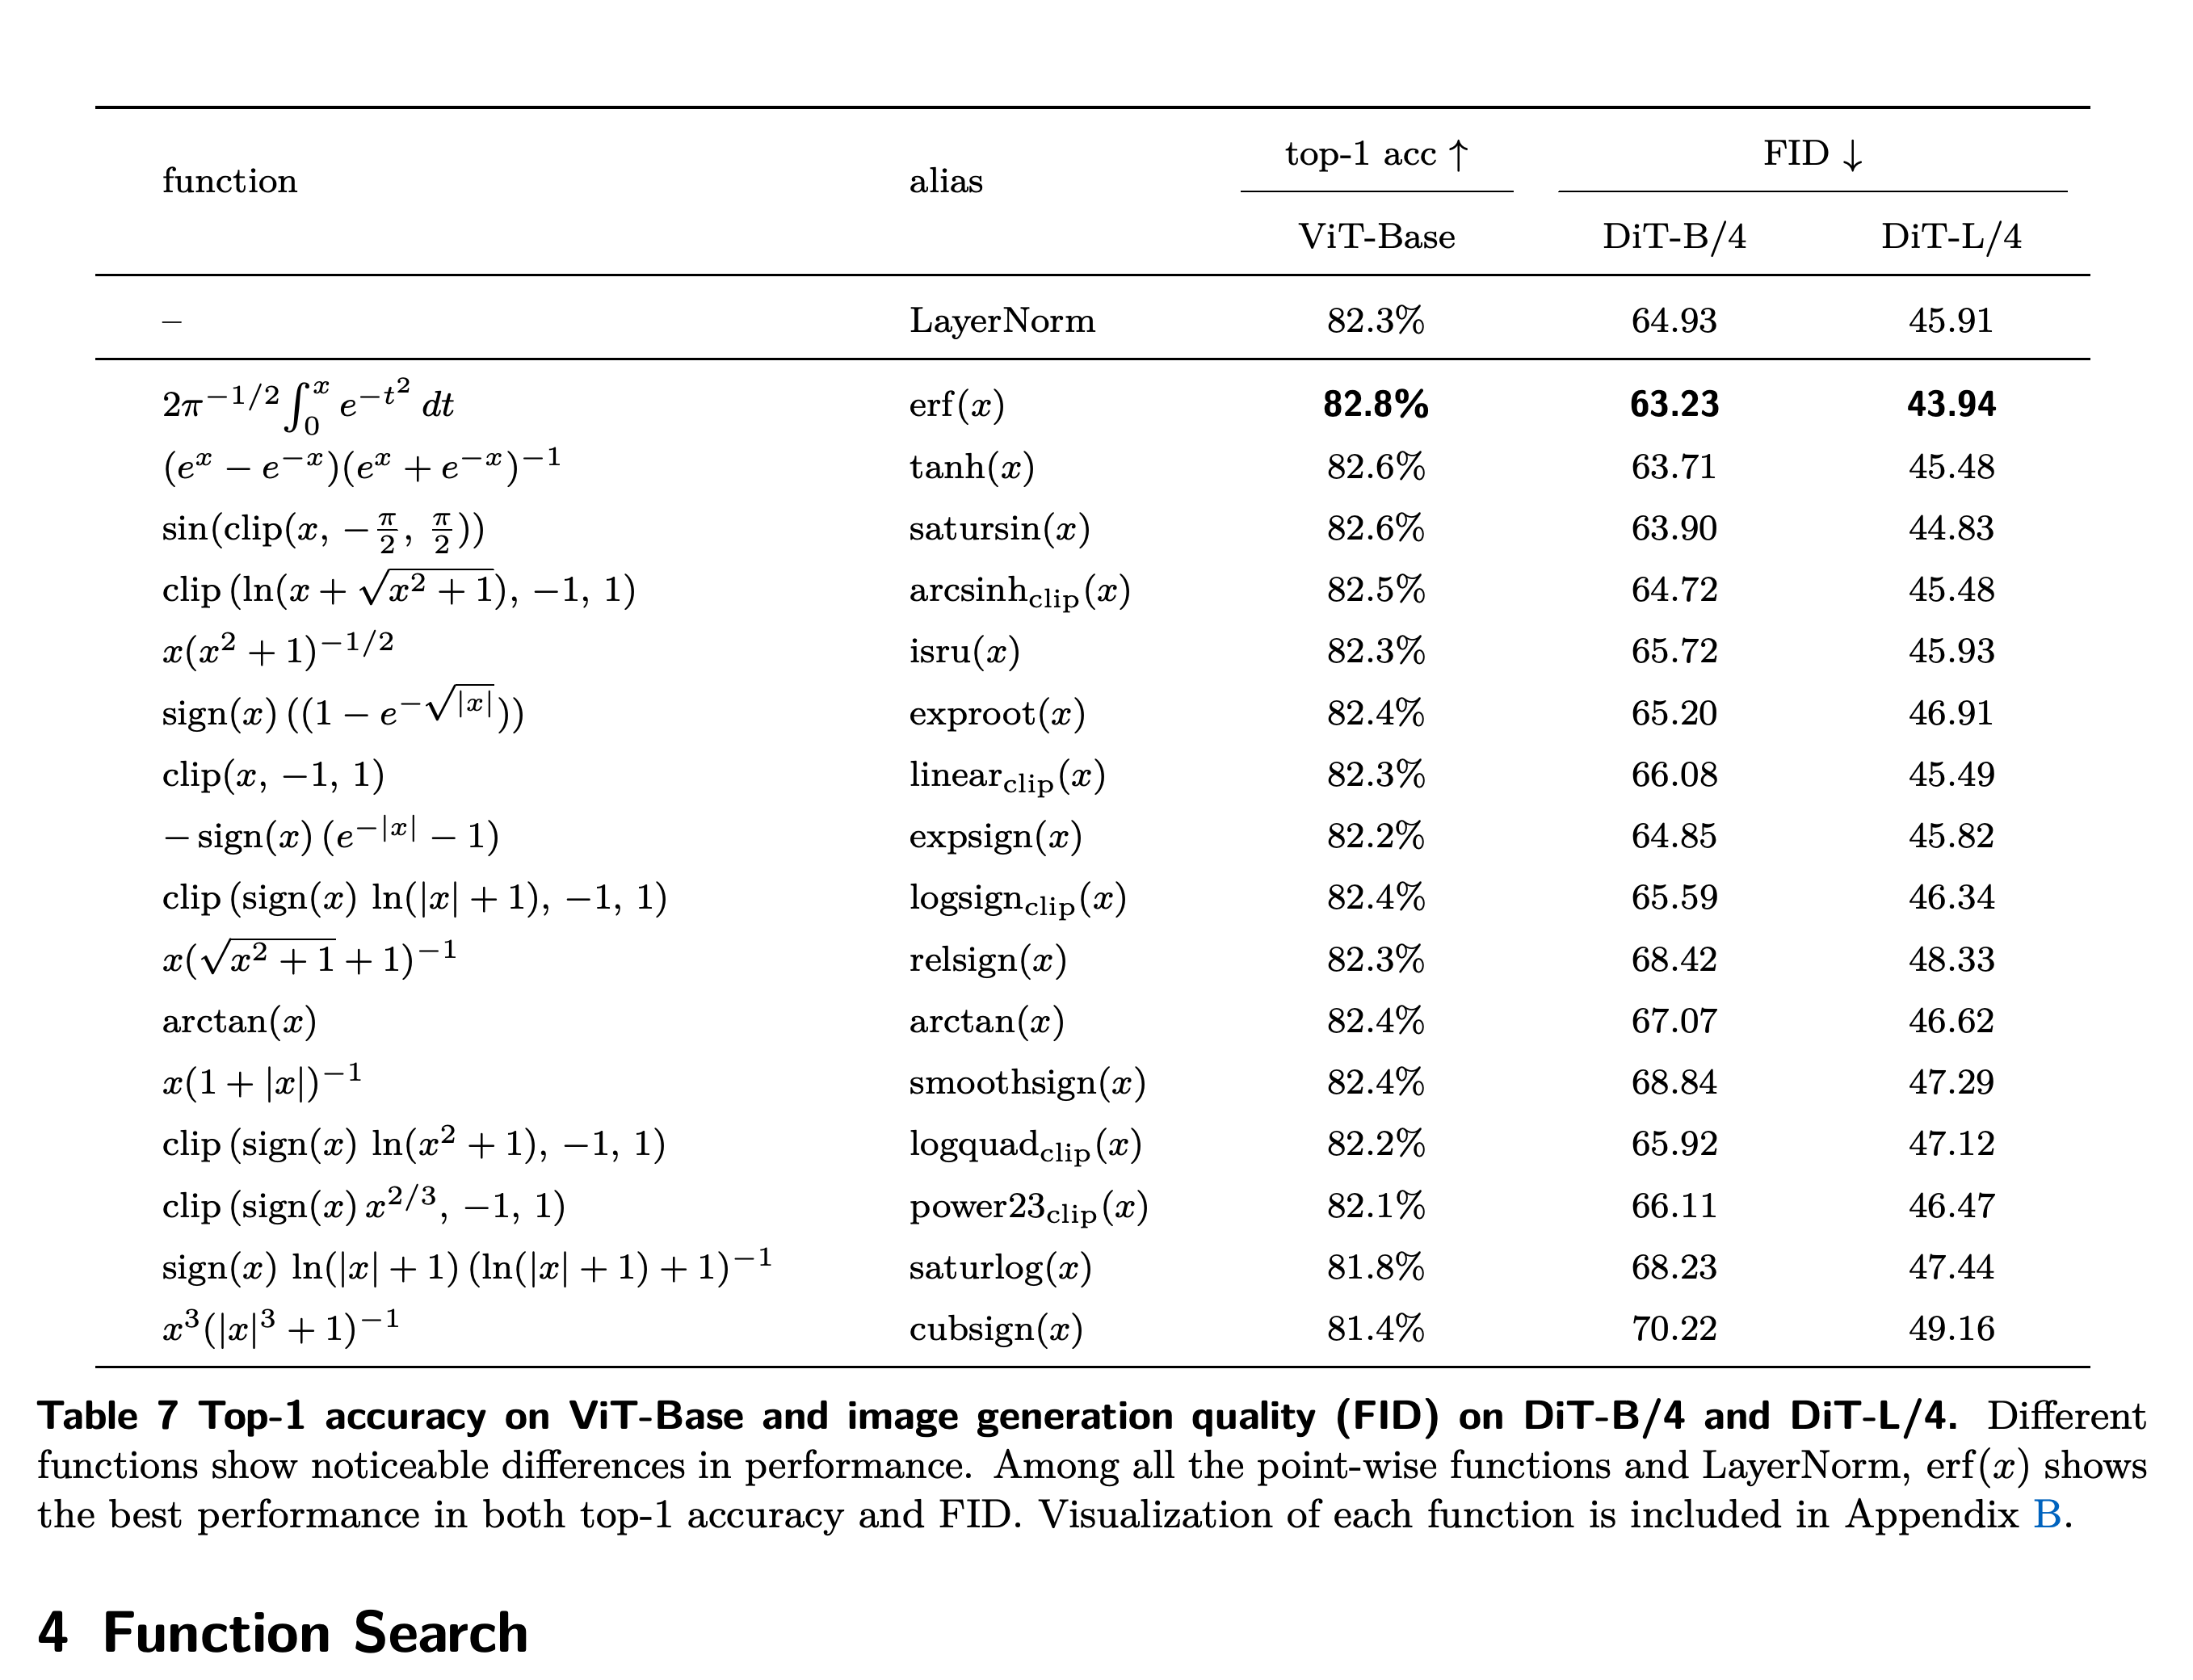
후보들은 중심이 정렬된 유계 형태를 공유하더라도 0 근처의 반응과 포화 속도가 다르다. Table 7의 서로 다른 결과는 시각적인 유사성에 의존하기보다 구체적인 함수 형태를 평가해야 함을 뒷받침한다.
5 Dynamic erf (Derf)
\(\operatorname{Derf}(x)=\gamma *\operatorname{erf}(\alpha x+s)+\beta\)는 학습 가능한 스칼라 α와 s, 학습 가능한 채널별 벡터 γ와 β를 사용한다. 오차 함수는 erf(x) = (2/√π) ∫₀ˣ exp(−t²) dt이며, Gaussian 누적분포와 관련된 S자형 함수다. Derf는 attention 앞, 각 토큰의 특징을 변환하는 feed-forward network 앞, 모델의 최종 정규화 계층에서 정규화를 대체한다. 별도 명시가 없으면 초기값은 α = 0.5, s = 0, γ = 1, β = 0이다. 코드는 https://github.com/zlab-princeton/Derf 에 공개되어 있다.
6 Experiments
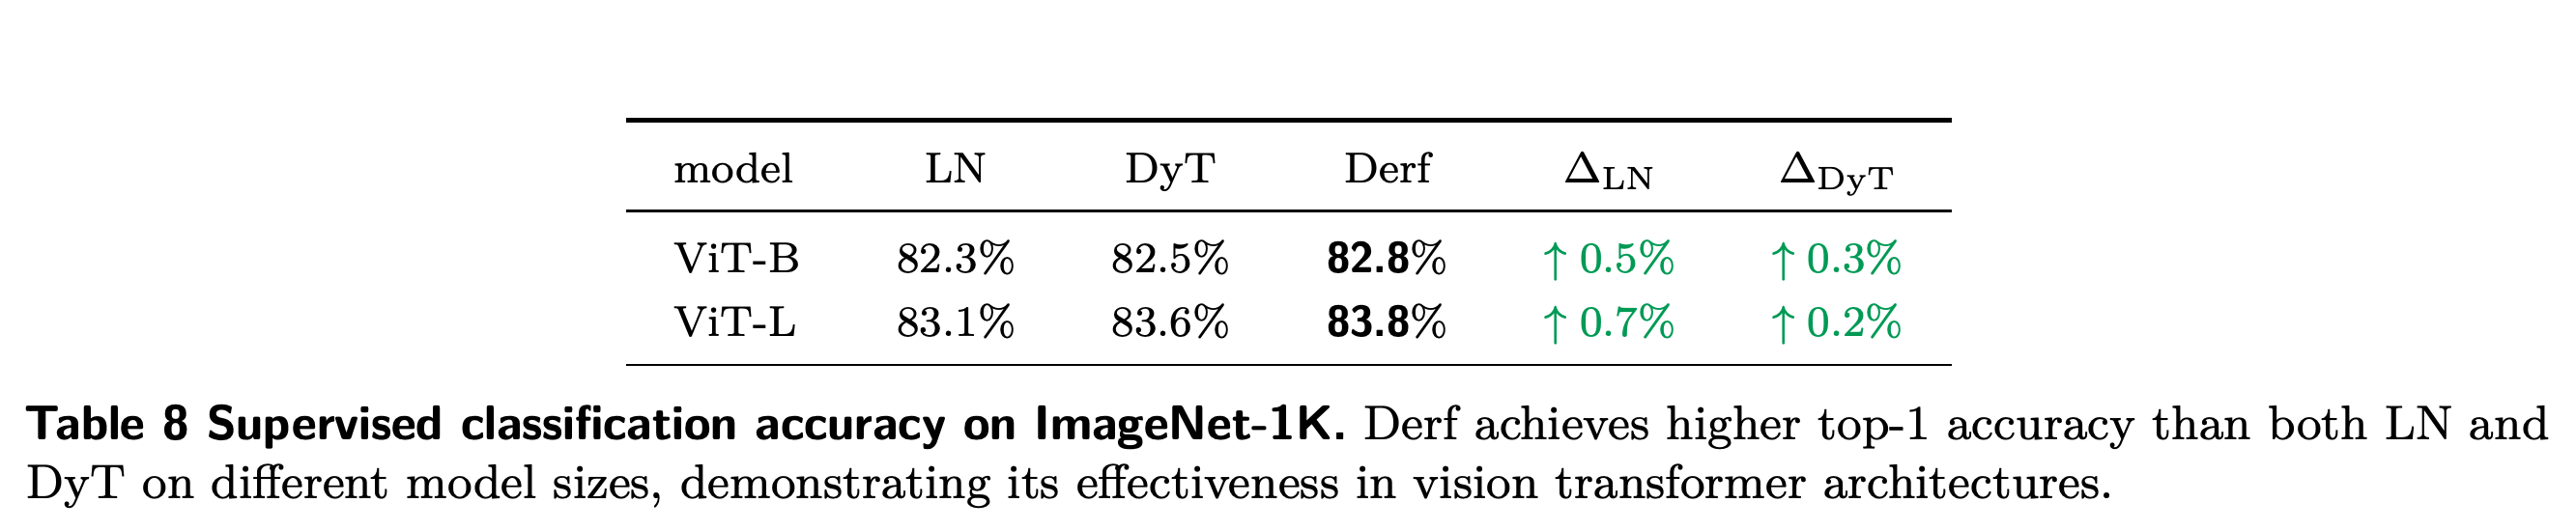
ImageNet-1K 지도학습 분류에서 Derf는 ViT-Base로 82.8%, ViT-Large로 83.8%를 달성한다. LayerNorm은 82.3%와 83.1%, DyT는 82.5%와 83.6%를 기록한다. Derf의 정확도는 LayerNorm보다 각각 0.5, 0.7 percentage points 높다.
Derf의 정확도는 LayerNorm보다 ViT-Base에서 0.5 percentage points, ViT-Large에서 0.7 percentage points 높다. DyT보다 각각 0.3, 0.2 percentage points 높다.
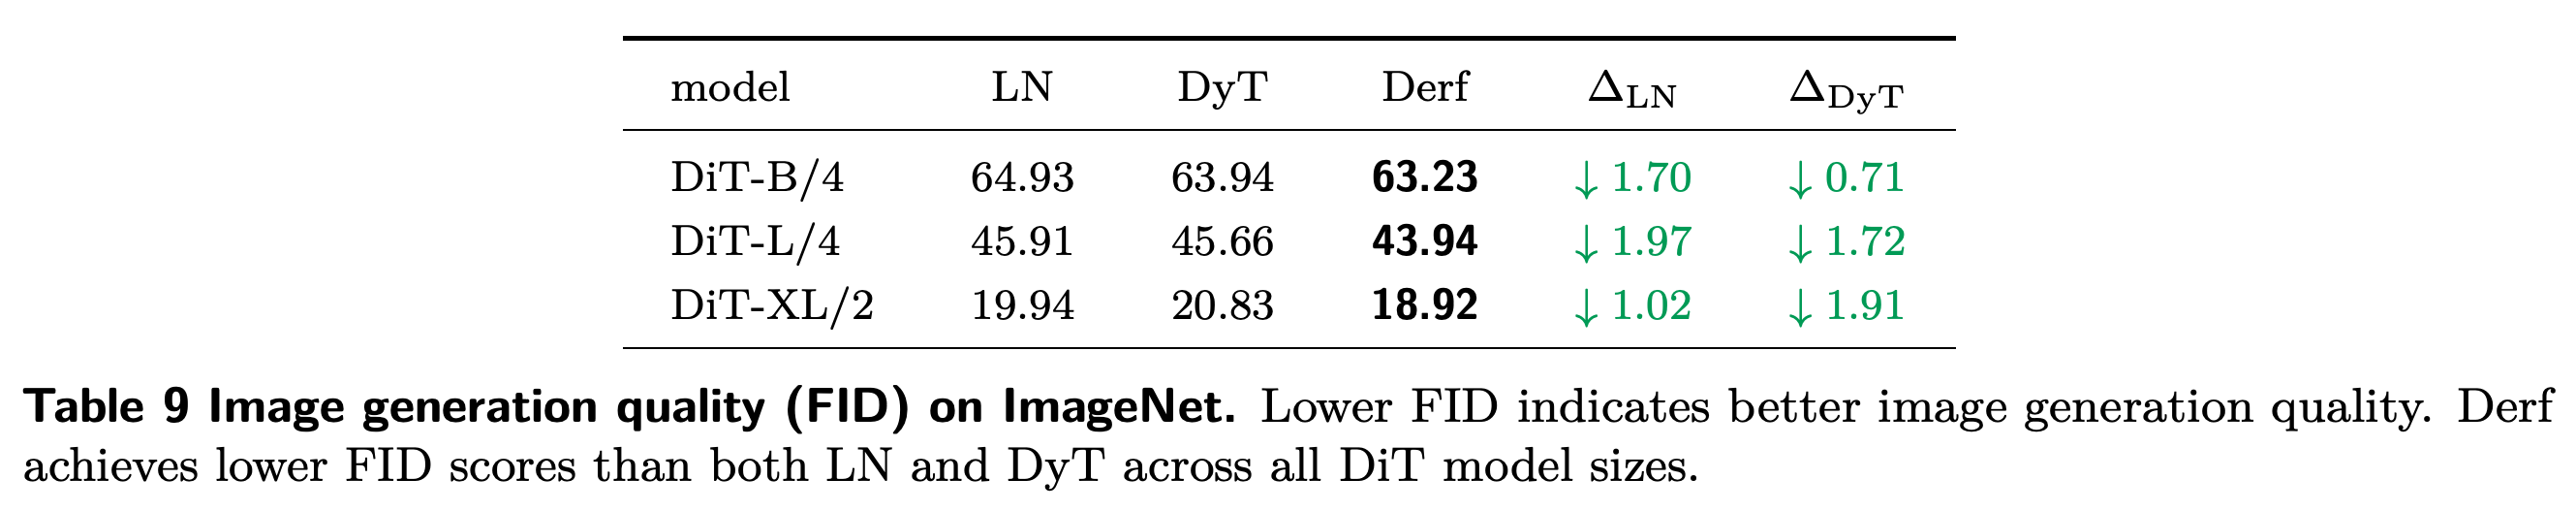
ImageNet 이미지 생성에서 Derf는 DiT-B/4, DiT-L/4, DiT-XL/2에서 각각 FID 63.23, 43.94, 18.92를 기록한다. 같은 순서로 LayerNorm은 64.93, 45.91, 19.94이고 DyT는 63.94, 45.66, 20.83이다. 목표 클래스에 따라 특징의 스케일과 이동량을 조절하는 클래스 조건부 아핀 매개변수는 모든 방법에서 유지한다. Appendix C는 학습률 탐색과 정규화 모델 및 점별 함수 모델에 서로 다르게 적용한 0 초기화 방식을 명시한다.
Derf는 시험한 모든 DiT 크기에서 가장 낮은 FID를 기록한다. DiT-XL/2에서는 Derf가 18.92, LayerNorm이 19.94, DyT가 20.83을 기록한다. 이 크기에서 DyT는 LayerNorm보다 개선되지 않는다.
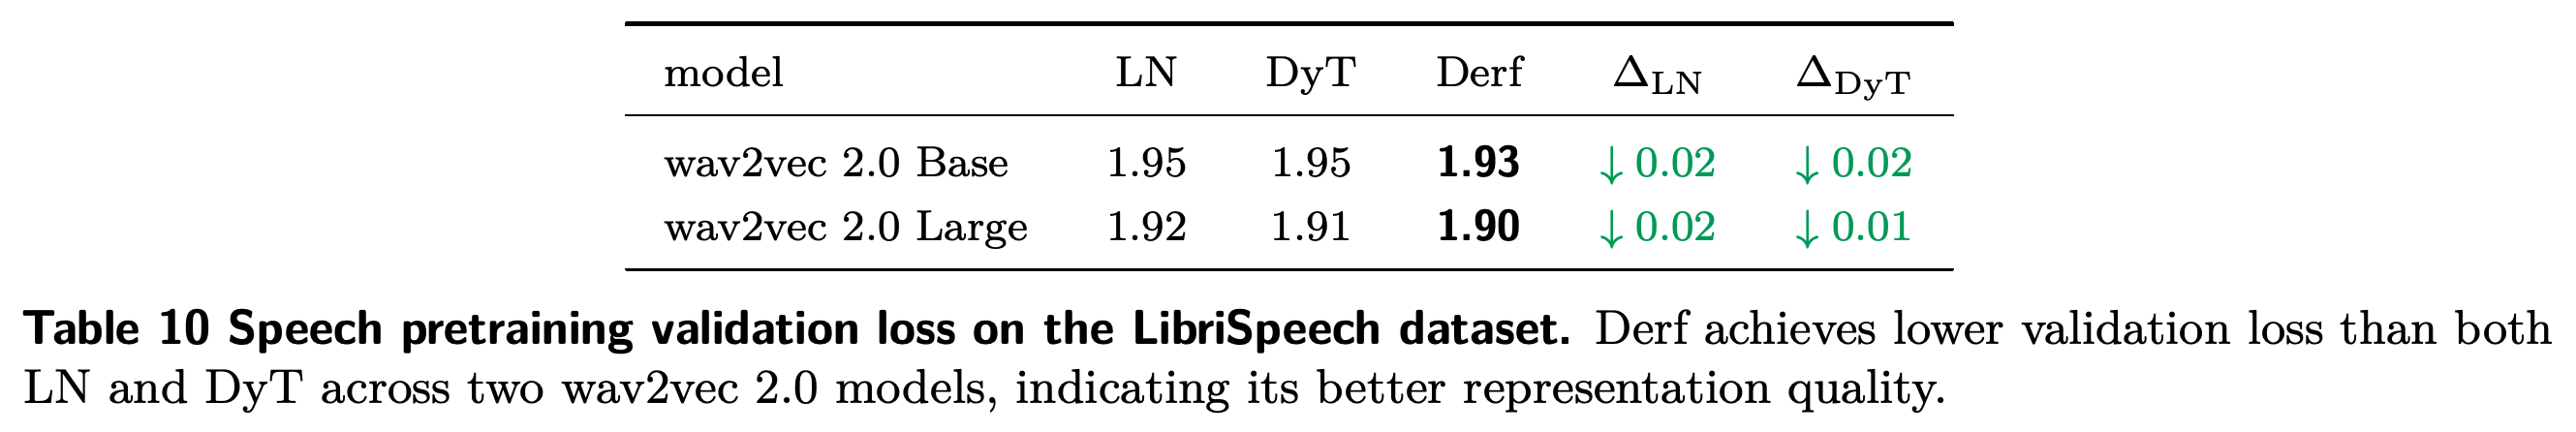
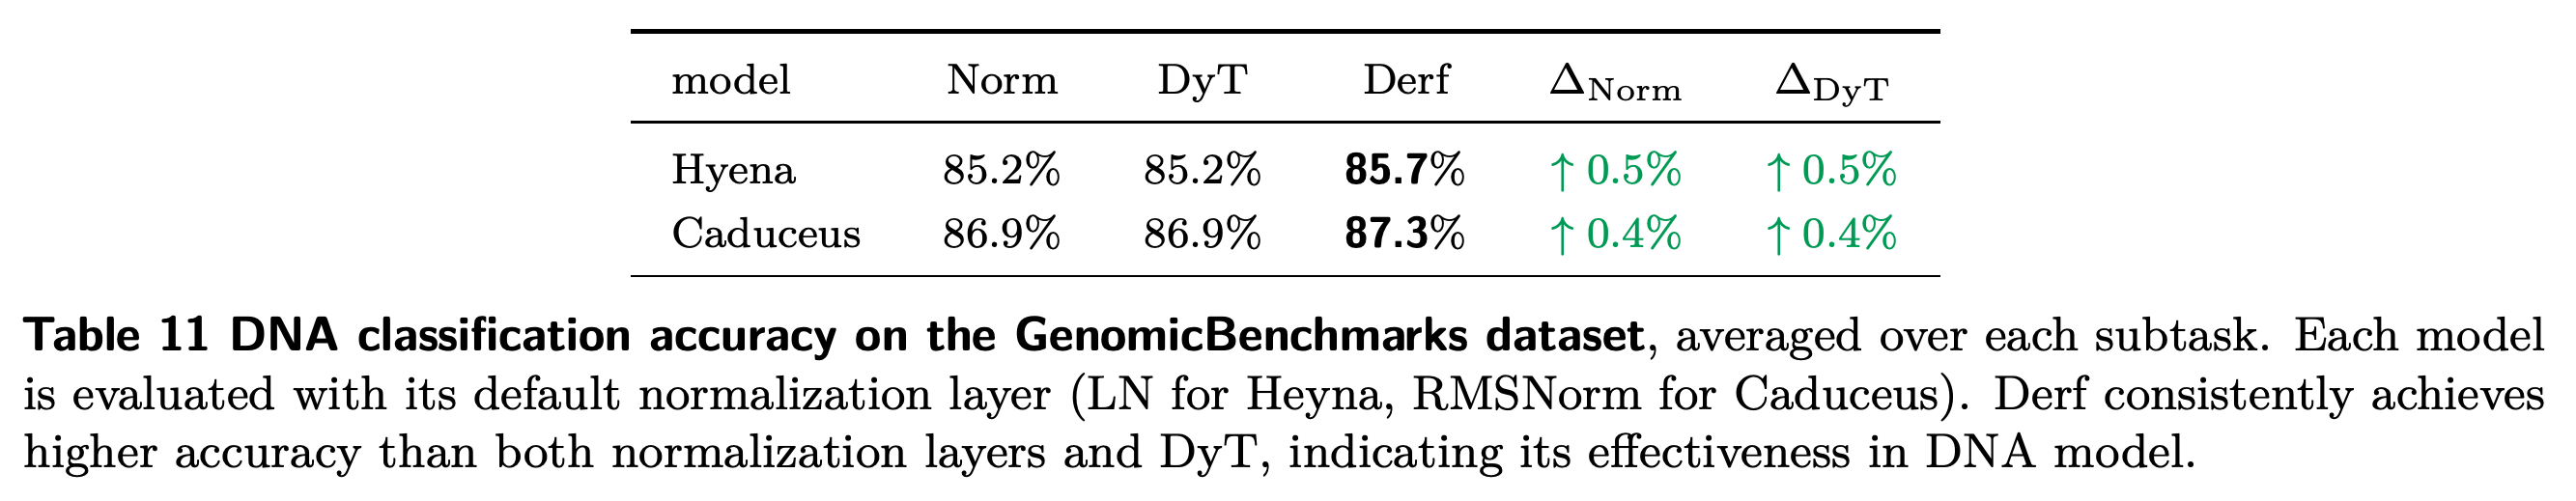
음성 데이터셋 LibriSpeech에서 음성 표현 학습 모델 wav2vec 2.0의 Base와 Large는 Derf를 사용했을 때 검증 손실 1.93과 1.90을 기록한다. LayerNorm은 1.95와 1.92를 기록한다. 유전체 실험에서 다루는 염기 서열인 DNA의 경우, 시퀀스 모델 HyenaDNA와 Caduceus를 인간 참조 유전체 GRCh38로 사전학습하고 GenomicBenchmarks 하위 과제의 평균 분류 정확도로 평가한다. Derf는 85.7%와 87.3%를 달성하며 각 모델의 기본 정규화와 DyT는 모두 85.2%와 86.9%를 기록한다.
Derf는 2가지 모델 크기 모두에서 LayerNorm보다 음성 사전학습 검증 손실을 0.02 낮춘다. 이 표는 사전학습 목적함수를 평가하며 후속 음성 인식 과제의 오류율은 제시하지 않는다.
평균 유전체 분류 정확도는 Hyena에서 85.7%, Caduceus에서 87.3%로 높아진다. 정규화 기준은 각 아키텍처의 기본 설정을 사용하며 Hyena는 LayerNorm, Caduceus는 RMSNorm을 사용한다.
GPT-2 (124M)는 OpenWebText로 사전학습한다. 2가지 점별 함수 방법 모두에서 입력 스케일 초기값을 탐색한 뒤, Derf는 LayerNorm과 같은 검증 손실 2.94를 기록하고 DyT의 2.97보다 낮은 손실을 얻는다. 보고된 언어 모델 실험에서 LayerNorm과 동등한 결과를 확인한다.
Derf와 LayerNorm은 모두 검증 손실 2.94를 보고하며 DyT는 2.97을 보고한다. 초기화를 조정한 뒤의 언어 모델 결과는 LayerNorm과 동등한 성능을 보여 준다.
6.1 Stronger Generalization or Better Fitting?
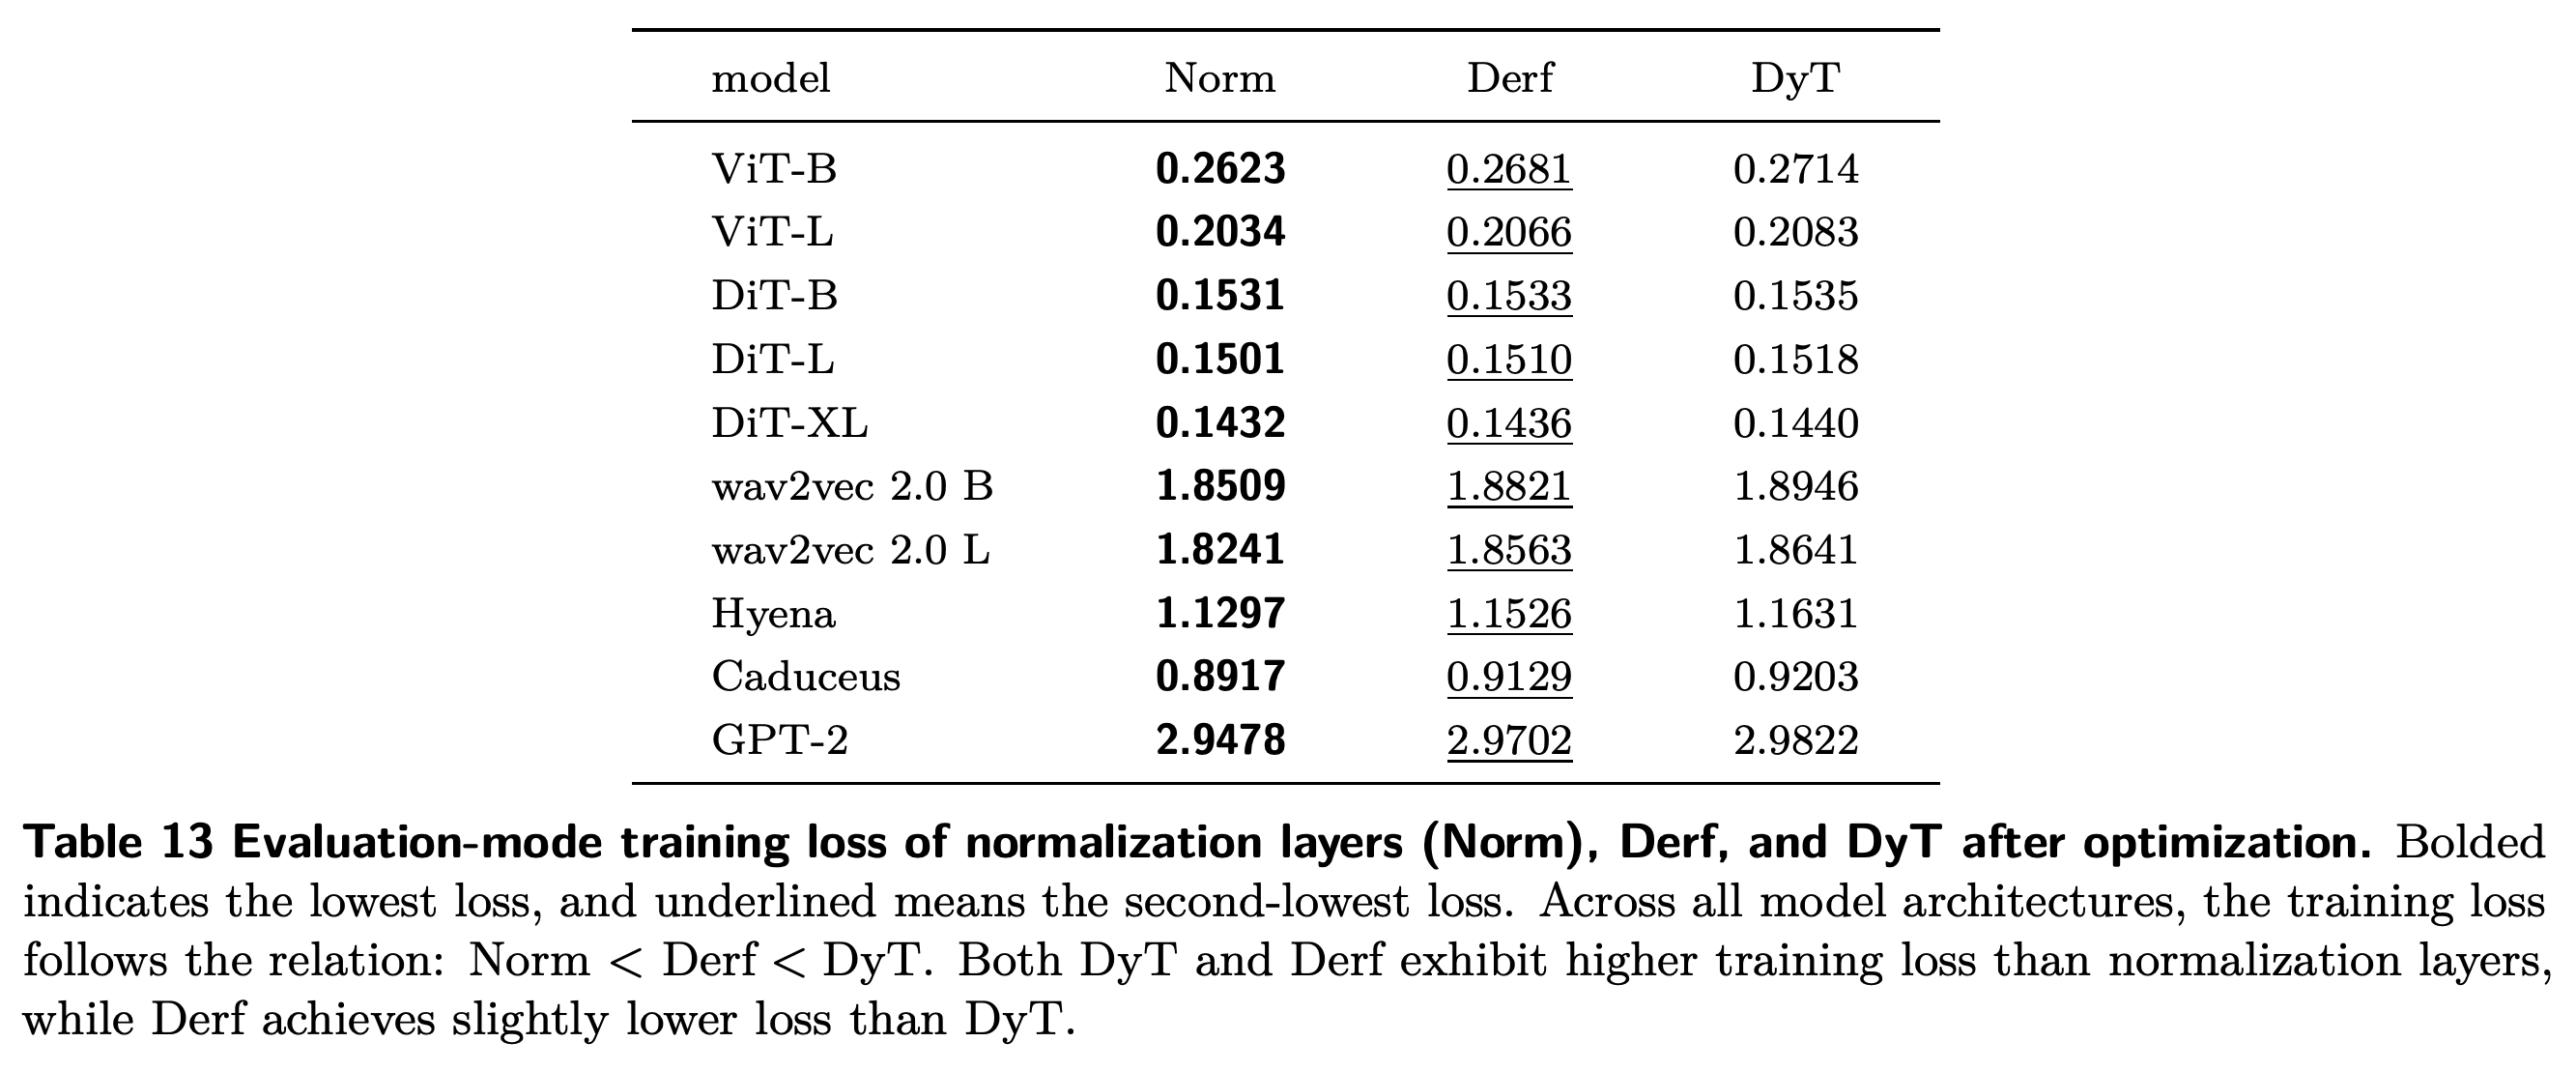
학습 데이터에 대한 적합 능력과, 보지 않은 데이터에서의 성능인 일반화를 구분하기 위해 저자들은 최적화가 끝난 뒤 평가 모드에서 학습 데이터 손실을 계산한다. 모델을 무작위로 교란하는 학습 절차인 확률적 정규화가 적용된 경우 이를 끄고, 테스트 시점의 전처리를 사용한다. 보고된 모든 모델의 학습 손실은 Norm < Derf < DyT 관계를 보인다. 예를 들어 ViT-Base의 손실은 각각 0.2623, 0.2681, 0.2714다. 측정한 학습 손실이 더 높으면서 평가용으로 남겨 둔 데이터에서 성능이 더 좋다는 결과는 정규화 대비 일반화 개선이라는 해석을 뒷받침한다. 다만 연산자 자체가 과적합을 줄인다는 암묵적 정규화 설명은 가설로 남는다.
모든 행에서 평가 모드의 학습 손실은 정규화가 가장 낮고, 그다음은 Derf, DyT 순이다. 따라서 Derf의 평가 성능 개선이 정규화보다 낮은 측정 학습 손실과 함께 나타나지는 않는다. 다만 이 비교로 원인을 분리해 확인할 수는 없다.
7 Analysis
분석에서는 Derf의 성능에 학습 가능한 이동량 s와 기본 함수가 각각 얼마나 기여하는지 살펴본다. s를 제거하는 경우, 스칼라 s를 채널별 벡터로 바꾸는 경우, 고정된 스케일 조정으로 tanh를 변환해 erf를 근사하는 경우를 비교한다.
7.1 Effect of s
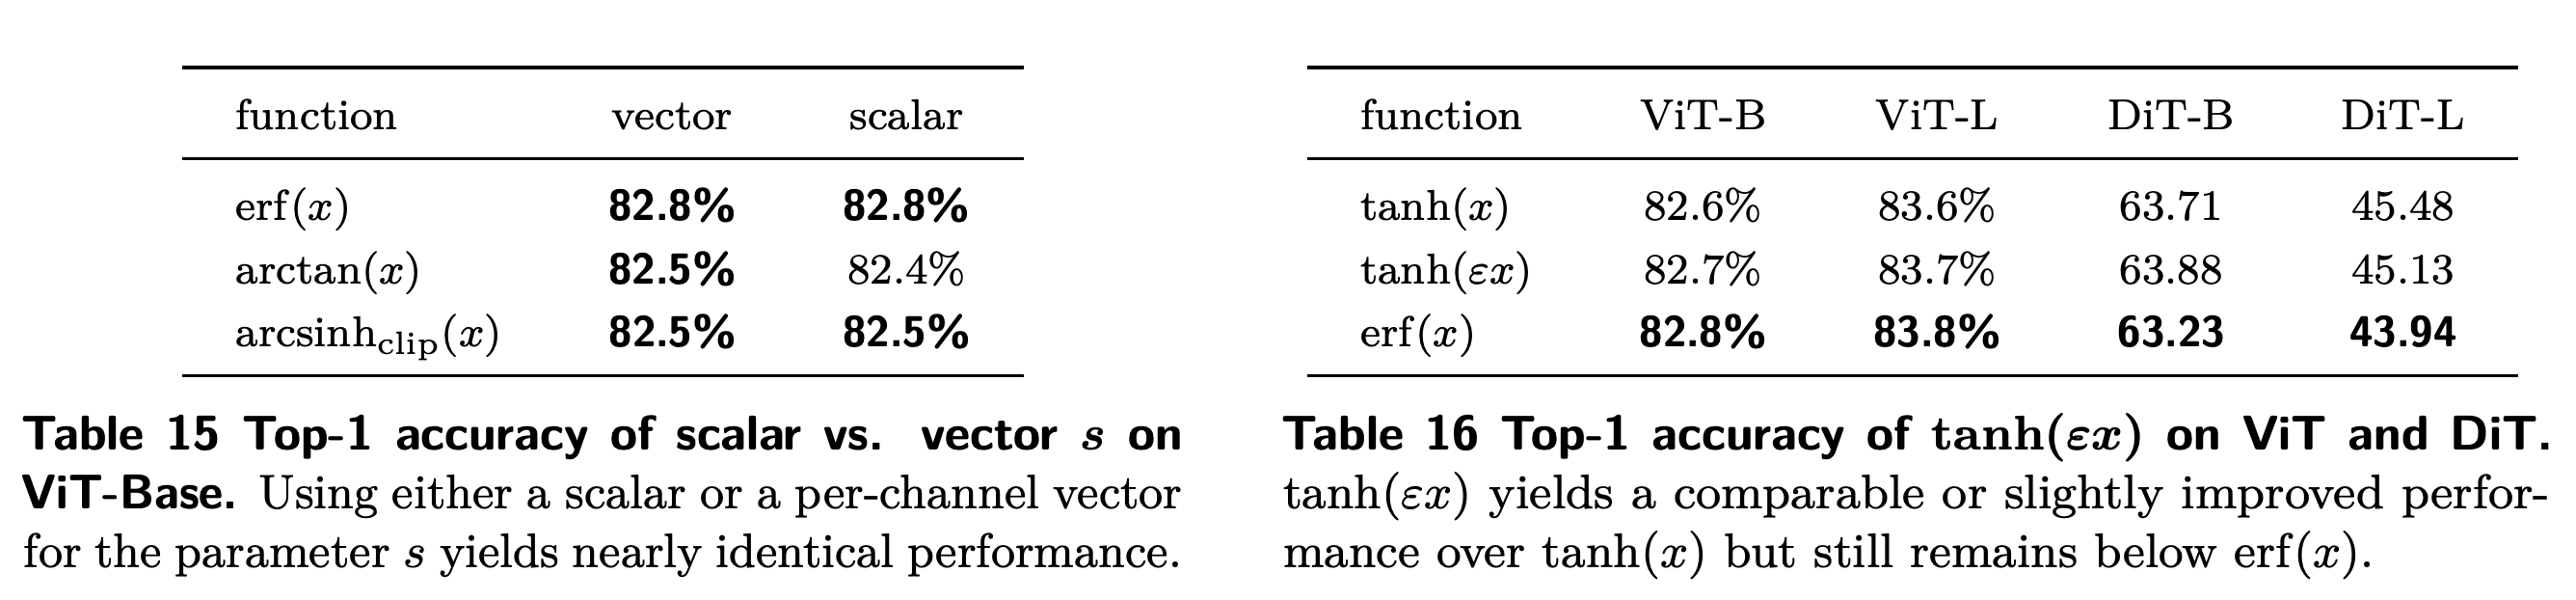
Table 14에서 s를 추가하면 시험한 모든 함수의 보고된 2개 지표가 모두 개선된다. erf의 ViT-Base 정확도는 82.6%에서 82.8%로 높아지고, DiT-B/4 FID는 63.39에서 63.23으로 낮아진다. s가 없는 erf도 s가 없는 tanh보다 좋으므로 이동량만으로 Derf의 우위를 모두 설명할 수는 없다. erf는 스칼라 이동량과 벡터 이동량에서 모두 82.8%를 기록하며 이 결과는 해당 실험에서 더 단순한 스칼라 설계를 뒷받침한다.
학습 가능한 이동량을 추가하면 보고된 6개 함수 모두에서 분류 정확도와 생성 FID가 개선된다. 이동량이 없는 erf도 이동량이 없는 tanh보다 좋으므로, 함수 선택의 기여와 추가 매개변수의 기여를 구분할 수 있다.
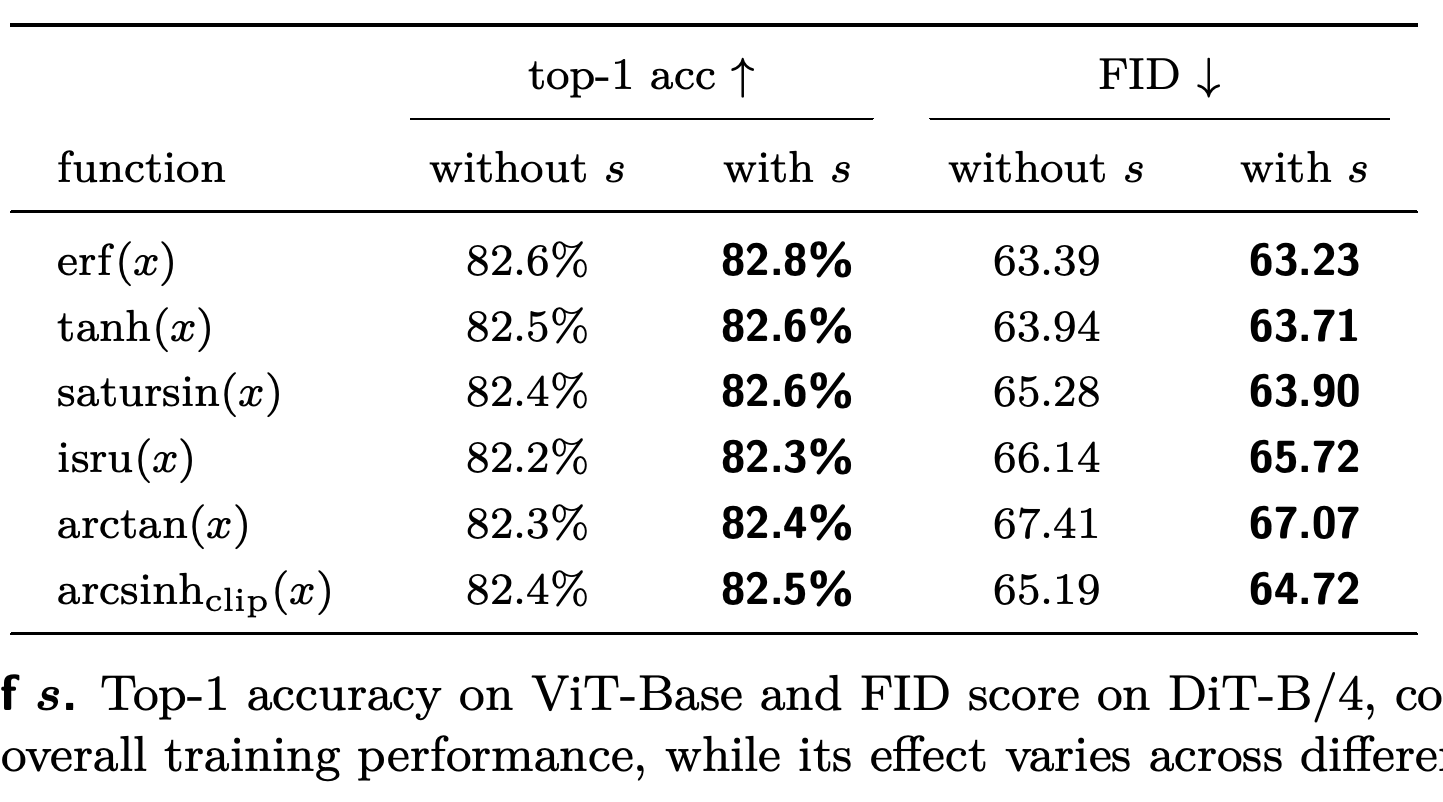
erf와 클리핑한 arcsinh는 스칼라 이동량과 채널별 벡터 이동량에서 보고된 정확도가 같으며 arctan은 0.1 percentage-point 차이를 보인다. 이 결과는 시험한 모델에서 스칼라 선택을 뒷받침하지만 통계적 동등성을 입증하지는 않는다.
7.2 Approximating Derf
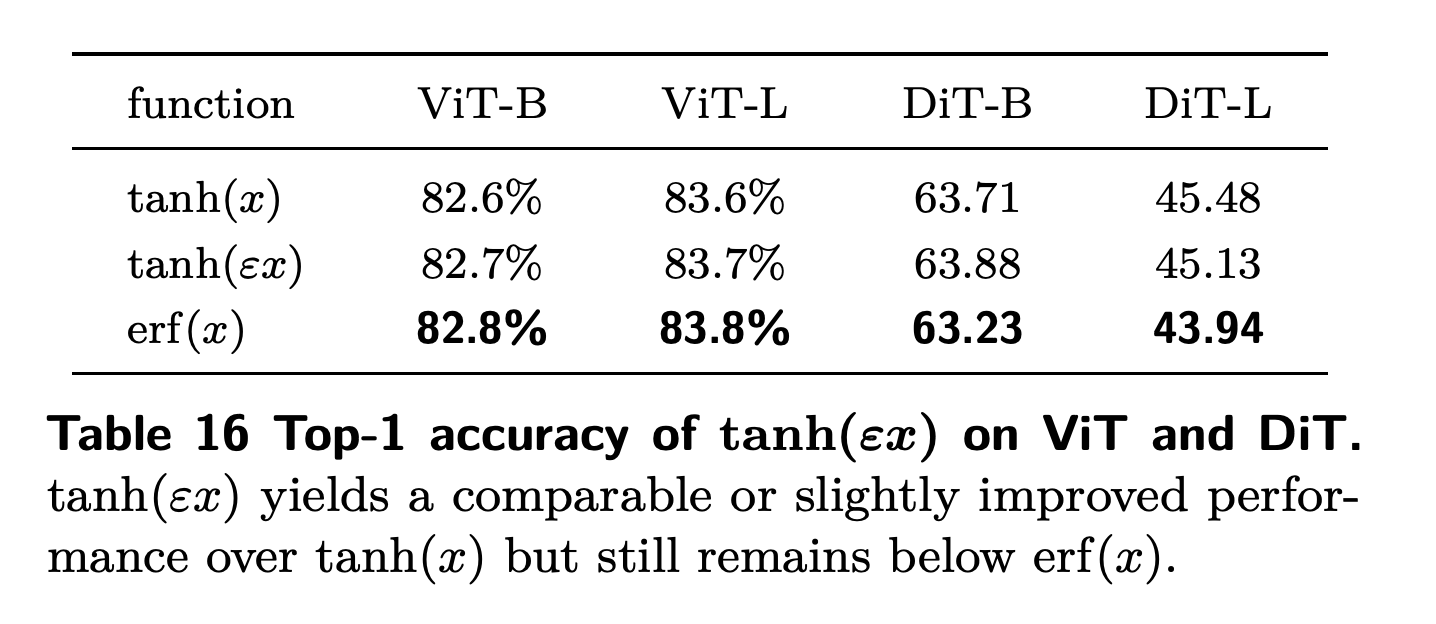
저자들은 실수 전체에서 |tanh(εx) − erf(x)|의 적분을 최소화해 \(\varepsilon\approx1.205\)를 선택한다. 스케일을 조정한 tanh는 ViT-Base와 ViT-Large에서 82.7%와 83.7%를 기록하며 erf의 82.8%와 83.8%보다 낮다. DiT-B/4 FID도 63.88로, 스케일을 조정하지 않은 tanh의 63.71보다 나빠진다. 고정된 스케일 조정으로는 erf의 보고된 성능에 도달하지 못한다.
스케일을 조정한 tanh는 모든 ViT 정확도와 DiT-L FID를 소폭 개선하지만 DiT-B FID는 63.71에서 63.88로 나빠진다. erf는 4개 열 모두에서 가장 좋은 결과를 유지하므로, 고정된 근사로는 erf의 경험적 우위를 재현하지 못한다.
8 Related Work
관련 연구에서는 정규화 변형, 기울기 흐름과 손실 곡면 형태에 기반한 설명, 초기화, 활성화 함수, 기울기 클리핑, 아키텍처 변경을 사용하는 정규화 없는 접근법을 다룬다. Derf는 DyT가 도입한 점별 함수 대체 방식을 따르며, 통제된 함수 성질 분석과 실험을 통한 오차 함수 선택을 연구 기여로 제시한다.
9 Conclusion
결론에서는 영 중심성, 유계성, 중심 민감도, 단조성을 유용한 설계 성질로 제시하고 Derf를 평가한 함수 중 가장 좋은 함수로 소개한다. 보고된 표는 시험한 비전, 음성, 유전체 설정에서의 개선과 언어 모델에서 LayerNorm과 동등한 결과를 뒷받침한다.
부록
- A Property Analysis Details에는 A.1 Zero-centeredness, A.2 Center Sensitivity, A.3 Monotonicity가 포함된다. 추가 학습 곡선에서 작은 수평 이동은 이동이 없는 기준 곡선을 거의 그대로 따른다. 수직 이동이 커지거나 0 근처 평탄 구간이 넓어지면 손실이 높아지며, 증가 또는 감소하는 단조 함수는 시험한 비단조 함수보다 낮은 학습 손실을 기록한다.
- B Function Search Details는 16개 후보를 자연 함수 3개, 변환한 기본 함수 6개, 클리핑한 비유계 함수 5개, 기본 함수를 그 절댓값에 1을 더한 값으로 나누는 표준 비율 함수 2개로 분류한다. 자연 함수에는 erf, tanh, 스케일을 조정한 arctan이 포함된다. 클리핑은 비유계 함수의 출력을 [−1, 1]로 제한하며 비율 형태 \(\frac{f(x)}{|f(x)|+1}\)은 포화하는 후보 smoothsign과 saturlog를 만든다.
- C Experimental Settings는 ViT의 학습 기간을 300 epochs, 유효 배치 크기를 4096, 기본 학습률을 4e-3으로 명시한다. DiT는 80 epochs와 배치 크기 256을 사용하고 모든 방법에서 학습률 {1e-4, 2e-4, 4e-4} 중 가장 좋은 결과를 선택한다. 0 초기화는 LayerNorm 모델에만 유지한다. 음성 실험에서는 특징을 그룹으로 묶어 정규화하는 초기 GroupNorm과 합성곱 특징 추출기 뒤의 LayerNorm을 유지하며 비교하는 모든 모델을 32-bit 부동소수점 정밀도인 fp32로 실행한다.
- C Experimental Settings의 나머지 설정에서 HyenaDNA와 Caduceus는 각각 시퀀스 길이 1024와 131072, 학습 기간 10000 steps와 50000 steps를 사용한다. GPT-2는 300,000 iterations와 블록 크기 1024를 사용하며 attention 관련 계층의 α 초기값은 {0.5, 1.0, 2.0, 4.0}, 나머지 계층의 초기값은 {0.1, 0.3, 0.5, 1.0}에서 탐색한다. 보고된 언어 모델 결과는 시험한 초기값 조합에서 얻은 최저 검증 손실이다.
- D Additional Results는 적용 가능한 경우 RMSNorm과 GroupNorm을 비교한다. 추가 비전, 생성, 음성, 유전체 비교에서는 Derf가 가장 좋은 결과를 기록한다. GPT-2 검증 손실은 Derf와 LayerNorm 모두 2.94, RMSNorm은 2.95, DyT는 2.97이다. Caduceus의 경우 Table 25는 LayerNorm의 87.0%와 기본 RMSNorm의 86.9%를 구분하며 Derf는 87.3%를 기록한다.
- E Loss Calculation Details는 데이터 증강과 확률적 정규화를 끈 뒤 전체 학습 데이터로 ViT 학습 손실을 계산한다. DiT는 대신 처음 100개 학습 배치에서 예측 오차를 제곱한 손실인 diffusion 평균제곱오차를 평균하며 전처리의 무작위 수평 반전을 유지한다. 다른 모델은 전체 학습 데이터를 사용한다. 따라서 적합 능력을 비교하는 데 사용하는 손실 계산 절차는 모델 계열마다 다르다.
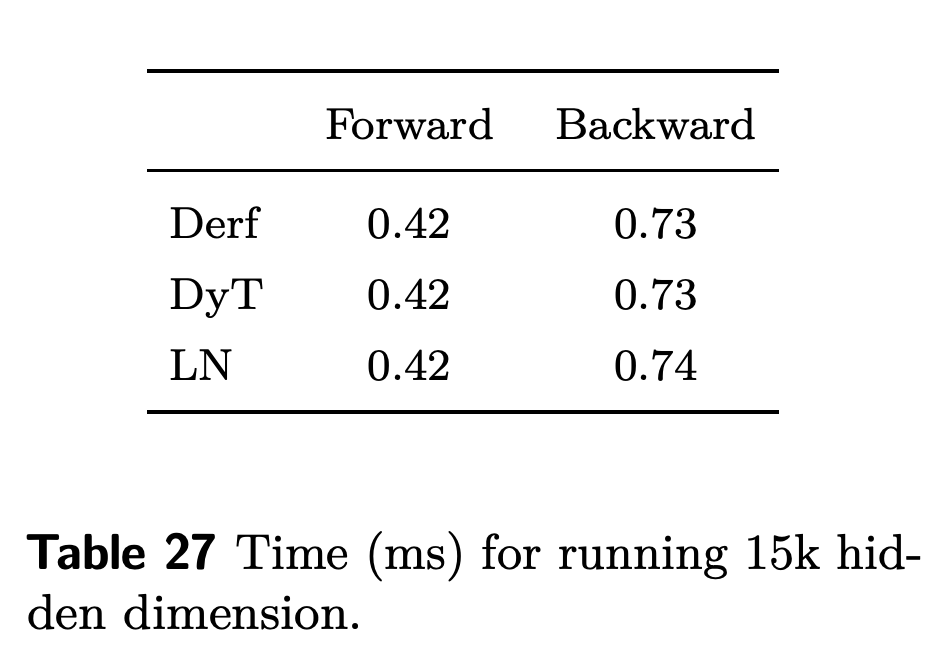
- F Computation Cost는 비교 대상 연산자를 GPU로 구현한 맞춤형 Triton 커널로 단일 계층 연산을 측정한다. 배치 크기, 시퀀스 길이, 정밀도를 맞추고 연산자 융합 수준도 비슷하게 설정한다. 보고된 은닉 차원 15k에서 Derf와 DyT는 각각 순전파 0.42 ms, 역전파 0.73 ms가 걸리며, LayerNorm은 0.42 ms와 0.74 ms가 걸린다. 이 결과는 시험한 설정에서 연산자 실행 시간이 비슷함을 보여 준다. 논문은 모델 전체의 처리량을 측정한 결과를 보고하지 않는다.
짧은 생각
함수 성질 실험은 시험한 ViT 설정에 실용적인 지침을 제공하며 공통 후보 탐색은 이 지침을 만족하는 함수가 실제로 좋은 성능을 내는지 검증한다. 이동량 제거 실험도 erf의 우위가 추가 매개변수에만 기인하지 않음을 보여 준다. 비유계 함수도 학습에 성공하고 작은 이동을 허용한다는 결과를 고려하면, 이러한 관찰을 보편적인 수학적 필수 조건으로 볼 수는 없다.
보고된 표에는 서로 다른 무작위 시드로 반복 실행한 결과의 불확실성 추정치가 없다. 따라서 0.1 percentage point 또는 검증 손실 0.01 같은 작은 차이의 변동성은 정량화되지 않았다. GPT-2는 매개변수 124M에서만 평가하고 음성 모델은 입력 관련 정규화를 유지하며 DiT는 연산자 계열에 따라 초기화를 바꾼다. 이러한 조건은 정규화의 완전한 제거나 계층 대체만으로 얻은 개선에 관한 주장의 범위를 제한한다.
더 높은 학습 손실과 더 좋은 평가 성능은 일반화 개선과 부합하지만 제안한 암묵적 정규화 원리를 직접 분리해 검증하지는 않았다. Derf의 측정된 단일 계층 비용은 대안들과 비슷하다. 따라서 실행 시간 결과는 큰 계산 비용 절감을 가정하지 않고도 보고된 정확도와 손실 개선을 위해 Derf를 사용할 근거를 제공한다.
Derf와 DyT의 단일 계층 실행 시간 곡선은 거의 겹친다. 은닉 차원이 커지면 Derf의 역전파 실행 시간이 LayerNorm보다 유리해지지만 이 그래프는 전체 학습 또는 추론 속도를 측정하지 않는다.
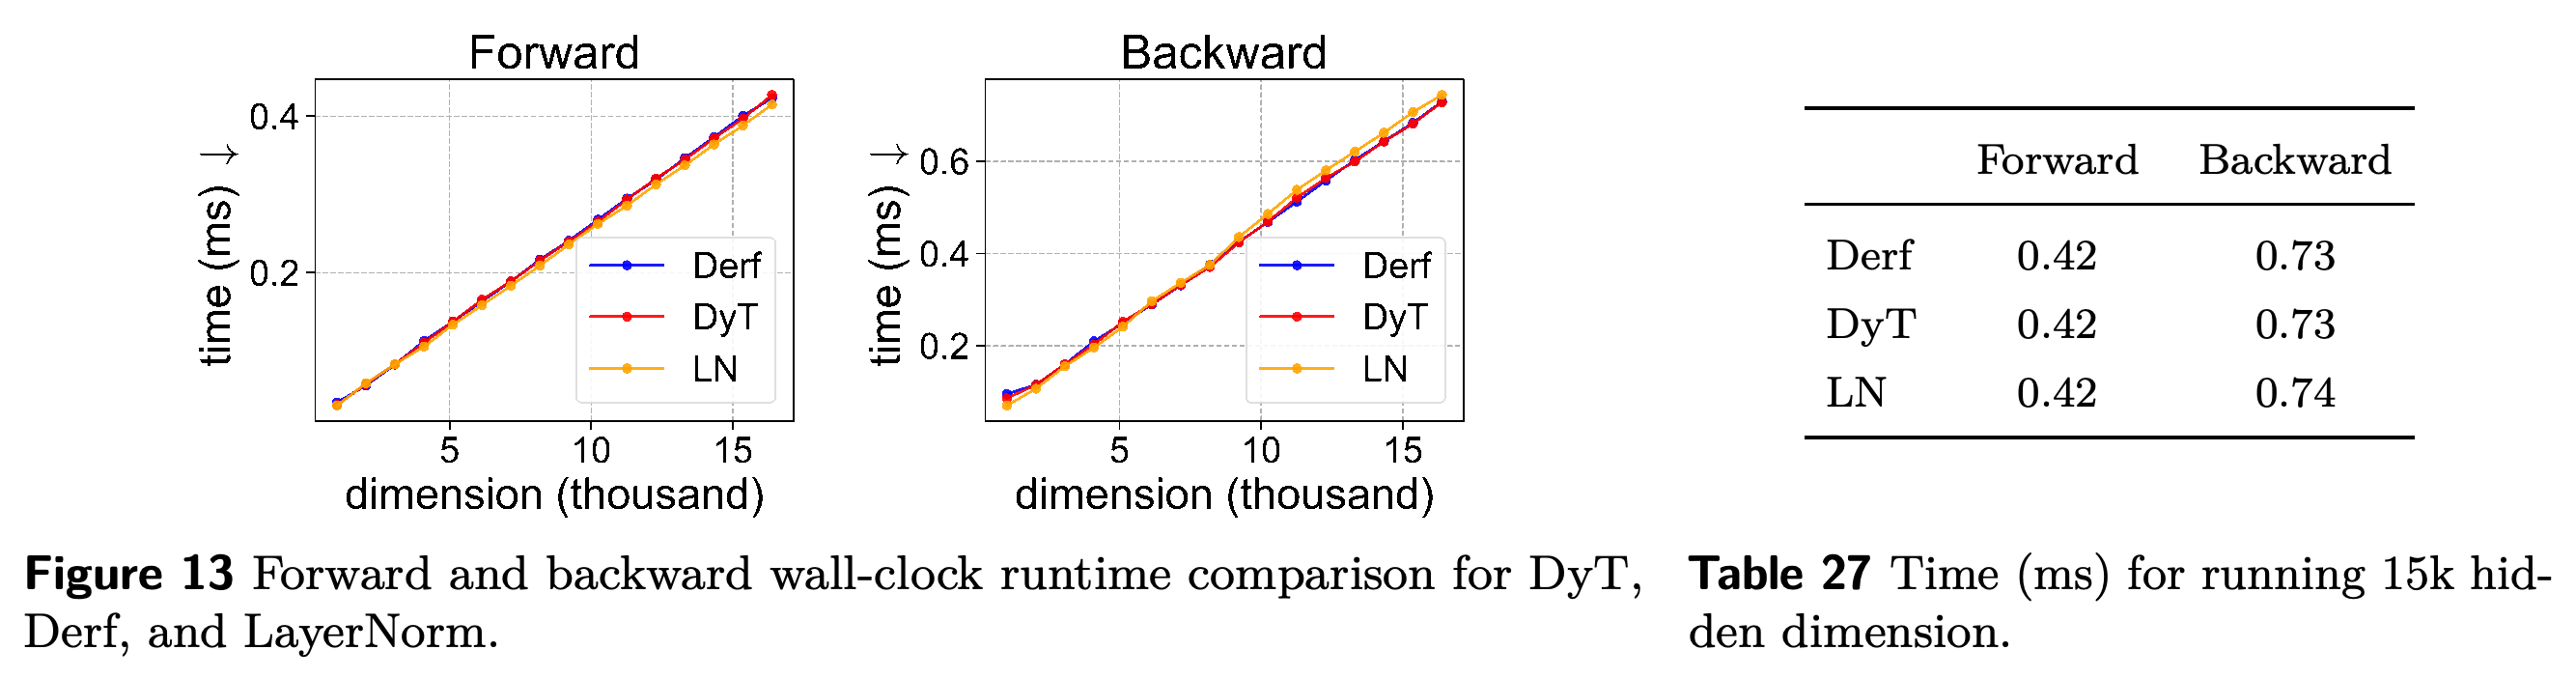
보고된 은닉 차원 15k에서 모든 연산자의 순전파는 0.42 ms가 걸린다. 역전파는 Derf와 DyT가 0.73 ms, LayerNorm이 0.74 ms가 걸린다. 이 수치 차이는 실행 시간이 비슷하다는 해석을 뒷받침하며 큰 폭의 가속을 보여 주지는 않는다.