


Emu3.5: Native Multimodal Models are World Learners 요약 설명
30 Oct 2025 | Paper Review Unified Multimodal Models World Models Diffusion Acceleration Reinforcement Learning목차
이번 글에서는 Emu3.5: Native Multimodal Models are World Learners 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 30일(Arxiv)
- Cui, Yufeng, Chen, Honghao, Deng, Haoge, Huang, Xu, Li, Xinghang, Liu, Jirong, Liu, Yang, Luo, Zhuoyan, Wang, Jinsheng, Wang, Wenxuan, et al.
- BAAI
- 논문 링크
- Github
- Project Page
요약
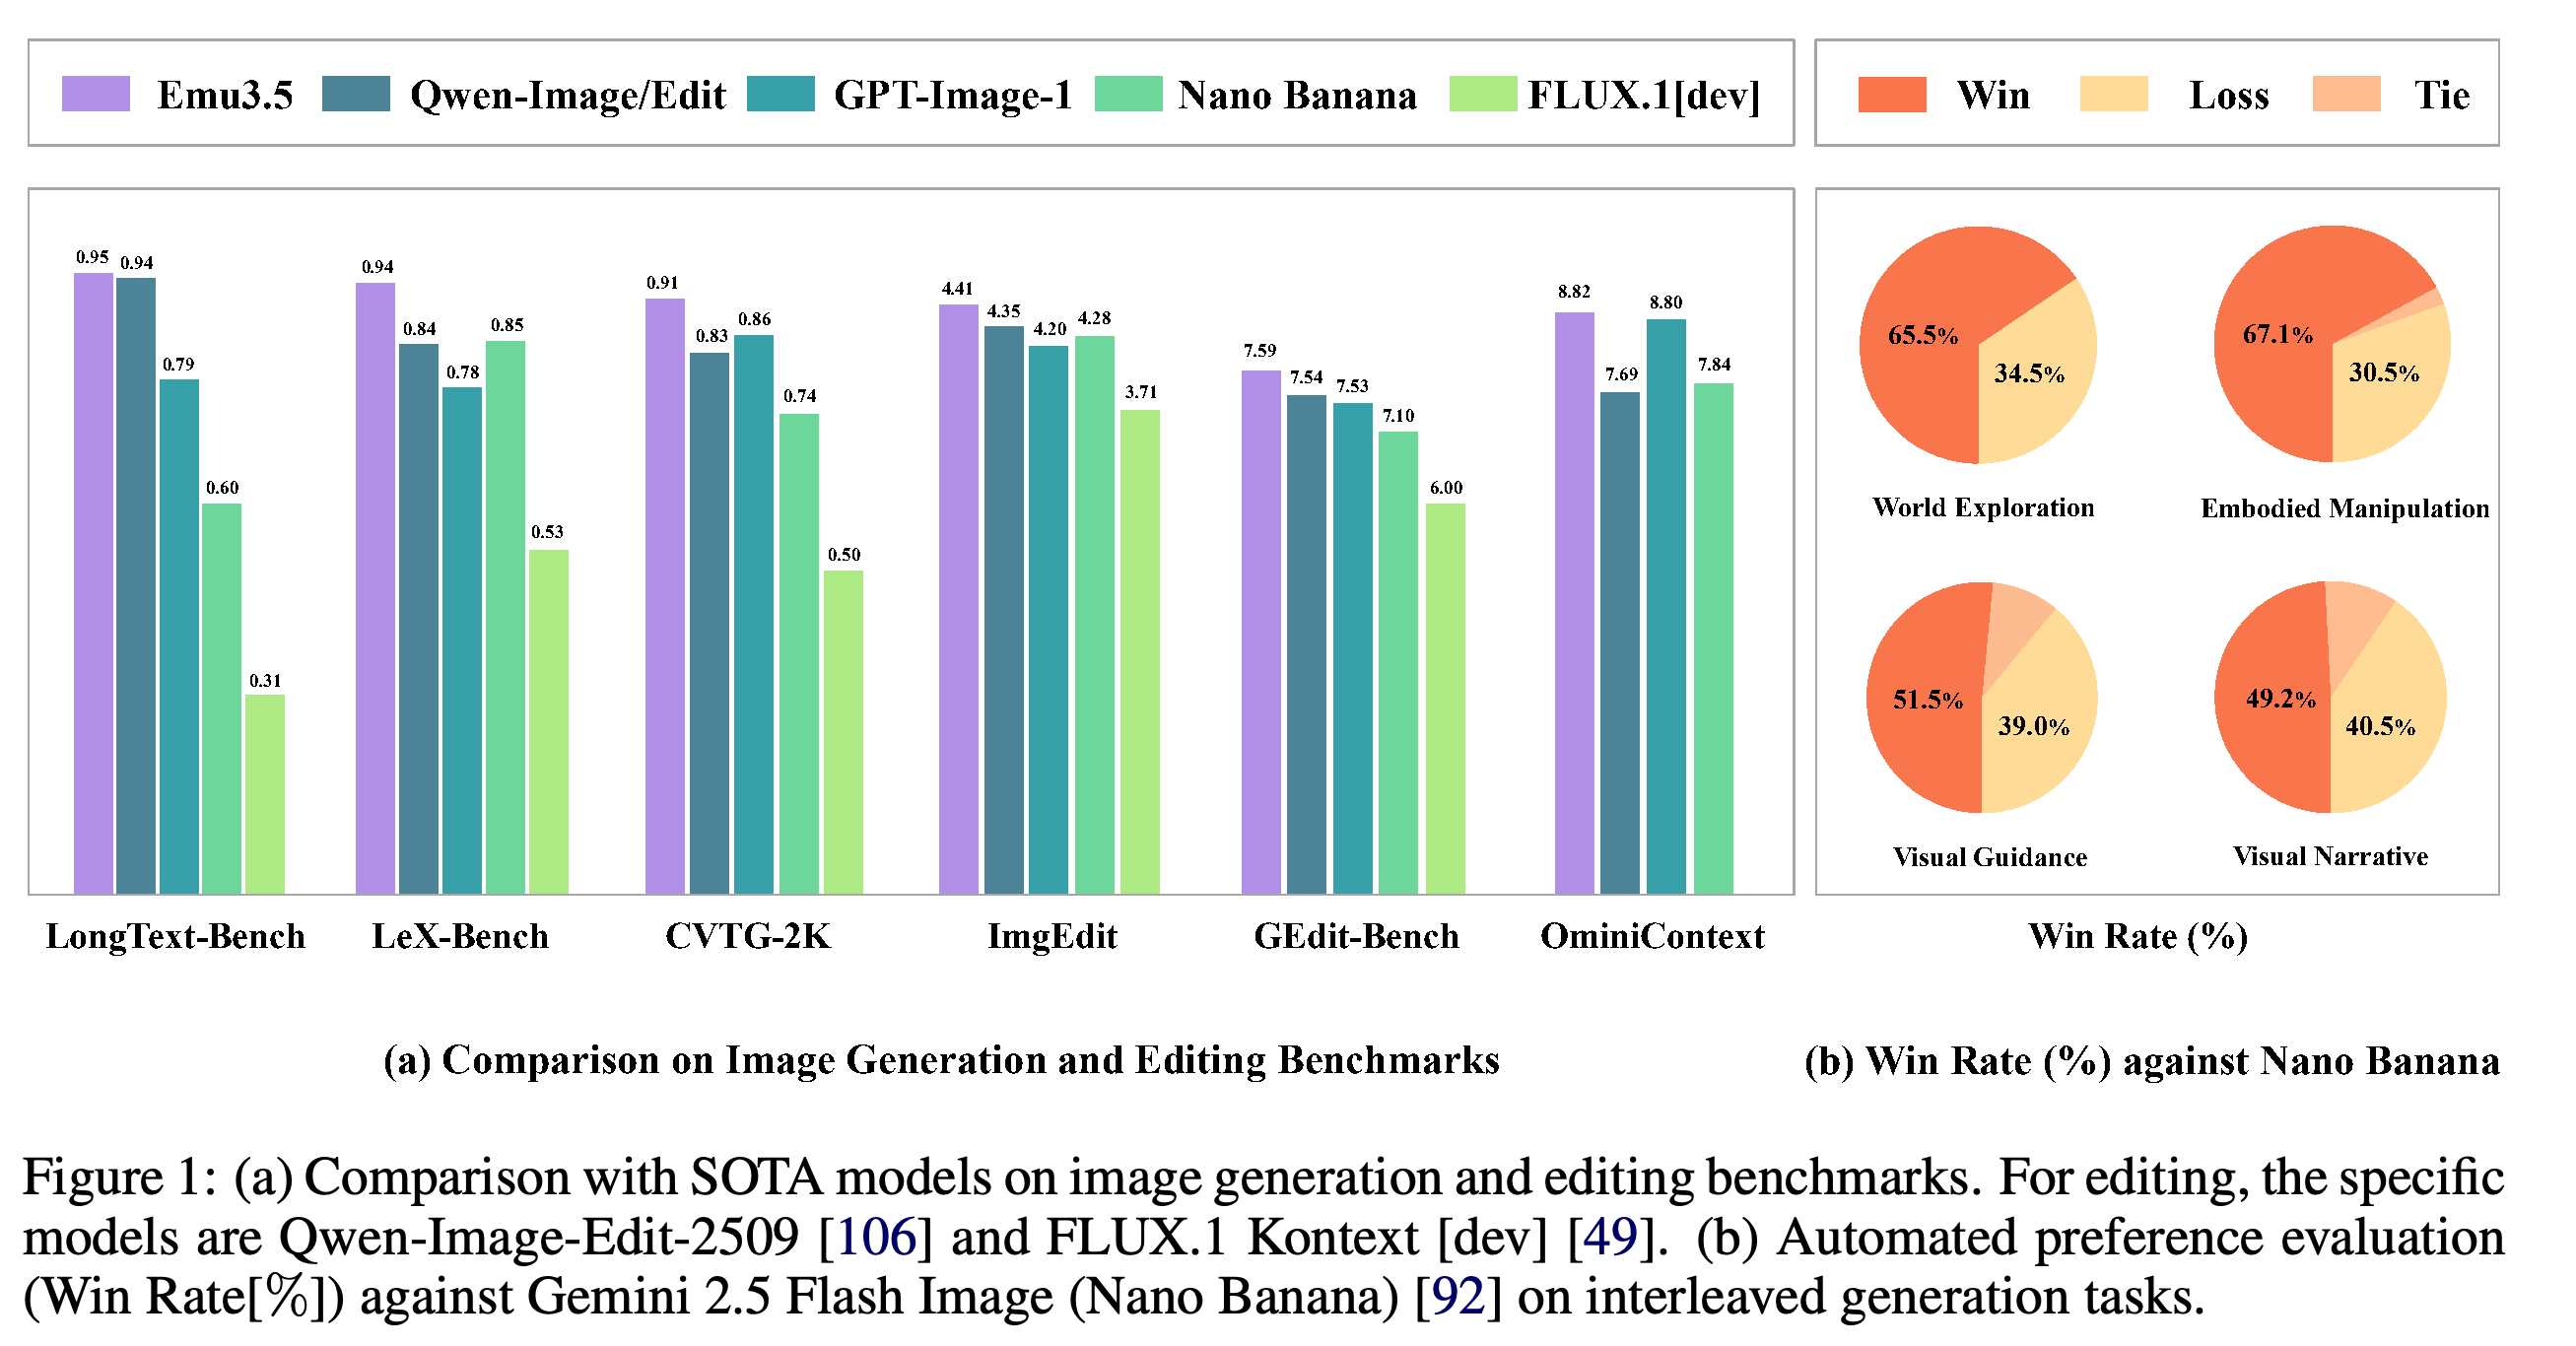
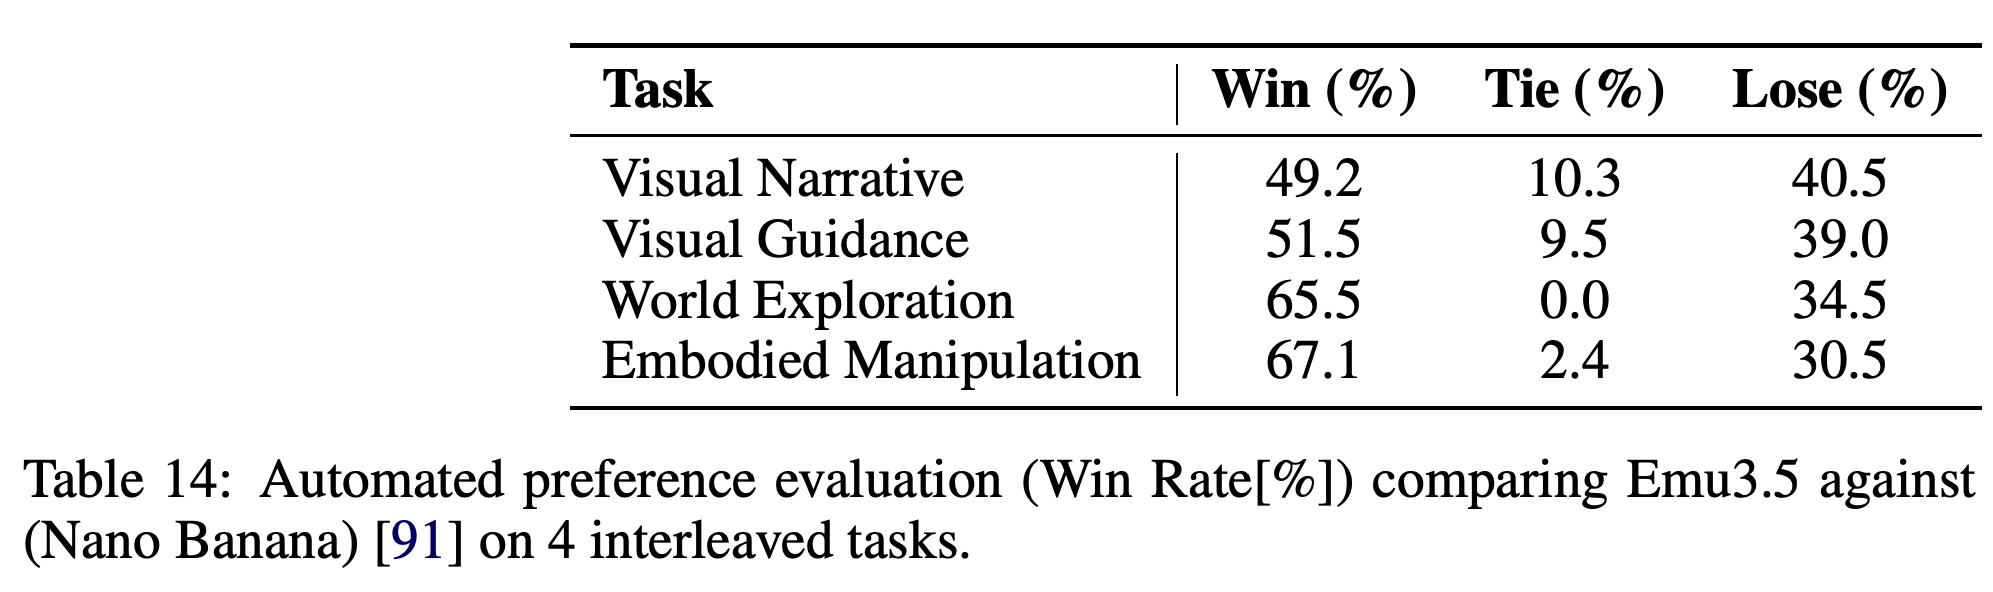
- Emu3.5는 1개 모델로 장면 변화와 객체 간 상호작용을 일관된 이미지와 텍스트 시퀀스로 생성하는 문제를 다룬다. 논문에서 ChatGPT로 수행한 Gemini 2.5 Flash Image 대비 자동 선호도 평가에서 World Exploration의 승률은 65.5%, Embodied Manipulation의 승률은 67.1%다. 전자는 연속으로 생성한 환경 시점을, 후자는 생성한 하위 작업 지시와 로봇 상호작용 이미지를 평가한다.
- 모델은 약 13 trillion개의 멀티모달 토큰으로 다음 토큰 예측을 학습한다. 토큰은 이산적인 텍스트 또는 이미지 요소이며 다음 토큰 예측은 시퀀스의 다음 요소를 예측하는 학습이다. 작업별 예제로 학습하는 지도 미세 조정과 생성 결과의 보상으로 최적화하는 강화학습을 통해 이미지 편집, 삽화가 포함된 이야기, 절차 안내, 장면 예측에 공통 인터페이스를 마련한다.
- Discrete Diffusion Adaptation (DiDA)은 이미지 토큰을 병렬로 반복 개선하는 적응 방법이다. 논문의 학습 및 추론 프레임워크인 FlagScale을 사용하면 1024×1024 이미지 생성 시간이 120 s에서 10 s로 줄어들며, GenEval의 이미지와 텍스트 정합성 점수는 0.86을 유지한다. 다른 보고된 품질 점수는 소폭 하락한다. 장기 시퀀스 평가는 자동 선호도에 의존하며 생성된 조작 시퀀스만으로 실제 로봇 실행의 성공을 입증할 수는 없다.
벤치마크 막대는 텍스트 렌더링과 편집 점수를 요약한다. 선호도 차트에서는 이야기와 안내보다 탐색과 조작의 승률이 더 높다. 벤치마크마다 축의 척도가 다르며, 선호도 결과는 생성된 출력을 Gemini 2.5 Flash Image와 비교한 것이다.
1 Introduction
서론은 긴 이미지와 텍스트 시퀀스의 학습, 범용 멀티모달 상호작용 지원, 수천 개 시각 토큰의 효율적인 디코딩이라는 3가지 연관된 과제를 제시한다. 인터넷 동영상은 시간순 프레임과 전사문을 제공하며 이를 통해 이미지와 텍스트가 같은 시퀀스에 섞이는 교차 생성을 학습한다. Emu3.5는 이 학습 데이터에 통합 사후 학습과 병렬 이미지 추론을 결합한다.
2 Emu3.5
Emu3.5는 텍스트와 시각 정보를 1개의 이산 시퀀스로 표현하고 디코더 전용 트랜스포머로 처리한다. 이 모델은 앞선 시퀀스 요소를 바탕으로 출력을 예측한다. 인터페이스는 이미지와 텍스트가 섞인 시퀀스를 입력받고 출력하며 별도의 시각 디코더가 이미지 코드를 이미지나 연속적인 동영상으로 변환한다.
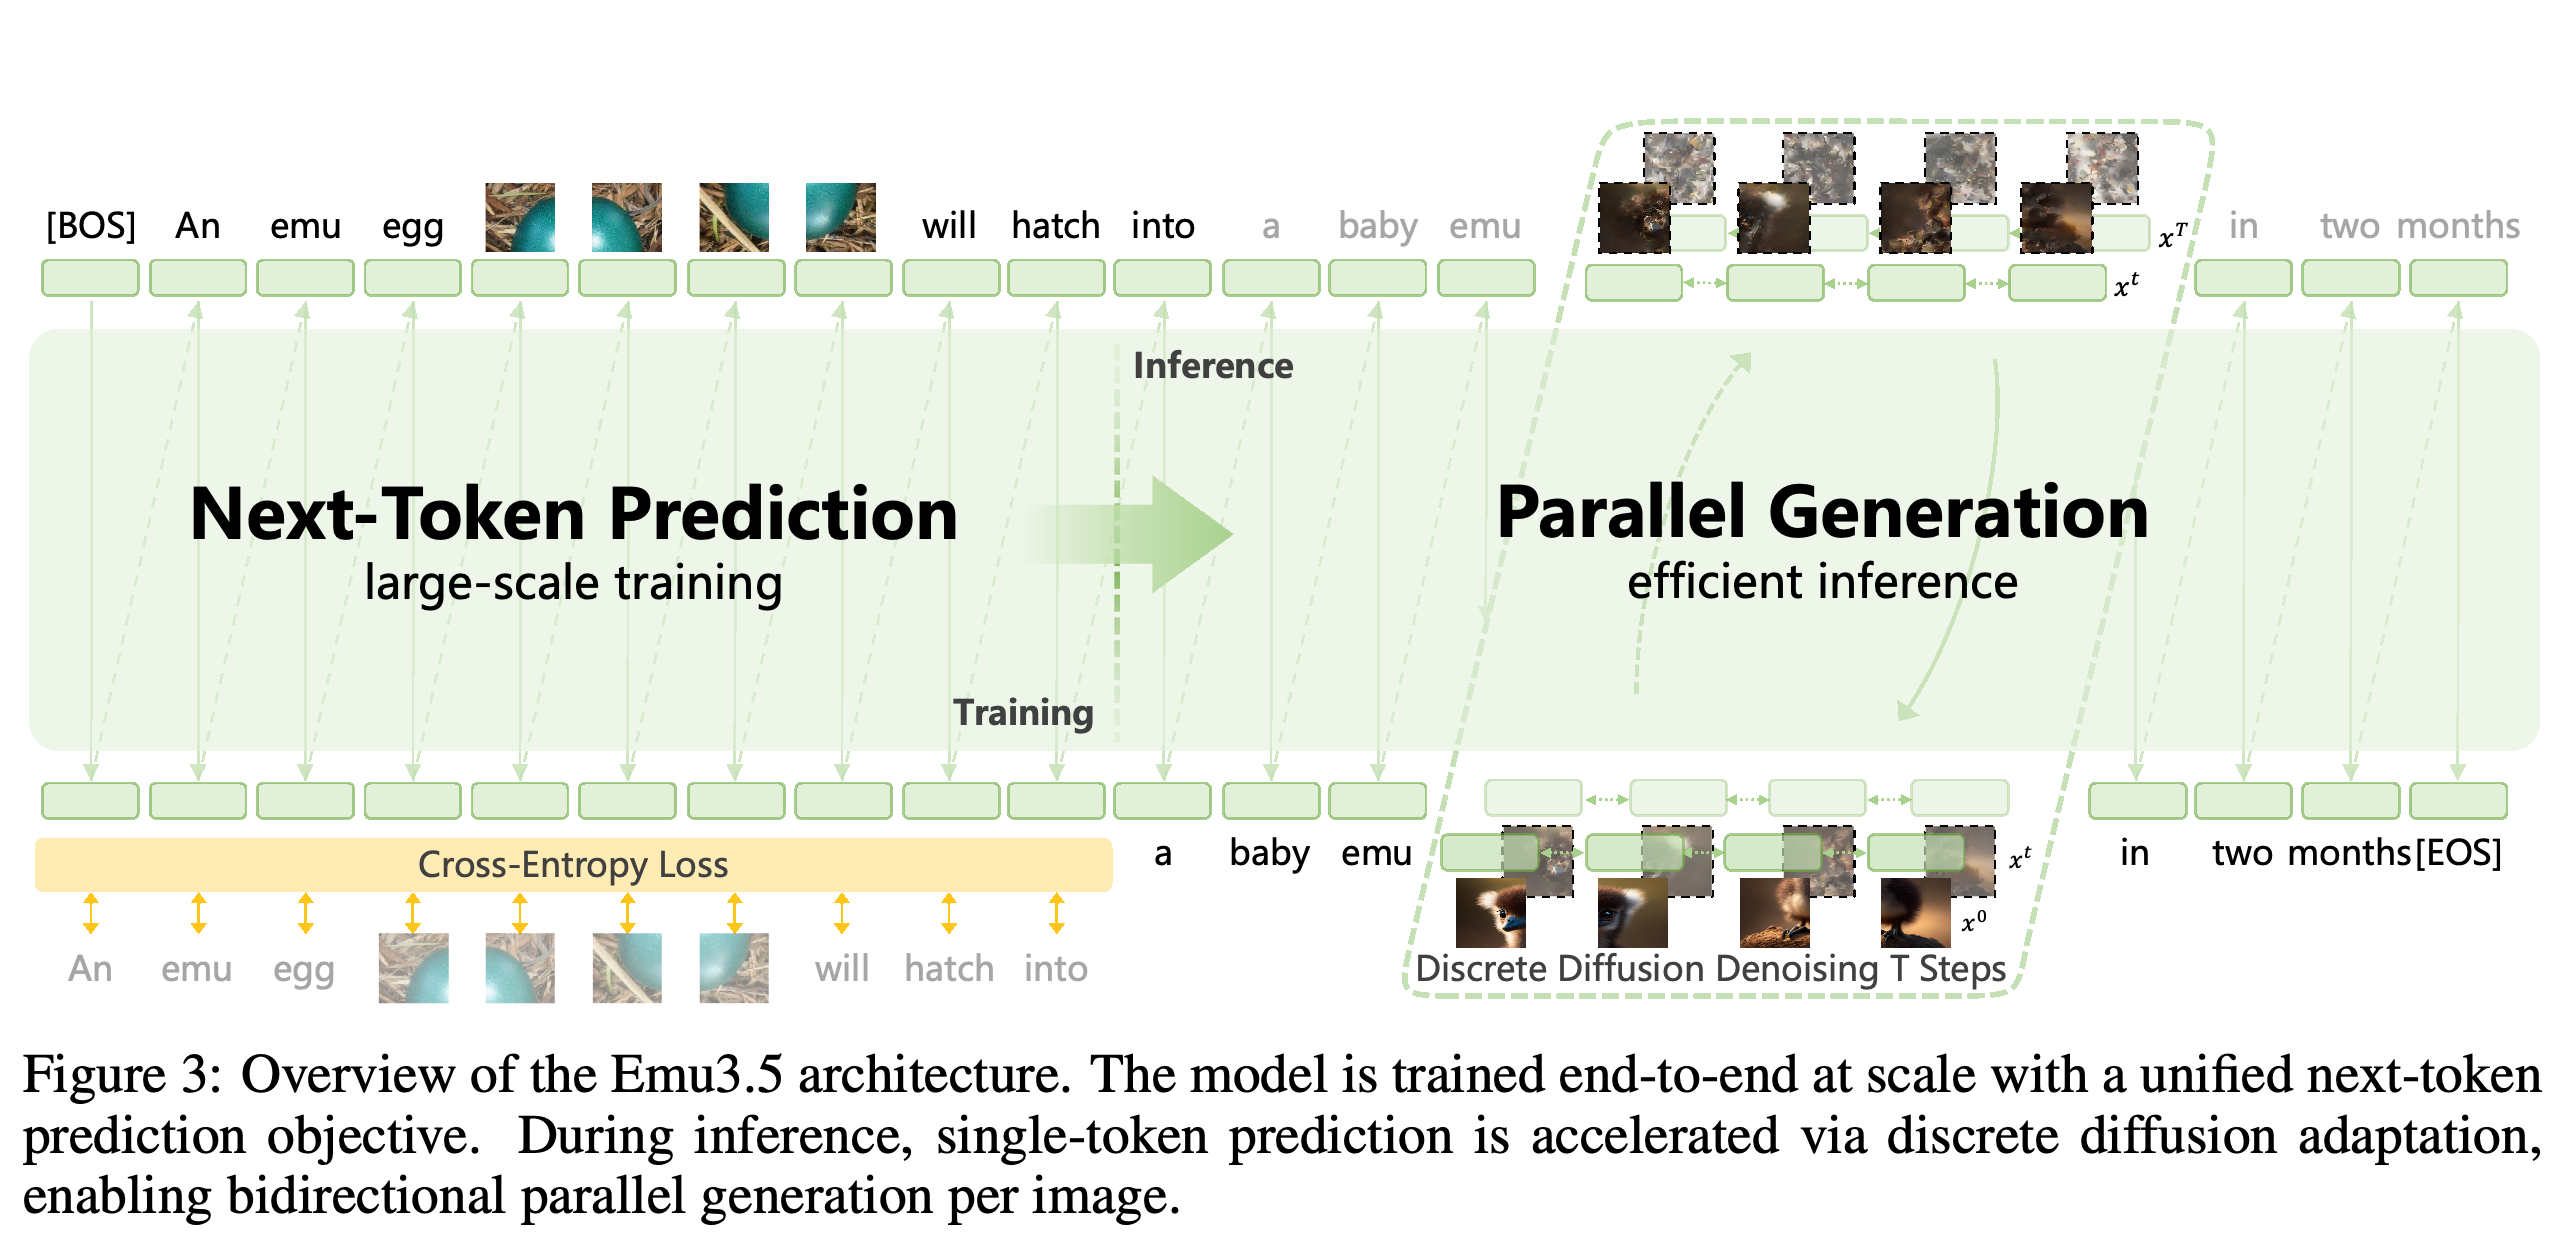
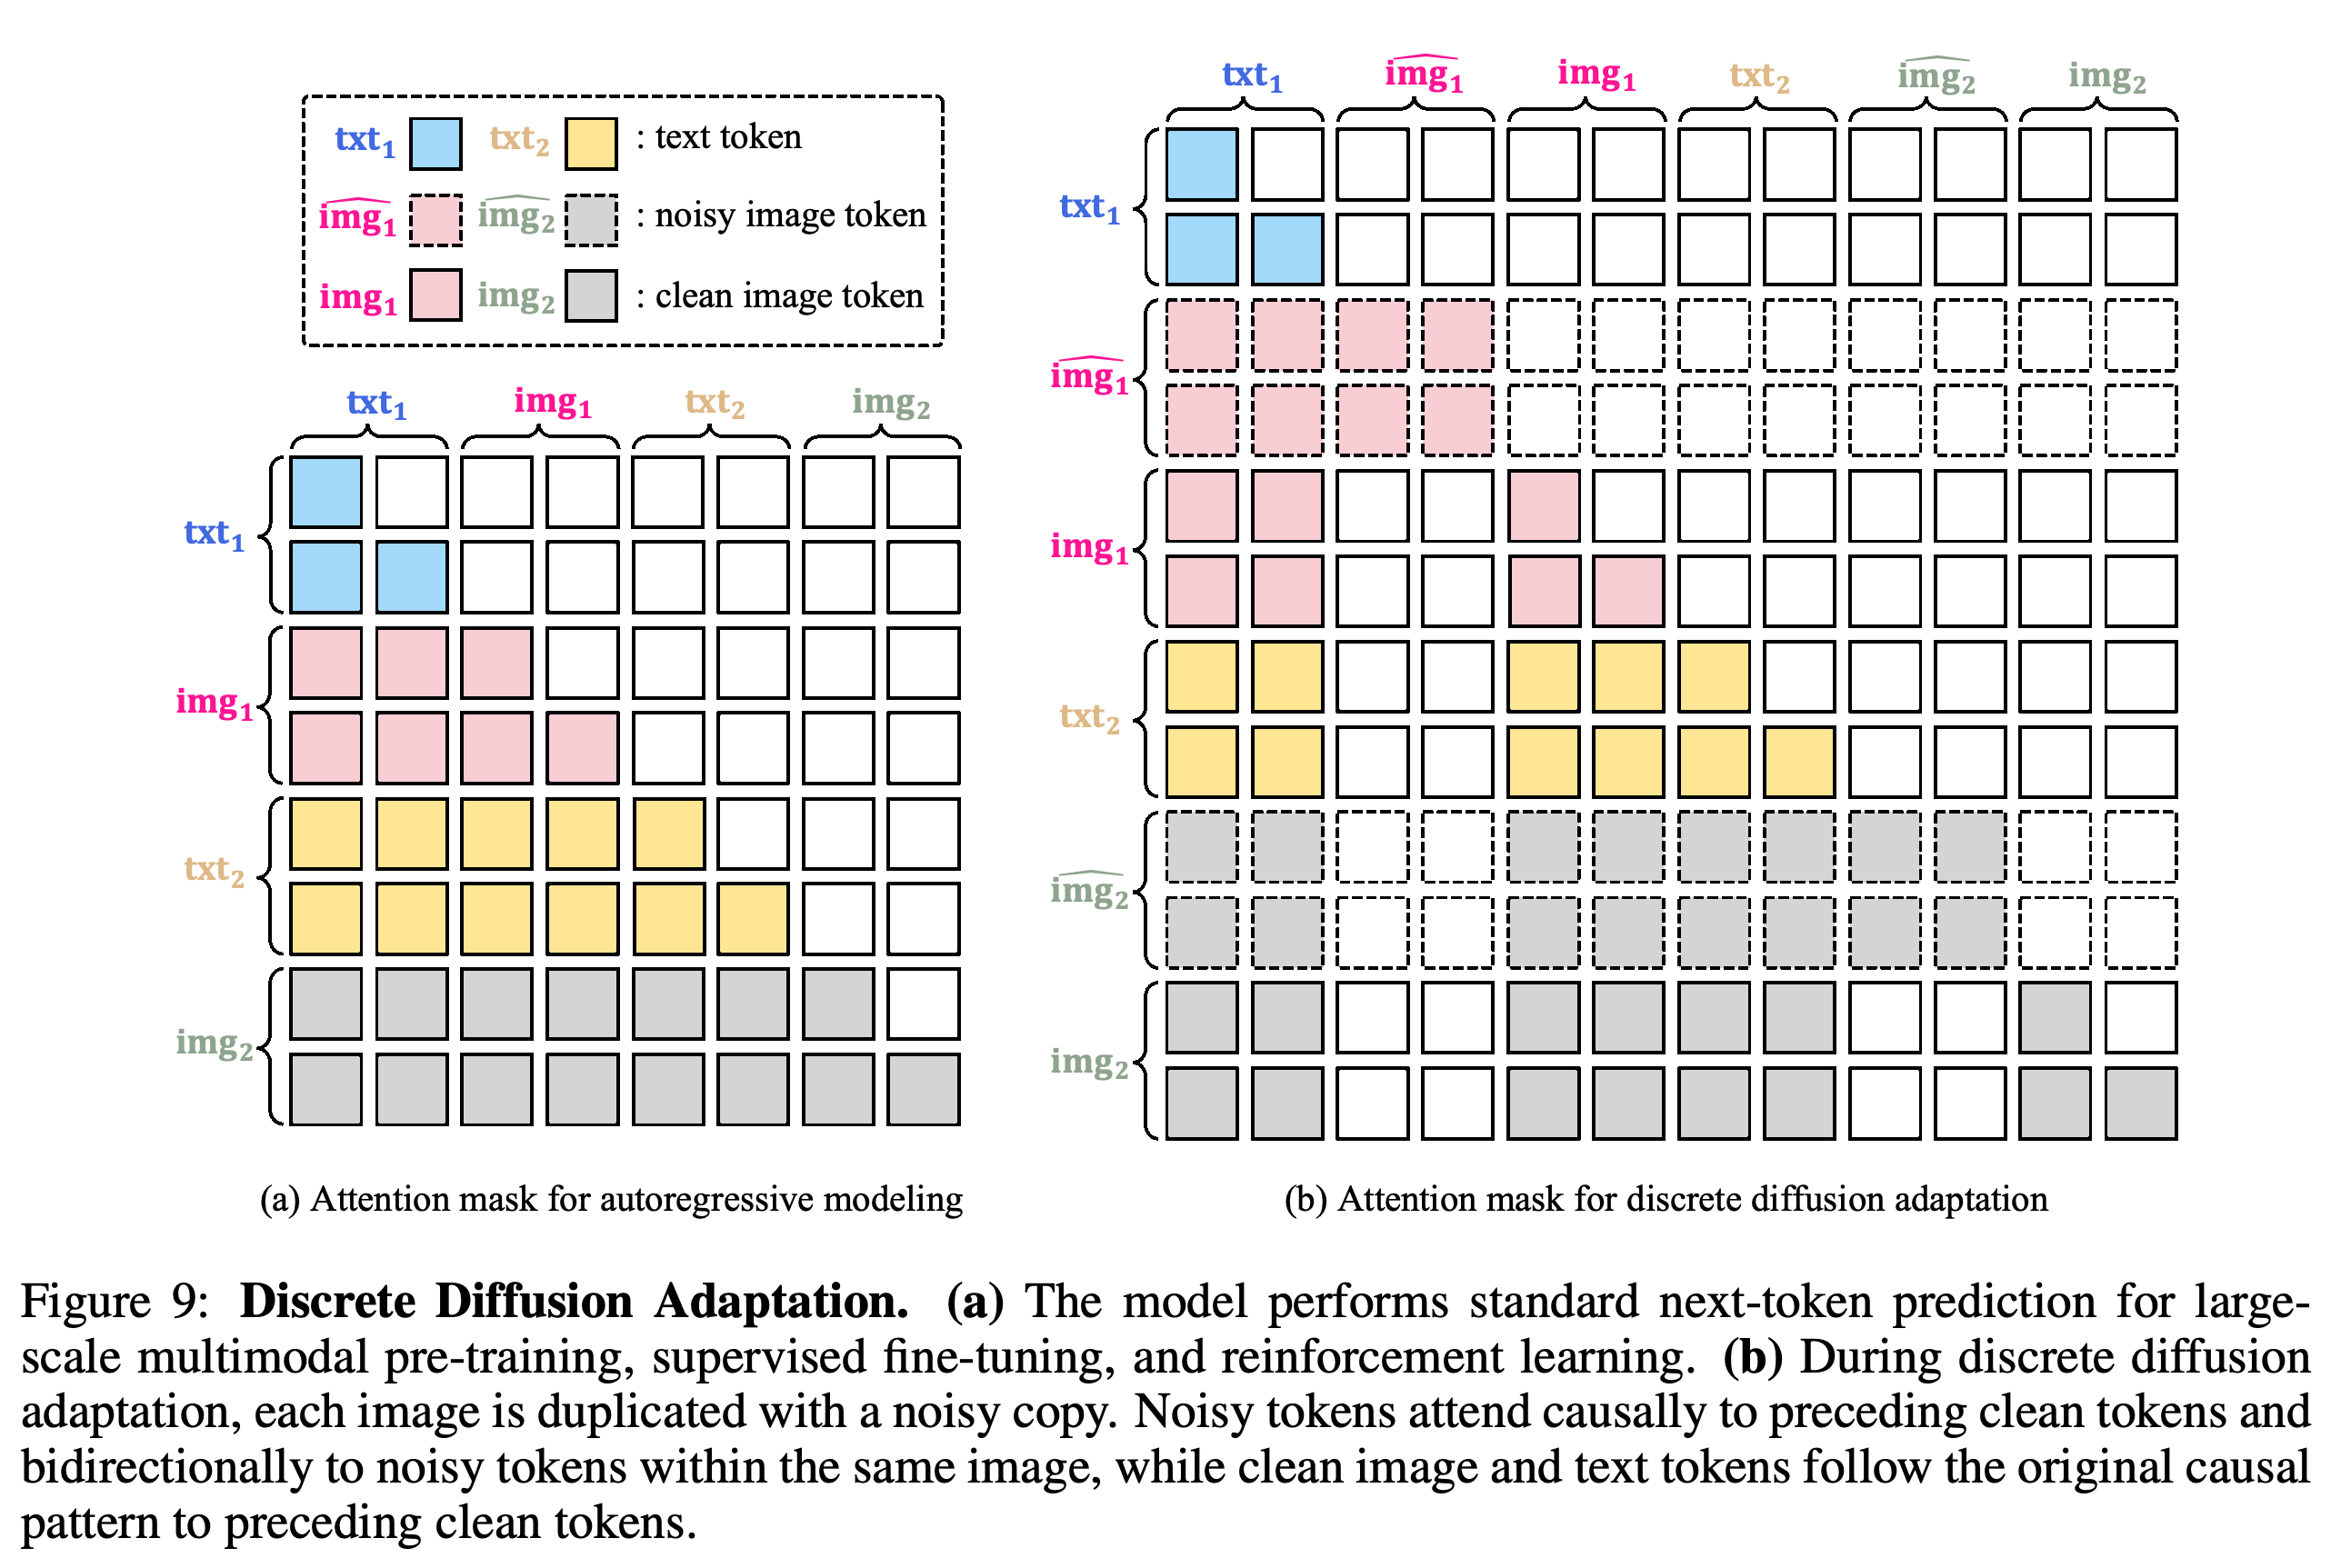
도식은 공통 다음 토큰 학습 목표와 적응 후 추론 절차를 구분한다. 병렬 개선은 이미지 내부에 적용되며, 주변 텍스트는 순서가 있는 멀티모달 시퀀스의 일부로 유지된다.
2.1 Overall
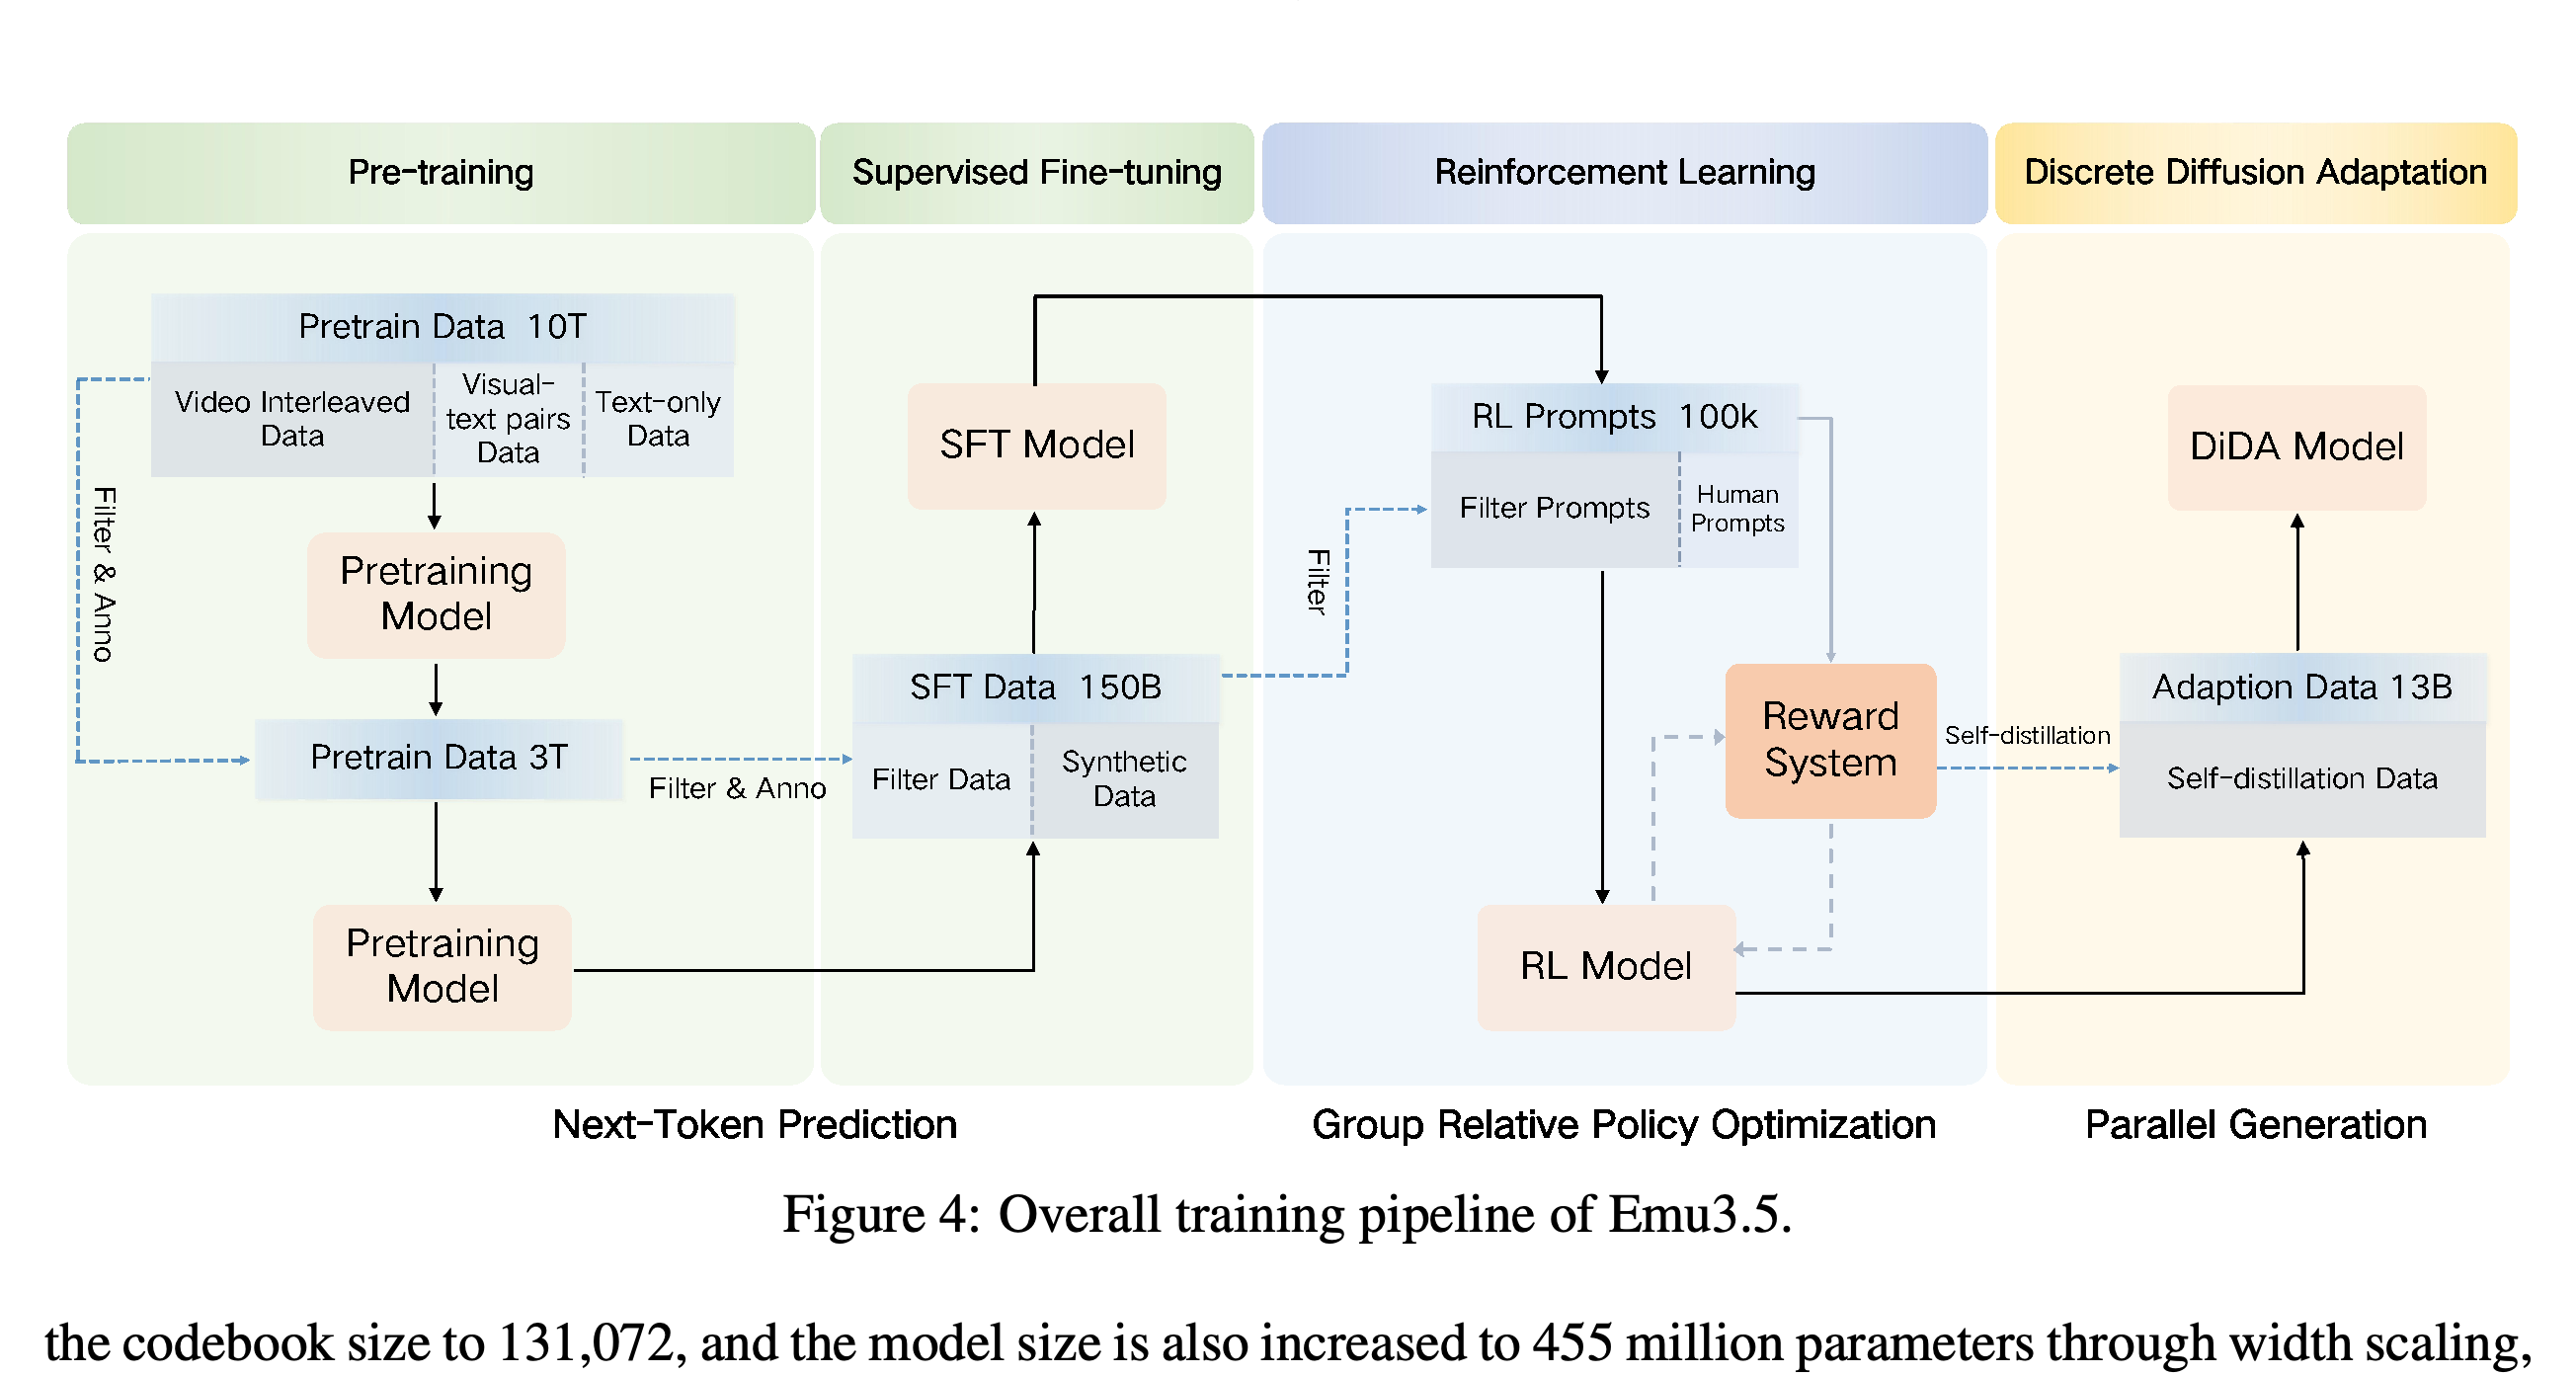
학습 과정은 2단계 사전 학습, 지도 미세 조정 (SFT), 다중 작업 강화학습 (RL), DiDA로 구성된다. 추론 시 텍스트는 순차적으로 생성하고 DiDA는 병렬 개선을 통해 각 이미지를 생성한다.
- Figure 4에는 사전 학습 단계가 10T와 3T, SFT 데이터가 150B, 적응 데이터가 13B로 표시되어 있다. Section 2.1은 SFT 데이터양을 “150 billion samples”로 설명하지만 Table 3은 작업별 데이터양을 토큰 수로 보고한다. 원문에서 이 단위들은 서로 일치하지 않는다.
DiDA는 사전 학습, SFT, 보상 기반 최적화 이후에 수행된다. 도식은 적응 데이터를 13B로 표시하며 자기 증류가 이 마지막 단계에 데이터를 공급하는 구조를 보여준다.
2.2 Unified Architecture
상세 설정에 따르면 파라미터는 34.1B이며, 트랜스포머 층에 31.2 billion개, 임베딩에 2.9 billion개가 포함된다. 모델은 64개 층, 은닉 차원 5,120, 중간 차원 25,600, 쿼리 헤드 64개, 키와 값 헤드 8개, 282,926-token 어휘, 최대 32,768-token 문맥을 사용한다.
- Grouped Query Attention (GQA)은 여러 쿼리 헤드가 키와 값 헤드를 공유해 효율을 높이는 어텐션 방식이다. RMSNorm은 제곱평균제곱근 정규화이며 QK-Norm은 쿼리와 키 투영을 정규화한다. 이들은 학습 안정성을 높인다. 게이트 활성화 함수인 SwiGLU와 위치를 인코딩하는 변환인 rotary positional embeddings (RoPE)도 설계에 포함된다.
- 어휘에는 텍스트 토큰 151,854개와 시각 토큰 131,072개가 포함된다. 텍스트 토큰화는 https://huggingface.co/Qwen/Qwen-7B/blob/main/tokenization_qwen.py 를 재사용한다. 학습 중 활성값을 무작위로 비활성화하는 드롭아웃 비율은 0.1이다.
2.3 Tokenizer
이미지를 이산 코드로 변환하는 시각 토크나이저는 index backpropagation quantization (IBQ)을 사용한다. 다운샘플링 계수는 16, 코드 차원은 256, 코드북 크기는 131,072개, 파라미터는 455 million개다. 논문에서 인용한 언어와 이미지 사전 학습 모델인 SigLIP은 특징 증류에 사용되며, 디코더의 중간 특징이 SigLIP 표현과 일치하도록 학습한다.
- 기본 디코더는 같은 이미지를 표현할 때 Emu3가 사용하는 토큰의 1/4을 사용한다. 선택적으로 사용하는 확산 이미지 디코더는 2배 해상도로 복원한다. 또한 저랭크 가중치 갱신으로 학습하는 LoRA 기반 증류를 통해 잡음 제거를 50단계에서 4단계로 줄인다.
- 반복적인 시각 생성에 사용하는 트랜스포머인 diffusion transformer (DiT)는 생성된 키프레임 토큰에서 연속적인 동영상을 디코딩한다. 키프레임 토큰은 선택된 프레임을 나타내는 코드다. 선택적으로 프레임 사이에 텍스트를 넣어 의미 정보를 제공하며 4채널 마스크는 토큰이 제공된 프레임을 표시한다.
3 Pre-training
사전 학습은 동영상과 언어가 섞인 시퀀스, 시각 정보와 텍스트 쌍, any-to-image 예제, 텍스트 전용 문서를 1개의 예측 목표로 통합한다. Any-to-image (X2I)는 이미지와 텍스트가 임의로 섞인 지시에서 이미지를 생성한다. 2번째 사전 학습 단계에서는 시각 해상도를 높이고 필터링과 주석을 추가한다.
3.1 Training Data
학습 말뭉치는 긴 시간에 걸친 동영상과 언어 데이터에 쌍으로 구성된 데이터와 텍스트 전용 데이터를 결합한다. 동영상 교차 데이터의 샘플링 비율은 사전 학습의 2단계 모두 0.55로 유지된다.
- 3.1.1 Video Interleaved Data: 약 63 million개의 동영상은 평균 길이가 6.5분이며 전체 분량은 약 790년이다. 장면을 고려한 추출 과정은 초당 평균 0.27개의 키프레임을 얻는다. 오디오를 텍스트로 전사하는 자동 음성 인식 (ASR)은 Whisper-large-v2와 Faster-Whisper를 사용한다. 이후 spaCy로 전사문을 분할하고 타임스탬프에 따라 프레임과 텍스트를 섞는다.
- 기본 필터링은 짧거나 해상도가 낮은 동영상과 말하는 사람의 얼굴 중심 영상을 제거하고 언어와 무음 영상의 분포를 조정한다. 고급 필터링은 프레임 품질을 평가하고 시각적으로 중복된 프레임을 제거하며 전사문 품질을 채점한다. 2번째 단계의 주석에는 의미 단위 구간, 시각 캡션, 멀티모달 요약이 추가된다.
- 3.1.2 Vision-Text Paired Data: 약 500 million개의 이미지와 텍스트 쌍, 30 million개의 동영상과 텍스트 쌍에 이미지와 텍스트를 처리하는 모델인 Qwen2.5-VL-7B로 주석을 보강한다. 합성 이미지와 텍스트 예제도 추가한다. 동영상과 텍스트 데이터의 프레임은 초당 1개를 추출하며 같은 동영상의 클립은 시간순으로 묶는다.
- 3.1.3 Any-to-Image Data: 약 27.35 million개의 예제는 공개 데이터셋과 동영상 및 이미지에서 선별한 자체 데이터를 결합한다.
- 3.1.4 Text-only Data: 필터링한 영어와 중국어 텍스트 약 3 trillion 토큰을 멀티모달 학습에 추가한다.
3.2 Training Details
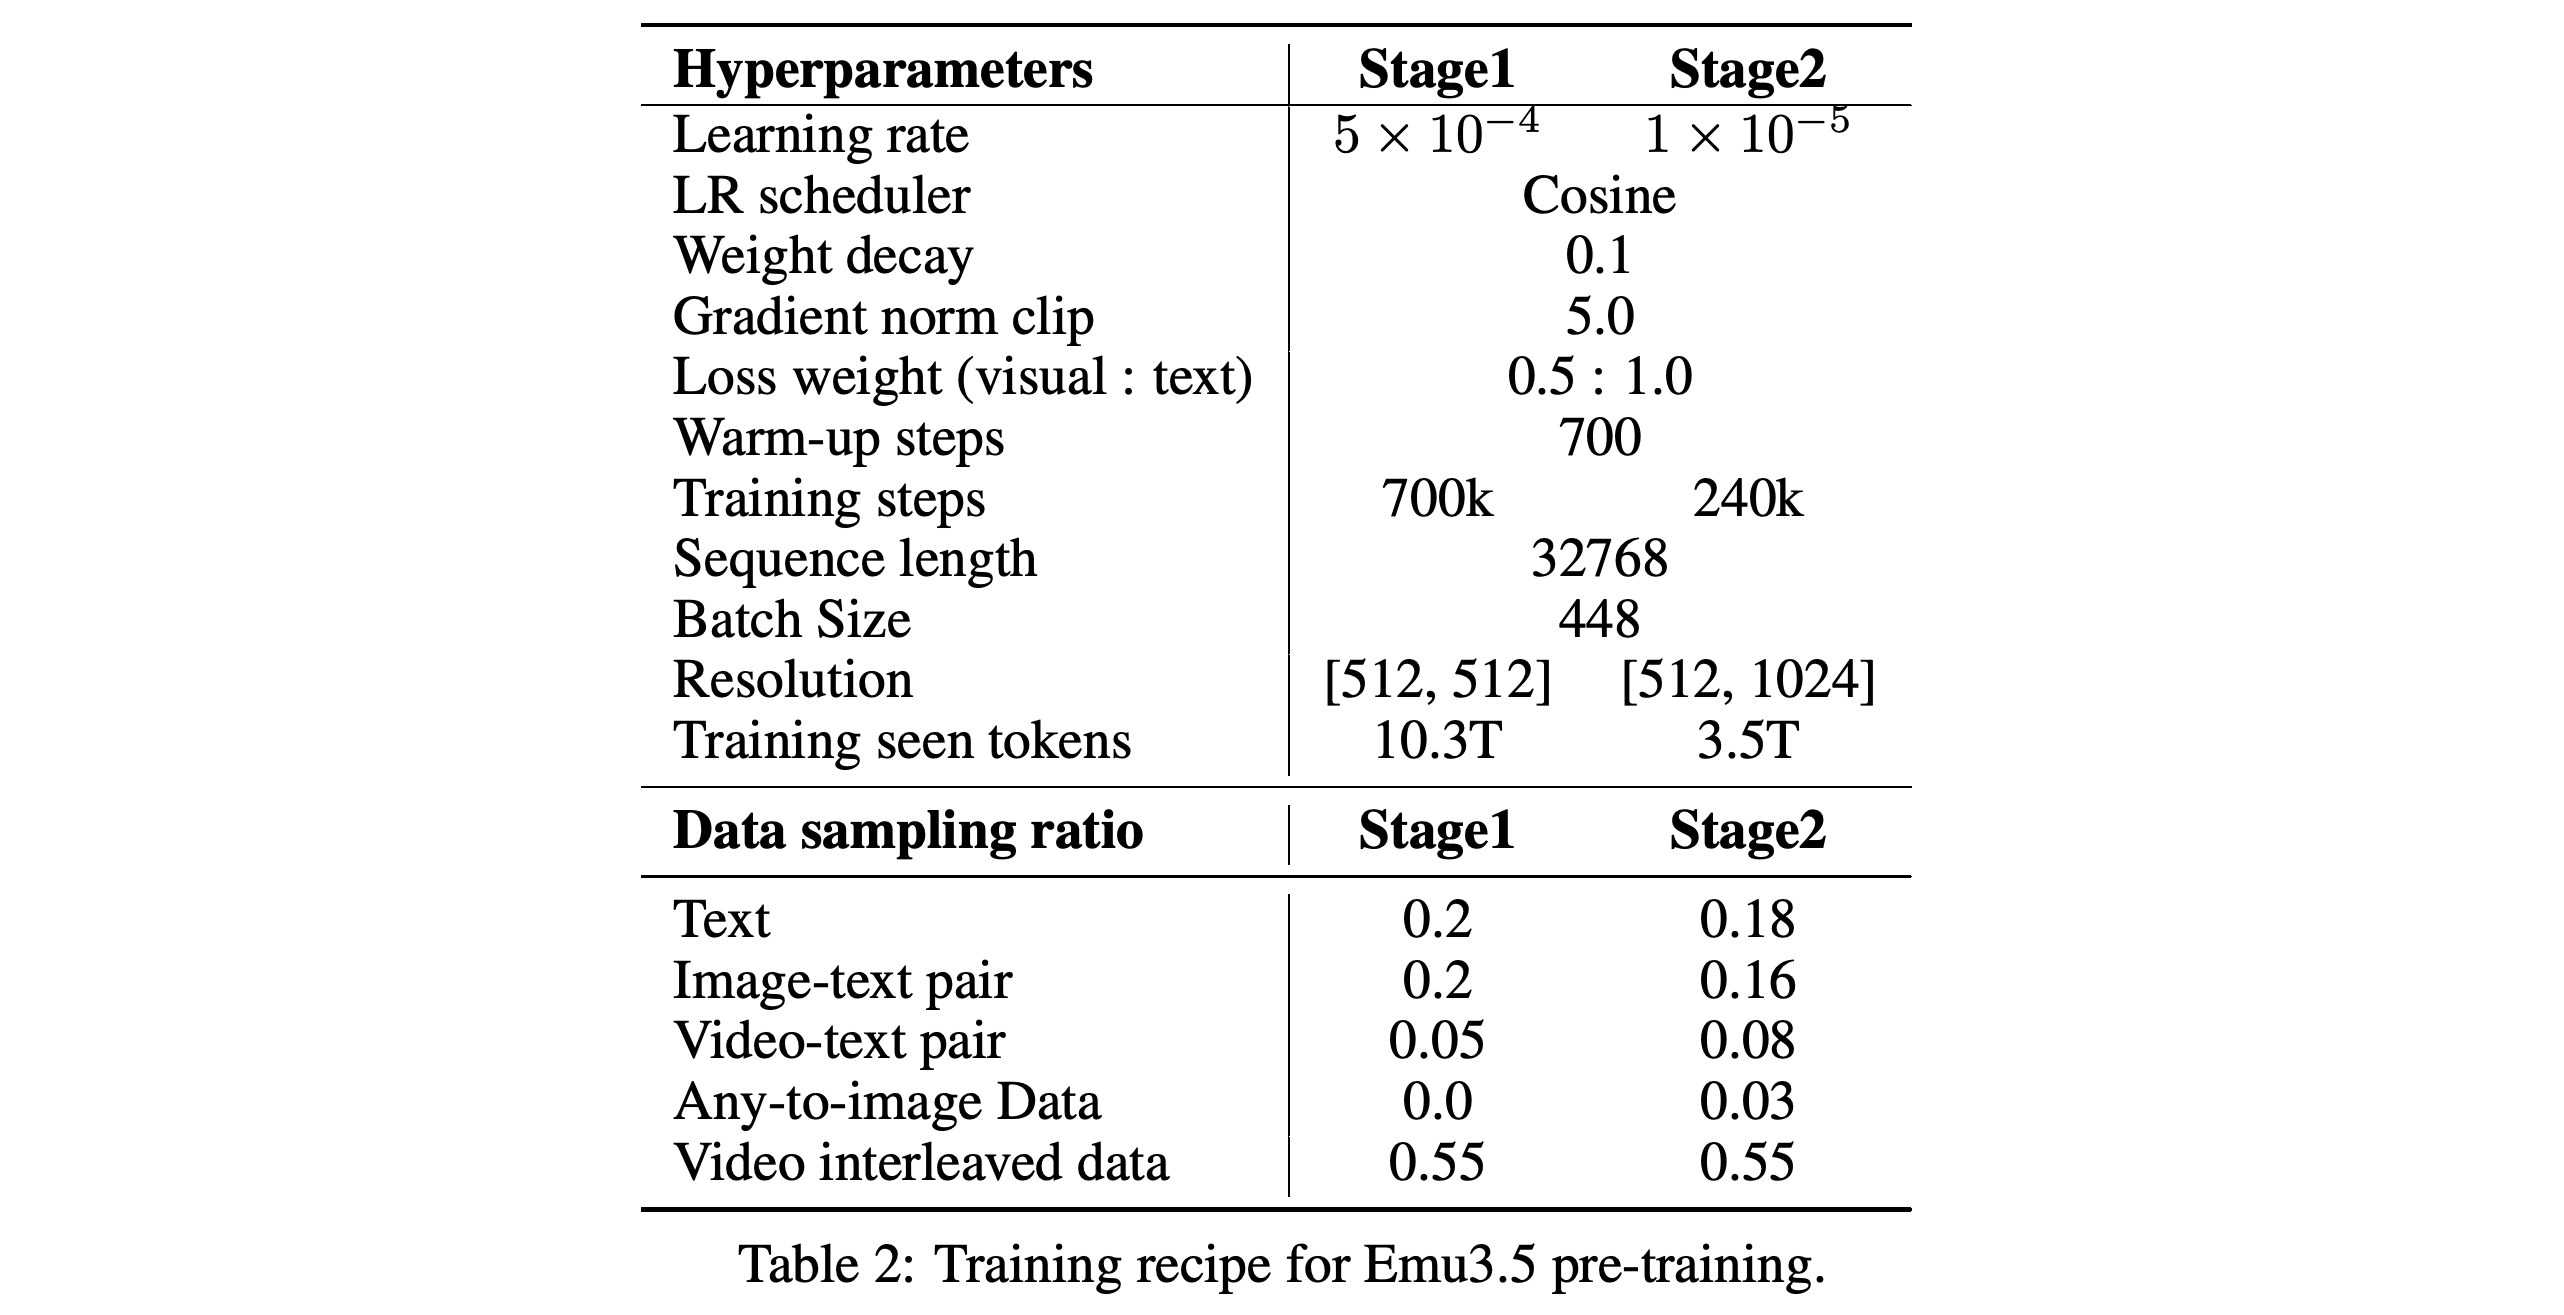
사전 학습은 정답 이산 토큰의 예측 손실인 교차 엔트로피 손실을 사용하며 시각 토큰 가중치는 0.5, 텍스트 토큰 가중치는 1.0이다. 모델은 Qwen3에서 초기화한다. Table 2는 Stage1에서 700k steps 동안 10.3T 토큰을, Stage2에서 240k steps 동안 3.5T 토큰을 학습했다고 보고한다. 이는 반올림한 10T와 3T 설명보다 정확한 수치다.
- 2단계 모두 시퀀스 길이 32,768, 배치 크기 448, 코사인 학습률 스케줄, 가중치 감쇠 0.1, 그래디언트 클리핑 5.0, 워밍업 700 steps를 사용한다. 학습률은 각각 5×10⁻⁴와 1×10⁻⁵이며, AdamW 옵티마이저는 β1 = 0.9, β2 = 0.95, ε = 1.0×10⁻⁸을 사용한다.
- Stage1은 이미지당 시각 토큰을 최대 1,024개로, 픽셀 면적을 최대 512×512로 제한한다. Stage2는 종횡비를 유지하면서 시각 토큰 1,024–4,096개와 최대 1024×1024 해상도를 사용한다. 모델 연산을 장치에 나누는 텐서 병렬화는 8이며, 시퀀스 연산을 나누는 문맥 병렬화는 2다.
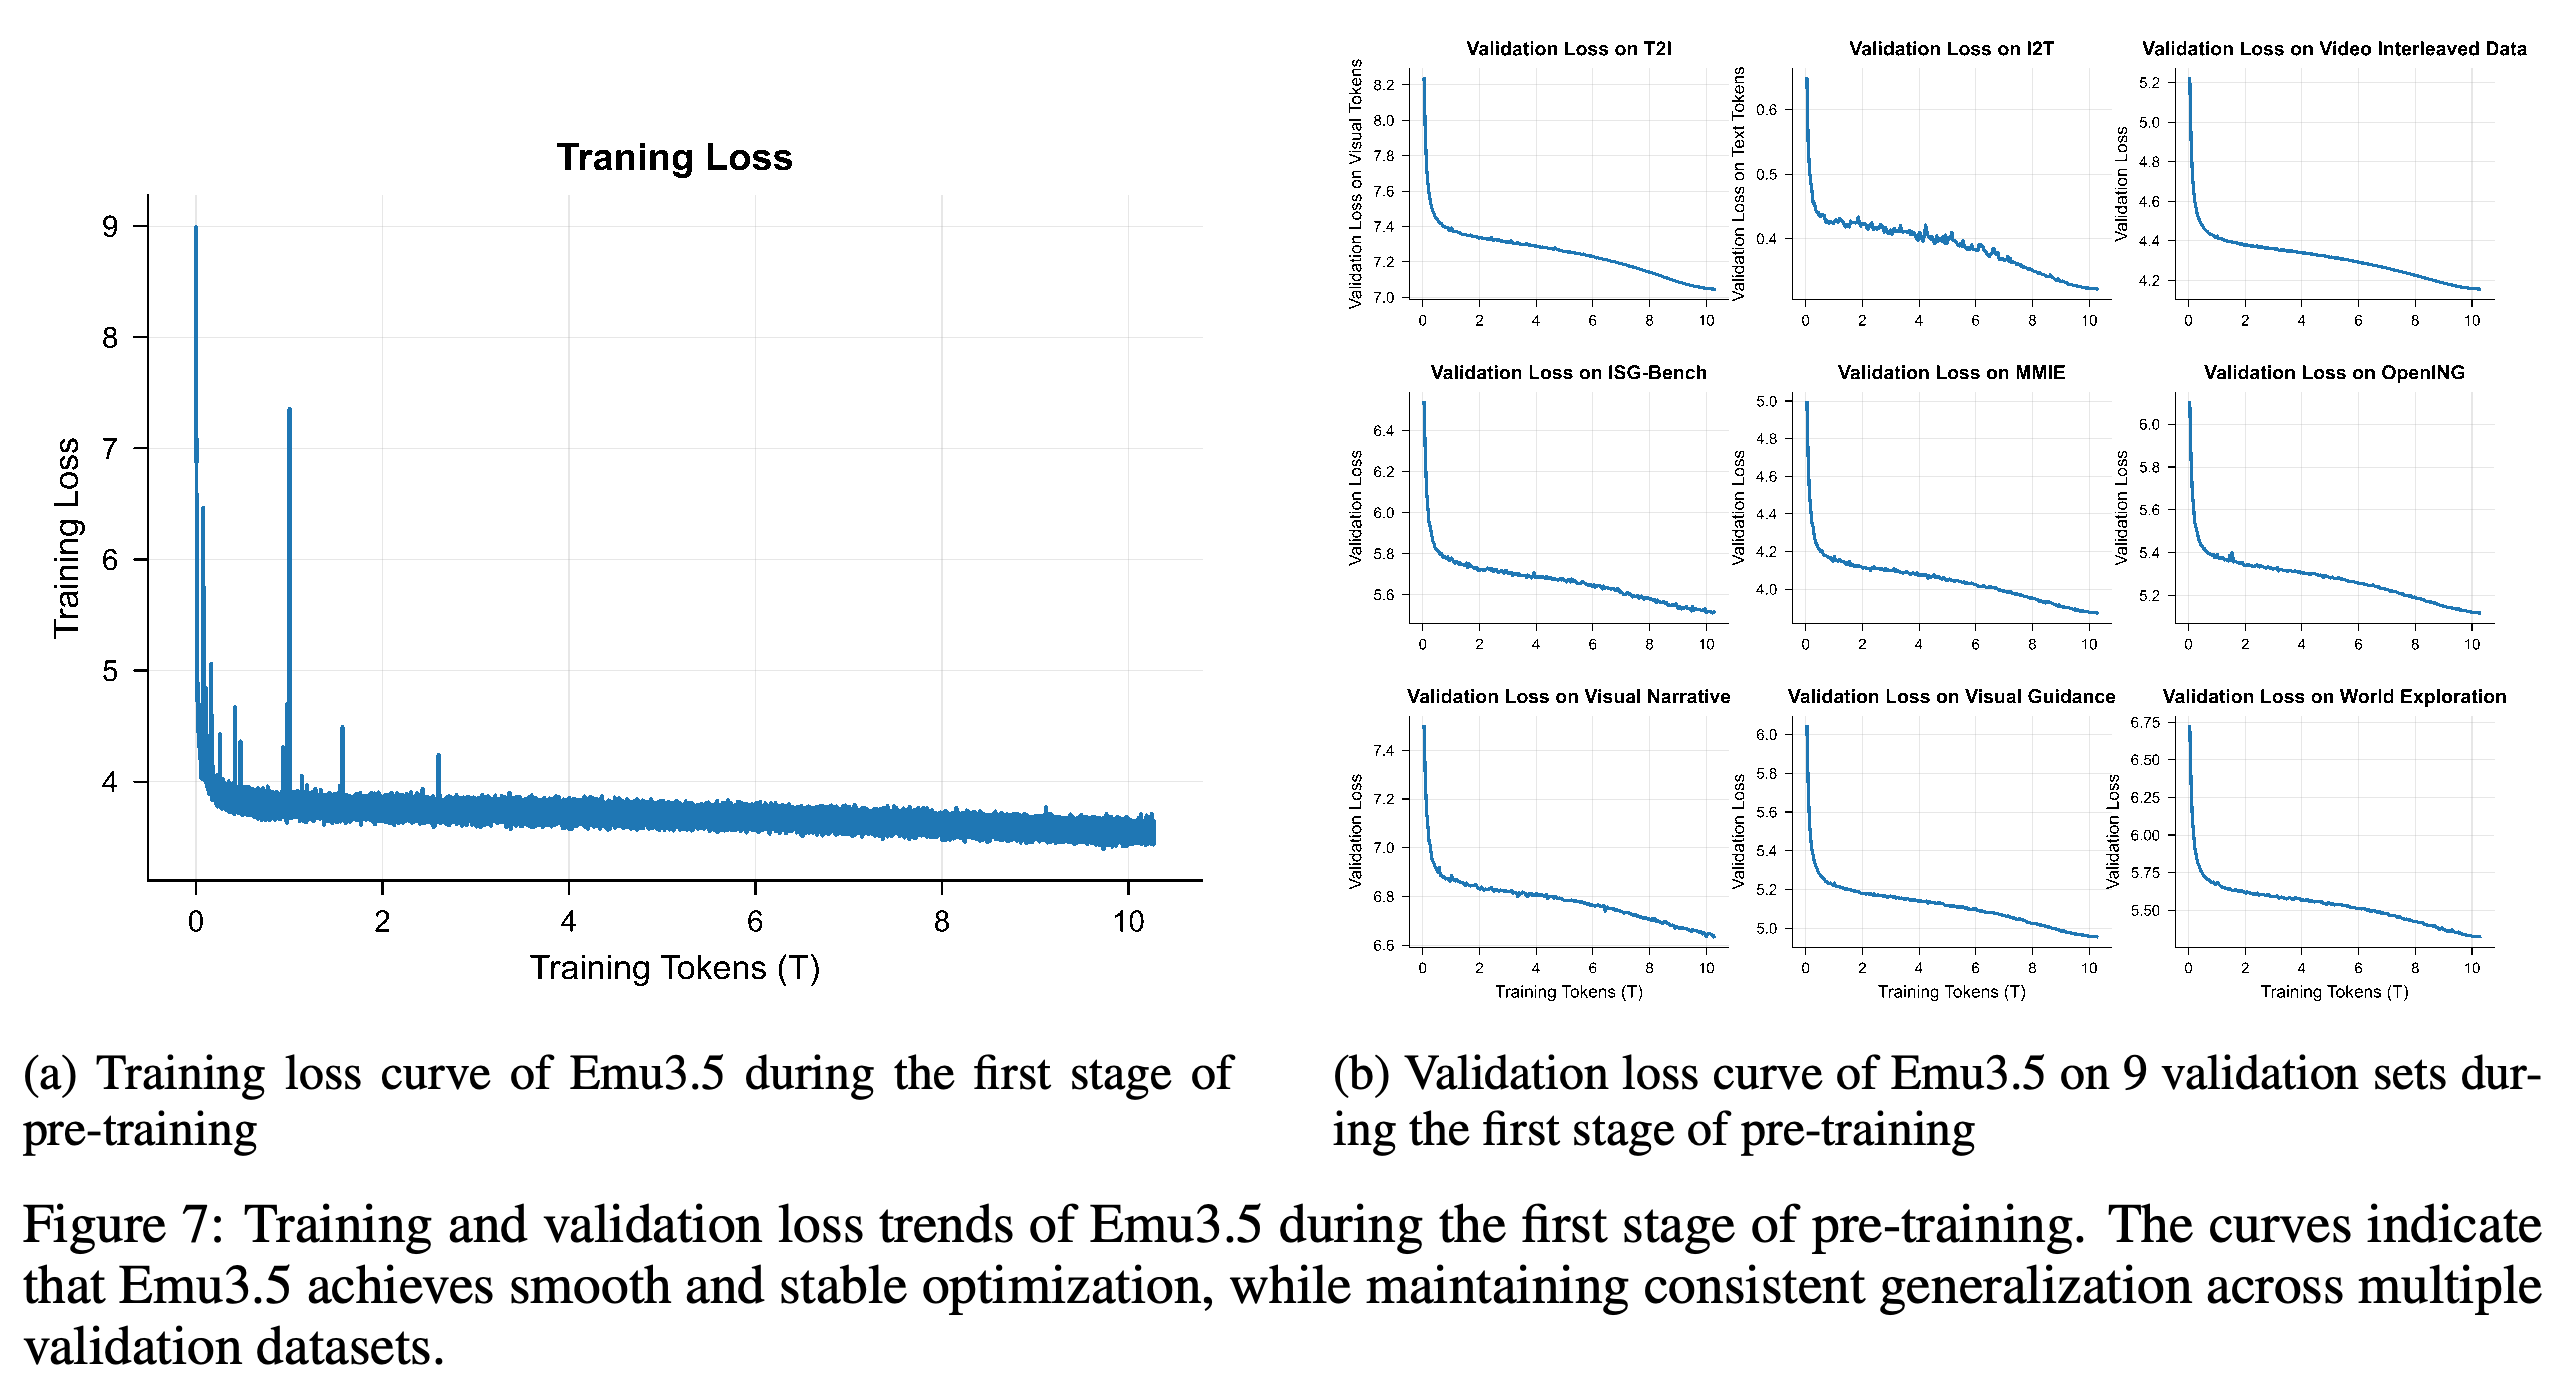
- Stage1 전반에서 학습 손실과 9개 검증 데이터셋의 손실이 감소한다. 여기에는 학습 영역 내 모달리티, 교차 멀티모달 평가 벤치마크인 ISG-Bench, OpenING, MMIE, 사전 학습 데이터와 겹치지 않는 후속 작업 데이터셋 3개가 포함된다. 이 데이터에서 예측 손실은 개선되지만 작업 완료 여부를 직접 측정하지는 않는다.
표는 학습한 토큰 수를 10.3T와 3.5T로 제시하며 동영상 교차 데이터의 샘플링 비율은 단계 전체에서 0.55로 유지한다. Stage2는 X2I를 비율 0.03으로 도입하고 해상도를 높이며 학습률을 낮춘다.
학습 손실은 초기 급등 이후 감소하며 9개 검증 손실 모두 학습한 토큰 수가 늘어날수록 감소하는 추세를 보인다. 곡선은 선택된 데이터에서 토큰 예측이 개선됨을 측정하며 상호작용 작업의 완료를 직접 측정하지는 않는다.
4 Post-training
사후 학습은 먼저 SFT로 통합 작업 인터페이스를 학습한 뒤, 공통 보상과 작업별 보상으로 생성 결과를 최적화한다. 이후 DiDA로 시각 디코딩을 조정해 추론 효율을 높인다.
4.1 Supervised Fine-tuning
SFT는 일반 언어 및 시각 언어 작업, X2I, Visual Narrative, Visual Guidance, World Exploration, Embodied Manipulation을 다룬다. Visual Narrative는 삽화가 포함된 이야기 시퀀스를 생성한다. Visual Guidance는 연속된 절차의 각 단계에 맞는 이미지와 지시를 생성한다.
- 4.1.1 Task Formulation: World Exploration은 지시마다 시각 결과를 1회 갱신하는 User-Interactive Mode와 내레이션을 동기화하며 자율적으로 이어가는 Free-Exploration Mode를 지원한다. Embodied Manipulation은 작업을 언어로 설명한 하위 작업과 각 작업의 완료 상태를 나타내는 키프레임으로 분해한다.
- 4.1.2 Training Data: Table 3은 General Tasks 29.7B 토큰, Any-to-Image 56.2B, Visual Narrative 10.1B, Visual Guidance 22.5B, World Exploration 17.5B, Embodied Manipulation 14.1B를 보고한다.
- 일반 작업 데이터에는 약 5 million개의 text-to-image 예제, 8.9 million개의 지시와 응답 쌍, 3.7 million개의 시각 언어 예제가 포함된다. X2I는 완전한 실제 데이터, 부분 합성 데이터, 완전 합성 데이터를 결합한다. 입력 이미지는 0개, 1개 또는 여러 개이며 출력 이미지는 1개다.
- 교차 데이터셋에는 이야기 예제 430k개, 2–10단계 절차로 제한한 안내 예제 960K개, 탐색 예제 200K개, 조작 예제 973K개가 포함된다. 조작 예제는 OpenX Embodiment 920K개, Agi-world Alpha 40K개, Songling Aloha 13K개로 구성된다. 명시적인 추론 주석인 chain-of-thought (CoT)를 전체 시퀀스와 이미지 수준에서 추가해 이야기와 안내 데이터를 보강한다. 탐색 데이터에는 카메라 궤적 주석을 추가하며 조작 시퀀스는 중간 하위 작업에서 시작할 수도 있다.
- 4.1.3 Training Details: Stage1은 X2I에 768px, 이야기, 안내, 조작에 512px, 탐색에 720px를 사용한다. 문맥 길이는 16,384, 시각 손실 가중치는 1.0이다. Stage2는 X2I를 1024px, 다른 교차 작업을 720px로 높이고, 문맥 길이 32,768과 시각 손실 가중치 0.5를 사용한다. 2단계 모두 배치 크기 1024, 학습률 6e−6, 3000 iterations를 사용한다. 텐서 병렬화는 8로 유지하며 문맥 병렬화는 1에서 2로 늘린다.
4.2 Reinforcement Learning
RL은 일반적인 이미지와 텍스트 정합성 및 심미성 보상에 텍스트 충실도, 정체성 보존, 시퀀스 일관성을 평가하는 작업별 보상을 결합한다. 각 보상은 합산 전에 [1, 10]으로 정규화한다.
- 4.2.1 Reward System: 이미지와 텍스트 표현 모델인 CLIP은 여기서 유사도 점수를 계산해 정합성 보상을 제공한다. 이미지와 텍스트를 함께 처리하는 시각 언어 모델 (VLM)은 정합성과 일관성을 평가한다. 이미지에서 글자를 추출하는 광학 문자 인식 (OCR)은 텍스트 충실도 보상에 사용된다. 여러 구성 요소로 학습 신호를 다양화하지만 보상 곡선만으로 점수 체계를 악용하는 보상 해킹이 없다고 입증할 수는 없다. CLIP에 대해서는 CLIP 논문 리뷰(Learning Transferable Visual Models From Natural Language Supervision) 글을 참조하라.
- 4.2.2 Training Data: 후속 작업마다 약 10K개의 프롬프트를 필터링하고 인간 피드백 샘플 1K개를 추가한다. 이미지 중심 단계에서는 X2I 지시 58K개와 text-to-image 샘플 50K개를 추가한다.
- 4.2.3 Training Details: 생성 샘플 그룹을 이용해 정책을 최적화하는 Group Relative Policy Optimization (GRPO)은 배치 크기 640, 학습률 1×10⁻⁶, 프롬프트당 롤아웃 8개를 사용한다. 롤아웃은 모델에서 샘플링한 출력이다. RL 학습 프레임워크인 VeRL 내에서 vLLM 샘플링 엔진을 사용한다. 다중 작업 RL은 프롬프트 전체를 1회 학습하고 이후 별도의 X2I 및 text-to-image 단계를 수행한다.
- 4.2.4 Scaling Behavior: 평균 학습 보상은 약 4.5에서 7.1을 넘는 수준으로 상승한다. 별도로 명시하지 않은 정량 결과는 이 RL 모델을 사용한다.
4.3 Discrete Diffusion Adaptation
DiDA는 일반적으로 토큰을 1개씩 생성하는 자기회귀 모델을 조정해, 전체 이미지 토큰 시퀀스를 초기화하고 병렬로 점진적인 잡음 제거를 수행한다. 모델이 자체 생성한 예제로 적응하는 자기 증류를 통해 이미지와 텍스트 쌍 및 교차 시퀀스를 마련한다.
- 4.3.1 Training Approach: 각 이미지는 잡음을 추가한 복사본과 쌍을 이룬다. 잡음이 있는 이미지 토큰은 앞선 깨끗한 토큰에는 인과적 어텐션을, 같은 이미지 내 잡음 토큰에는 양방향 어텐션을 적용한다. 깨끗한 이미지 토큰과 텍스트 토큰은 앞선 깨끗한 토큰에만 접근하는 인과적 어텐션을 유지한다.
- 4.3.2 Infrastructure: FlagScale은 마스크를 설정할 수 있는 어텐션 구현인 PyTorch FlexAttention과 행별 블록 마스크를 결합한다. 학습에는 텐서 병렬화, 층을 분산하는 파이프라인 병렬화, 시퀀스 연산을 분산하는 시퀀스 병렬화, 옵티마이저 상태를 분할하는 ZeRO-1 데이터 병렬화를 함께 사용한다. 활성값 재계산은 저장해야 하는 중간 활성값을 줄인다.
- 텍스트와 이미지 상태를 명시적으로 구분하는 스케줄러인 Finite-State Machine (FSM)이 모달리티 전환을 관리한다. 비동기 요청, 실행 상태 재사용, 8비트 부동소수점 형식으로 연산하는 FP8 양자화는 장치 4개 구성에서 보고된 최소 50%의 속도 향상에 기여한다.
추가된 잡음 이미지 블록은 잡음 제거 중인 이미지의 토큰 사이에 양방향 어텐션을 허용한다. 깨끗한 이미지와 텍스트는 앞선 깨끗한 토큰에 대한 인과적 의존 관계를 유지하므로, 순서가 있는 이미지와 텍스트 시퀀스 안에서 이미지를 병렬로 개선할 수 있다.
5 Tokenizer Training
토크나이저 학습은 이산 시각 표현과 이미지 및 동영상 디코더를 별도로 개발한다. 학습 목표와 데이터는 일반적인 복원 성능과 함께 텍스트 및 얼굴의 세부 표현을 중점적으로 다룬다.
5.1 Data
이미지 말뭉치는 일반 데이터셋, 심미성이 높은 이미지, 텍스트와 얼굴이 풍부한 이미지 모음을 결합한다. 512×512 pixels 미만이거나 품질 점수가 0.4 미만인 이미지는 제외하며 심미성과 워터마크도 추가로 필터링한다.
- 일반 데이터에는 ImageNet, OpenImage, CC3M, CC12M, 자체 이미지가 포함된다. TextAtlas5M, PosterCraft, LAION은 텍스트가 풍부한 콘텐츠를 제공한다. Midjourney, COYO-700M, DataComp, JourneyDB는 얼굴 데이터를 추출할 이미지를 제공한다.
- 동영상 디코더 데이터에는 Koala, Sekai, Agibot, 자체 스톡 동영상, 고품질 이미지가 포함된다. 장면 분할, 프레임 간 움직임을 추정하는 광학 흐름, 적절한 Koala 학습 클립을 선택하는 점수인 Video Training Suitability Score (VTSS)로 말뭉치를 필터링한다.
5.2 Training Details
토크나이저는 복원, 양자화, 지각, 적대적 학습, 엔트로피, 의미 증류 손실을 결합한다. 지각 손실에는 학습된 시각 거리 지표인 Learned Perceptual Image Patch Similarity (LPIPS)를 사용한다. 적대적 손실에는 이미지 패치를 채점하는 판별기인 PatchGAN을 사용한다. Adam은 β1 = 0.5, β2 = 0.9, 학습률 1e−4, 워밍업 15K steps, 500K iterations, 배치 크기 256을 사용한다.
- 선택적으로 사용하는 이미지 디코더는 논문에서 인용한 생성 학습 목표인 Flow-matching을 사용하며 Stable-Diffusion 3.5 medium에서 초기화한다. 512px에서 배치 크기 512, 학습률 5e−5로 200k steps를 학습한다. 이후 해상도별 버킷을 균형 있게 샘플링해 512px–1024px 해상도에서 50K iterations를 학습한다.
- LoRA 기반 디코더 증류는 배치 크기 128, 학습률 1e−5로 6K steps를 수행한다. 잡음 제거는 50단계에서 4단계로 줄어들며, 최대 2K 해상도의 출력을 지원한다.
- 동영상 디코더는 Wan2.2 5B에서 시작한다. 1초 길이의 720px/480px 클립으로 배치 크기 1,024, 이미지와 동영상 비율 4:1, 학습률 5e−5를 사용해 약 80K steps를 학습한다. 이어 2–5초 클립에서 비율 1:1, 학습률 3e−5로 추가 80K steps를 학습하고 이후 1080px 미세 조정을 수행한다.
6 Experiment
실험은 이미지 생성, 이미지 편집 및 조건부 생성, 교차 작업 4개, 토크나이저 복원, DiDA의 지연 시간과 품질을 평가한다. 기존 이미지 벤치마크로 정량 비교를 수행하며 교차 작업에는 ChatGPT 선호도 판단과 선별된 정성 예제를 사용한다.
6.1 Text-to-Image
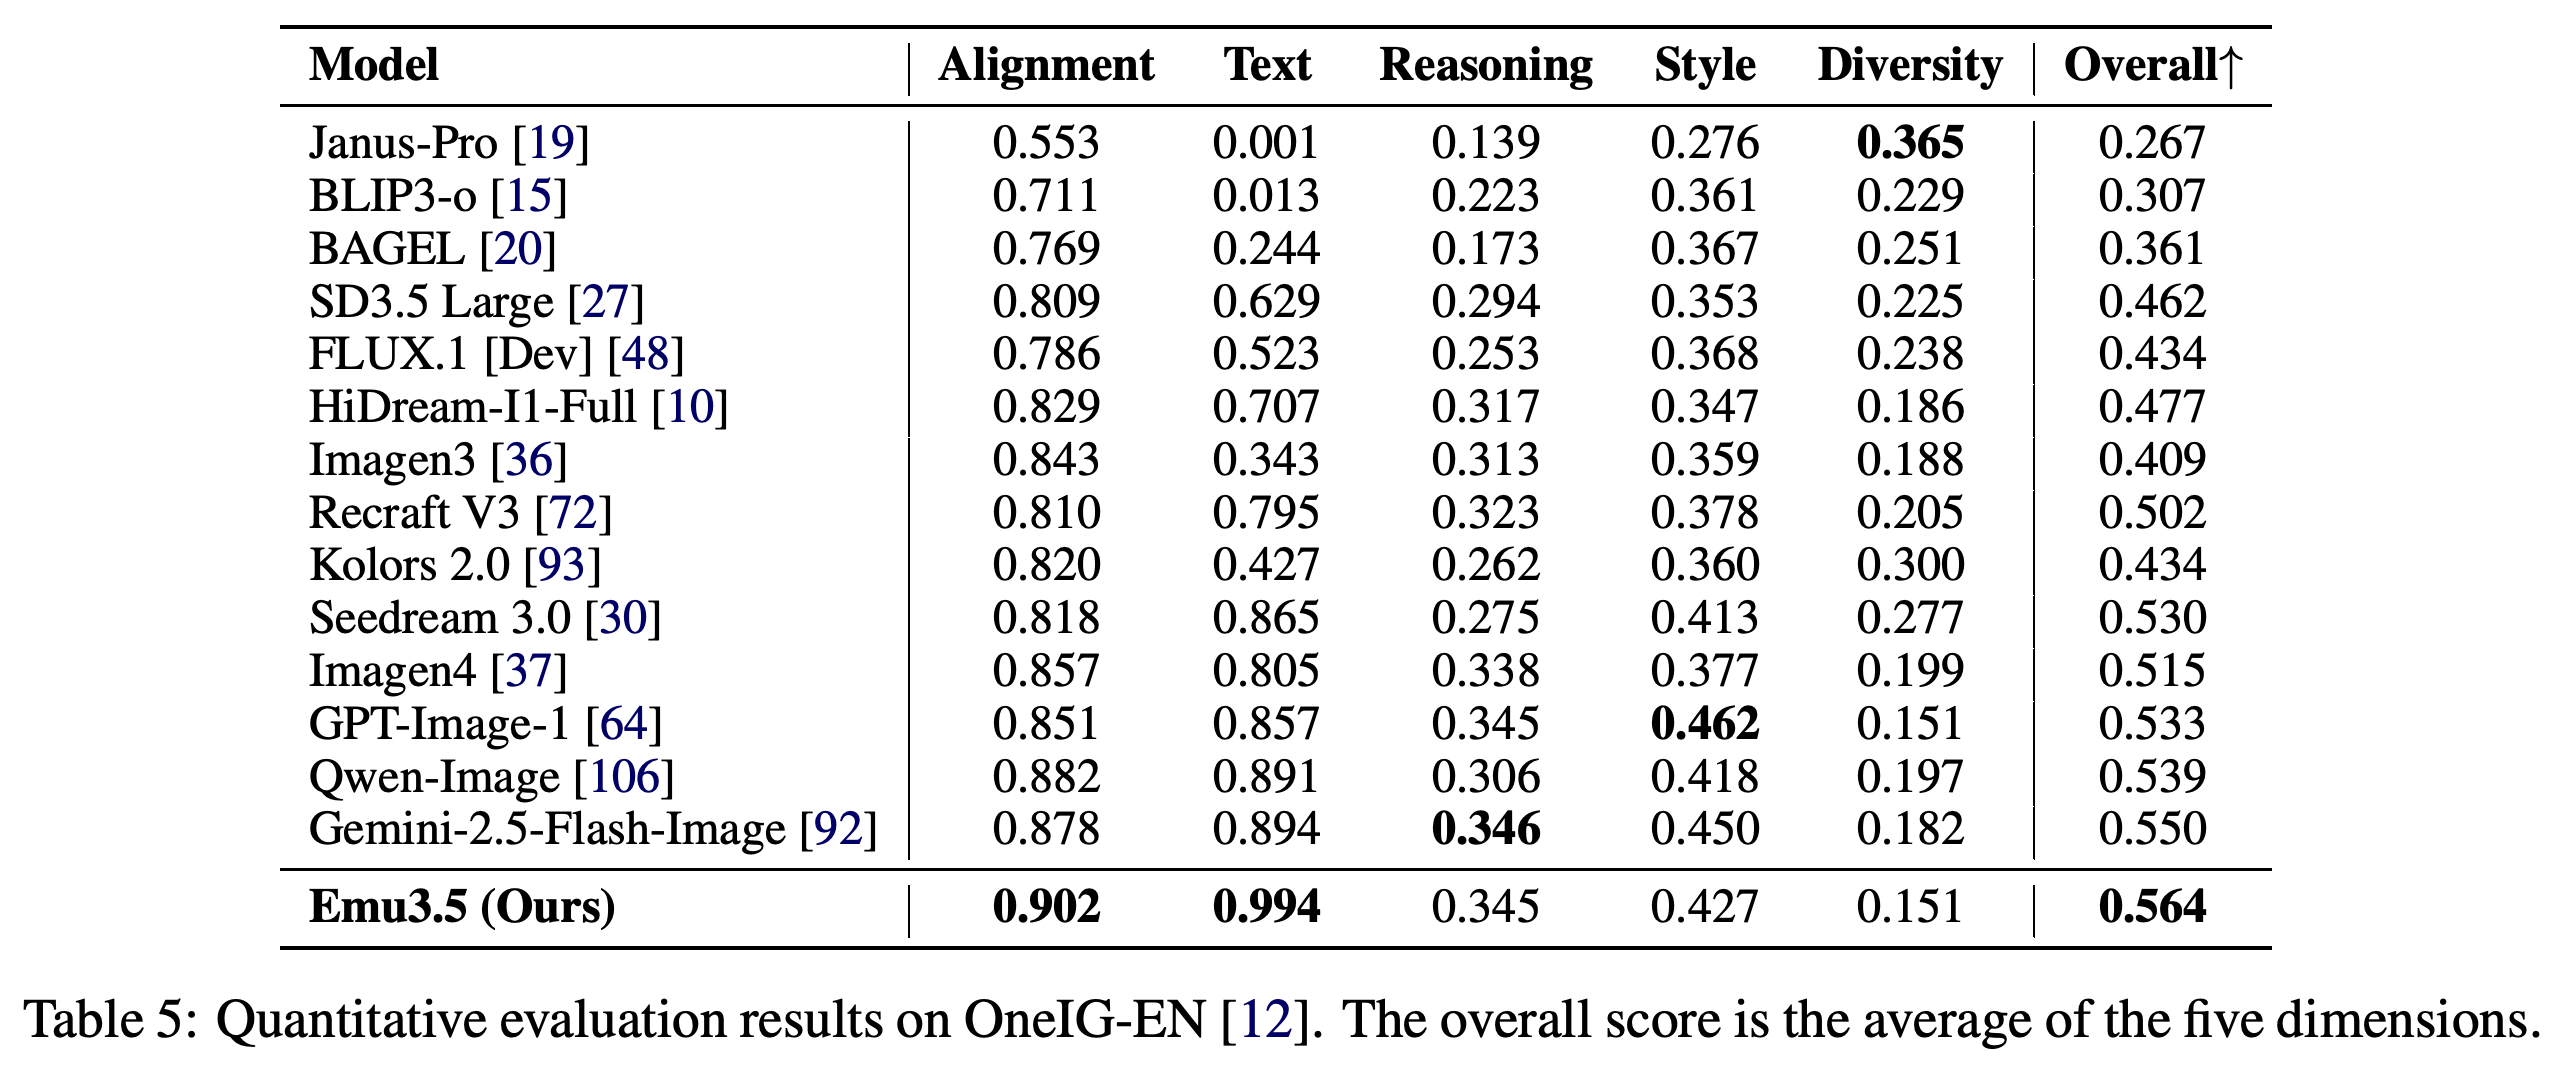
Text-to-image 평가는 일반적인 지시 이행과 영어 및 중국어 텍스트 렌더링을 다룬다. 정합성, 텍스트, 추론, 스타일, 다양성을 평가하는 OneIG-Bench에서 Emu3.5는 보고된 영어 종합 점수 0.564로 가장 높으며 Gemini 2.5 Flash Image는 0.550을 기록한다. 중국어 점수는 0.529로 Qwen-Image의 0.548보다 낮다.
- 복잡한 이미지 생성 지시의 이행을 평가하는 TIIF Bench testmini에서 Emu3.5의 short/long 종합 점수는 89.48/88.18이며, GPT Image 1은 89.15/88.29다. 2개 프롬프트 조건에서 각각 최고 점수를 기록한 모델이 다르다.
- LeX-Bench는 프롬프트 1,310개로 영어 텍스트 렌더링을 평가한다. Emu3.5의 easy, medium, hard 조건별 재현율은 0.98, 0.96, 0.87이며, 대응하는 pned 텍스트 오류 점수는 0.43, 1.16, 4.39다. pned는 낮을수록 좋다. PDF는 pned의 전체 명칭을 설명하지 않는다. Easy 조건에서는 Seedream 3.0이 0.34로 더 좋은 점수를 기록한다.
- LongText-Bench는 긴 텍스트 렌더링을 평가한다. 점수는 영어 0.976, 중국어 0.928, 평균 0.952다. Qwen-Image는 0.943, 0.946, 0.944이므로, Emu3.5는 영어와 평균에서 앞서지만 중국어에서는 뒤처진다.
- CVTG-2K는 영어 텍스트 영역 2–5개를 요구하는 프롬프트 2,000개로 구성된다. Emu3.5의 평균 단어 정확도는 0.9123이며, Normalized Edit Distance (NED)는 0.9656이다. NED는 이 벤치마크에서 높을수록 좋은 정규화된 텍스트 비교 점수로 보고된다. GPT-Image-1은 각각 0.8569와 0.9478을 기록한다.
- Figure 12는 사진풍과 양식화된 출력, 밀도 높은 영어 및 중국어 텍스트, 수학 표기법을 보여준다. 선별된 예제는 출력 형식을 보여주지만 실패 빈도를 측정하지는 않는다.
Emu3.5의 최고 OneIG-EN 평균 점수 0.564는 표에서 가장 높은 정합성 및 텍스트 점수와 여러 비교 모델보다 낮은 다양성 점수를 함께 반영한 결과다. 모든 평가 항목에서 최고 점수를 기록하지는 않는다.
6.2 Any-to-Image
X2I 평가는 약 1024×1024 해상도에서 편집, 대상 조건부 생성, 생성 및 편집 작업 31개를 다룬다. Emu3.5는 ImgEdit, GEdit-Bench, OmniContext, ICE-Bench에서 보고된 종합 점수가 가장 높다. 다만 일부 차이는 작으며 개별 하위 작업에서는 여전히 상대적으로 약한 성능을 보인다.
- ImgEdit은 샘플 737개와 GPT-4.1 채점으로 단일 턴 이미지 편집을 평가한다. Emu3.5는 4.41, Qwen-Image-Edit-2509는 4.35, Gemini 2.5 Flash Image는 4.28을 기록한다.
- GEdit-Bench는 샘플 606개와 GPT-4o 채점으로 단일 턴 편집을 평가한다. Emu3.5는 의미 일관성 8.11, 지각적 품질 7.70, 종합 7.59를 기록한다. Qwen-Image-Edit의 종합 점수는 7.56이다. 종합 점수는 샘플별 종합 점수의 평균이며 2개 구성 지표의 평균이 아니다.
- OmniContext는 샘플 400개로 대상 중심 생성을 평가하며 GPT-4.1 기반으로 프롬프트 이행과 대상 일관성을 채점한다. Emu3.5의 평균은 8.82로 GPT-4o의 8.80보다 높으며 캐릭터보다 객체에서 강한 결과를 보인다.
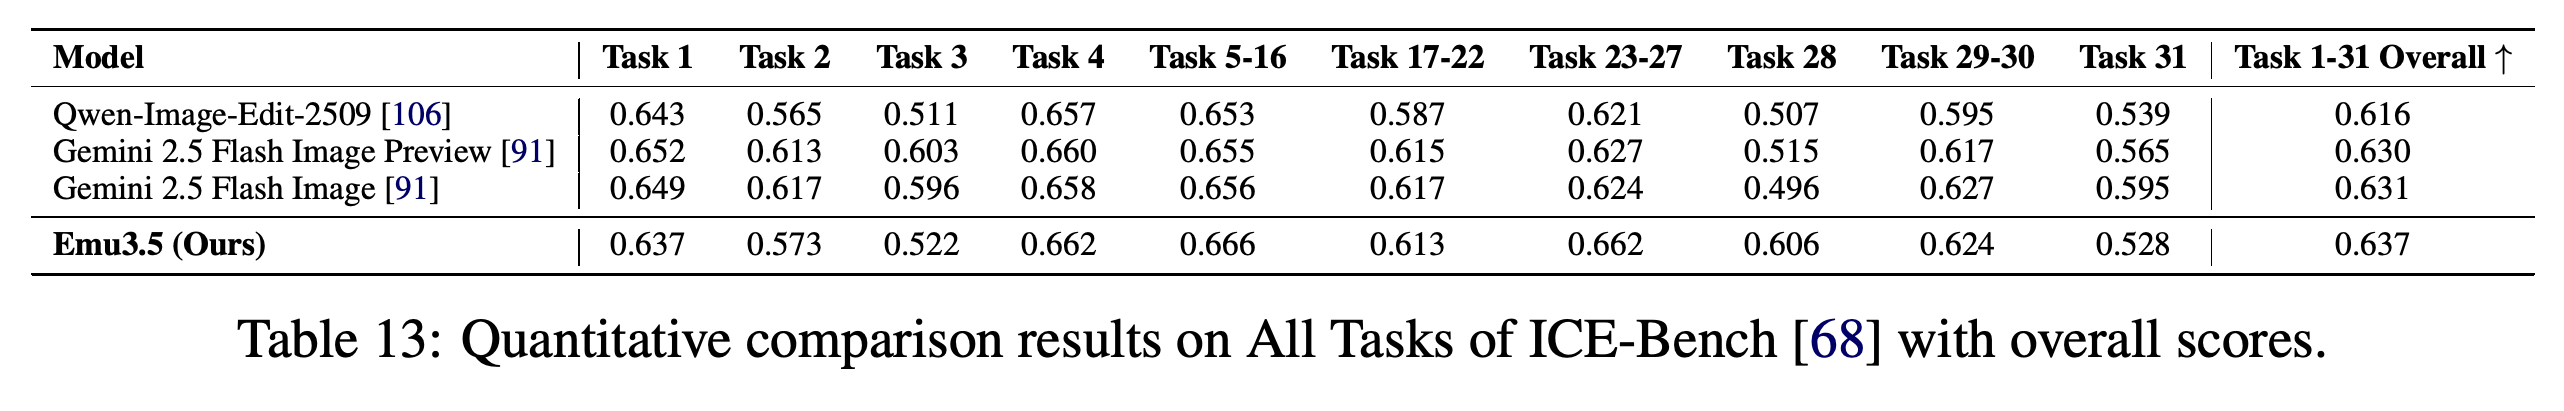
- ICE-Bench는 샘플 6538개와 작업별 자동 품질, 일관성, 제어 가능성 지표로 이미지 생성 및 편집을 평가한다. Emu3.5의 종합 점수는 0.637로 Gemini 2.5 Flash Image의 0.631보다 높지만 얼굴 참조, 스타일 참조, 얼굴 교체에서는 더 약하다. Qwen-Image-Edit-2509는 참조 이미지 없는 생성 평가에서 빈 1024×1024 이미지를 입력받는다.
- Figures 13–15는 시점 변경, 국소 및 복합 편집, 단일 또는 다중 이미지에 기반한 대상 조건부 생성을 보여준다.
Emu3.5의 종합 점수 0.637은 표에 나열된 비교 모델 중 가장 높다. 다만 얼굴 참조, 스타일 참조, 얼굴 교체에서는 Gemini 2.5 Flash Image보다 약하다. 세부 결과는 종합 점수만으로 모든 작업에서 우세하다고 해석할 수 없음을 보여준다.
6.3 Visual Narrative
Visual Narrative는 Gemini 2.5 Flash Image와의 ChatGPT 비교를 통해 시각, 텍스트, 모달리티 간 품질을 평가한다. Emu3.5는 승리 49.2%, 무승부 10.3%, 패배 40.5%를 기록한다. 이는 이야기 생성 성능이 비슷하다는 논문의 설명과 부합한다.
- Figure 16은 텍스트 전용 및 이미지 조건부 이야기를 보여주며, 만화 이야기, 역사 설명, 가상 상황, 자연 묘사를 다룬다. 평가는 생성된 이야기의 품질을 측정하며 교육 콘텐츠의 사실 정확성을 별도로 검증하지는 않는다.
6.4 Visual Guidance
Visual Guidance 평가는 단계의 관련성과 완결성, 지시의 명확성, 텍스트와 이미지 정합성, 절차의 일관성, 시각 정보의 유용성, 작업 완료, 이미지 품질을 고려한다. Gemini 2.5 Flash Image 대비 자동 선호도에서 승리 51.5%, 무승부 9.5%, 패배 39.0%를 기록한다.
- Figure 17은 스케치 완성 과정, 식물 심기, 요리, 표정 변화, 객체 다루기, 케이블 정리, 조각을 보여준다. 이는 생성된 절차 묘사이며 평가에서는 사용자가 묘사된 절차를 완료했는지 보고하지 않는다.
6.5 World Exploration
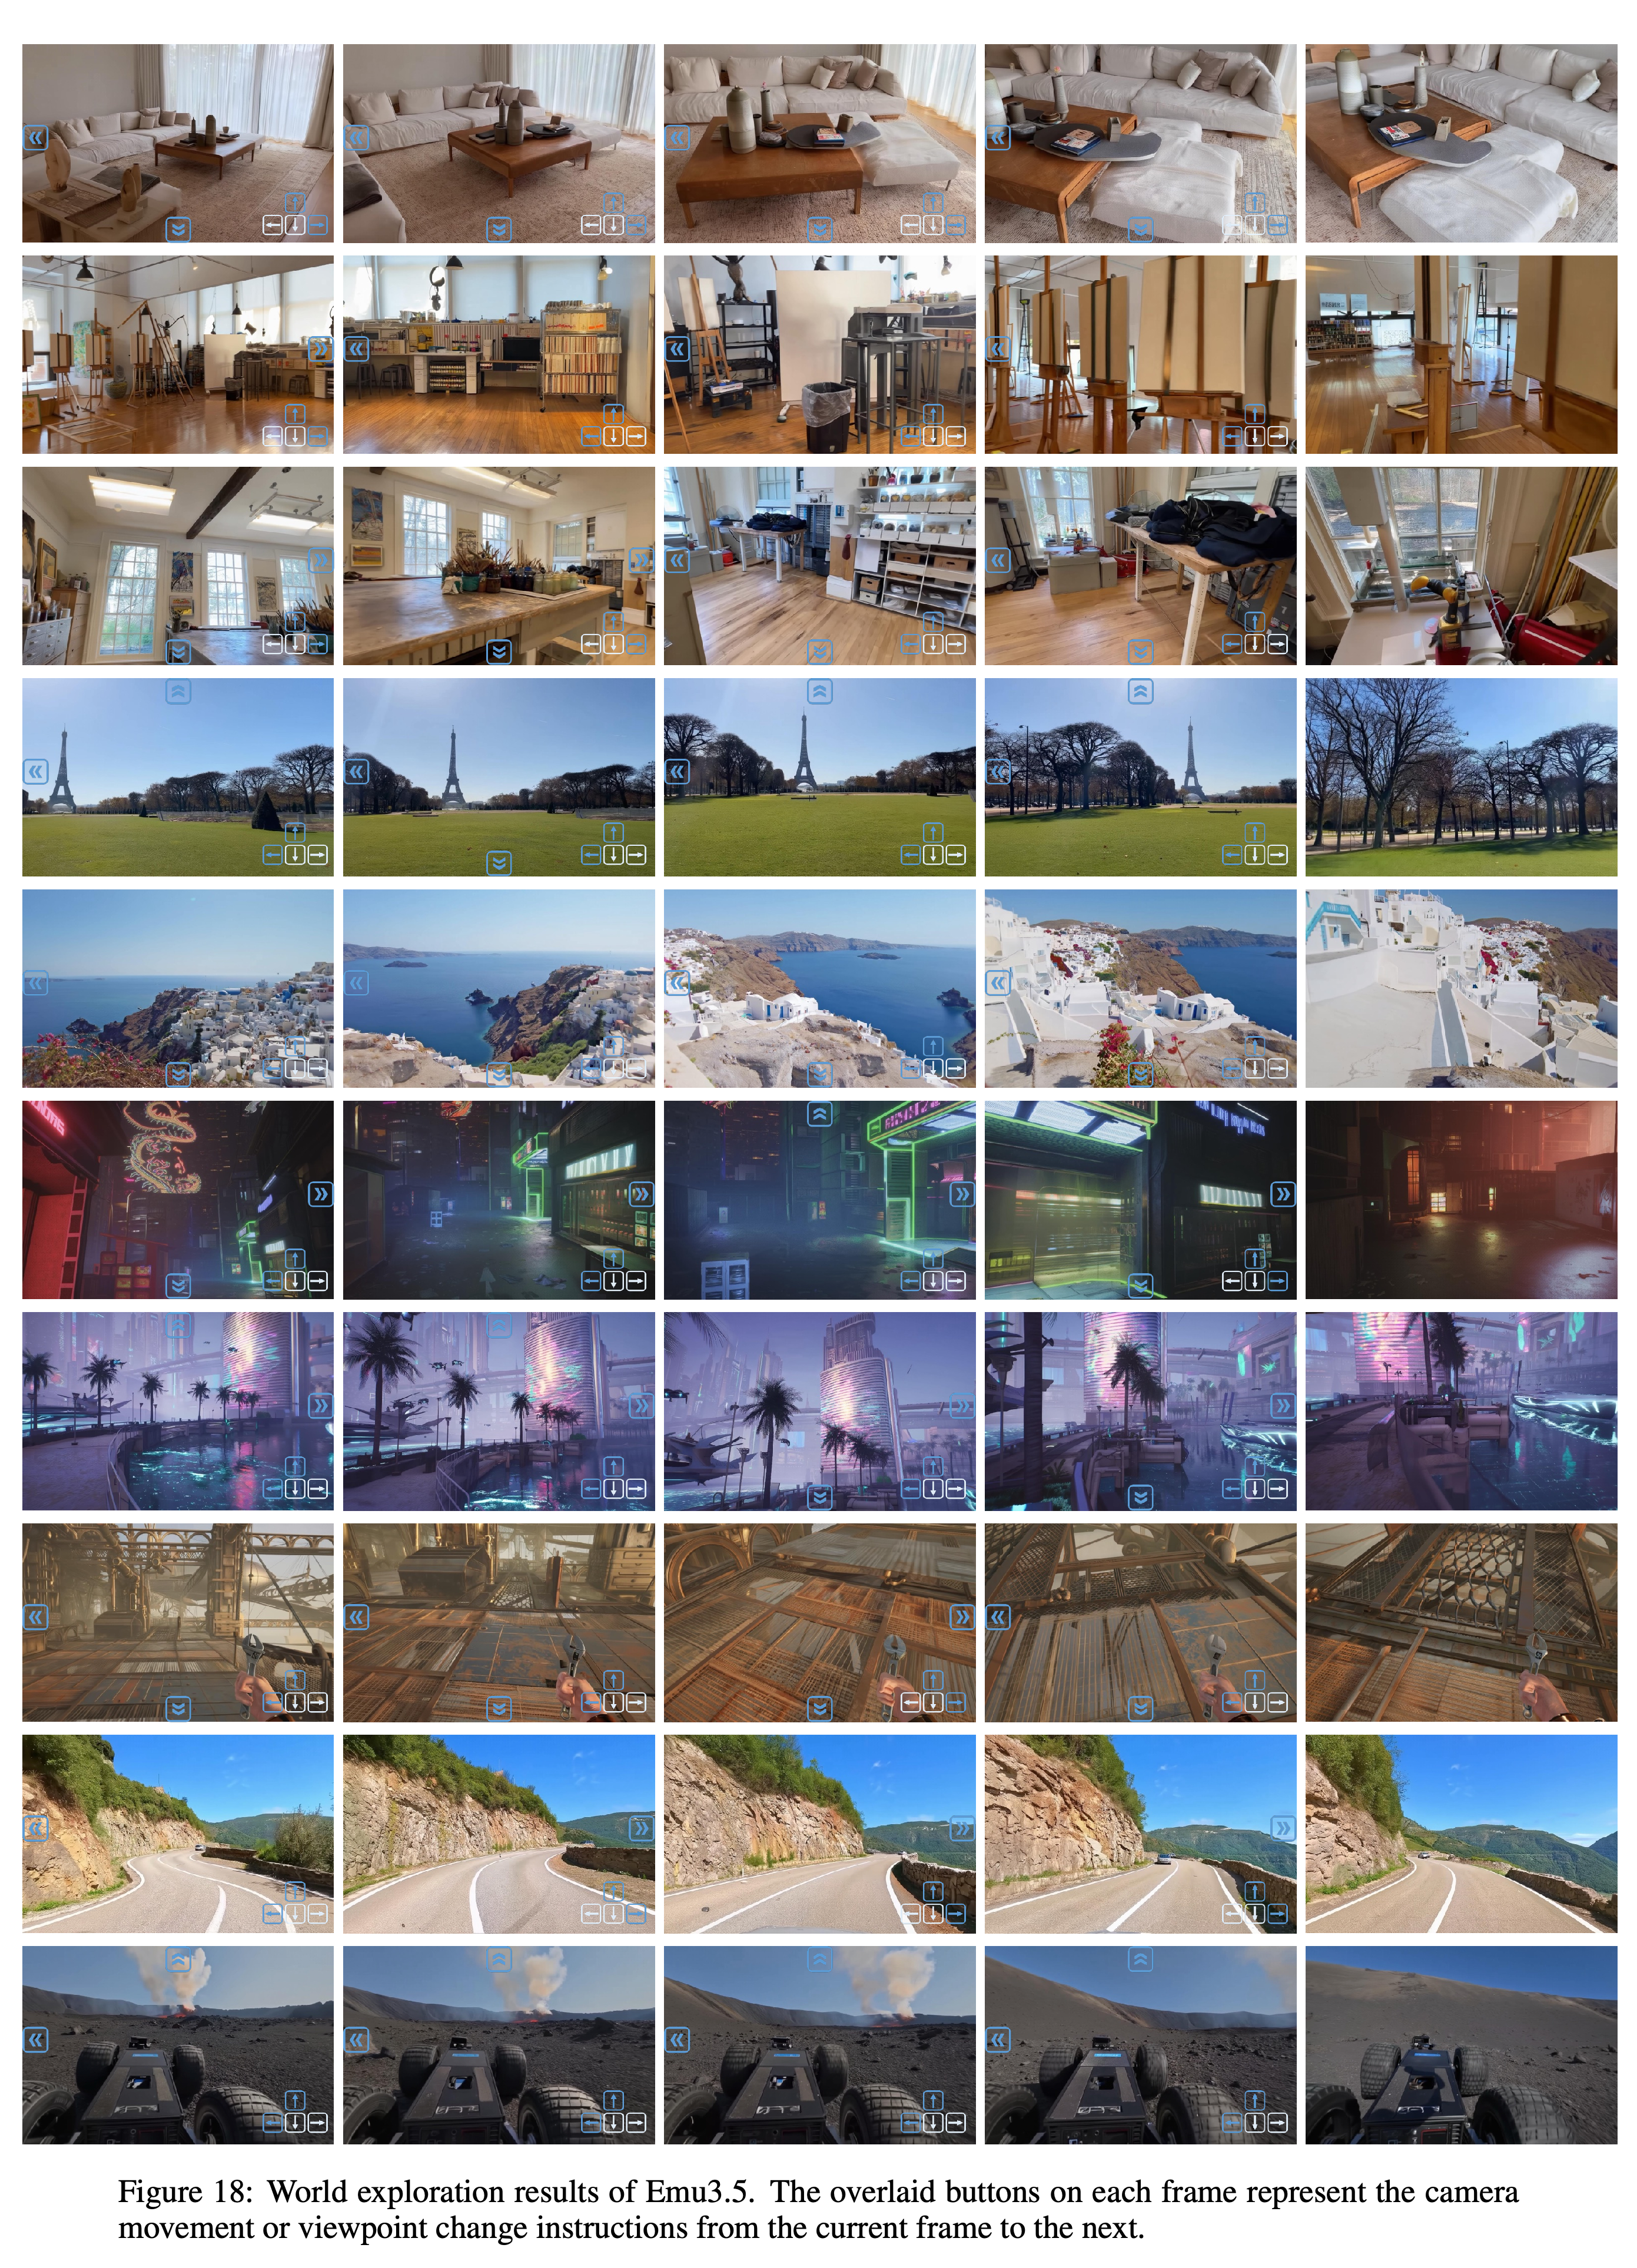
World Exploration 평가는 학습 영역 내 시나리오와 추가적인 영역 밖 시나리오, 텍스트 전용 및 멀티모달 프롬프트, User-Interactive 및 Free-Exploration 모드를 포함한다. ChatGPT는 경로의 타당성, 공간 일관성, 전체 일관성, 환경의 풍부함, 시각 정보와 텍스트 정합성, 이미지 품질, 텍스트 품질, 작업 완료라는 8개 기준을 평가한다. Emu3.5는 승리 65.5%, 패배 34.5%를 기록한다.
- Figure 18은 User-Interactive Mode에서 텍스트만으로 초기화하는 방식을 강조하고 실내, 야외, 주행, 게임과 유사한 장면의 연속 시점을 보여준다. Table 14는 선호도를 종합하며 입력 모드나 영역별 정량 점수를 따로 제시하지 않는다.
연속으로 생성된 시점은 방, 풍경, 도로, 게임 환경에서 지시에 따른 카메라 움직임을 보여준다. 선별된 궤적은 상호작용 형식을 보여주지만 임의의 경로에서 기하학적 일관성을 정량화하지는 않는다.
6.6 Embodied Manipulation
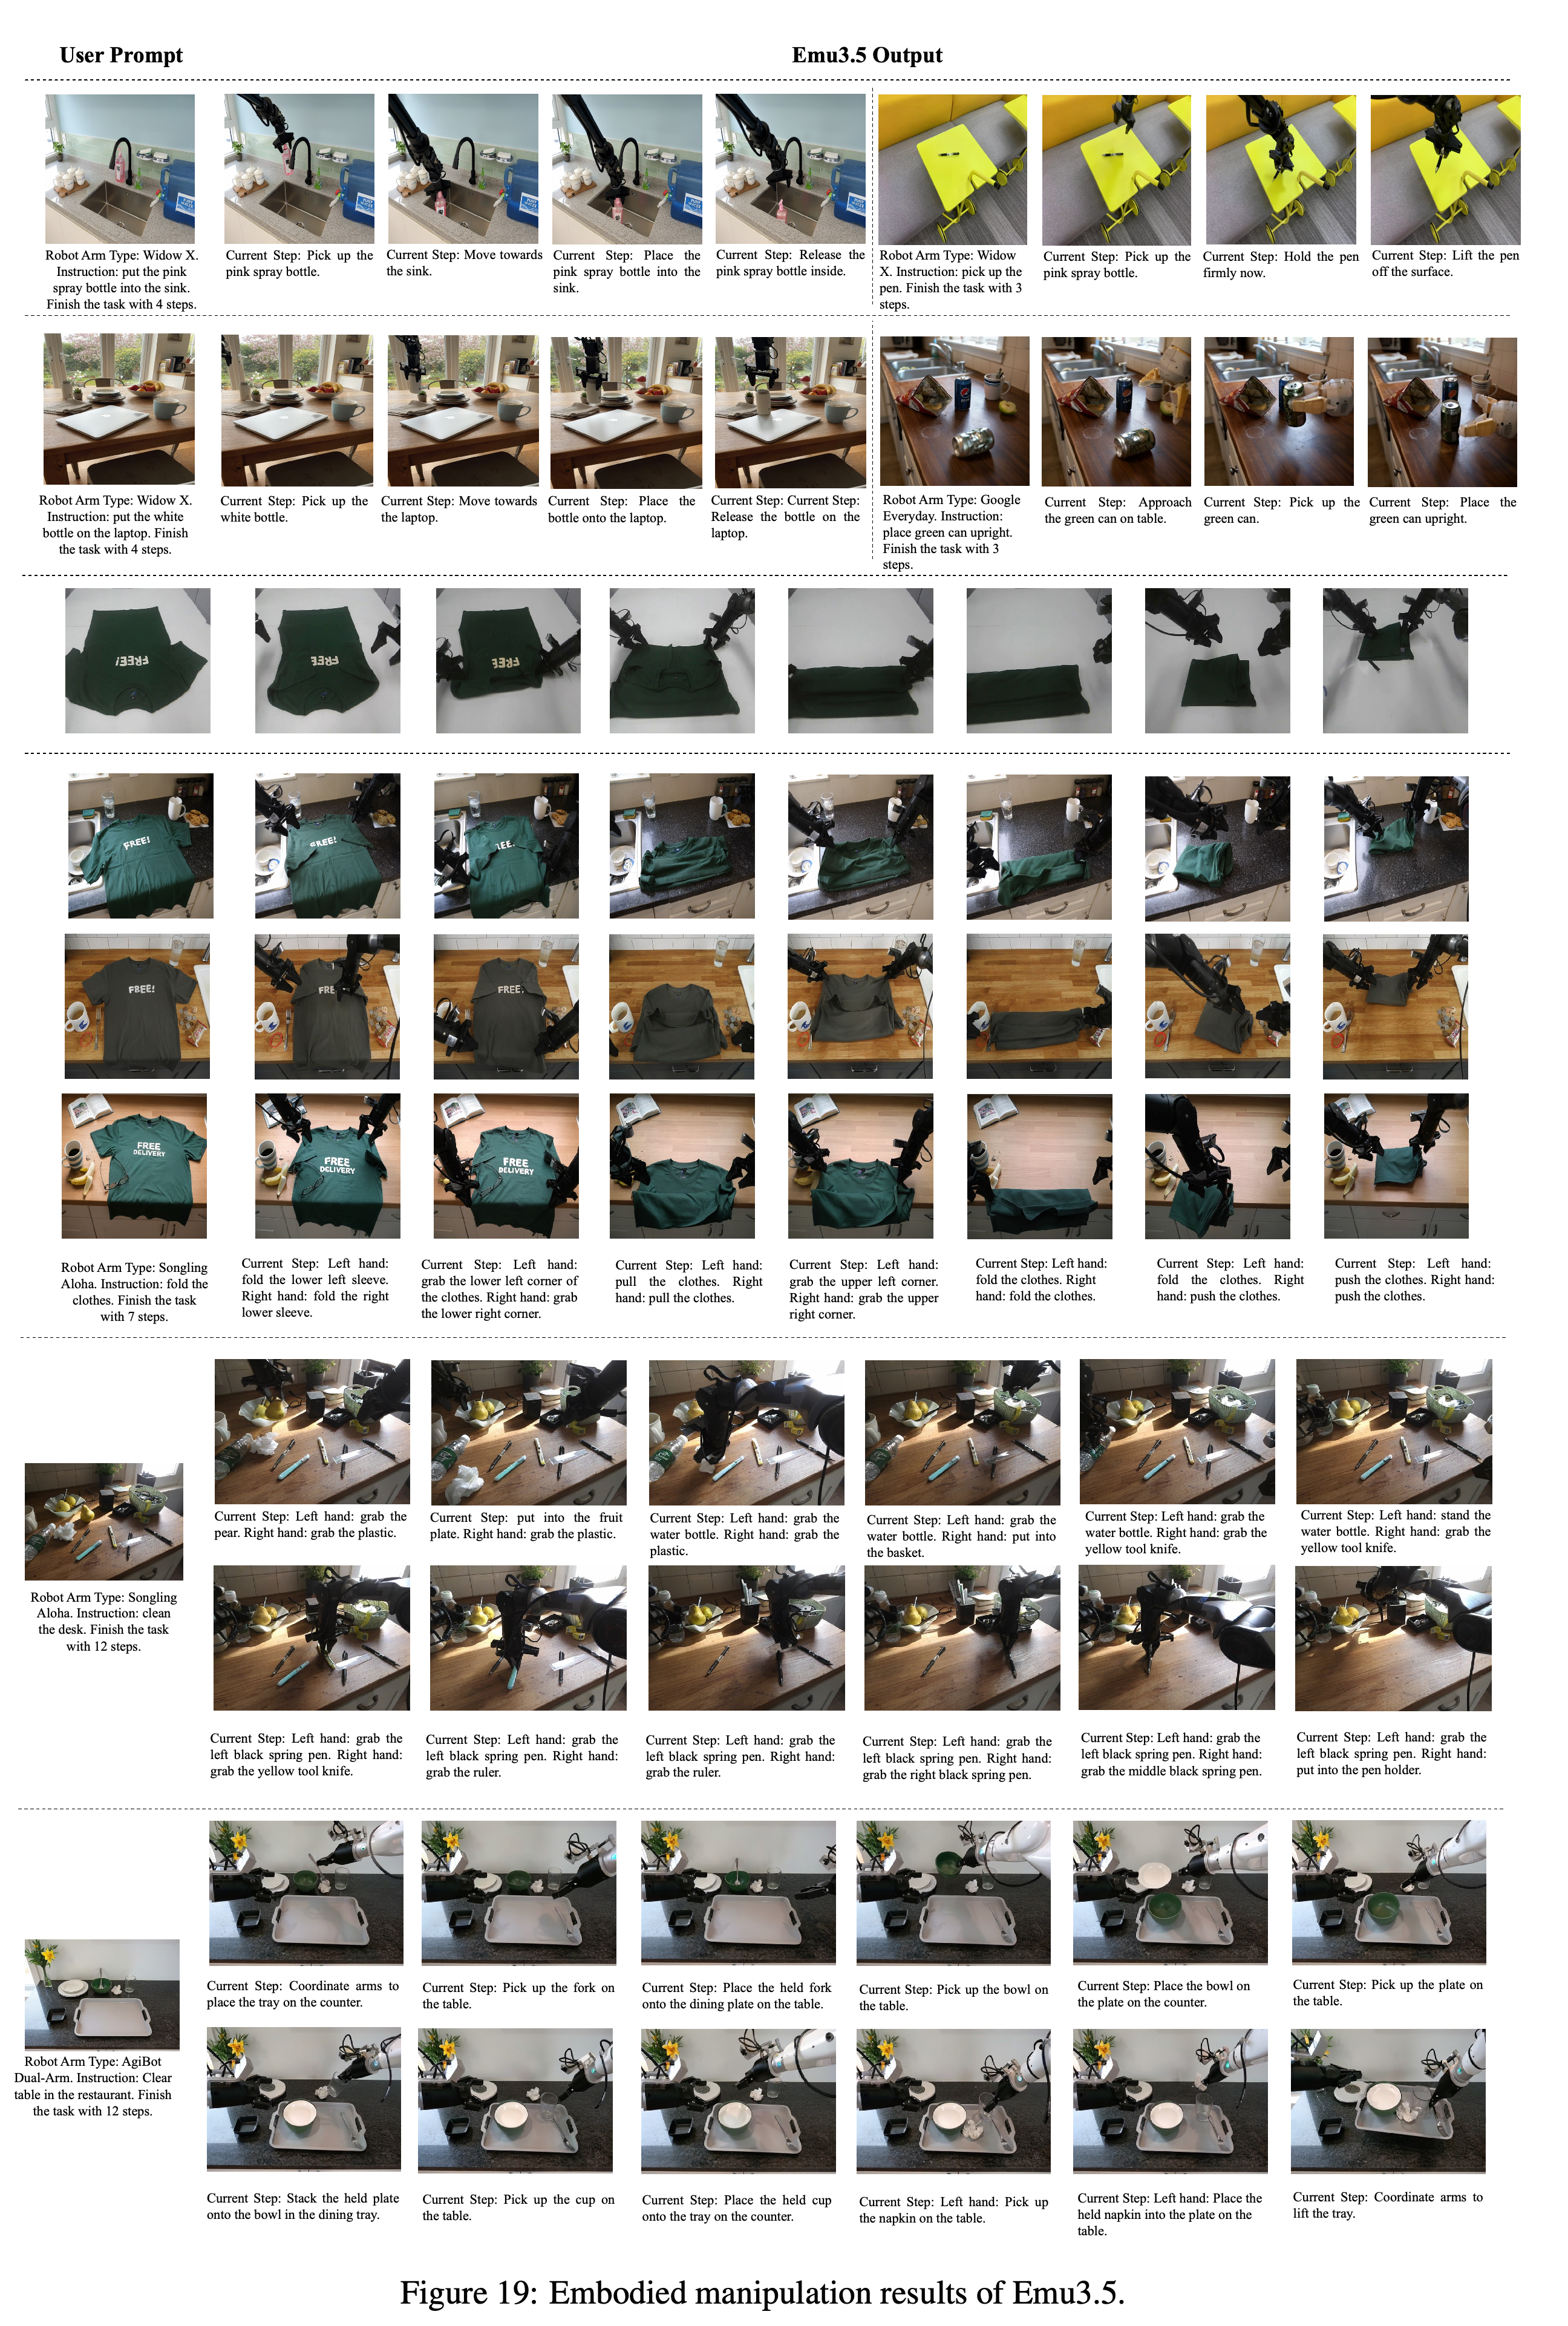
Embodied Manipulation 평가는 로봇 구성인 robotic embodiment 5개와 3–13단계로 이루어진 50개 초과 작업을 다룬다. 샘플 331개는 실제 촬영 이미지 10개, 추출한 예제 109개, 팔 위치와 환경 조건을 변형한 합성 예제 192개로 구성된다.
- ChatGPT는 하위 작업 기술의 명확성, 텍스트와 이미지 정합성, 작업 실행의 진행 정도, 이미지 품질, 배경 일관성, 물리 법칙과의 일관성을 평가한다. Emu3.5는 Gemini 2.5 Flash Image 대비 승리 67.1%, 무승부 2.4%, 패배 30.5%를 기록한다.
- Figure 19는 객체 배치, 천 접기, 표면 정리를 위한 하위 작업과 키프레임의 생성 시퀀스를 보여준다. 첫 번째 천 접기 행을 제외한 모든 초기 프레임은 Gemini 2.5 Flash Image로 생성한다. 보고된 결과는 실제 실행된 로봇 궤적이 아니라 생성된 계획과 이미지를 평가한다.
승리, 무승부, 패배 열은 이야기와 안내의 작은 선호도 차이와 탐색 및 조작의 큰 차이를 구분해 보여준다. 이 비율은 비교 모델 1개에 대한 자동 선호도를 측정하며 실제 물리 작업의 성공을 측정하지는 않는다.
예제는 여러 로봇 유형과 다단계 활동에 대해 언어로 표현한 하위 작업과 생성된 키프레임을 연결한다. 예측한 상호작용 상태를 시각화하며 이에 대응하는 실제 실행 성공 측정은 제시하지 않는다.
6.7 Tokenizer Reconstruction
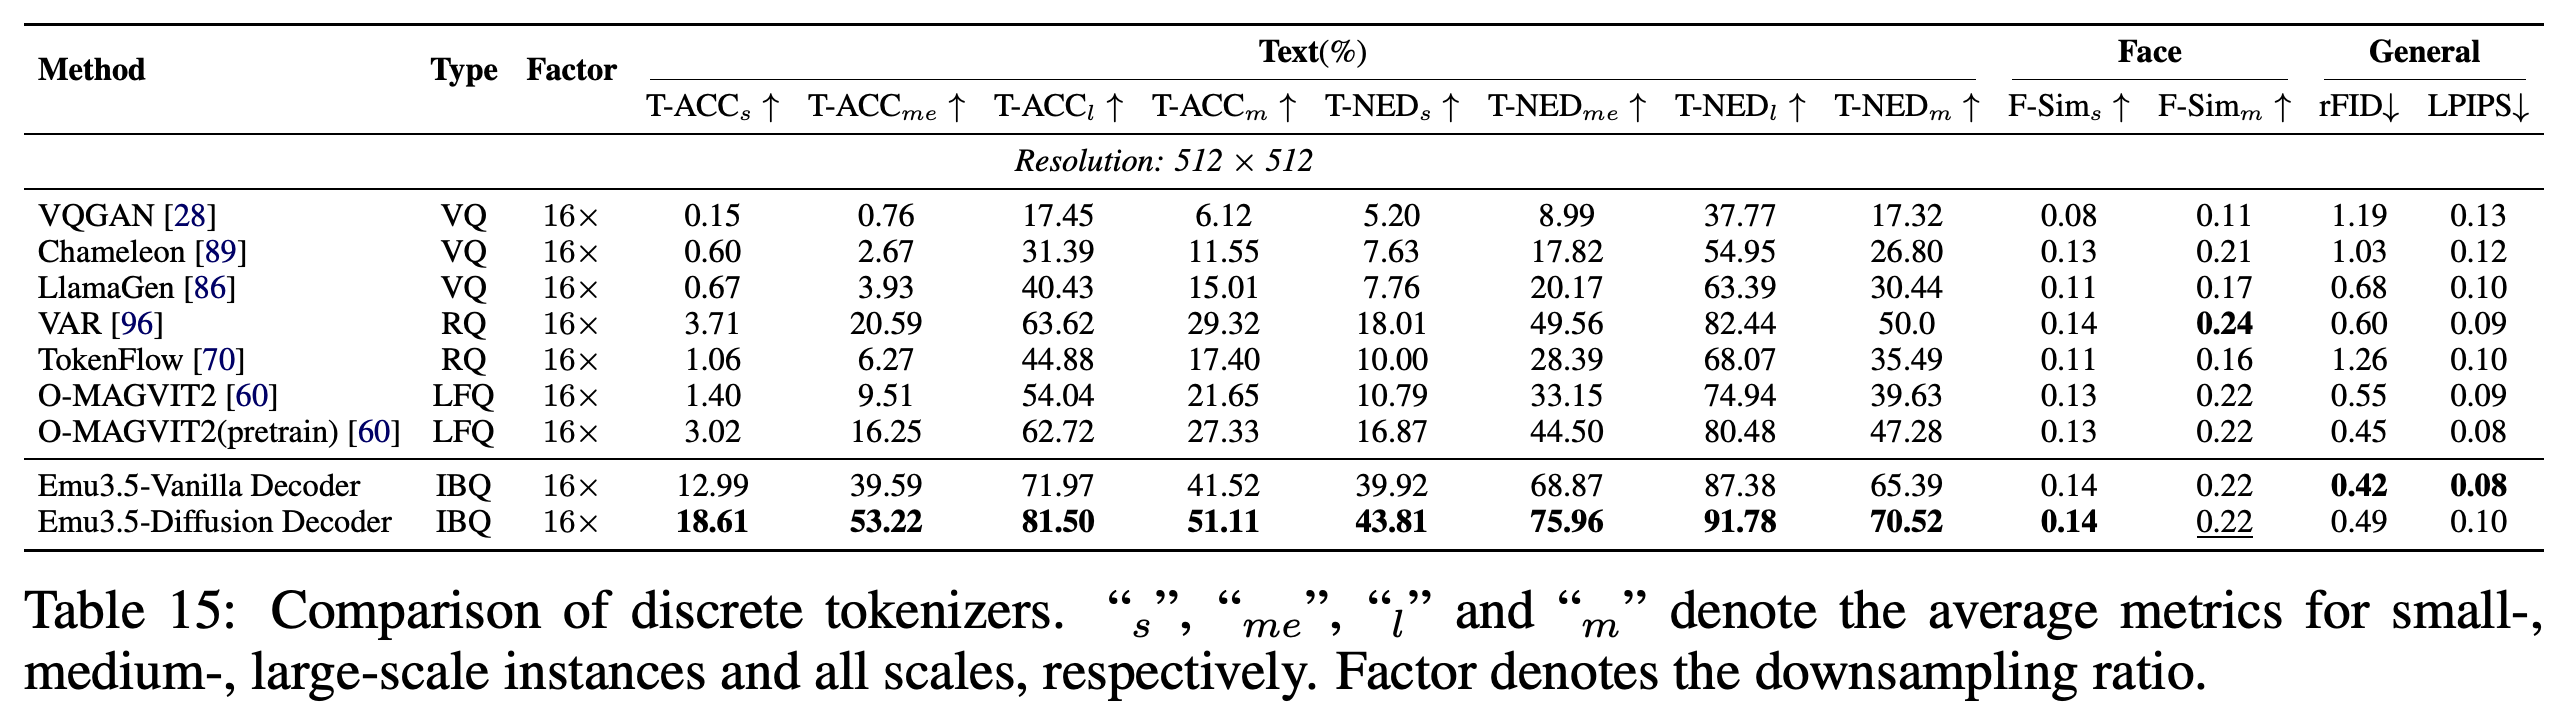
토크나이저 평가는 텍스트와 얼굴 복원을 평가하는 시각 토크나이저 벤치마크인 Tokbench와 일반 복원용으로 선별한 60k-image 데이터셋을 사용한다. 확산 디코더는 기본 디코더 대비 전체 크기 범주의 텍스트 정확도를 41.52에서 51.11로, 보고된 정규화 텍스트 점수를 65.39에서 70.52로 높인다.
- Table 15는 상충 관계도 보여준다. 분포 기반 복원 지표인 reconstruction Fréchet Inception Distance (rFID)는 0.42에서 0.49로, LPIPS는 0.08에서 0.10으로 악화된다. 2개 지표 모두 낮을수록 좋다.
- 2개 디코더의 전체 크기 범주 얼굴 유사도는 모두 0.22다. Figure 11은 텍스트, 인물, 동물, 풍경의 원본과 복원 결과를 비교한다. 선택적으로 사용하는 확산 디코더는 기본 디코더의 2배 해상도로 복원한다.
확산 디코더는 기본 디코더보다 텍스트 복원을 개선하지만 rFID와 LPIPS는 악화시킨다. 2개 Emu3.5 디코더의 얼굴 유사도는 같으므로, 개선 여부는 지표에 따라 달라진다.
6.8 Discrete Diffusion Adaptation
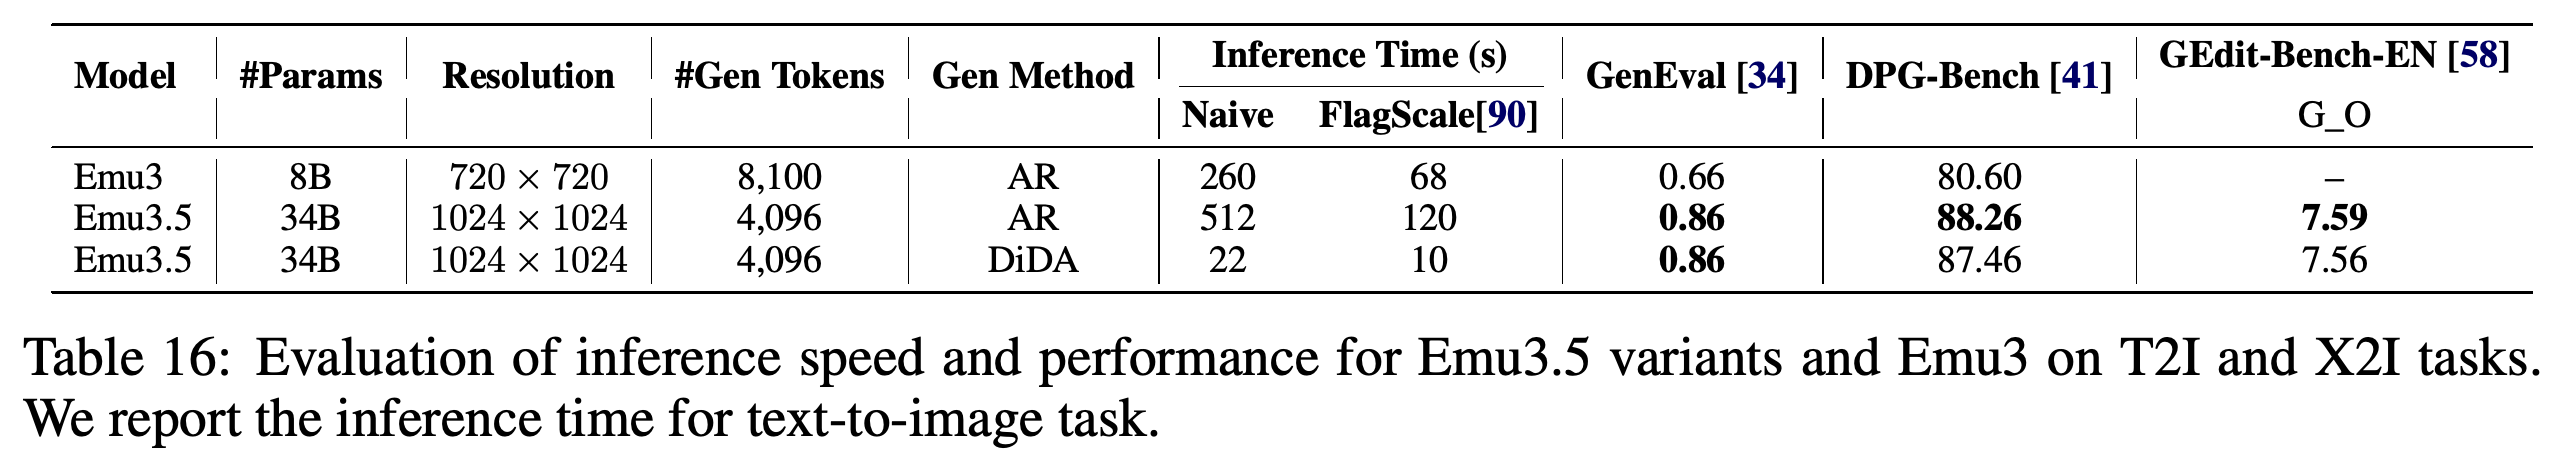
1024×1024 해상도와 생성 토큰 4,096개 조건에서 DiDA는 단순 구현의 추론 시간을 512 s에서 22 s로, FlagScale 추론 시간을 120 s에서 10 s로 줄인다. 이 수치로 계산한 속도 향상은 각각 약 23.3배와 12배지만 논문의 본문은 가속 효과를 최대 20배로 요약한다.
- GenEval은 0.86을 유지한다. 다른 이미지 생성 정합성 벤치마크인 DPG-Bench는 88.26에서 87.46으로, GEdit-Bench-EN 종합 점수는 7.59에서 7.56으로 낮아진다. 결과는 일부 점수의 소폭 하락과 함께 측정된 품질이 비슷하게 유지됨을 뒷받침한다.
- 비교 대상 Emu3는 파라미터 8B개, 해상도 720×720, 토큰 8,100개를 사용하며 GenEval 0.66과 DPG-Bench 80.60을 기록한다. 해상도, 파라미터 수, 토큰화가 달라서 이 비교로 특정 변경 사항의 효과를 따로 확인할 수는 없다.
대응하는 Emu3.5 행들은 1024×1024와 토큰 4,096개 조건에서 디코딩 방법을 비교한다. FlagScale 지연 시간은 120 s에서 10 s로 줄어든다. GenEval은 유지되며, DPG-Bench와 GEdit-Bench-EN은 소폭 하락한다. 표의 지연 시간은 text-to-image 생성에 대한 결과다.
7 Conclusion, Limitations and Future Work
결론은 Emu3.5의 성능이 대규모 통합 예측 학습과 멀티모달 사후 학습에서 비롯된다고 설명하며 모델과 개발 과정을 공개한다고 밝힌다. 명시된 한계에는 512×512 이미지에도 여전히 필요한 토큰 1,024개, 남아 있는 추론 지연, 장기 작업에 대한 체계적인 평가 부족이 포함된다.
- 향후 연구로 토크나이저 압축과 복원 개선, 추가 가속, 정량 및 인간 평가 벤치마크, 더 풍부한 멀티모달 프롬프팅, 물리 세계와 상호작용하는 체화 에이전트를 제안한다. 이 방향들은 논문에서 입증한 생성 실험의 범위를 넘어선다.
8 Authors and Contributions
논문은 BAAI의 Emu3.5 Team을 명시하고 작업 분야별 기여자를 나열한다. 별표는 핵심 기여자를 표시하며 이들은 중국어 성의 획수순으로 배열된다. Zhongyuan Wang과 Tiejun Huang은 Senior Leads이며, Xinlong Wang은 Project Lead다.
- Tokenizer에는 Fan Zhang*, Zhuoyan Luo*, Xu Huang*이 참여한다.
- Data에는 Yueze Wang*, Wenxuan Wang*, Yufeng Cui*, Chengyuan Wang, Xinghang Li, Honghao Chen, Fan Zhang, Yang Liu, Zhuoyan Luo, Jinsheng Wang이 참여한다.
- Pre-training에는 Yufeng Cui*, Wenxuan Wang, Yueze Wang, Zhuoyan Luo, Yingli Zhao, Fan Zhang, Zecheng Hao, Wenxuan Ma가 참여한다.
- Downstream Post-training에는 Yueze Wang*, Wenxuan Wang*, Chengyuan Wang*, Jirong Liu*, Yang Liu*, Honghao Chen*, Xinghang Li*, Fan Zhang*, Zhuoyan Luo*, Yufeng Cui*가 참여한다.
- Unified Post-training에는 Jinsheng Wang*, Yang Liu*, Jirong Liu*, Yufeng Cui, Chengyuan Wang, Wenxuan Wang, Honghao Chen이 참여한다.
- Discrete Diffusion Adaptation에는 Haoge Deng*, Fan Zhang*, Ting Pan, Yingli Zhao, Xianduo Li가 참여한다.
- Infrastructure에는 Yingli Zhao*, Xianduo Li, Zhuo Chen, Yulong Ao가 참여한다.
부록
- PDF에는 Appendix라는 제목이 명시된 절이 없다. 29–36페이지에는 실험 절에서 다룬 추가 정성 그림이 있으며 37–45페이지에는 References가 있다. 프로젝트 URL은 https://emu.world 와 https://github.com/baaivision/Emu3.5 다.
짧은 생각
가장 명확한 공학적 비교는 DiDA다. 대응하는 Emu3.5 행들은 보고된 모델 크기, 해상도, 토큰 수가 같으며 벤치마크 점수를 거의 유지하면서 지연 시간을 크게 줄인다. 자동 선호도 평가는 생성된 탐색과 조작 시퀀스를 선호한다. 다만 실험은 실제 실행의 성공을 입증하거나 동영상 사전 학습과 공동 RL의 기여를 분리하지는 못한다. 저자들도 인간 평가를 향후 과제로 제시한다.