


DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models 요약 설명
02 Dec 2025 | Paper Review Sparse Attention Reinforcement Learning Agent Training Data목차
이번 글에서는 DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 2일(Arxiv)
- DeepSeek-AI, Liu, Aixin, Mei, Aoxue, Lin, Bangcai, Xue, Bing, Wang, Bingxuan, Xu, Bingzheng, Wu, Bochao, Zhang, Bowei, Lin, Chaofan, et al.
- DeepSeek-AI
- 논문 링크
요약
- DeepSeek-V3.2는 공개 언어 모델의 긴 입력 처리 비용과 독점 모델보다 부족한 추론 및 도구 사용 능력을 개선한다. 도구 사용은 모델이 외부 함수를 호출해 과제를 수행하는 방식이다. 논문의 벤치마크 설정에서 DeepSeek-V3.2는 여러 추론 과제에서 GPT-5-High와 비슷한 성능을 보인다. 더 많은 연산을 사용하는 DeepSeek-V3.2-Speciale는 여러 수학 벤치마크에서 Gemini-3.0-Pro보다 높은 점수를 얻지만 출력 토큰도 더 많이 사용한다.
- DeepSeek Sparse Attention (DSA)은 각 query 토큰에 대해 앞선 토큰을 선택하는 attention 방식이다. 경량 indexer가 attention에 사용할 저장 표현인 key-value 항목 2048개를 선택한다. 실험 모델은 DeepSeek-V3.1-Terminus와 비교해 보고된 짧은 문맥 및 긴 문맥 성능을 유지한다. 서비스 벤치마크에서는 긴 시퀀스의 뒤쪽 토큰 위치에서 추론 비용이 더 낮다.
- 보상으로 응답을 최적화하는 강화학습(RL)에 사전 학습 비용의 10%를 넘는 연산 예산을 투입한다. 이 학습 방식은 응답 분포 간 차이 추정치를 보정하고 갱신 대상과 충분히 다른 모델 정책이 생성한 음의 보상 우위 응답 중 일부를 제외한다. 또한 생성과 학습에서 활성 모델 모듈을 선택하는 expert routing과 출력 후보 토큰을 제한하는 token-sampling mask를 동일하게 유지한다.
- 에이전트 학습 파이프라인은 도구 및 환경과 상호작용해야 하는 과제를 구성한다. 실제 도구에 추출하거나 합성한 프롬프트를 결합하며 일반 에이전트 과제 4,417개를 포함한 합성 환경 1,827개를 생성한다. 확장된 추론 과정을 출력하지 않는 non-thinking mode에서 합성 일반 에이전트 데이터만 사용한 통제 실험은 지도 학습 체크포인트와 검색 및 코드 환경에서 RL을 수행한 비교 모델보다 높은 도구 사용 벤치마크 성능을 보인다.
- DeepSeek-V3.2-Speciale는 여러 후보 해답을 생성하거나 해답을 반복적으로 개선해 2025년 수학 및 프로그래밍 대회 4개에서 논문이 보고한 금메달 기준에 도달한다. 모델이 한 번에 참조할 수 있는 대화량인 128K-token context window 때문에 에이전트의 수행 과정이 중간에 끊길 수 있다. 점수는 실행 프레임워크에도 영향을 받으며 Table 3에서 Speciale의 정확도 향상에는 Gemini-3.0-Pro보다 긴 출력이 필요하다.
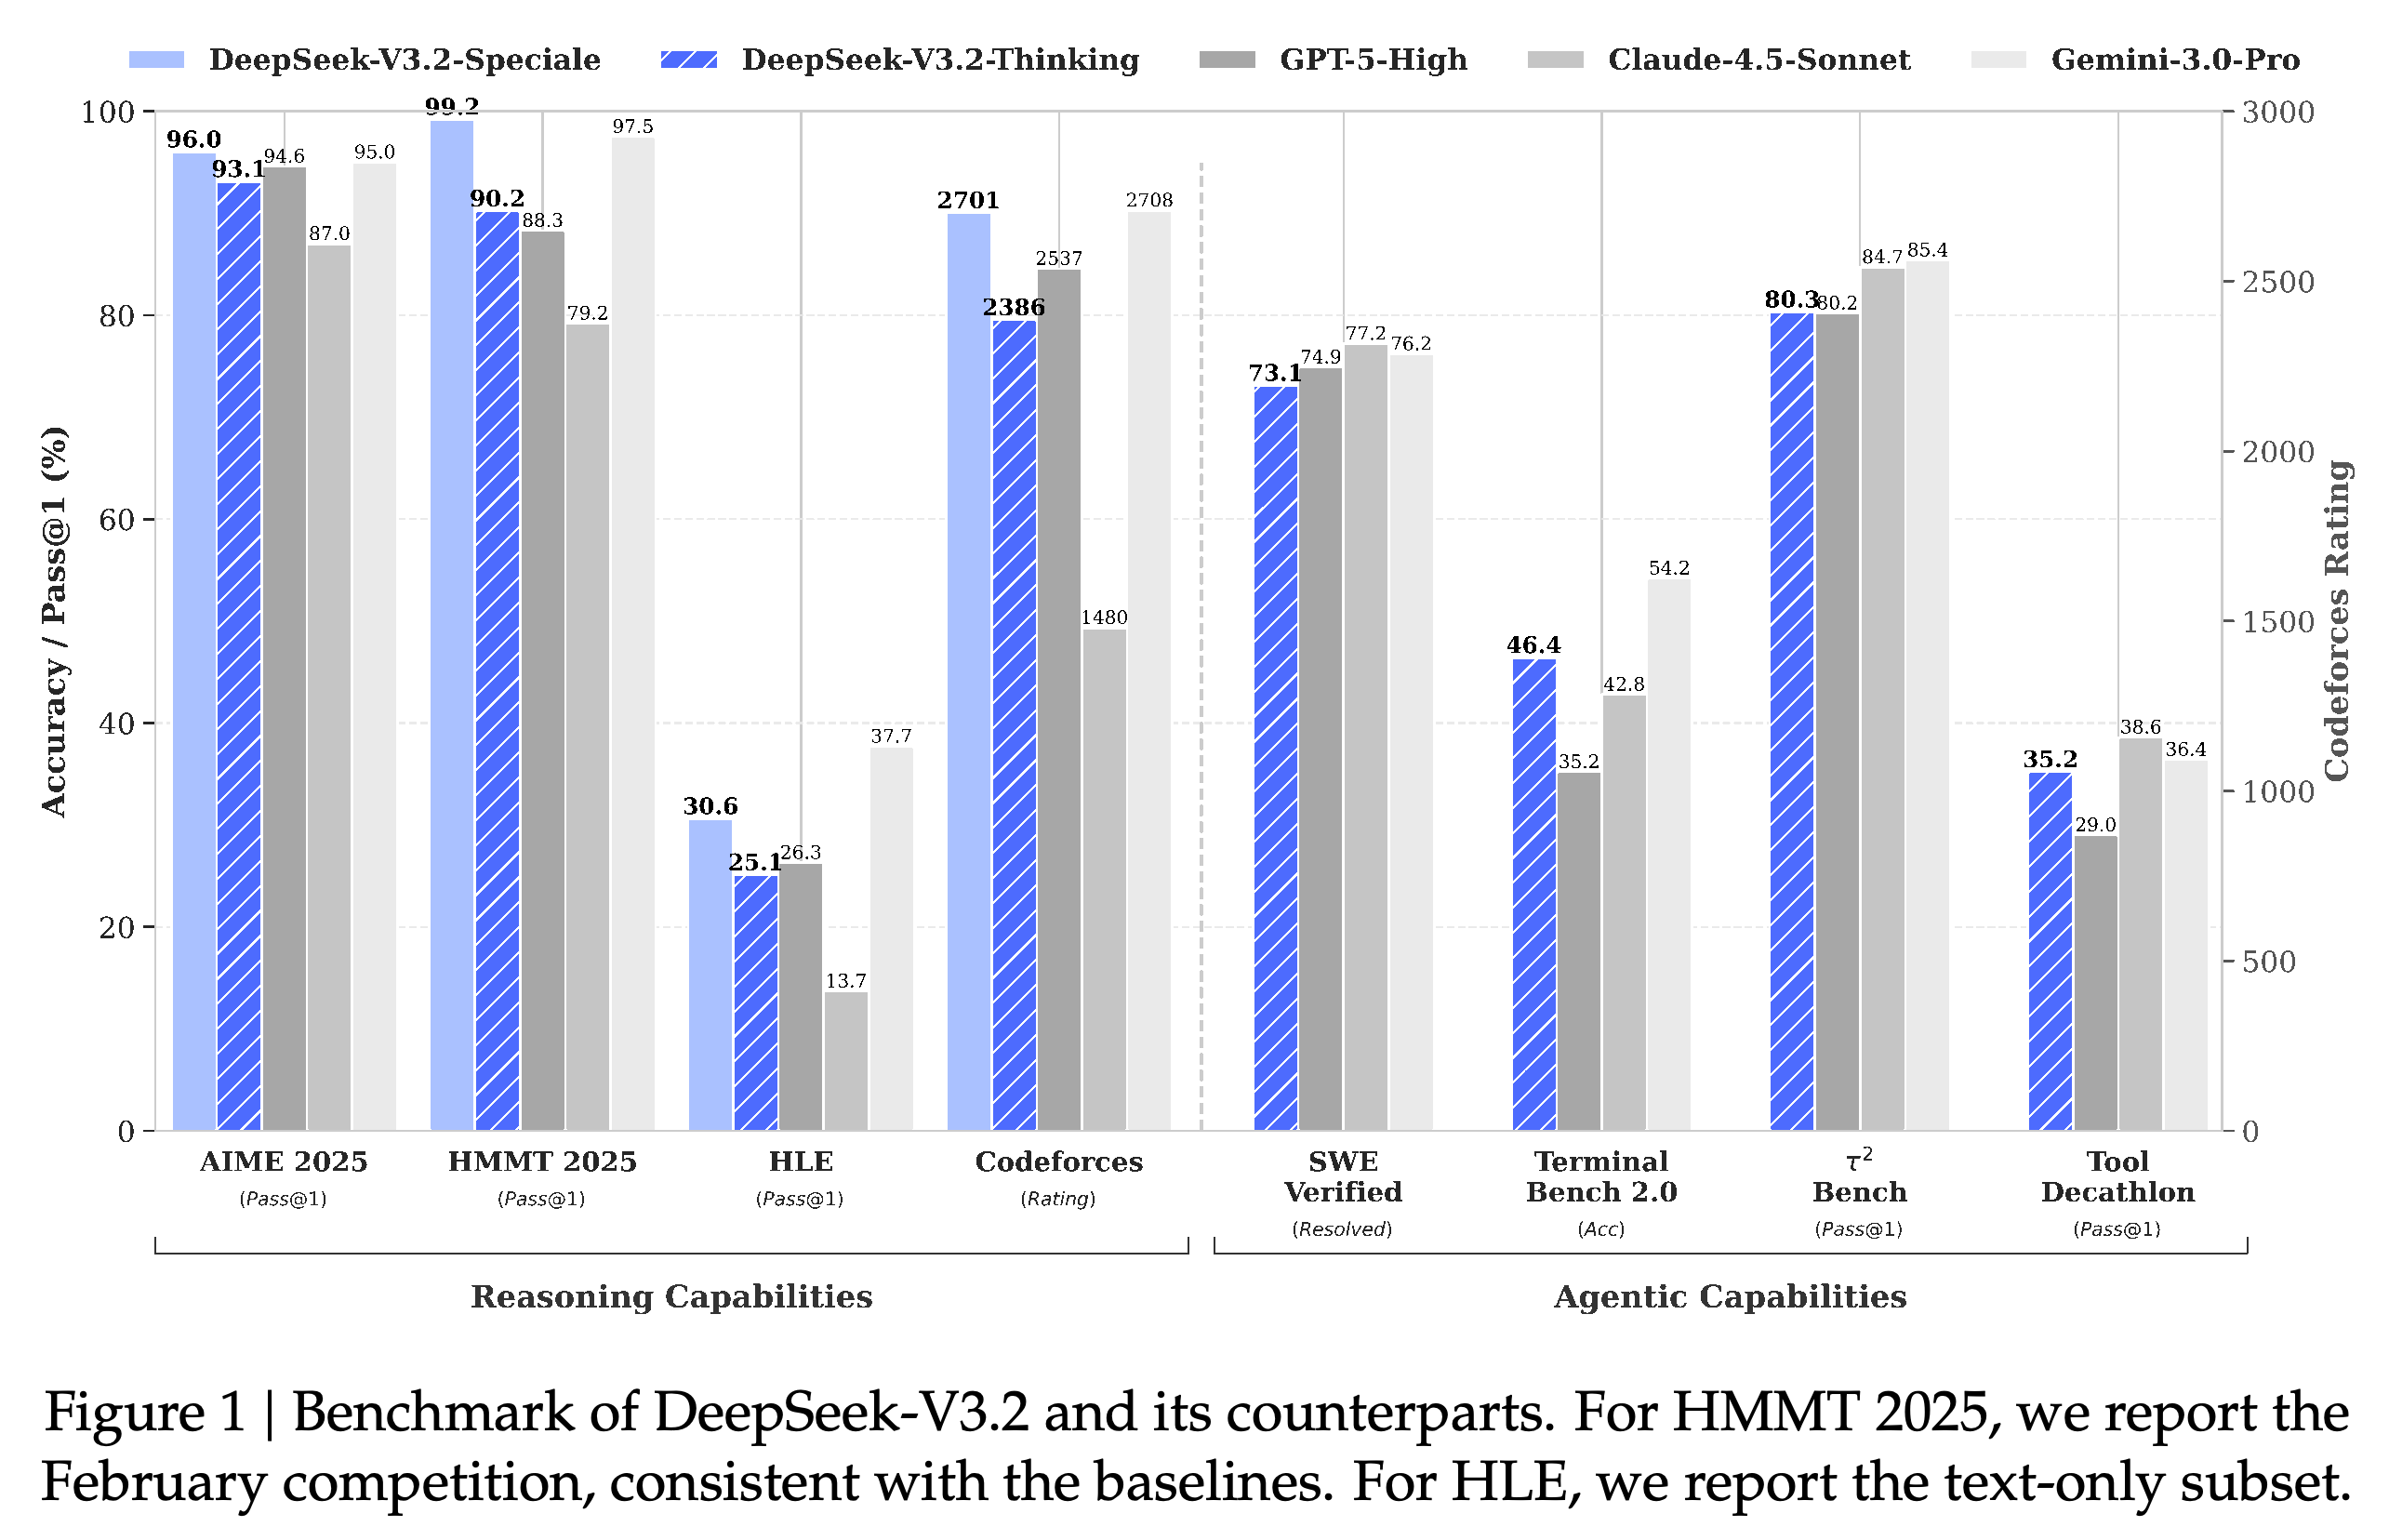
개요는 추론 벤치마크와 에이전트 벤치마크를 구분하며 제시된 추론 과제에서 Speciale의 성능 향상을 보여준다. 표준 모델이 에이전트 과제에서 모든 독점 비교 모델을 앞서는 것은 아니다. 그래프의 HMMT 값 90.2는 캡션의 2월 표기와 충돌한다. Tables 2–3은 2월의 92.5와 11월의 90.2를 구분한다.
1. Introduction
서론은 공개 대규모 언어 모델의 제약 3가지로 긴 시퀀스에 대한 높은 attention 비용, 부족한 후속 학습 연산량, 도구와 상호작용하는 환경에서의 낮은 일반화 및 지시 이행 능력을 제시한다. 이를 개선하기 위해 DSA, 확장 가능한 RL 학습 방식, 에이전트 과제 합성을 결합한다. 서론에서는 1,800개가 넘는 환경과 복잡한 프롬프트 85,000개를 보고한다.
2. DeepSeek-V3.2 Architecture
DeepSeek-V3.2는 DeepSeek-V3.2-Exp와 같은 아키텍처를 사용한다. DeepSeek-V3.1-Terminus와 비교했을 때 유일한 아키텍처 변경은 지속 학습을 통한 DSA 도입이다.
2.1. DeepSeek Sparse Attention
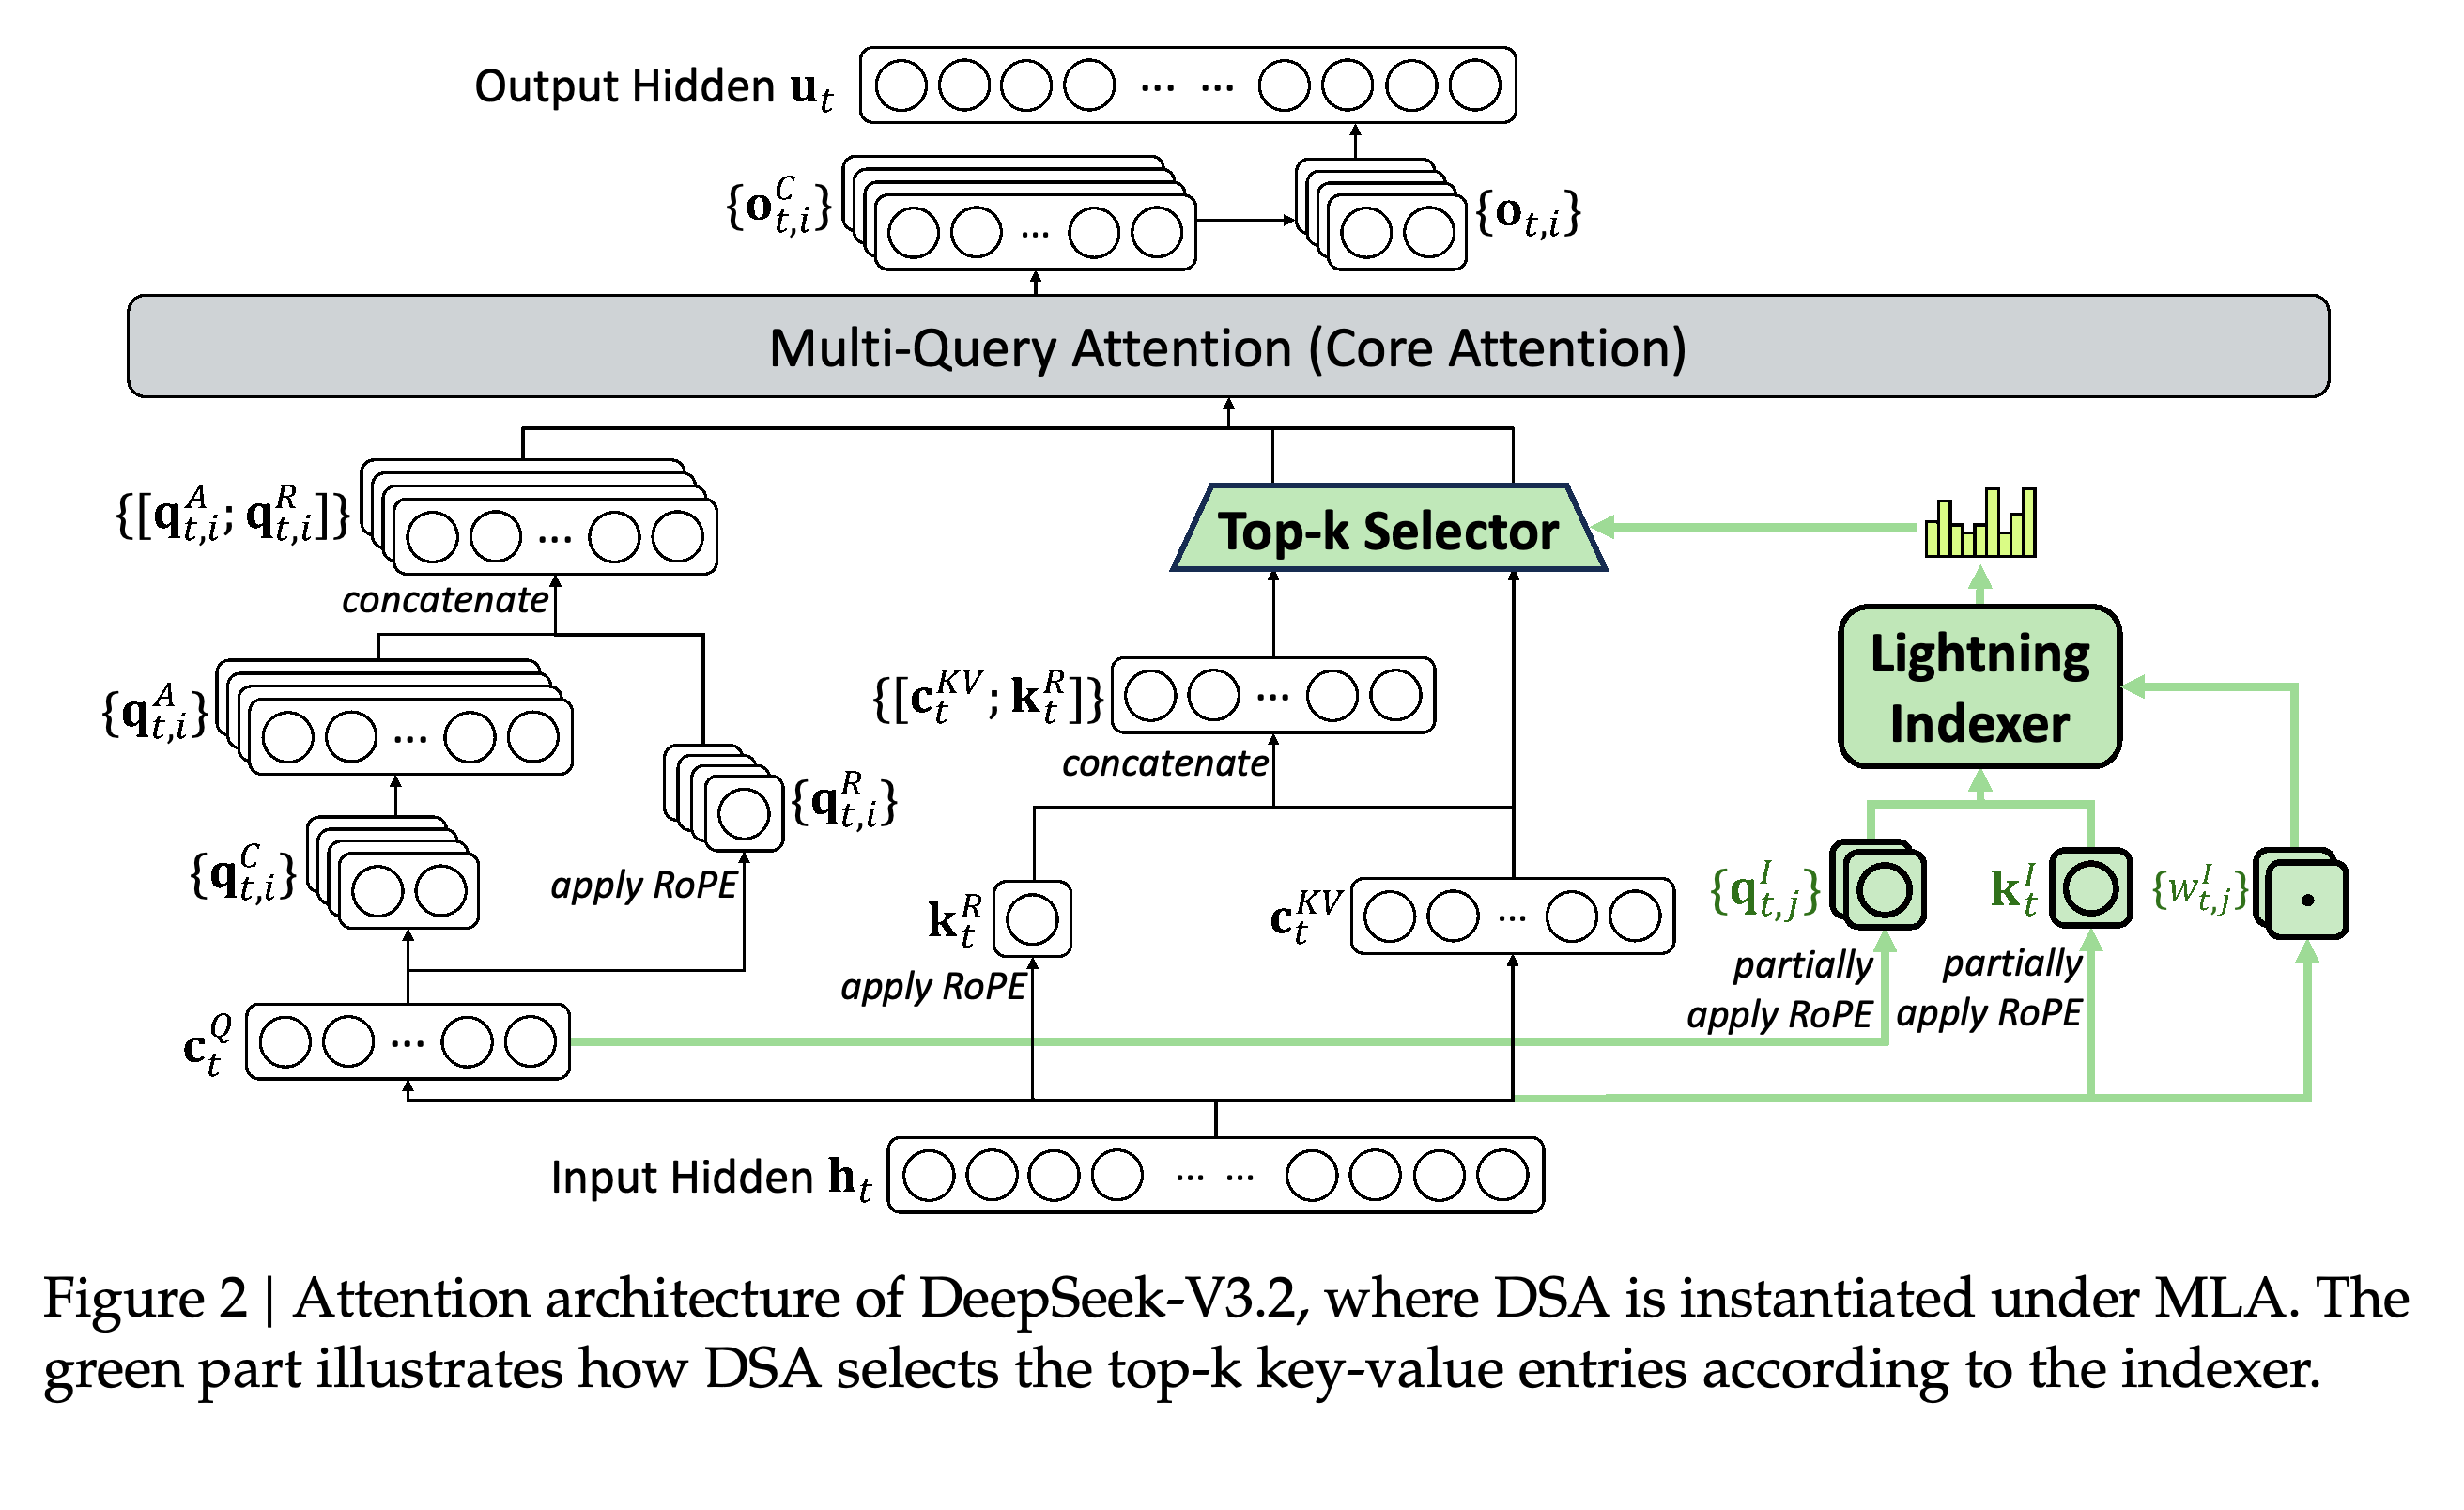
작은 점수 계산 모듈인 lightning indexer는 가중 query-key 유사도에 ReLU를 적용해 앞선 토큰의 순위를 매긴다. ReLU는 처리량을 고려해 선택한 정류 선형 활성화 함수다. 이후 attention은 index 점수가 가장 높은 k개 항목인 top-k에 적용된다. Indexer는 적은 수의 head를 사용하며 8비트 부동소수점 연산인 FP8을 지원한다.
- DSA는 key-value 항목을 잠재 벡터로 표현하는 기존 attention 설계인 MLA를 기반으로 구현한다. 각 잠재 항목을 query head 사이에서 공유하는 multi-query attention인 MQA를 사용한다.
- Index 점수는 \(I_{t,s}=\sum_{j=1}^{H^I}w^I_{t,j}\operatorname{ReLU}\left(\mathbf{q}^I_{t,j}\cdot\mathbf{k}^I_s\right)\)이며, H^I는 indexer head 수다.
- 참조 구현은 https://huggingface.co/deepseek-ai/DeepSeek-V3.2-Exp/tree/main/inference 에서 제공한다.
2.1.1. Continued Pre-Training은 128K context window를 갖춘 DeepSeek-V3.1-Terminus에서 시작하며 동일한 긴 문맥 데이터 분포를 사용한다. Dense warm-up에서는 indexer만 학습하고 이후 sparse training에서는 indexer와 본 모델을 함께 학습한다.
- Dense warm-up은 나머지 파라미터를 고정하고 head별 attention 점수를 합산한 뒤 전체 합을 하나로 맞춘 L1-normalized 분포에 indexer 점수를 맞춘다. 확률분포 간 차이를 측정하는 KL divergence를 사용한다. 학습률 10^-3으로 1000 steps를 수행하며 step마다 128K tokens 시퀀스 16개를 사용해 총 2.1B tokens를 학습한다.
- Sparse training은 query마다 key-value 토큰 2048개를 선택한다. 학습률 7.3 × 10^-6으로 15000 steps를 수행하며 step마다 128K tokens 시퀀스 480개를 사용해 총 943.7B tokens를 학습한다.
- Indexer 입력은 계산 그래프에서 분리하므로 indexer 손실이 본 모델을 갱신하지 않는다. 분포 일치 손실은 indexer를 학습하고 언어 모델링 손실은 본 모델을 학습한다. Sparse 단계의 분포 일치에는 선택된 토큰만 사용한다.
초록색 분기는 핵심 attention 연산 전에 토큰에 점수를 매기고 선택한다. Selector는 공유 잠재 key-value 항목을 걸러내며, 핵심 attention은 기존 attention 경로를 통해 선택된 항목 집합을 처리한다.
2.2. Parity Evaluation
동등 성능 평가에서는 DeepSeek-V3.2-Exp와 DeepSeek-V3.1-Terminus를 비교하며 짧은 문맥 및 긴 문맥 벤치마크에서 뚜렷한 성능 저하가 없다고 보고한다. 동일한 후속 학습 전략을 적용한 모델들의 ChatbotArena Elo는 2025년 11월 10일 기준으로 비슷했다. Elo는 사용자 선호도를 근사하는 비교 평점이다.
- 논문에서 인용한 긴 문맥 추론 벤치마크인 AA-LCR에서 DeepSeek-V3.2-Exp는 reasoning mode로 4 points 높은 점수를 얻는다.
- 논문은 이전에 보지 못한 테스트에서 여러 Fiction.liveBench 긴 문맥 평가 지표가 개선되었다고도 보고한다. 이 절에서는 전체 벤치마크 점수나 선호도 평점의 불확실성 추정치를 제시하지 않는다.
2.3. Inference Costs
DSA는 본 모델의 핵심 attention 연산 복잡도를 \(O(L^2)\)에서 \(O(Lk)\)로 줄인다. L은 시퀀스 길이, k는 선택한 토큰 수이며 k는 L보다 훨씬 작다. Lightning indexer의 복잡도는 여전히 시퀀스 길이의 제곱에 비례한다. 따라서 복잡도 감소는 핵심 attention 연산에 해당하며 전체 attention 파이프라인의 복잡도가 같은 수준으로 줄어드는 것은 아니다.
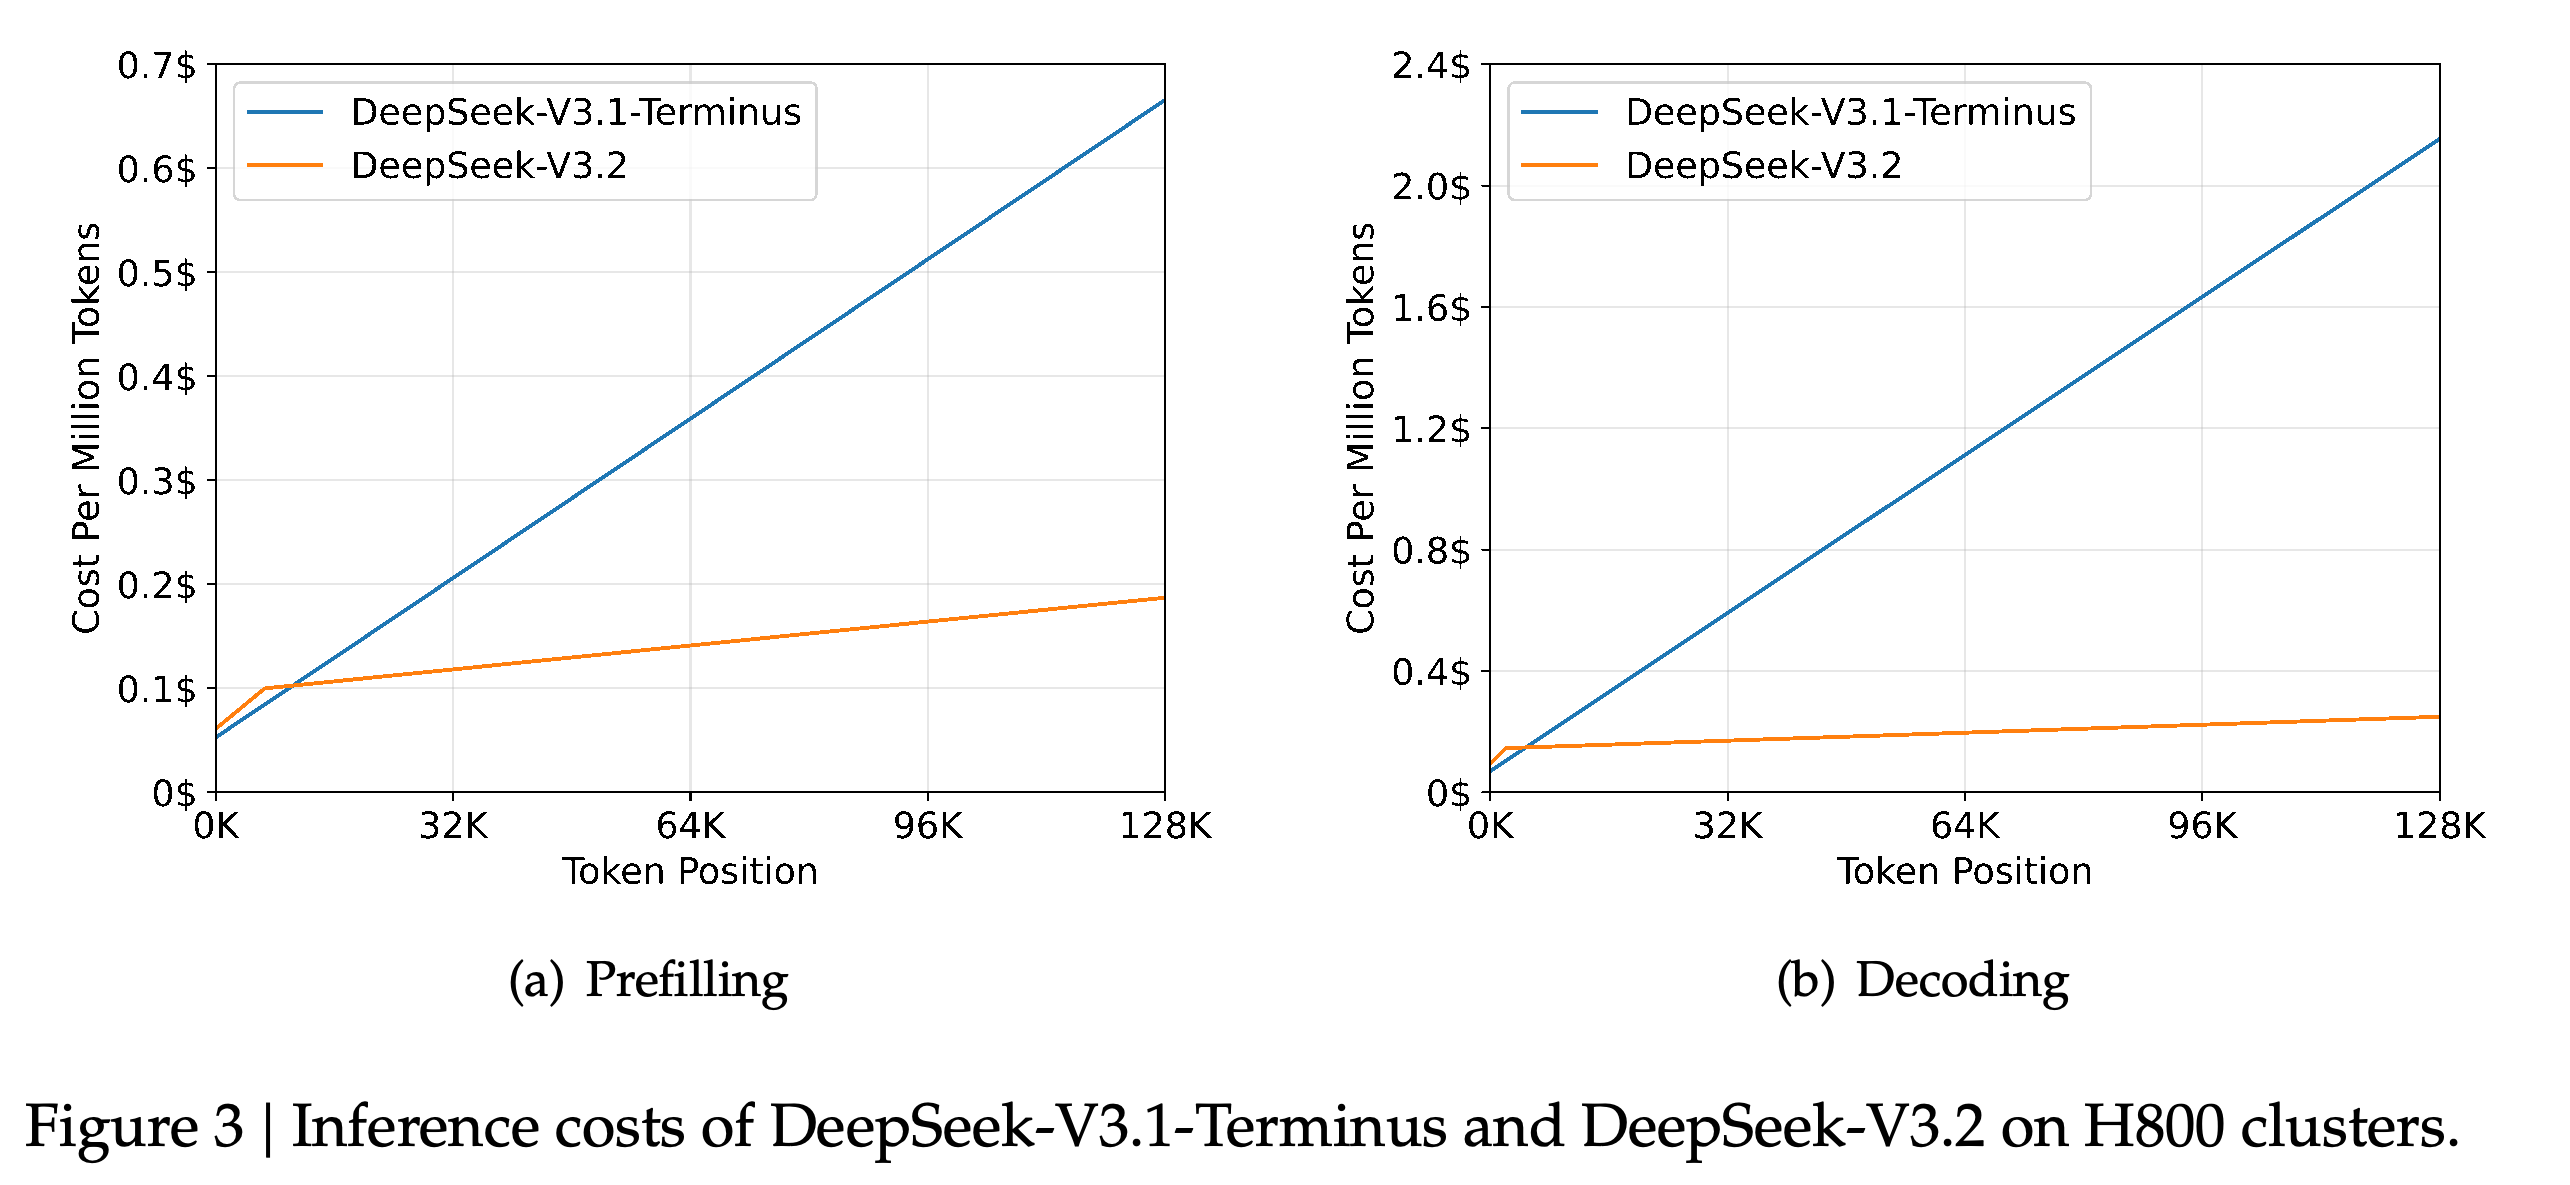
- Figure 3은 추론용 그래픽 프로세서인 H800 GPU에 배포한 서비스에서 million tokens당 비용을 추정한다. GPU 임대료는 GPU hour당 2 USD로 가정한다. 토큰 위치가 뒤로 갈수록 비용 절감 효과가 커지며, 새 토큰을 생성하는 decoding 단계에서 특히 두드러진다.
- 입력 프롬프트를 처리하는 prefilling 단계에서 시퀀스가 짧을 때는 masked MHA, 즉 마스크를 적용한 multi-head attention으로 DSA를 효율적으로 모사한다.
양쪽 패널 모두 토큰 위치가 뒤로 갈수록 비용 격차가 커짐을 보여준다. DeepSeek-V3.2의 decoding 비용은 DeepSeek-V3.1-Terminus보다 훨씬 완만하게 증가한다. 이는 명시된 임대료 가정 아래에서 벤치마크에 사용한 H800 서비스의 긴 문맥 효율성 주장을 뒷받침한다.
3. Post-Training
후속 학습은 sparse attention을 유지하면서 specialist distillation과 mixed RL을 결합한다. Specialist distillation은 분야별 모델이 생성한 응답으로 공통 모델을 학습하는 방식이다. Specialist는 수학, 프로그래밍, 논리 추론, 일반 에이전트 과제, 에이전트 코딩, 에이전트 검색을 담당하며 글쓰기와 일반 질의응답도 함께 다룬다.
- 각 specialist는 확장된 추론 과정을 출력하는 thinking mode와 직접 응답하는 non-thinking mode를 지원한다. 저자들은 이후 RL로 증류 모델과 specialist 사이에 남은 성능 격차를 해소한다고 보고하지만 여기에서는 수치 비교를 제시하지 않는다.
- Mixed training은 추론, 에이전트 과제, 사람의 선호도에 맞춰 응답을 학습하는 human alignment를 1개 RL 단계로 결합한다. 추론 및 에이전트 보상에는 규칙 기반 결과 보상, 길이 패널티, 언어 일관성 보상을 포함한다. 일반 과제에서는 프롬프트별 평가 기준에 따라 응답에 점수를 매기는 생성형 보상 모델을 사용한다.
- DeepSeek-V3.2-Speciale는 길이 패널티를 줄이고 추론 데이터만으로 학습한다. 수학 증명에는 DeepSeekMath-V2의 데이터셋과 보상 방식을 도입한다.
3.1. Scaling GRPO
Group Relative Policy Optimization (GRPO)은 같은 질문에 대해 생성한 다른 응답들과 비교해 응답을 평가하는 RL 알고리즘이다. 응답 보상에서 그룹 평균을 뺀 값을 advantage로 사용하며 이 신호는 해당 응답의 확률을 높일지 낮출지를 결정한다. 논문은 학습 응답을 생성하는 정책과 갱신 대상 정책의 차이에서 발생하는 불안정성을 줄이기 위해 4개 조치를 추가한다.
- Unbiased KL Estimate는 KL divergence를 표본으로 근사하는 K3 divergence 추정량에 현재 정책 확률을 이전 정책 확률로 나눈 비율을 곱한다. 저자들은 이 방식이 기울기를 보정하고 현재 모델에서 특정 토큰의 확률이 참조 모델보다 훨씬 낮을 때 지나치게 큰 갱신을 방지한다고 설명한다.
- Off-Policy Sequence Masking은 advantage가 음수인 응답에서 이전 정책 확률을 현재 정책 확률로 나눈 비율의 로그 평균이 임계값 δ를 넘으면 해당 응답의 정책 손실 기여를 억제한다. 여기서 off-policy는 갱신 대상과 다른 정책으로 응답을 생성했다는 뜻이다. 이전 정책의 확률은 추론 프레임워크가 직접 반환한 값을 사용한다.
- Keep Routing은 입력마다 expert 모듈 일부를 활성화하는 Mixture-of-Experts 모델에서 생성 시 사용한 expert 경로를 학습에서도 유지한다. Keep Sampling Mask는 누적 확률로 후보 토큰을 제한하는 top-p sampling이나 순위로 제한하는 top-k sampling의 truncation mask를 유지해, 생성과 학습에서 같은 후보 토큰 공간을 사용하게 한다.
- 저자들은 안정성과 언어 일관성이 개선되었다고 보고하지만 이 절에서는 각 조치의 개별 기여를 수치로 제시하지 않는다. 수학에서는 참조 모델에서 벗어나는 정도에 패널티를 부과하는 KL regularization을 약하게 적용하거나 적용하지 않는 편이 유리할 수 있다.
3.2. Thinking in Tool-Use
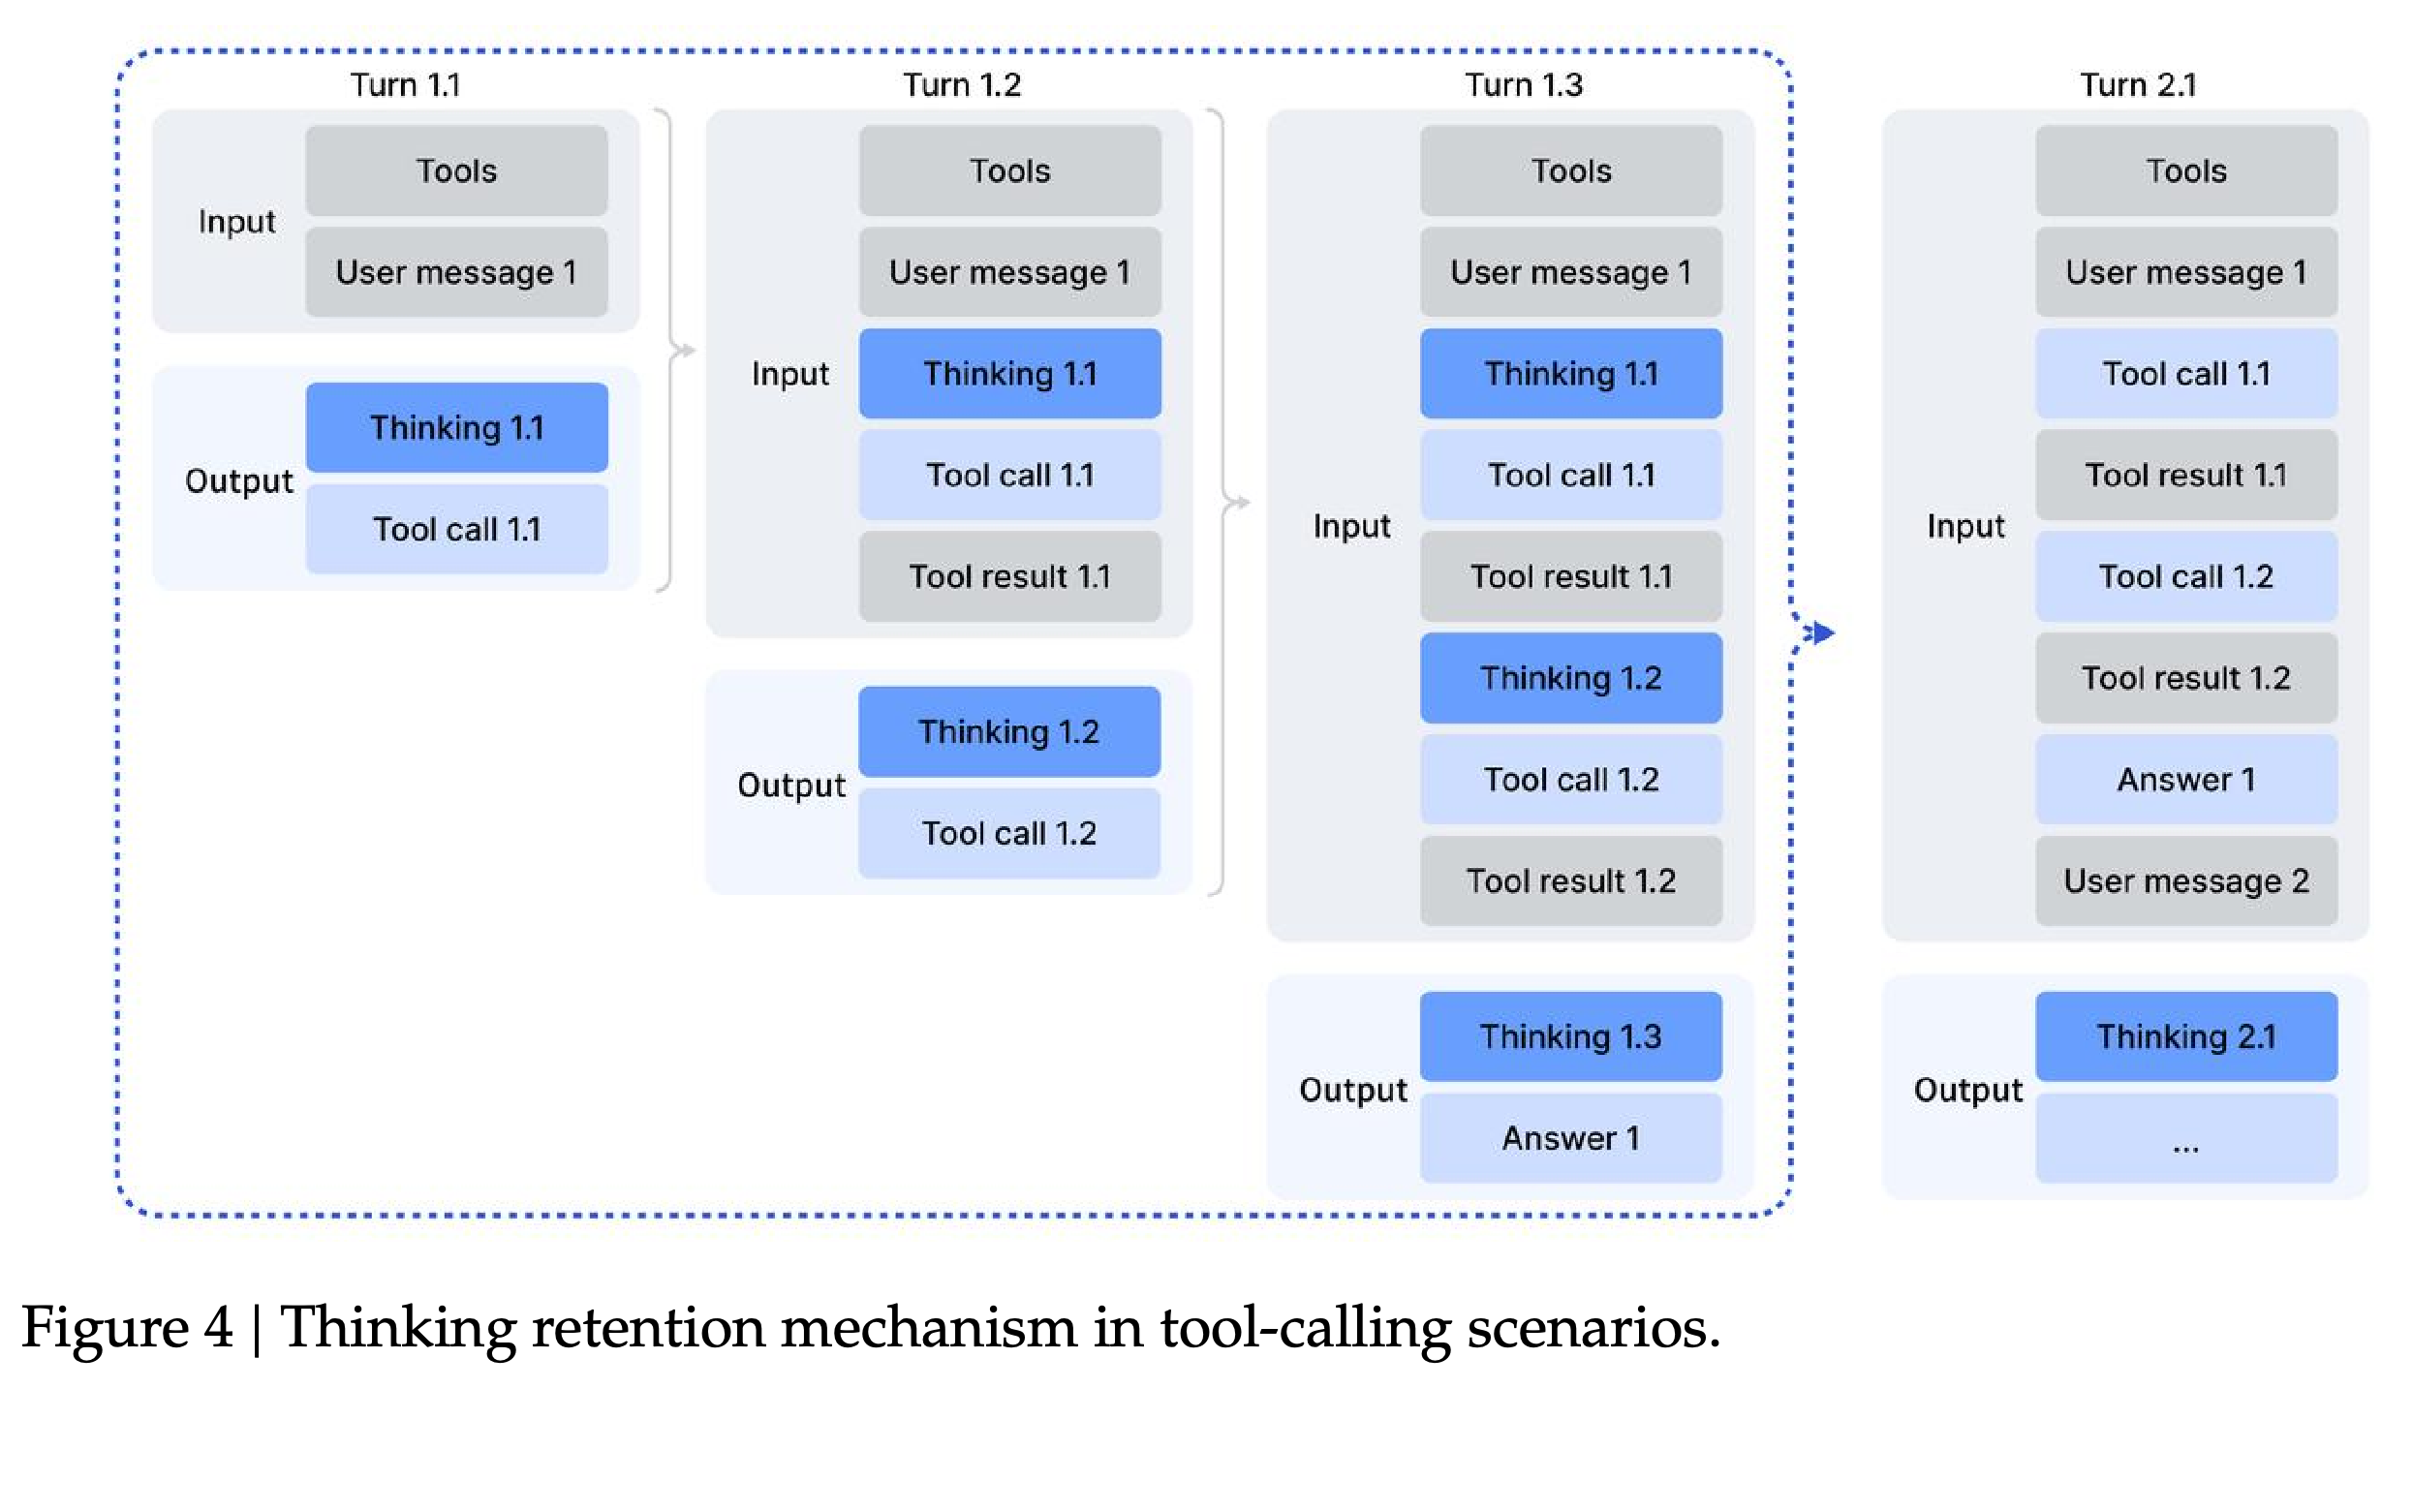
3.2.1. Thinking Context Management는 사용자 턴 안에서 도구 호출과 도구 결과에 걸쳐 추론을 유지하다가, 새 사용자 메시지가 도착하면 이전 추론을 제거한다. 추론을 제거한 뒤에도 도구 호출과 결과는 대화에 남는다. 이 방식은 같은 문제를 반복해서 추론하는 일을 줄이기 위한 것이다.
- Roo Code와 Terminus는 도구 상호작용을 사용자 메시지로 표현할 수 있으며 이 경우 추론이 제거된다. 논문은 이런 프레임워크에 non-thinking mode를 권장한다.
- 3.2.2. Cold-Start는 이후 RL에 앞서 초기 학습 예시를 구성하는 단계다. 설계한 프롬프트로 기존 추론 데이터와 추론이 없는 에이전트 데이터를 결합한다. 모델은 추론, 도구 호출, 결과로 이루어진 원하는 수행 과정을 간헐적으로 생성한다. 안정적으로 생성하지는 못하지만 이 과정이 RL의 초기 기반을 제공한다.
1개 사용자 턴 안에서 연속으로 도구를 호출하면 앞선 추론을 유지한다. 새 사용자 메시지는 이전 호출, 결과, 답변을 유지하면서 추론 과정만 제거한다. 이 때문에 도구 결과를 사용자 메시지로 표현하는 프레임워크에서는 추론이 지속되지 않는다.
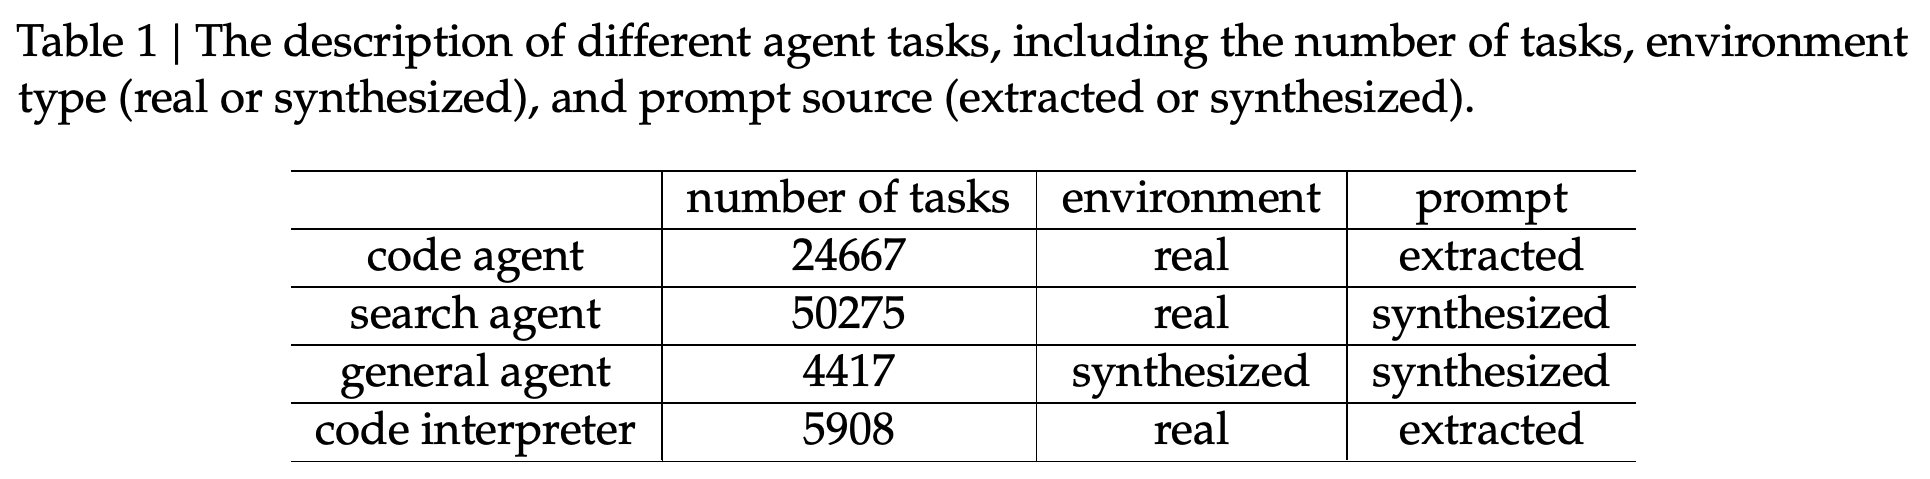
3.2.3. Large-Scale Agentic Tasks는 code agent, search agent, general agent, code interpreter agent를 결합한다. Table 1은 실제 도구 환경과 합성 환경, 추출한 프롬프트와 합성한 프롬프트를 구분한다. 이 프롬프트들은 실제 사용자 상호작용에서 가져온 것이 아니다.
- Search Agent는 드물게 등장하는 개체를 중심으로 질문을 구성하고 서로 다른 모델 설정으로 후보 답변을 생성한 뒤 검색으로 검증한다. 참조 답변은 맞고 생성한 후보는 모두 틀린 검증 가능한 질문을 유지하며 평가 기준으로 점수를 매긴 유용성 중심 예시도 추가한다.
- Code Agent는 보고된 소프트웨어 문제와 제안된 코드 변경을 연결하는 GitHub issue–Pull Request 쌍을 수집하고 자동 환경 설정 에이전트로 실행 가능한 환경을 구축한다. 참조 패치는 기존에 실패하던 테스트를 통과시키고, 통과하던 테스트가 실패하는 회귀를 0건으로 유지해야 한다. 테스트 결과는 일관되게 파싱할 수 있도록 JUnit 형식을 사용한다.
- Code Interpreter Agent는 실행 가능한 노트북 환경인 Jupyter Notebook으로 수학, 논리, 데이터 과학 문제를 다룬다. 학습 과제 수는 code agent 24667개, search agent 50275개, general agent 4417개, code interpreter 5908개다.
나열된 과제 대부분은 검색과 코드 과제다. General agent 행만 합성 환경과 합성 프롬프트를 결합한다. 이 점에서 해당 과제 4417개는 실제 도구를 기반으로 구축한 과제 모음과 구별된다.
General Agent는 데이터베이스, 함수 기반 도구, 과제, 참조 해답, 검증 함수를 합성한 뒤, 과제 난도를 반복적으로 높이고 필요하면 도구를 확장한다. 해답은 데이터베이스에 직접 접근하지 않고 도구 인터페이스를 통해 동작해야 한다. 100번의 시도 중 적어도 1번 성공한다는 뜻인 pass@100이 0이 아닌 과제를 유지해 환경 1,827개와 과제 4,417개를 얻는다.
- 쪽 번호가 12인 여행 계획 예시는 Hangzhou에서 출발해 2025 October 1st부터 October 3rd까지 3일간의 일정을 요구한다. 도시, 호텔, 관광 명소, 식당을 반복할 수 없으며 추천 장소는 해당 날짜에 머무는 도시에 있어야 한다.
- 2일차 조건은 호텔 가격을 식사 비용, 식당 평점, 관광 명소 가격과 연계한다. 호텔 가격이 800 CNY 이상이면 식당 지출은 350 CNY 미만, 식당 평점은 모두 4.0 이상, 명소 입장료는 120 CNY 미만이어야 한다. 명시된 500–800 CNY 구간에서는 적어도 1개 식당의 평점이 4.0 이상이고 입장료가 180 CNY 미만이어야 한다. 200–500 CNY 구간에서는 적어도 1개 식당의 평점이 3.2 이상이어야 한다. CNY는 예시에 사용한 통화이며 원문에서 구간 경계는 서로 겹친다.
- 이 예시는 모든 제약을 충족하는 해답을 찾기는 어렵지만 제출된 해답을 검증하기는 상대적으로 쉽다는 설계 기준을 보여준다.
4. Evaluation
평가는 지식과 추론, 수학, 프로그래밍, 소프트웨어 이슈 해결, 검색, 도구 사용을 다룬다. 이후 절에서는 벤치마크 성능, Speciale의 정확도와 필요한 출력 토큰 수, 합성 과제의 학습 전이, 추론 시점의 문맥 관리를 살펴본다.
4.1. Main Results
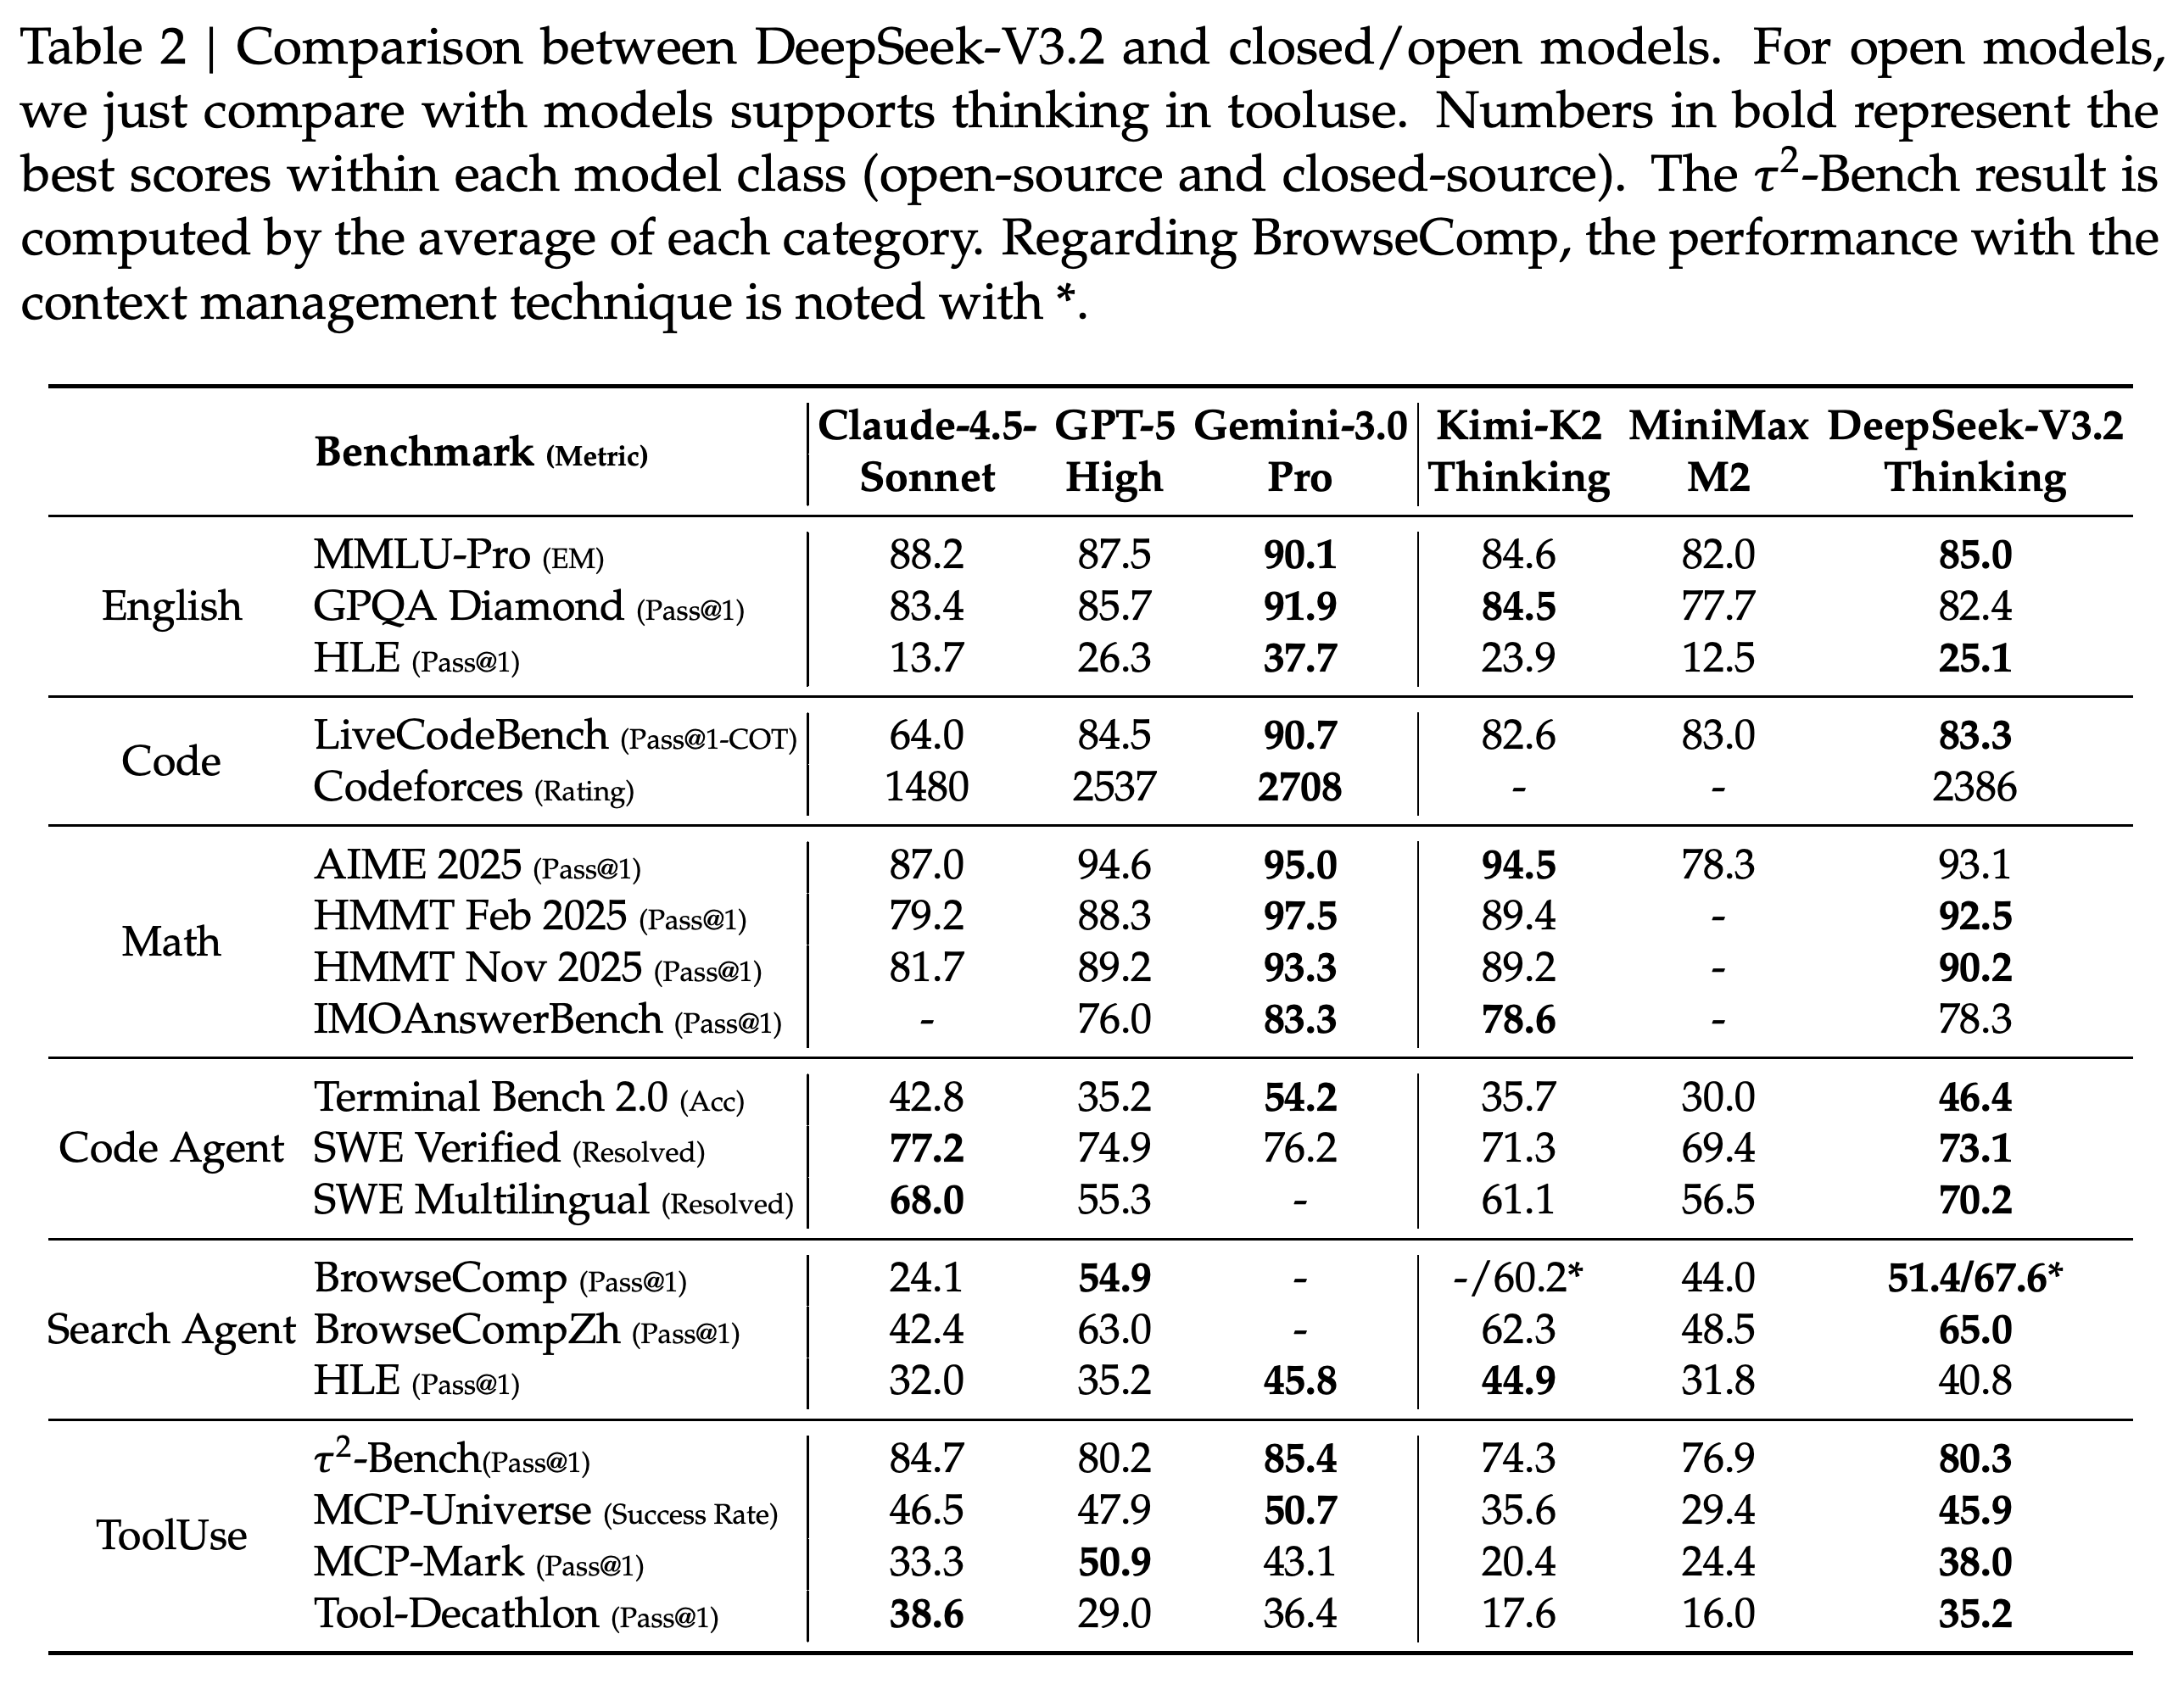
주요 평가는 샘플링의 무작위성을 조절하는 temperature를 1.0으로 설정하고 128K-token context window를 사용한다. 도구 사용 벤치마크에는 thinking mode와 표준 함수 호출을 적용한다. DeepSeek-V3.2는 수학 경시대회 벤치마크인 AIME 2025에서 93.1을 기록하며 GPT-5-High는 94.6을 기록한다. 또 다른 수학 경시대회 벤치마크인 HMMT Feb 2025에서는 각각 92.5와 88.3을 기록한다.
- 논문의 평가 절에서 Human Last Exam으로 명명한 텍스트 전용 벤치마크 HLE에서는 저자들의 단계별 추론 및 boxed-answer 템플릿으로 25.1을 기록하지만 공식 템플릿에서는 23.9를 기록한다. Table 2는 대학원 수준의 질의응답 벤치마크인 GPQA Diamond에서 82.4도 보고하며 이는 Gemini-3.0-Pro의 91.9보다 낮다.
- 소프트웨어 이슈 해결 벤치마크인 SWE Verified에서 DeepSeek-V3.2는 73.1%를 해결한다. Kimi-K2 Thinking은 71.3%, Claude-4.5-Sonnet은 77.2%를 해결한다. 주요 점수는 저자들의 내부 프레임워크를 사용하며 다른 프레임워크 및 non-thinking mode를 사용한 견고성 평가 점수는 72에서 74 사이에 분포한다.
- 터미널 기반 과제 평가인 Terminal Bench 2.0에서는 Claude Code를 thinking mode로 사용해 46.4를 기록한다. Terminus를 non-thinking mode로 사용하면 39.3을 기록한다. 이 비교에서는 실행 프레임워크와 응답 모드가 모두 달라진다.
- 브라우징 에이전트 벤치마크인 BrowseComp는 문맥 관리를 적용하면 51.4에서 67.6으로 개선된다. 저자들은 개입하지 않을 경우 검색 테스트 사례의 약 20%+가 128K tokens를 넘는다고 보고한다.
- 도구 사용 점수는 대화형 에이전트 벤치마크인 τ²-Bench에서 80.3, MCP-Universe에서 45.9, MCP-Mark에서 38.0, 다양한 장기 도구 과제를 평가하는 Tool-Decathlon에서 35.2다. MCP 벤치마크는 Model Context Protocol 도구 환경에서 에이전트를 평가한다. 모든 모델은 저자들의 내부 환경에서 테스트하며 검색 및 Playwright 브라우저 자동화 설정은 공식 설정과 다를 수 있다.
- 평가에 사용한 도구와 환경은 RL 학습에서 접하지 않았다. 도구 출력에는 tool 메시지 역할을 사용해 추론을 유지하지만 불필요한 자기 검증 때문에 수행 과정이 문맥 한도를 넘을 수 있다. 특히 MCP-Mark의 GitHub 및 Playwright 과제에서 이런 문제가 발생한다.
DeepSeek-V3.2는 여러 에이전트 벤치마크에서 나열된 공개 비교 모델을 앞서지만 독점 모델은 지식 및 일부 도구 사용 평가에서 우위를 유지한다. BrowseComp의 51.4/67.6은 문맥 관리 미적용 및 적용 결과를 구분한다. 공개 모델 비교는 도구 사용 중 thinking을 지원하는 모델로 제한한다.
4.2. Results of DeepSeek-V3.2-Speciale
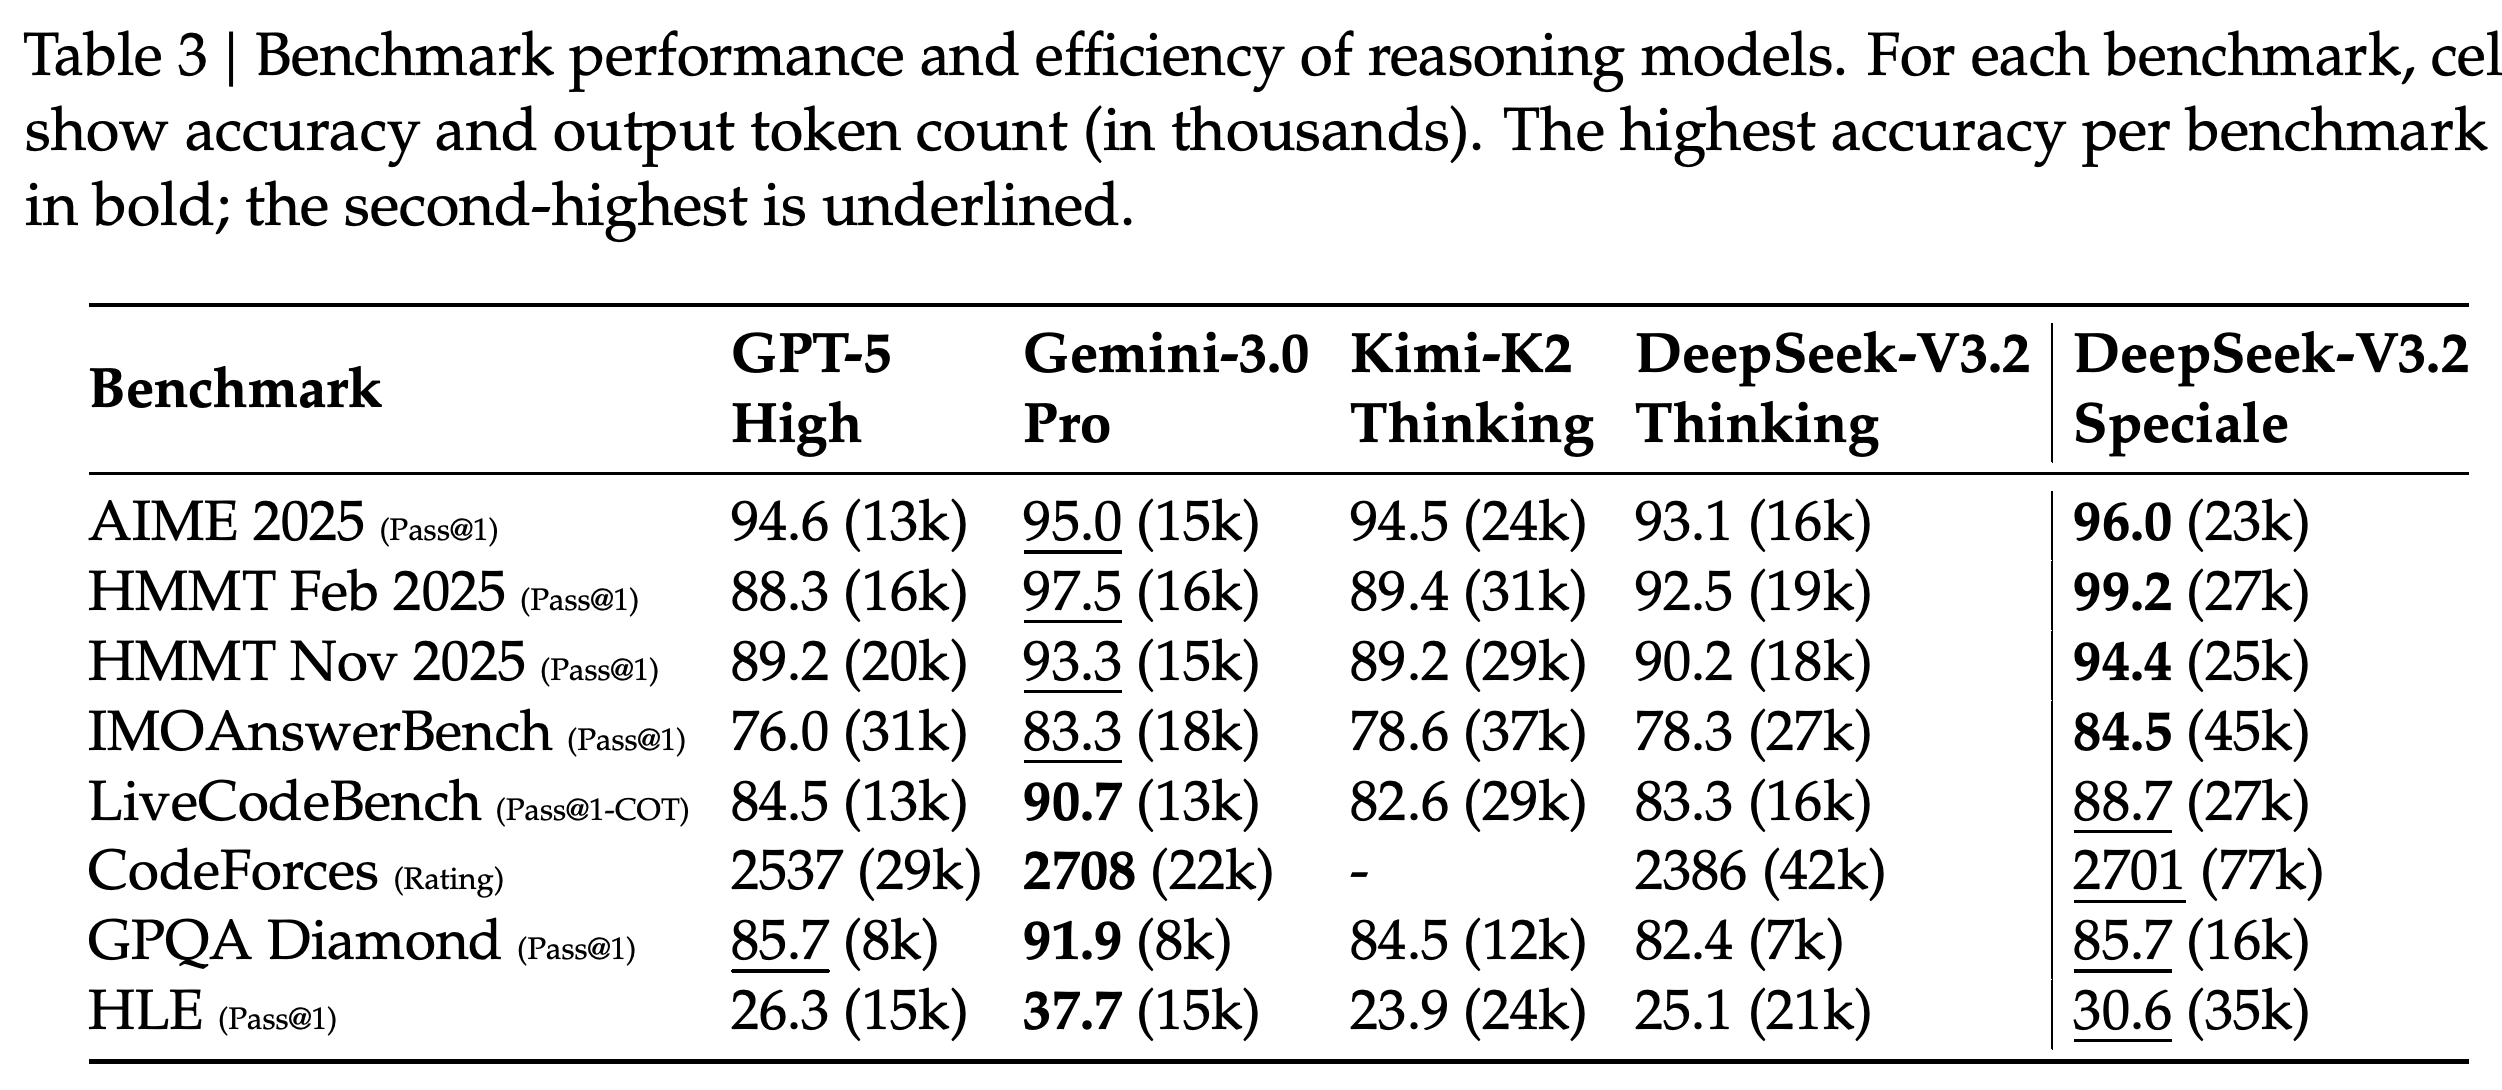
DeepSeek-V3.2-Speciale는 더 긴 출력으로 여러 추론 점수를 높인다. Table 3에서 AIME 2025는 출력 토큰 23k로 96.0을 기록하며 Gemini-3.0-Pro는 15k로 95.0을 기록한다. HMMT Feb 2025에서는 27k로 99.2를 기록하며 비교 모델은 16k로 97.5를 기록한다. 우위는 벤치마크에 따라 달라진다. HLE에서는 30.6으로 Gemini-3.0-Pro의 37.7보다 낮고, 프로그래밍 대회 평점인 CodeForces에서는 2701로 비교 모델의 2708보다 낮다.
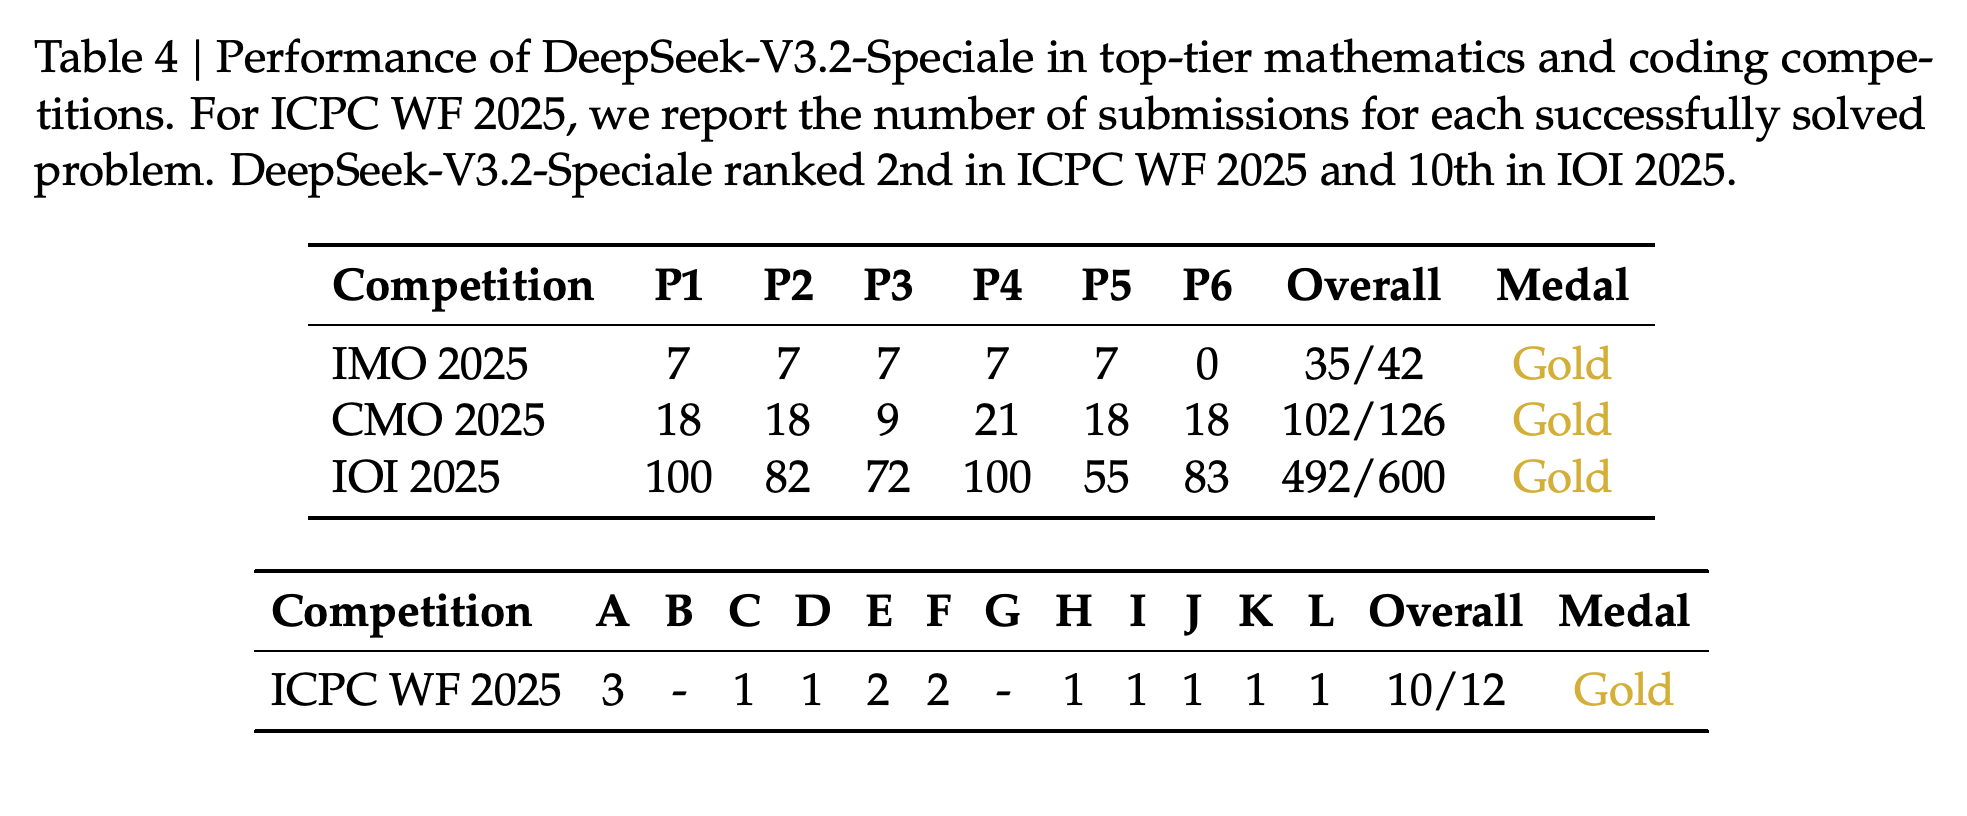
- Speciale는 International Mathematical Olympiad인 IMO 2025에서 35/42, China Mathematical Olympiad인 CMO 2025에서 102/126, International Olympiad in Informatics인 IOI 2025에서 492/600을 기록한다. ICPC World Finals 프로그래밍 대회인 ICPC WF 2025에서는 10/12 문제를 해결한다.
- 보고된 대회 순위는 IOI 2025에서 10th, ICPC WF 2025에서 2nd다. 이 결과는 단일 응답을 샘플링하는 벤치마크 방식 대신 Appendix D의 후보 선택 및 개선 절차를 사용한다.
- 수학 추론 벤치마크인 IMOAnswerBench에서 Speciale는 출력 토큰 45k를 사용하고 비교 모델은 18k를 사용한다. CodeForces에서는 각각 77k와 22k를 사용한다. 정식 DeepSeek-V3.2는 정확도, 지연 시간, 비용의 균형을 위해 더 엄격한 길이 제한을 적용한다.
- CMO 2025는 영어로 평가한다. 논문은 문제와 추론 코드를 https://github.com/deepseek-ai/DeepSeek-Math-V2 에서 참조하도록 안내한다.
점수와 출력 토큰 수를 함께 제시해 Speciale의 성능 향상에 필요한 추론량을 보여준다. HMMT Feb 2025에서는 Gemini-3.0-Pro보다 높은 점수를 얻지만 토큰을 27k 대 16k로 더 많이 사용한다. CodeForces에서는 토큰을 77k 대 22k로 더 많이 사용하면서 평점은 조금 낮다.
총점은 대회 4개 모두에서 논문이 보고한 금메달 기준을 충족한다. 세부 결과에는 남은 실패도 드러난다. IMO 6번 문제는 0점을 받고, ICPC의 B와 G 문제는 해결하지 못한다. ICPC의 문제별 값은 해결한 문제의 제출 횟수다. 결과는 Appendix D의 선택 및 개선 절차에 영향을 받는다.
4.3. Synthesis Agentic Tasks
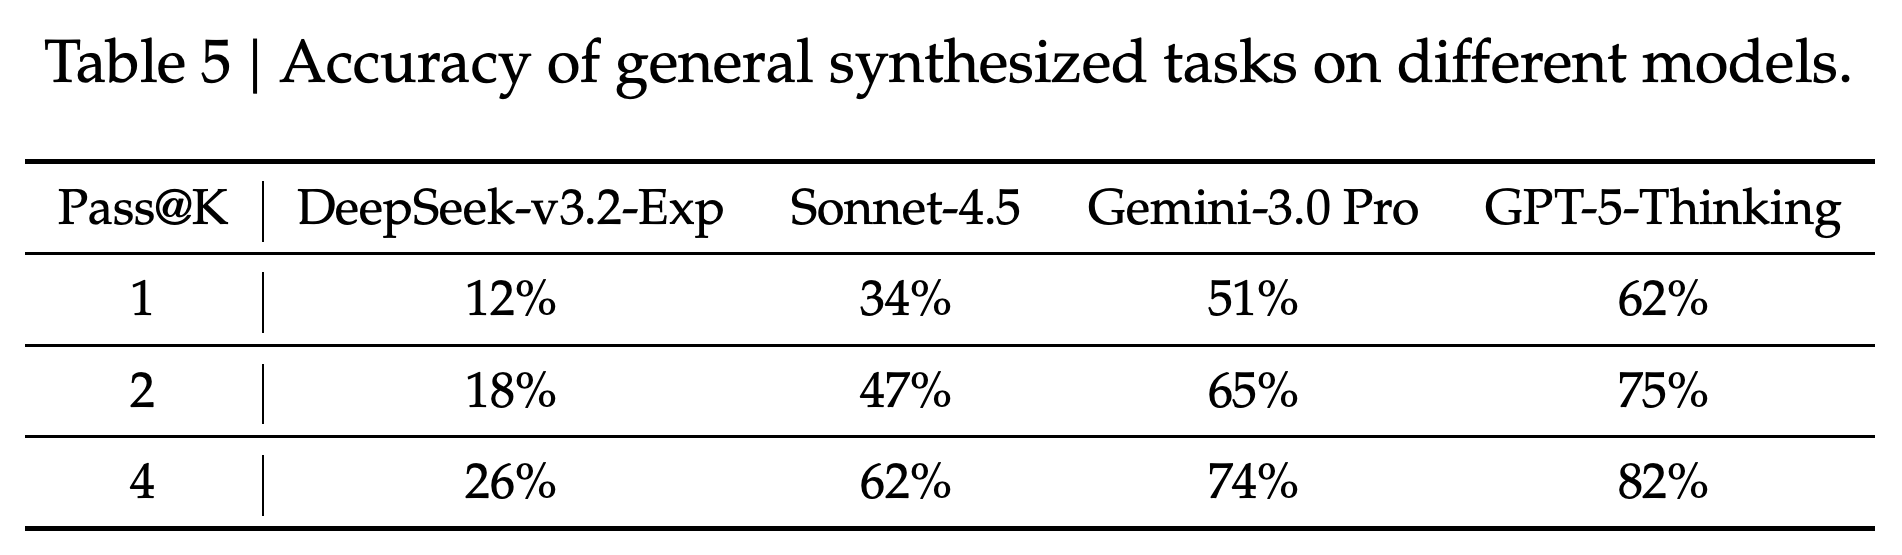
난도 확인을 위해 합성 일반 에이전트 과제 50개를 무작위로 추출하고 1번의 시도로 성공하는 비율인 pass@1을 보고한다. DeepSeek-V3.2-Exp는 12%, Sonnet-4.5는 34%, Gemini-3.0 Pro는 51%, GPT-5-Thinking은 62%를 기록한다. 추출한 과제는 모델 4개 모두에 어렵지만 표본이 작아 비교의 정밀도에는 한계가 있다.
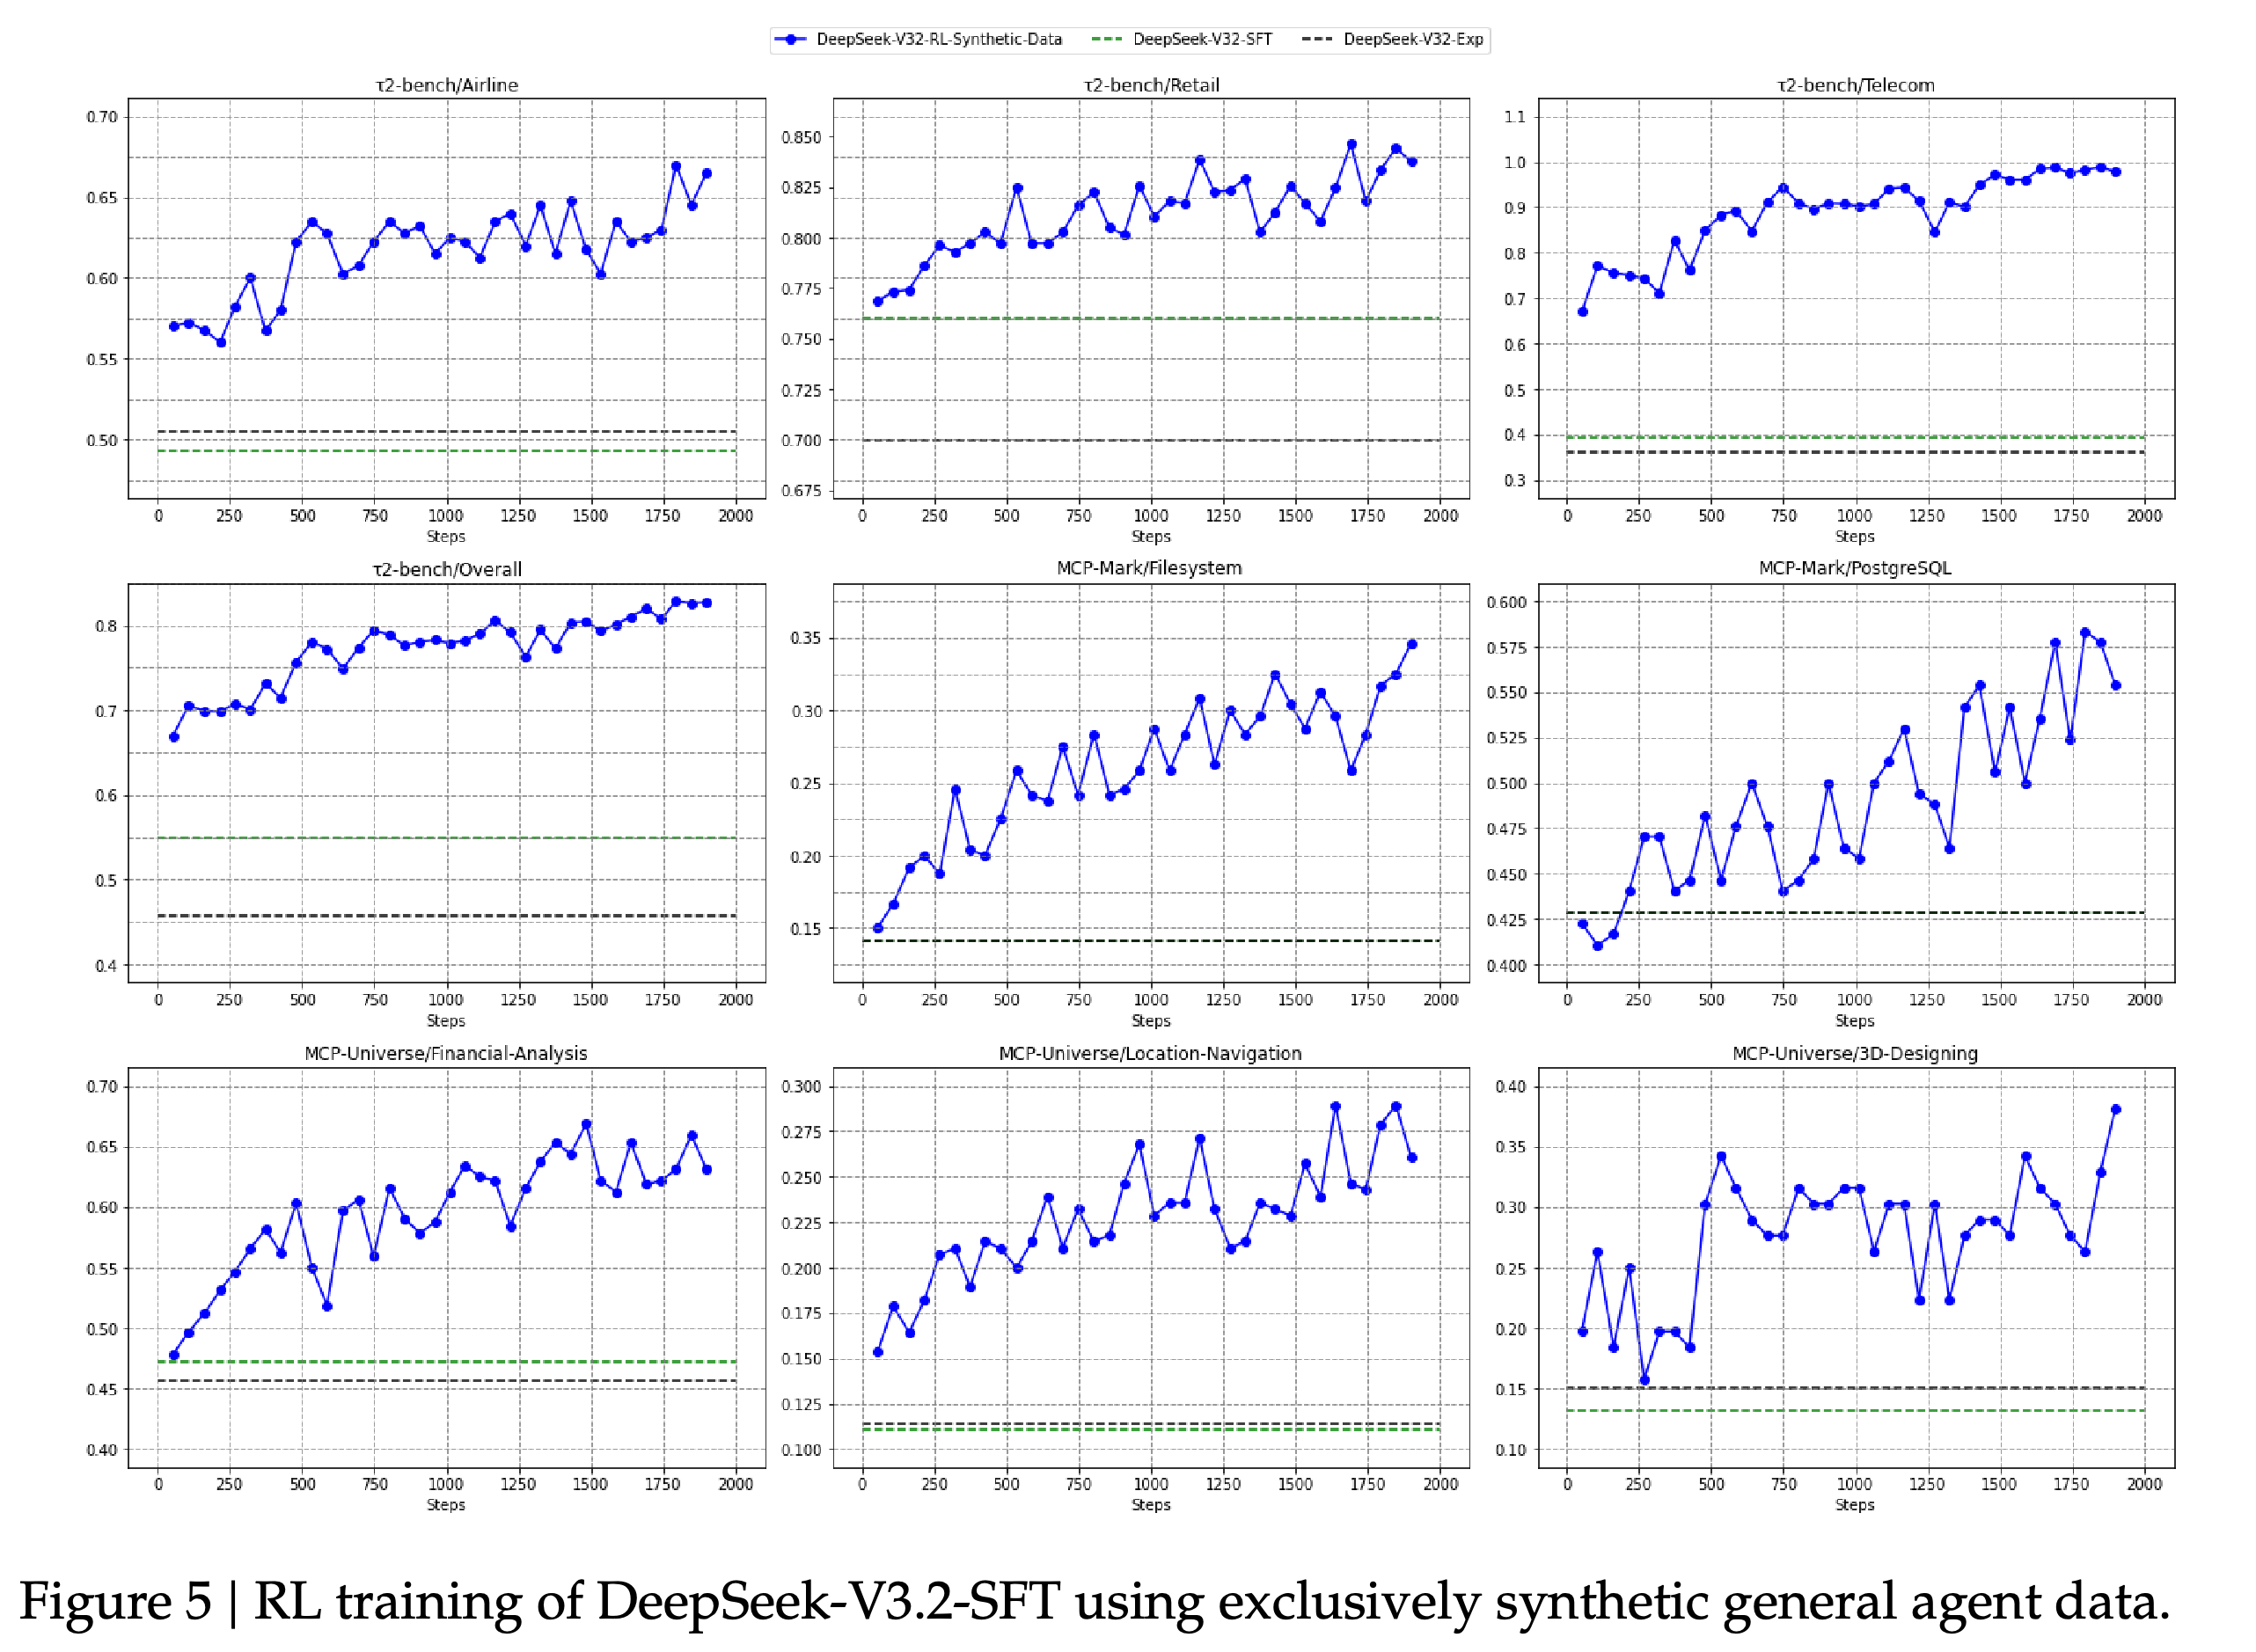
- 전이 실험은 지도 미세 조정 체크포인트인 DeepSeek-V3.2-SFT에서 시작해, non-thinking mode로 합성 일반 에이전트 과제에만 RL을 적용한다. 따라서 이 실험의 학습 개입에는 확장된 추론 과정과 다른 RL 데이터가 포함되지 않는다.
- Figure 5는 지도 학습 체크포인트와 비교해 τ²-bench 범주와 일부 MCP-Mark 및 MCP-Universe 과제에서 성능이 개선됨을 보여준다. 코드 및 검색 환경에서 RL을 수행한 DeepSeek-V3.2-Exp는 이 벤치마크들에서 비슷한 수준의 전이를 보이지 않는다.
- 이 실험은 합성 일반 에이전트 학습이 다른 도구 환경으로 전이되는지를 직접 검증한다. 그래프의 학습 곡선에는 불확실성 구간이 없다.
최대 2번 또는 4번의 시도로 성공하는 비율인 Pass@2와 pass@4는 모든 모델에서 증가한다. GPT-5-Thinking은 pass@1의 62%에서 pass@4의 82%로 상승하고 DeepSeek-v3.2-Exp는 12%에서 26%로 상승한다. 이는 표본으로 추출한 50개 과제가 여전히 어렵다는 점을 보여준다.
패널 9개에서 합성 일반 에이전트 데이터만 사용한 RL은 대체로 지도 학습 및 실험 모델 기준선보다 평가 성능을 높인다. 여러 도구 영역에서 개선이 나타나지만 개별 곡선은 변동하며 불확실성 구간은 제공하지 않는다.
4.4. Context Management of Search Agent
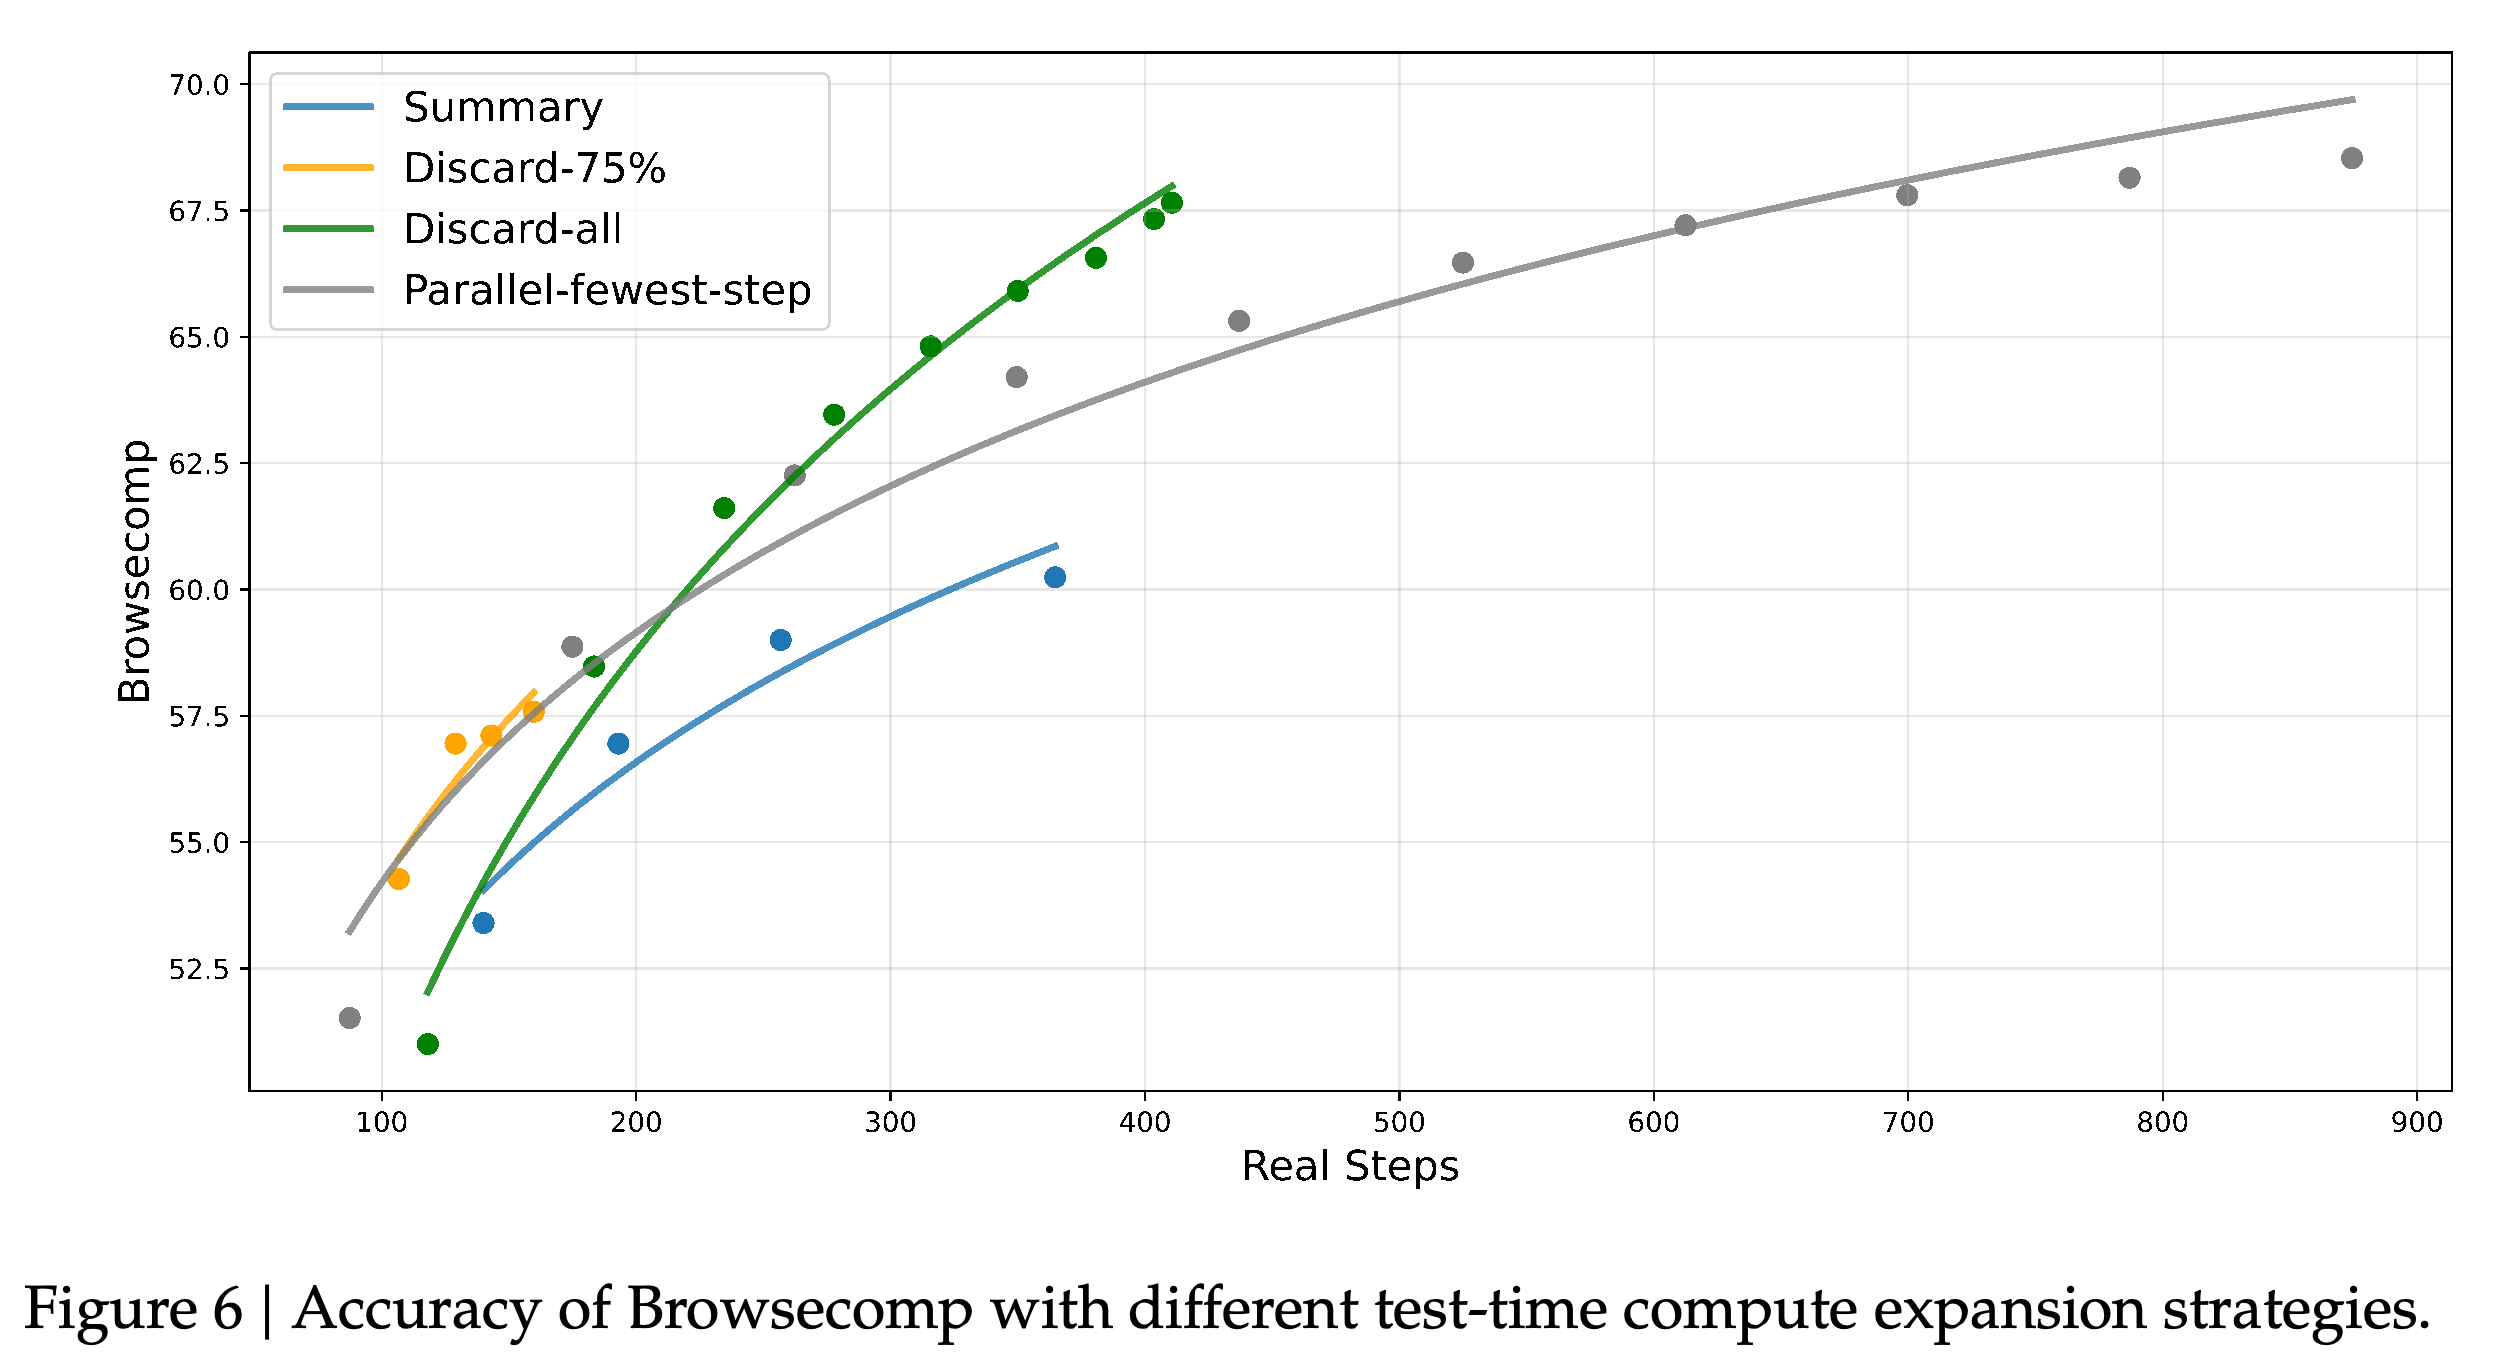
검색 에이전트의 문맥 관리는 토큰 사용량이 context window의 80%를 넘으면 작동한다. Summary는 수행 과정을 압축한 뒤 생성을 다시 시작한다. Discard-75%는 도구 호출 이력의 앞부분 75%를 제거하고 Discard-all은 이전 도구 호출 이력을 모두 제거한다. Parallel-fewest-step은 독립적인 수행 과정 N개를 생성한 뒤 step 수가 가장 적은 것을 선택한다.
- BrowseComp에서 Summary는 평균 364 steps로 60.2를 기록한다. Discard-all은 67.6을 기록하며 Figure 6에서 병렬 확장보다 훨씬 적은 실행 step으로 비슷한 정확도에 도달한다.
- 검색 점수는 모델 가중치뿐 아니라 추론 시점의 연산량과 문맥 정책에도 영향을 받는다. 그림은 실행 step을 비교 축으로 사용하며 동일한 토큰 사용량, 지연 시간, 금전적 비용을 직접 입증하지는 않는다.
정확도와 step 수의 관계를 나타낸 곡선은 문맥 관리와 병렬 샘플링 전략의 효율성이 서로 다름을 보여준다. Discard-all은 훨씬 적은 실행 step으로 병렬 샘플링과 비슷한 정확도에 도달하고 Summary는 더 낮은 점수를 기록한다. 그래프는 금전적 비용을 직접 측정하지 않는다.
5. Conclusion, Limitation, and Future Work
논문은 sparse attention, 확대된 RL 연산량, 합성 에이전트 과제를 결합해 공개 언어 모델의 측정된 효율성과 능력을 개선한다. 동시에 최상위 독점 모델과 비교해 세계 지식의 범위, 출력 토큰 효율, 복잡한 과제 성능에서 약점이 남아 있음을 인정한다.
- 저자들은 지식 격차의 원인을 더 적은 총 학습 FLOPs로 설명하고 사전 학습 확대를 제안한다. FLOPs는 연산량을 측정하는 부동소수점 연산 횟수다.
- 다른 제안 방향으로는 더 효율적인 추론 과정, 기반 모델 및 후속 학습 방식의 개선, 순차적 문맥 관리와 병렬 추론의 더 나은 결합이 있다. 이들은 향후 연구 방향으로 제안한 내용이다.
부록
- A. MHA and MQA Modes of MLA는 기존 latent attention의 multi-head 구현과 multi-query 구현 사이의 변환을 보여준다. DeepSeek-V3.1-Terminus는 학습과 prefilling에 MHA를 사용하고 decoding에 MQA를 사용한다. 이는 DSA가 공유 잠재 key-value 항목을 사용하는 아키텍처 배경을 설명한다.
- B. Cold Start Template은 동일한 연결 리스트 프로그래밍 과제에 대한 프롬프트 예시 3개를 제시한다. 각각 도구 없는 추론, 명시적 추론 없는 도구 사용, 추론 안에 포함한 도구 호출을 보여준다. Tables 6–8은 <think></think>, {TOOL-DESCRIPTIONS}, {TOOLCALL-FORMAT} 표식을 사용하며 결합 예시는 코드 실행을 최대 20회 허용한다.
- C. Non-thinking DeepSeek-V3.2 Agentic Evaluation은 Table 9에서 모드를 비교한다. Claude Code를 사용할 때 Terminal Bench 2.0은 non-thinking mode의 37.1에서 thinking mode의 46.4로 상승한다. SWE Verified는 72.1에서 73.1로, MCP-Mark는 26.5에서 38.0으로, Tool-Decathlon은 25.6에서 35.2로 상승한다.
- D. Evaluation Method of IOI, ICPC World Final, IMO, and CMO는 최대 생성 길이를 128k로 설정한다. 도구나 인터넷 접근 없이 생성하며 대회 시간과 시도 횟수 제한을 적용한다고 보고한다. IOI는 문제마다 후보 500개를 생성하고 예제 테스트나 길이 제약을 충족하지 못하거나 수행 불능 또는 거부를 표현한 후보를 제외한다. 이후 유효한 후보 중 추론 과정이 가장 긴 50개를 골라 제출한다. ICPC는 같은 필터링 기준으로 문제마다 후보 32개를 생성한다. IMO와 CMO는 자기 평가에서 만점을 얻거나 최대 수정 횟수에 도달할 때까지 생성, 검증, 개선을 반복한다.
- E. Author List는 기여자를 Research & Engineering, Data Annotation, Business & Compliance로 분류한다. 명단은 각 사람의 이름을 기준으로 알파벳순으로 정렬하며 별표는 팀을 떠난 사람을 표시한다.
짧은 생각
가장 명확한 근거는 엔지니어링 선택 2가지에 관한 것이다. Sparse attention은 보고된 동등 성능 평가에서 성능 저하 없이 긴 문맥 서비스의 측정 비용을 낮춘다. 또한 합성 데이터만 사용한 RL 실험은 다른 도구 환경으로의 전이를 입증한다. 최종 모델의 향상을 확대된 RL 연산량만의 효과로 분리해 설명할 근거는 상대적으로 부족하다. Specialist distillation, 보상, 데이터, 학습 안정화 조치도 학습 파이프라인에 기여하기 때문이다. 배포 비교에서는 정확도와 함께 출력 토큰 수, 실행 프레임워크, 문맥 정책, 후보 생성 절차를 보고해야 한다. Tables 3–4와 Figure 6은 추가 추론 작업이 보고된 결과에 어떤 영향을 미치는지 보여준다. Figure 1에서 DeepSeek-V3.2-Thinking의 HMMT 값은 90.2지만, 캡션은 2월 대회를 명시한다. Tables 2–3은 2월 점수를 92.5, 11월 점수를 90.2로 보고한다. 상세 표에서는 대회를 구분하지만 그림의 불일치는 해결되지 않았다. 논문은 구현 및 대회 평가 절차를 제공하지만 GRPO 안정화 조치 4개의 효과를 모두 분리한 정량적 ablation이나 합성 과제 전이 곡선의 불확실성 추정치는 제공하지 않는다.