


2025년 1월 AI 논문 동향
31 Jan 2025 | Paper Review Monthly Papers Compute Allocation Long-Context Models Verification and Generalization목차
이달의 트렌드
2025년 1월의 주제는 추가 연산을 유용한 능력으로 전환하는 방법이며, 선정된 3편의 논문은 언어 모델의 입력 확장, 이미지 생성 중 검색, 보상 기반 학습을 통해 이를 살펴본다. MiniMax-01은 아키텍처와 실행 방식을 개선해 백만 토큰 규모의 입력을 처리한다. 토큰은 모델이 처리하는 텍스트 단위다. Diffusion 연구는 노이즈를 반복해서 제거하며 이미지를 만드는 생성 모델에서 샘플링에 사용하는 노이즈를 검색한다. 사후 학습 연구는 전문가 응답으로 학습하는 지도 미세조정(SFT)과 생성 응답에 대한 보상으로 학습하는 강화학습(RL)을 추정 학습 연산량이 같은 조건에서 비교한다. 1, 2, 3
이미지 검색과 보상 기반 사후 학습은 검증을 활용하지만, 검증의 역할은 서로 다르다. Verifier는 생성 결과에 점수를 매기는 모델이나 자동 검사기다. Diffusion 연구에서는 이미지 후보를 선택하고, RL 연구에서는 응답 수정에 필요한 보상과 텍스트 피드백을 제공한다. 유용성은 무엇을 측정하는지에 따라 달라진다. 이미지 검색은 분류기의 확신도를 높이면서 다양성을 줄일 수 있고, 이미지 평가기를 결합한 앙상블은 폭넓은 평가에서 성능을 높이지만 구성 정확도에서는 가장 높은 성능을 내지 못한다. RL 실험에서 순차 수정은 낯선 과제 조건으로의 전이 성능을 높이지만, 시작 체크포인트도 결과에 영향을 준다. 보고된 GeneralPoints 실험에서는 SFT 초기화 없이 직접 RL을 적용하면 실패한다. 극도로 과적합된 SFT 내비게이션 체크포인트에서 시작하면 RL은 학습에 없던 행동 규칙에 대한 성능을 회복하지 못한다.
결과는 중간 지표와 전체 과제 성능 사이의 차이도 드러낸다. MiniMax가 4M 토큰에서 삽입된 문장을 검색했다고 해서 같은 길이의 문서를 대상으로 복잡한 추론을 수행할 수 있음이 입증되지는 않는다. 이미지 verifier 점수가 높아져도 다양성이나 다른 품질 지표는 나빠질 수 있다. 개별 내비게이션 행동의 정확도가 개선되어도 행동 규칙을 바꾸면 전체 경로 성공률은 약 1% 이하에 머문다. 이러한 결과는 최적화를 유도하는 지표와 함께 실제로 달성하려는 과제 결과를 평가해야 한다는 해석을 뒷받침한다.
2025년 1월의 주요 논문
1. MiniMax-01: Scaling Foundation Models with Lightning Attention
- https://arxiv.org/abs/2501.08313
- MiniMax-01: Scaling Foundation Models with Lightning Attention 요약 설명
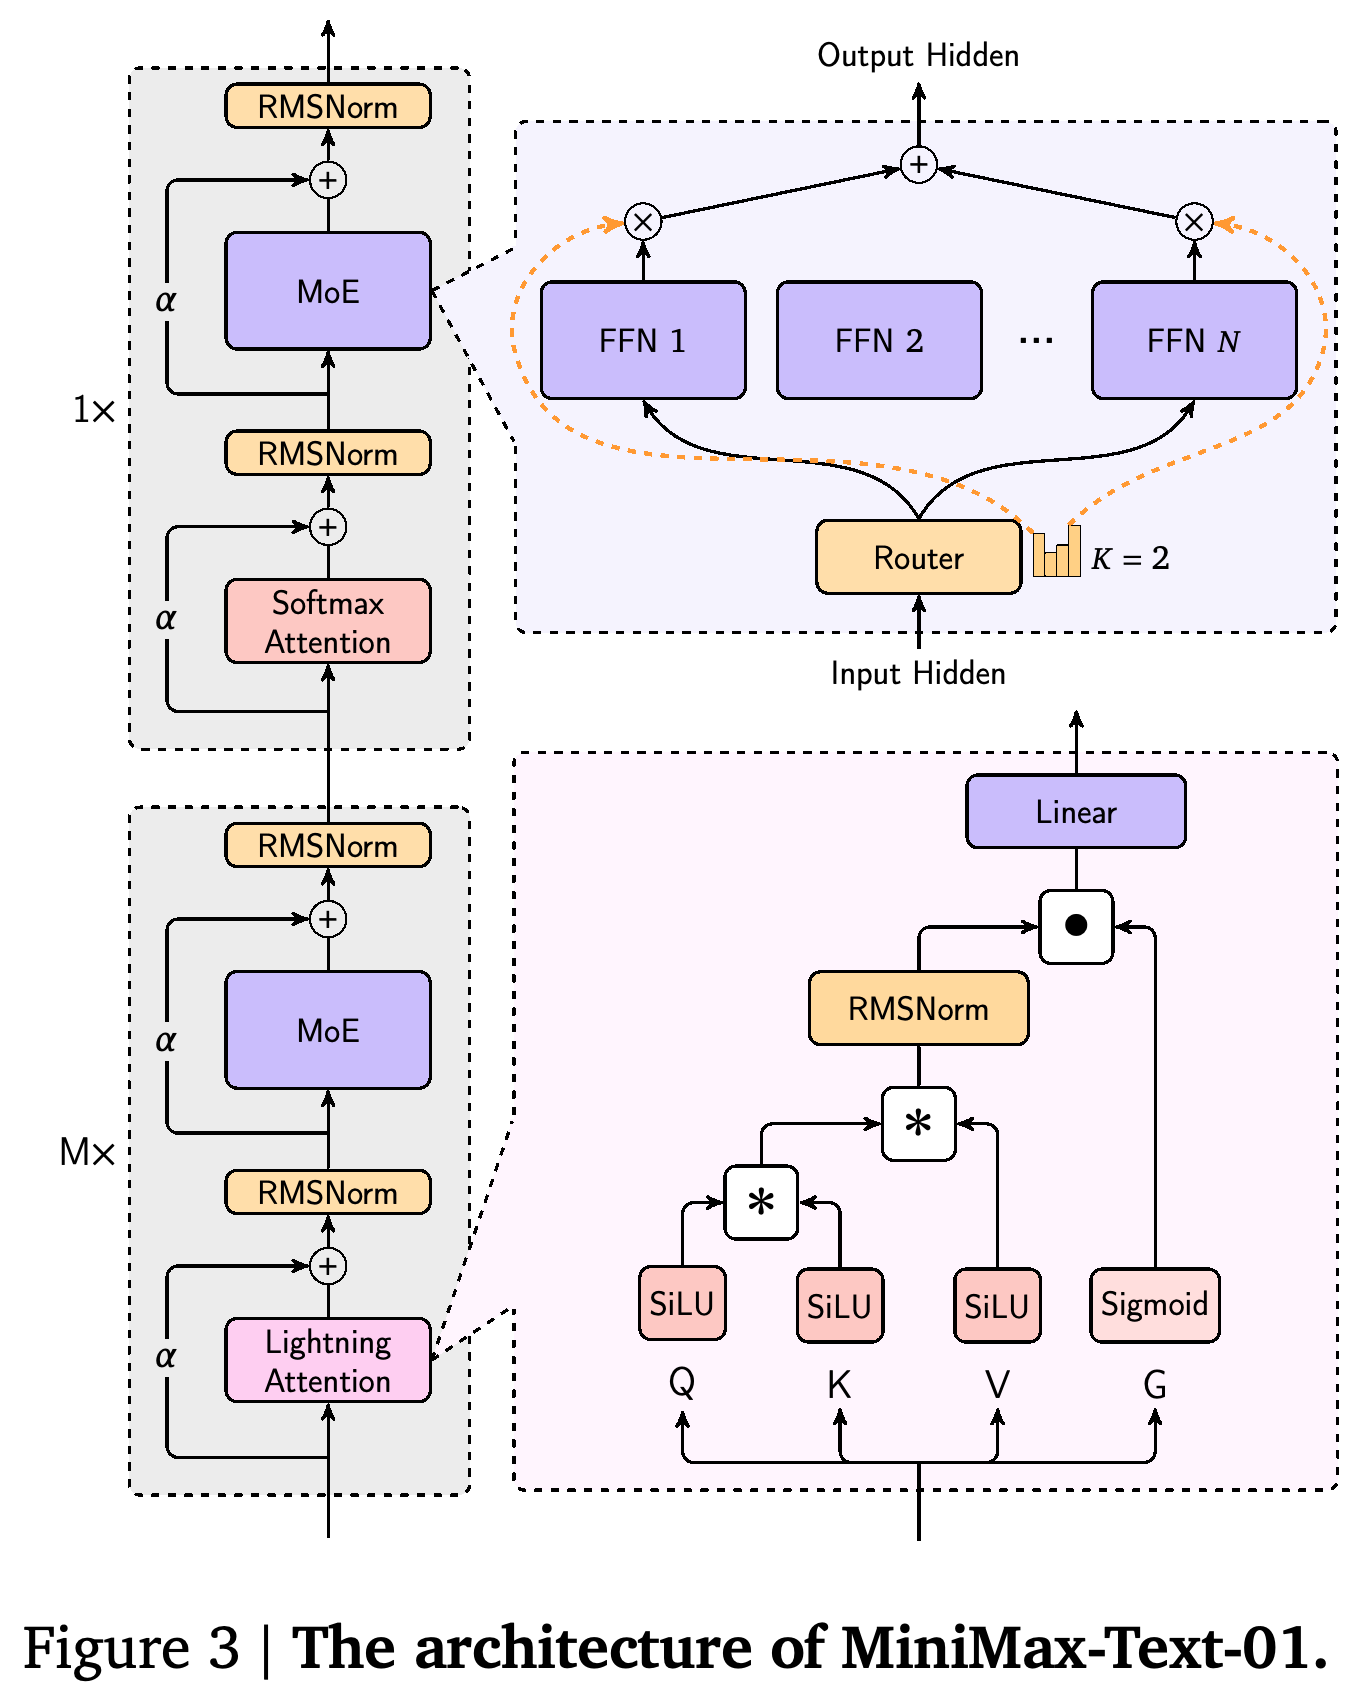
- MiniMax-01: Scaling Foundation Models with Lightning Attention은 lightning attention 계층 7개와 softmax attention 계층 1개를 묶어 반복 배치한다. Lightning attention은 타일 단위 연산과 앞선 입력의 누적 요약을 사용하고, softmax attention은 앞선 토큰에 대한 정규화된 가중치를 계산한다. 각 토큰을 선택된 피드포워드 네트워크로 보내는 Mixture of Experts(MoE)를 사용하며, 총 파라미터 456 billion개 중 토큰마다 45.9 billion개를 활성화한다.
- 주기적으로 배치한 softmax 계층은 순수 lightning attention에서 관찰된 검색 성능의 약점을 보완한다. Attention 비교 실험에서 Hybrid-lightning은 삽입한 정보를 검색하는 Needle in a Haystack 평가에서 파라미터 1B, 3B, 7B일 때 각각 95.7, 98.0, 97.7을 기록한다. 입력이 길어져도 처리량이 대체로 일정하다는 관찰은 실험 범위 내의 순수 lightning attention에 해당한다. Hybrid 구성은 softmax 계층을 유지하므로 입력이 길어지면 처리량이 감소한다.
- MiniMax-Text-01은 긴 문맥 과제 13개로 구성된 RULER에서 평균 정확도 0.910을 기록하며, Gemini-1.5-Pro (002)는 0.850을 기록한다. 두 모델 모두 입력 길이는 1M 토큰이다. 긴 문맥 질의응답 벤치마크인 LongBench v2에서는 추론 과정을 명시적으로 생성하는 chain-of-thought를 사용할 때 56.5를 기록하며, 같은 평가 방식에서 GPT-4o (11-20)는 51.4를 기록한다.
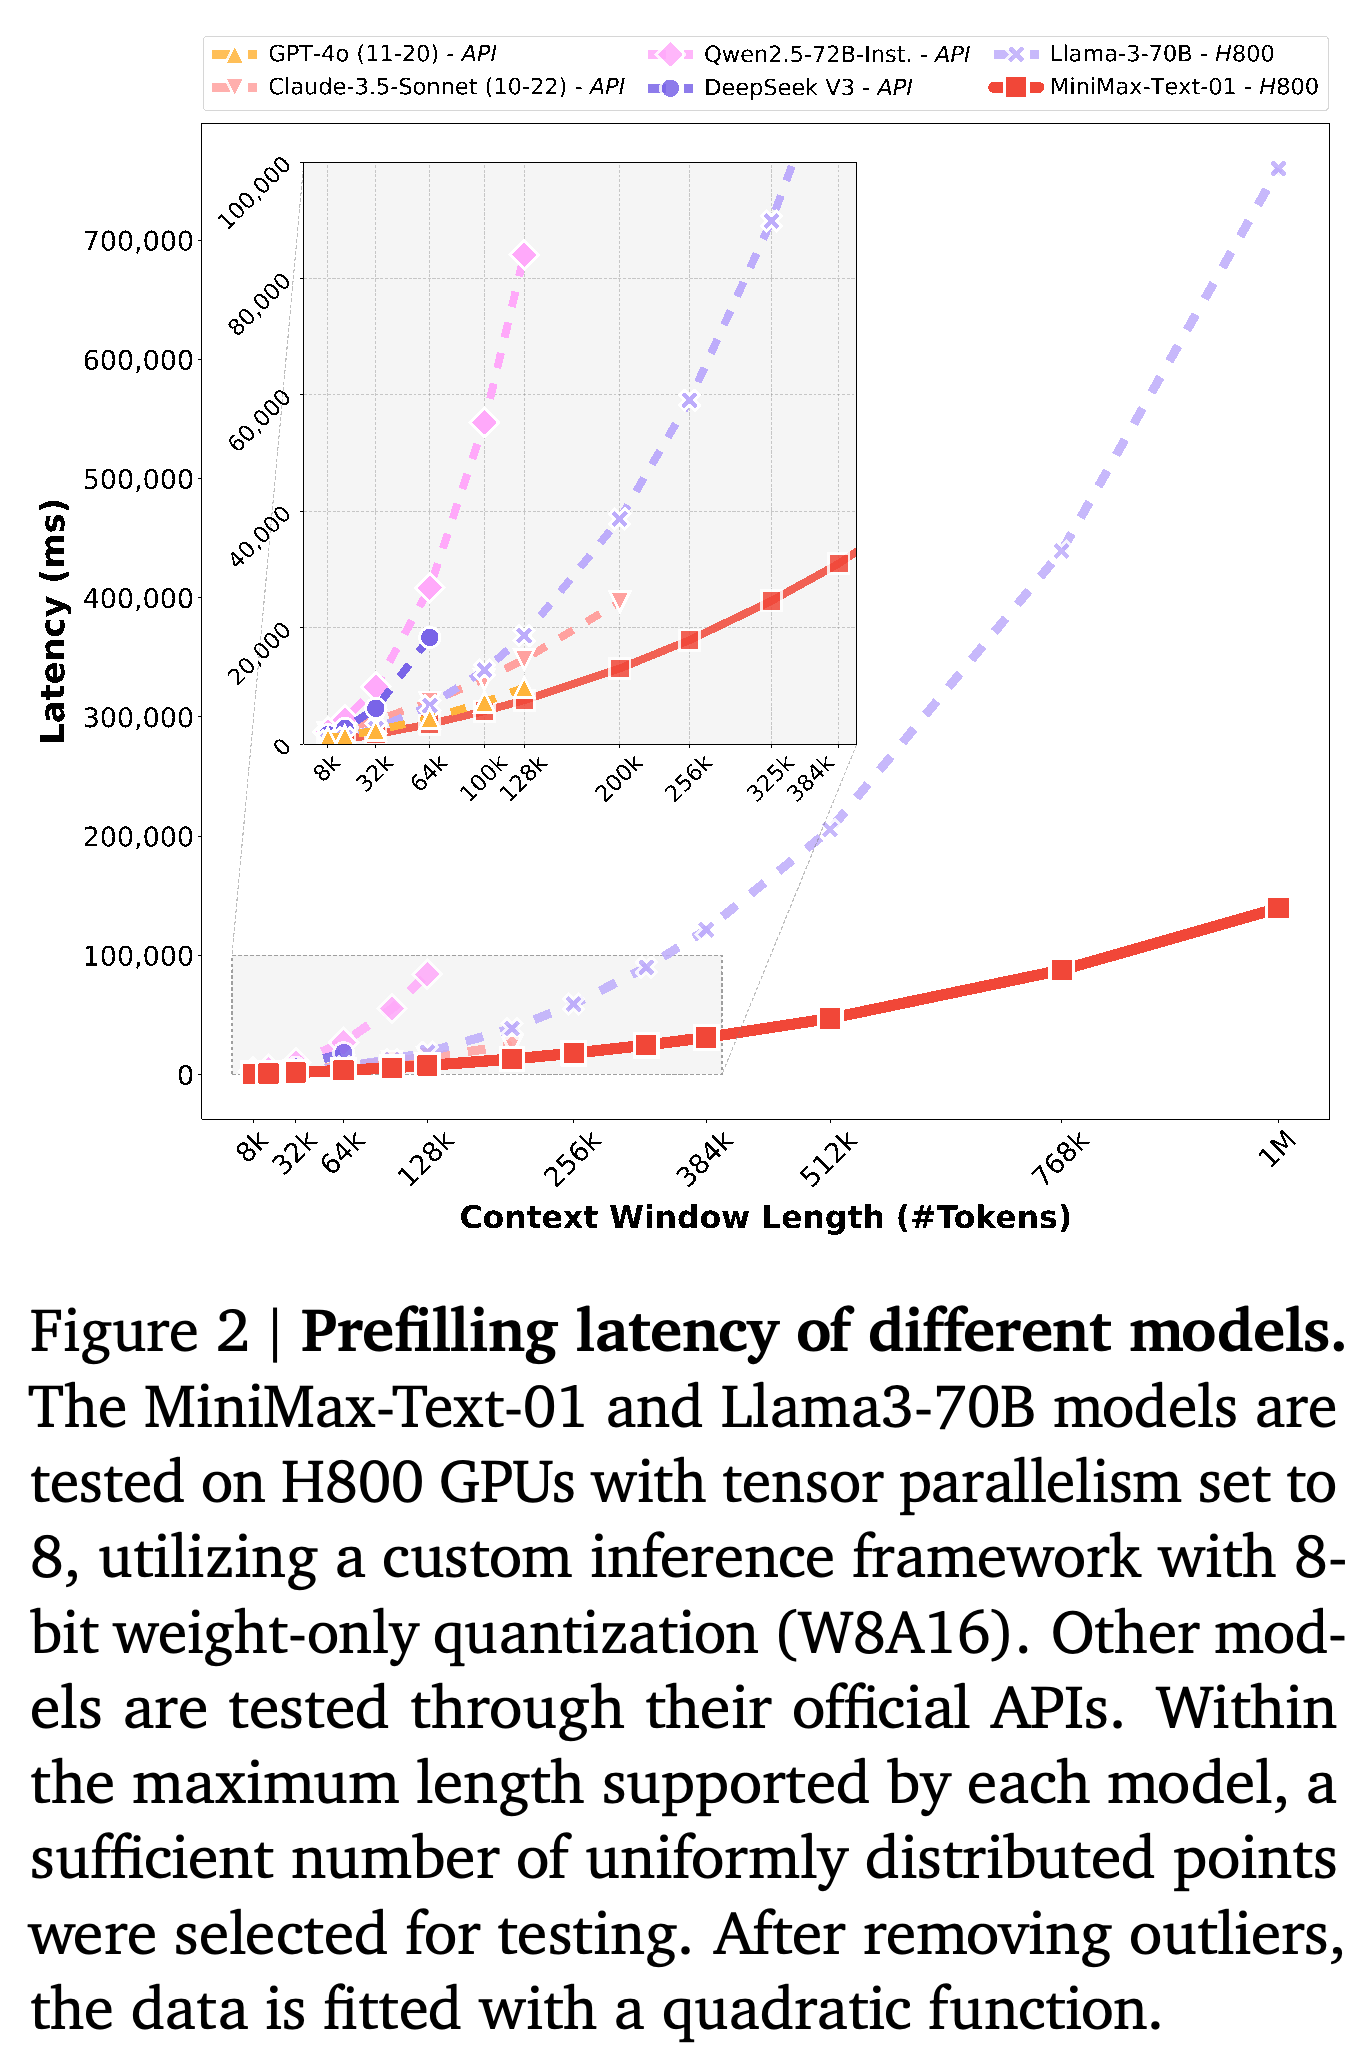
곡선은 입력이 길어질수록 MiniMax-Text-01의 prefilling 지연 시간 우위가 커짐을 보여 준다. Llama3-70B와의 로컬 비교는 H800 하드웨어, tensor parallelism 8, W8A16 조건을 공유한다. API 비교에는 서로 다른 서빙 시스템이 포함되며, 이상치 제거와 이차함수 적합도 해석에 영향을 준다.
이 도식은 반복되는 attention 혼합과 희소 전문가 계산의 연결을 보여 준다. Lightning 블록 7개 뒤에 softmax 블록이 오고, router는 피드포워드 전문가 2개를 선택한다. 따라서 최종 아키텍처는 누적된 linear attention 상태와 이전 입력에 대한 직접적인 softmax 접근을 모두 유지한다.
2. Inference-Time Scaling for Diffusion Models beyond Scaling Denoising Steps
- https://arxiv.org/abs/2501.09732
- Inference-Time Scaling for Diffusion Models beyond Scaling Denoising Steps 요약 설명
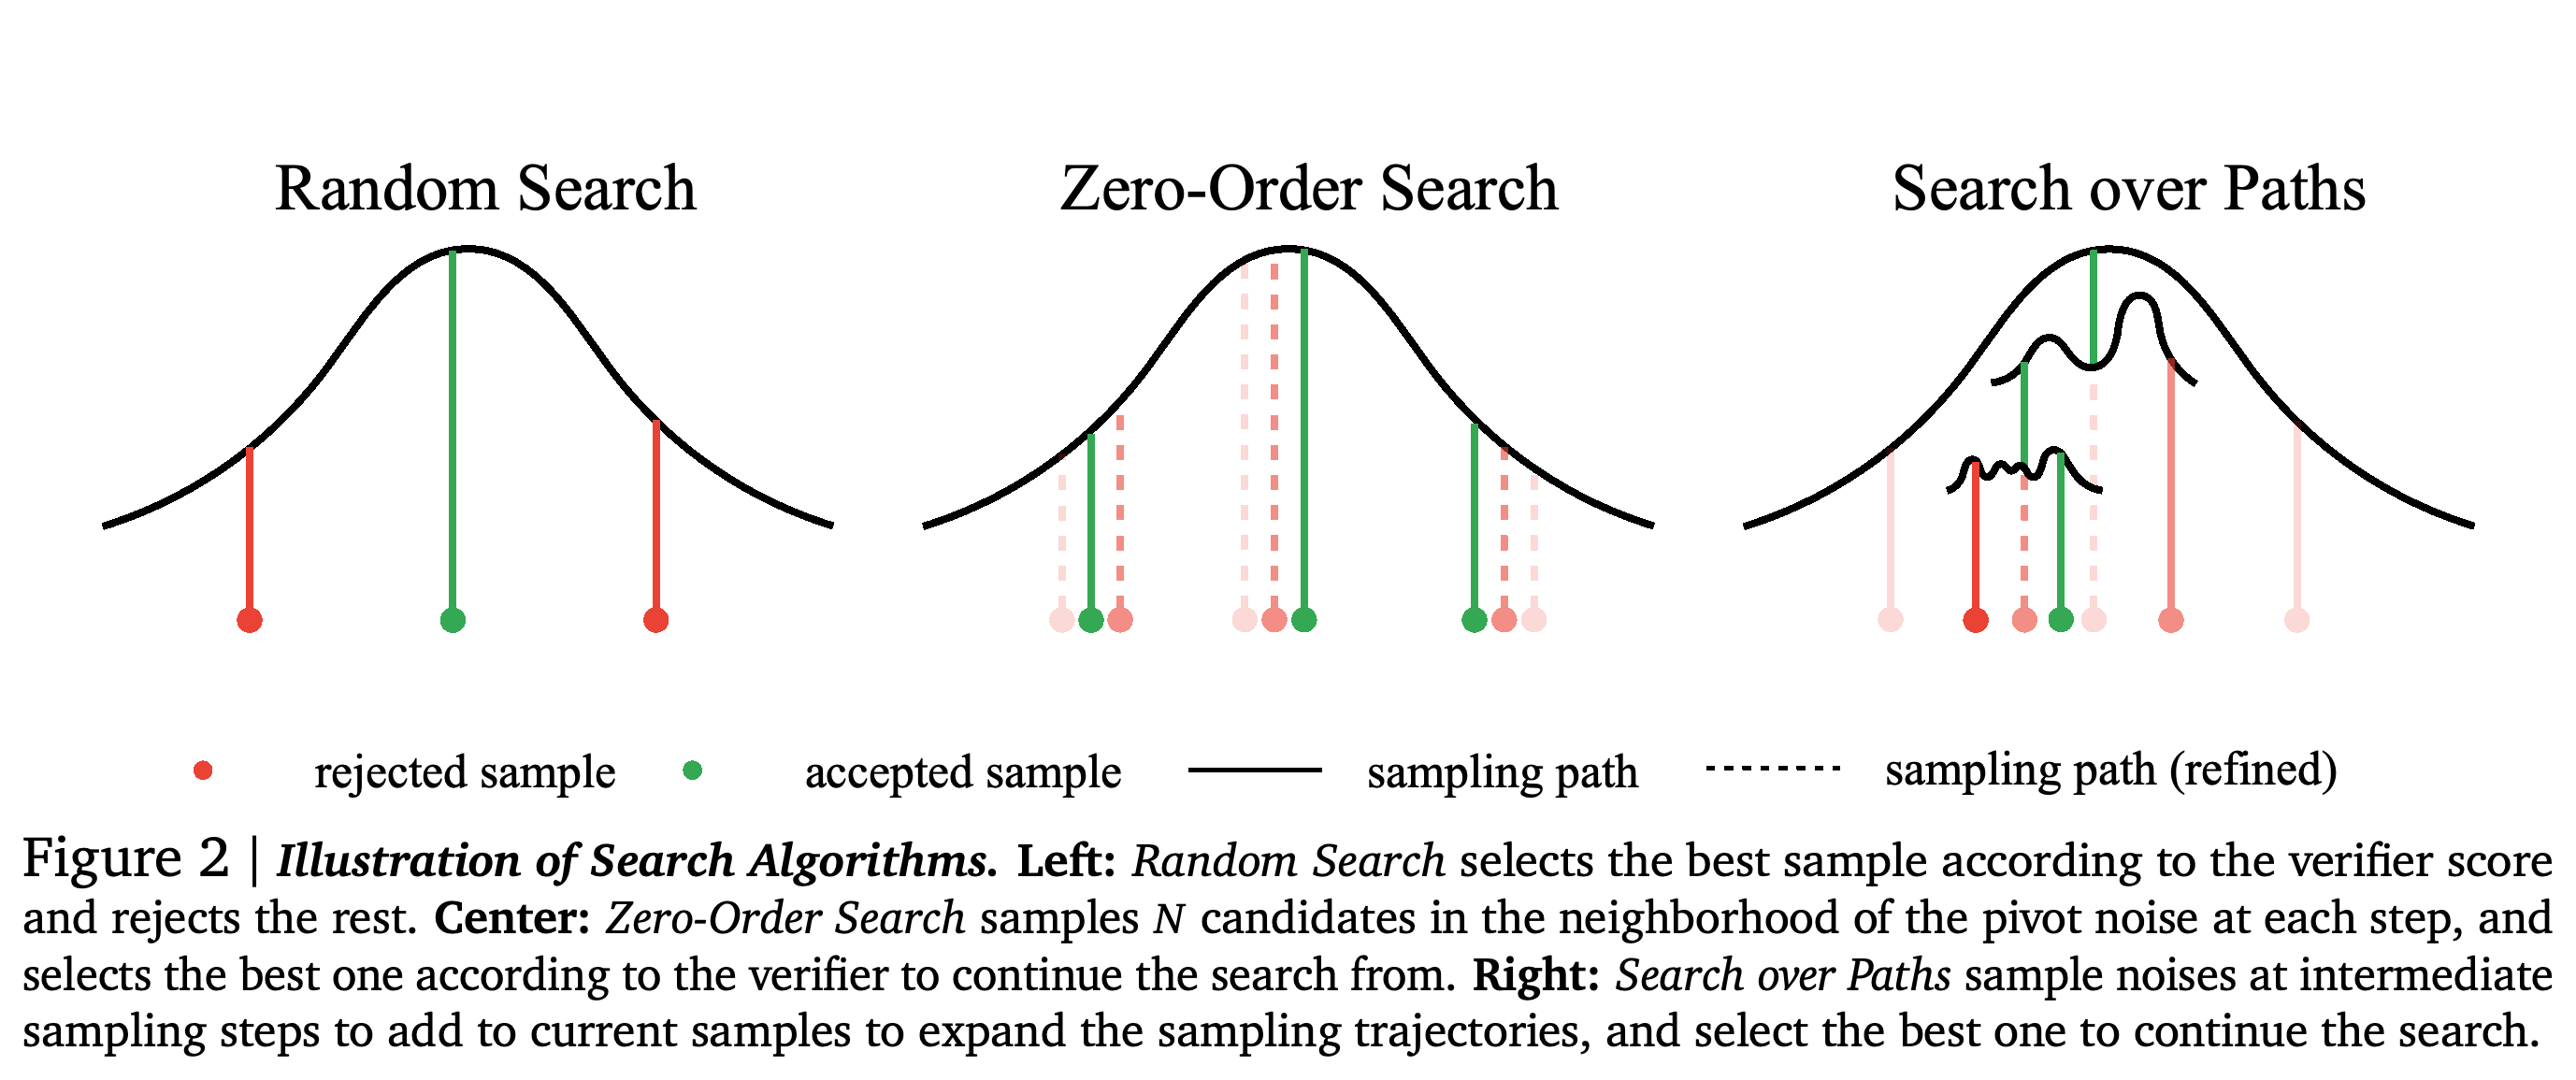
- Inference-Time Scaling for Diffusion Models beyond Scaling Denoising Steps는 후보 채점과 샘플링 노이즈 검색을 구분한다. Random Search는 독립적인 후보 중에서 선택하고, Zero-Order Search는 기울기를 계산하지 않고 인접한 초기 노이즈를 개선하며, Search over Paths는 중간 denoising 경로를 분기한다. 이러한 방법은 denoising 단계를 늘려 얻는 이득이 줄어든 뒤에도 추론 연산을 활용할 수 있는 다른 방법을 제공한다.
- 텍스트 프롬프트 기반 이미지 생성 벤치마크인 DrawBench에서 FLUX.1-dev에 앙상블 기반 Random Search를 적용하면, 언어 모델이 이미지 품질을 평가하는 LLM Grader 점수가 검색 없는 조건의 84.29에서 88.18로 높아진다. 베이스라인은 생성 모델의 순전파 평가 횟수인 number of function evaluations(NFEs) 30회를 사용하며, 검색에는 2880 NFEs를 추가한다. 같은 검색 예산에서 이웃 후보를 둘로 설정한 Zero-Order Search는 87.25를, 초기 경로를 둘로 설정한 Search over Paths는 86.84를 기록한다. LLM Grader에 대해서는 Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (LLM-as-a-Judge) 요약 설명 글을 참조하라.
- Verifier 선택에 따라 결과가 달라진다. 지정한 속성과 객체 관계를 평가하는 T2I-CompBench에서 검색 예산 1920 NFEs로 Random Search를 수행하면, 인간 선호를 학습한 평가기 ImageReward를 사용한 경우가 앙상블보다 전체 6개 범주에서 점수가 높다. 지역 검색은 라벨이 있는 이미지 벤치마크 ImageNet에서 다양성 감소를 일부 완화하지만, 과도한 검색에 따른 성능 악화를 없애지는 못한다. 생성 모델 평가 횟수와 근사 산술 연산량 비교만으로는 배포 환경의 지연 시간을 확인할 수 없다. 모델 기반 품질 평가기에 대한 인간 검증 연구도 보고되지 않았다.
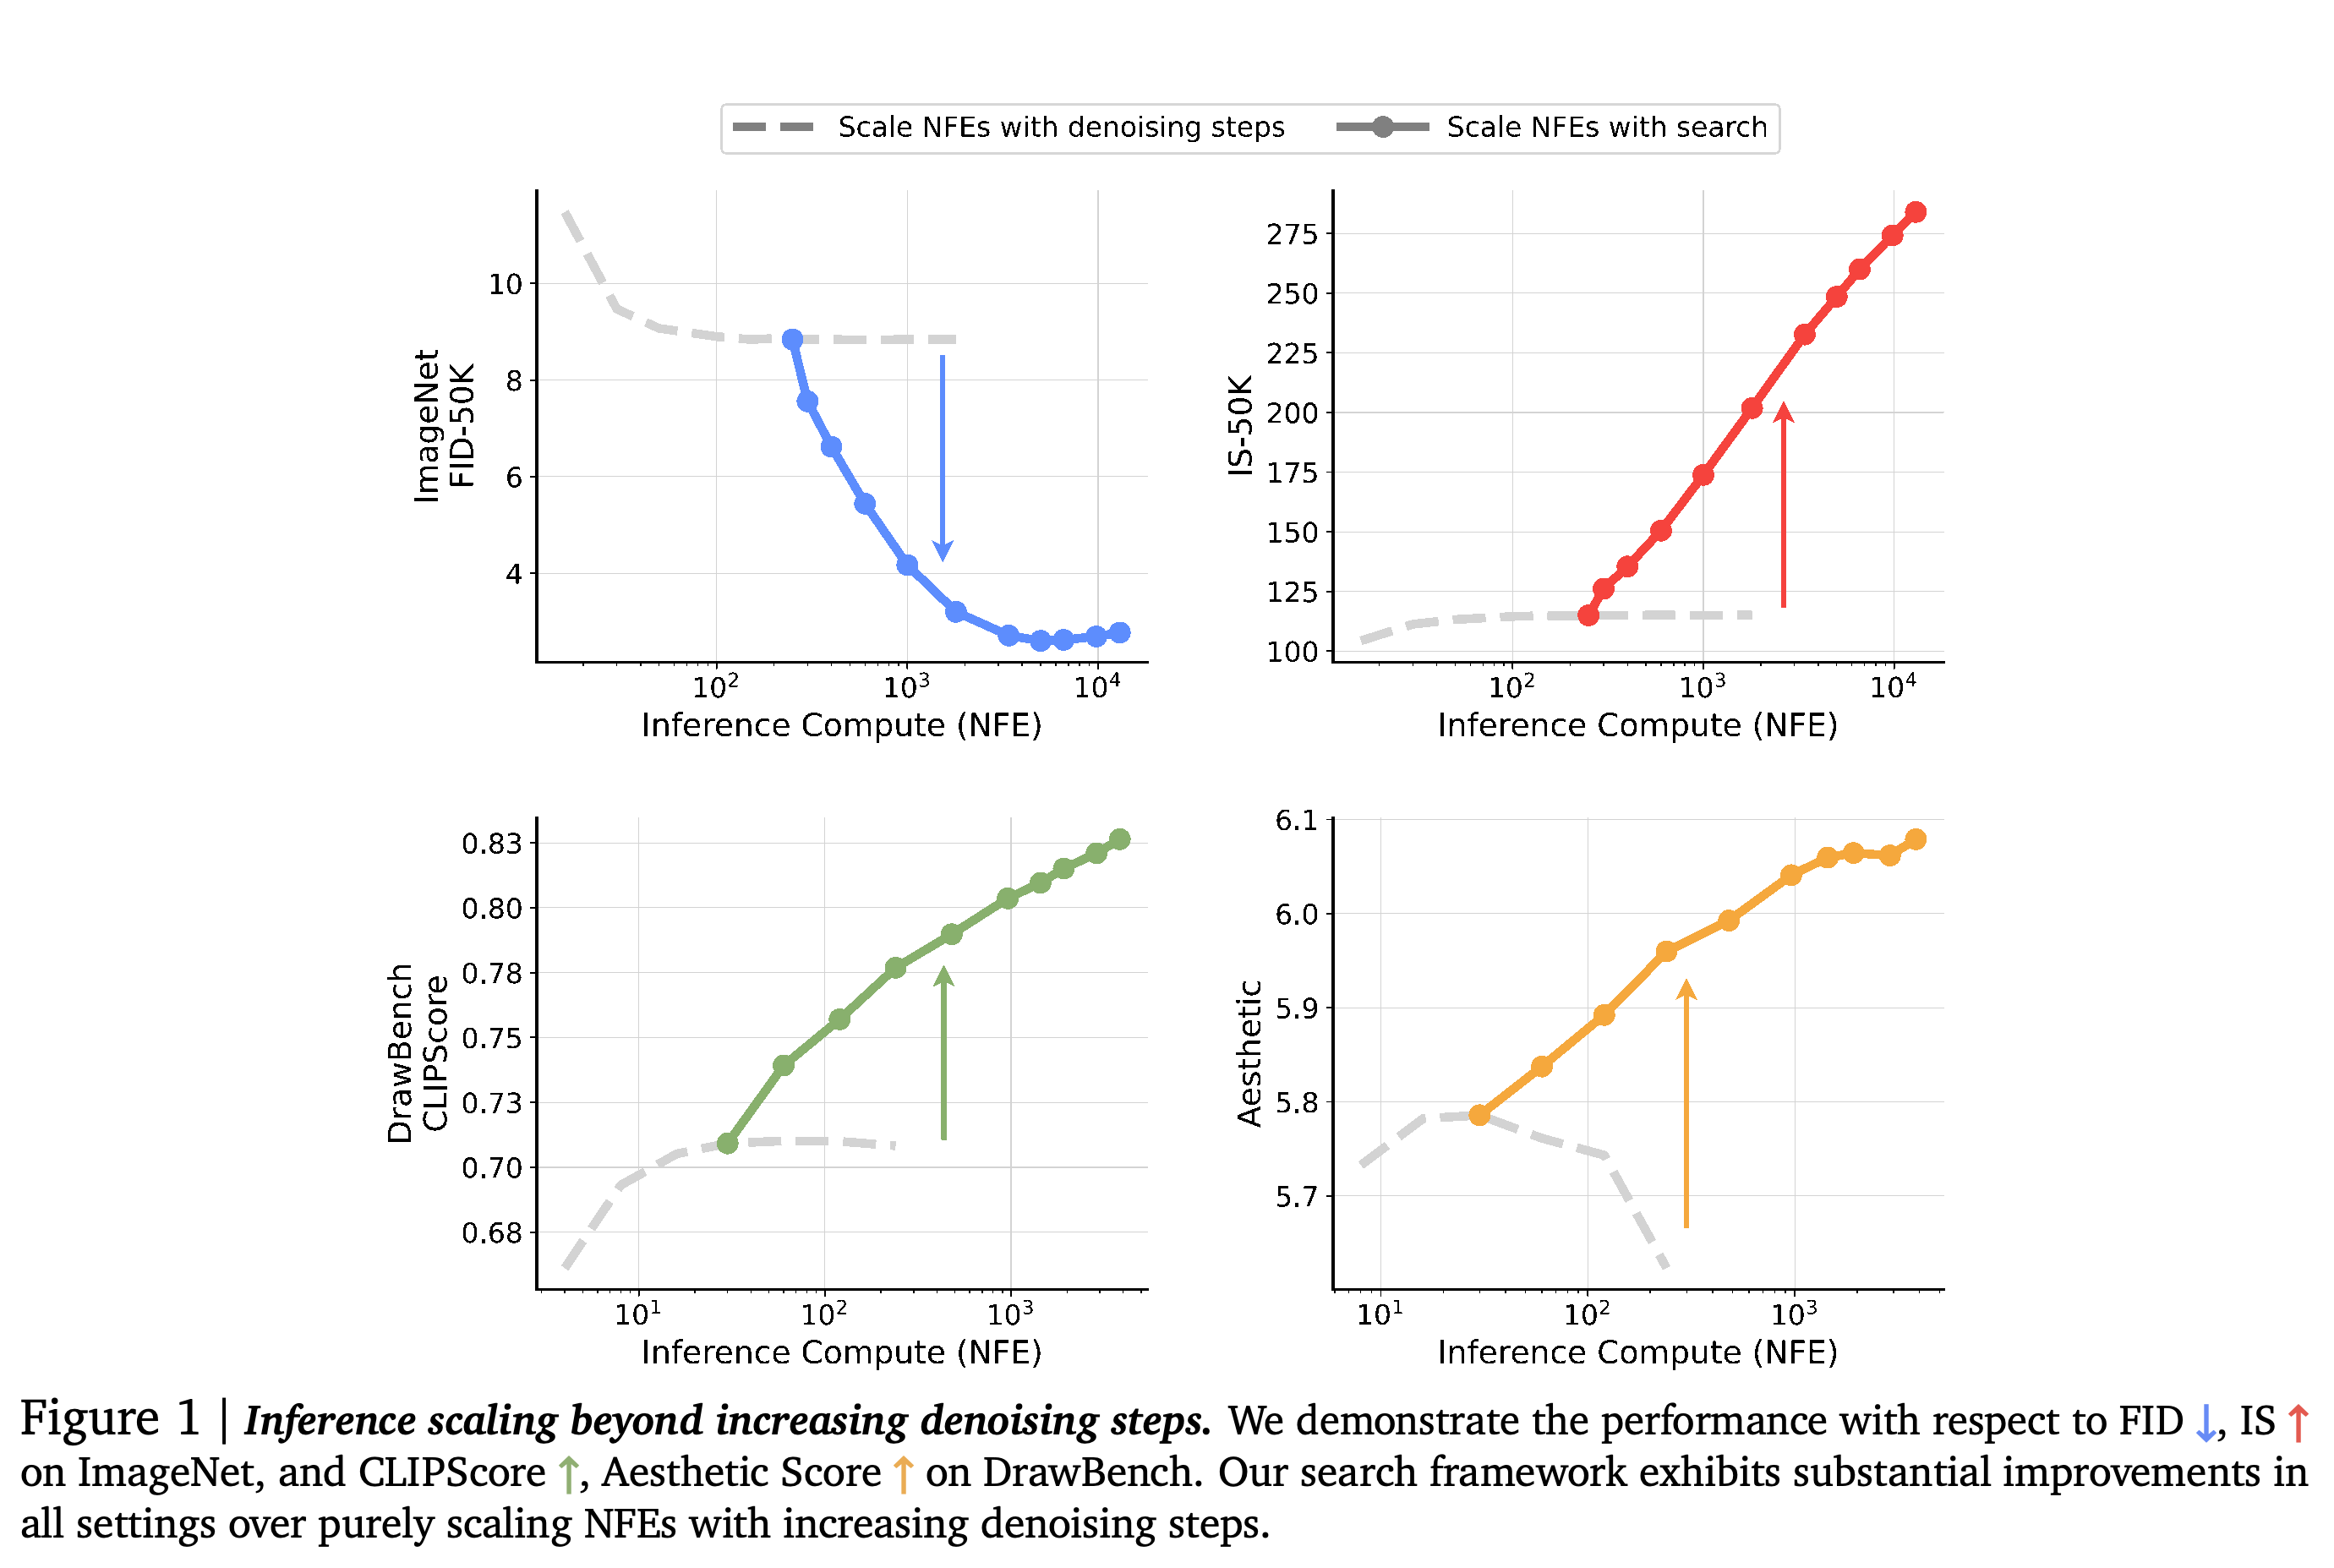
곡선 4개는 denoising 평가만 늘렸을 때 이득이 작아진 이후에도 생성 모델의 추가 평가를 검색에 배분하면 표시된 ImageNet과 DrawBench 지표가 계속 개선됨을 보여준다. 각 패널은 서로 다른 품질 기준을 측정하므로, 보편적으로 최적인 검색 구성을 입증하지는 않는다.
도식은 독립적인 후보 선택, 초기 노이즈의 국소적 개선, 중간 경로의 개선을 구분한다. 이러한 탐색 범위의 제한은 개별 이미지 점수를 극대화할 때 다양성이 줄어드는 상황에서 알고리즘마다 다른 양상을 보이는 이유를 해석하는 데 도움이 된다.
3. SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training
- https://arxiv.org/abs/2501.17161
- SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training 요약 설명
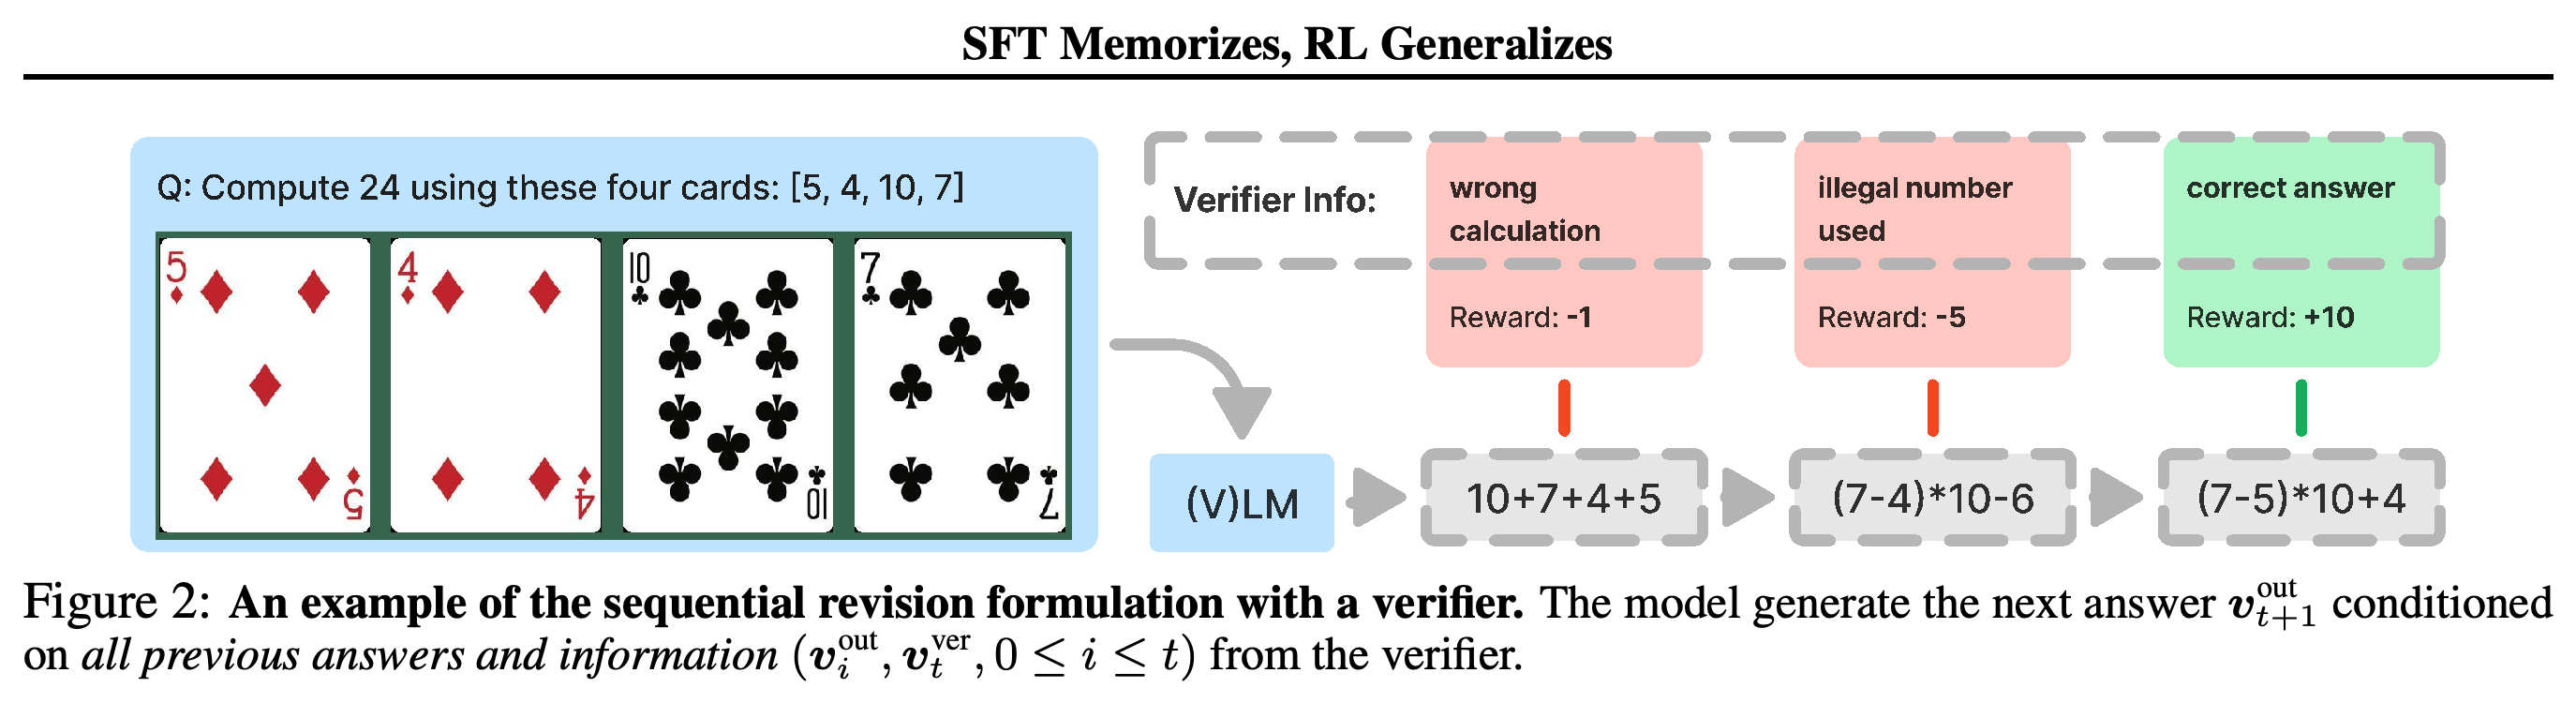
- SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training은 카드 4장의 값으로 24를 만드는 GeneralPoints와 거리뷰 내비게이션 환경 V-IRL에서 Llama-3.2-Vision-11B를 평가한다. 추가 SFT와 RL 학습은 모두 SFT로 학습한 공통 체크포인트에서 시작한다. RL은 verifier 피드백을 활용한 순차 수정을 사용한다. 최종 성능을 비교할 때는 RL 학습 응답 생성 비용을 포함한 추정 학습 연산량을 동일하게 맞춘다.
- 학습에 없던 내비게이션 행동 공간에서 이미지와 텍스트를 입력한 단계별 정확도는 초기화 시점의 35.7%에서 RL 적용 후 45.0%로 높아지고, 추가 SFT 적용 후에는 2.5%로 낮아진다. 과제 규칙을 고정하고 시각 조건을 바꾸면 RL은 GeneralPoints 성공률을 23.6%에서 41.2%로, 내비게이션 경로 성공률을 16.7%에서 77.8%로 높인다. 추가 SFT는 각 성공률을 13.7%와 11.1%로 낮춘다.
- 이 근거는 실험한 백본과 환경에서 해당 RL 파이프라인의 전이 성능이 더 높음을 뒷받침한다. 학습 예시를 거의 그대로 재현하는지는 직접 측정하지 않는다. 행동 정확도가 개선되어도 내비게이션 규칙을 바꾸면 전체 경로 성공률은 약 1% 이하에 머문다. 보고된 GeneralPoints 실험에서는 SFT 초기화 없이 직접 RL을 적용하면 실패하며, 극도로 과적합된 SFT 체크포인트에서도 RL은 규칙 전이 성능을 회복하지 못한다.
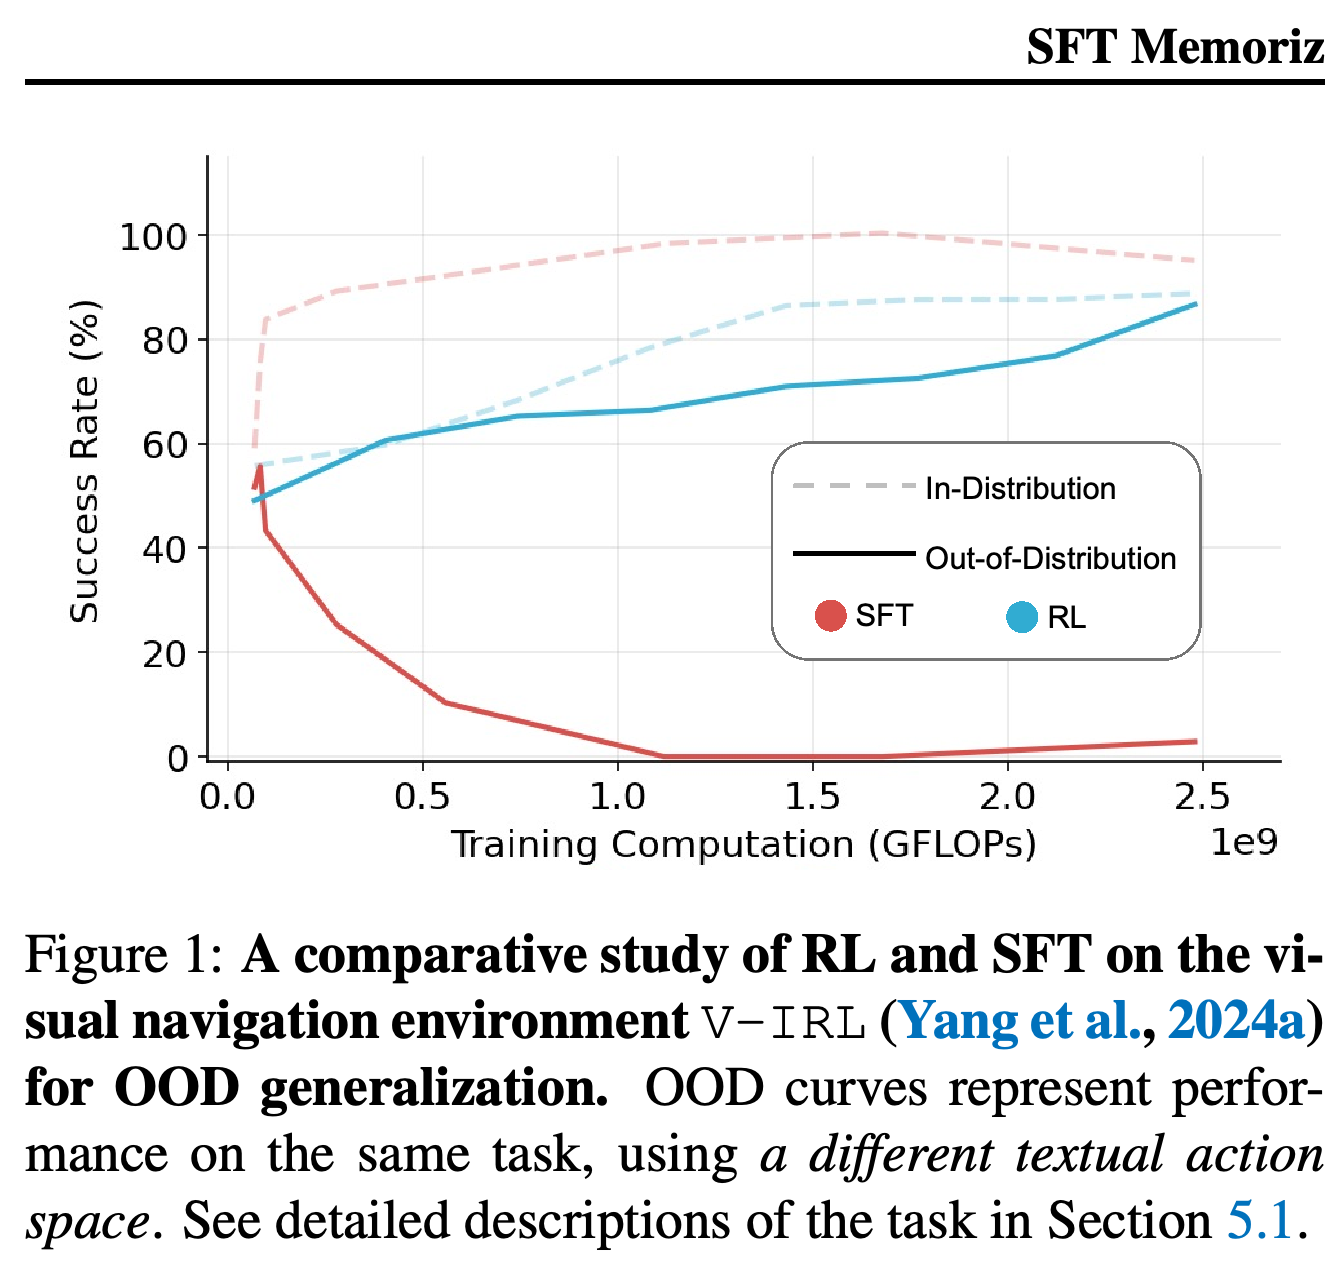
학습 연산량이 늘어나면 SFT는 학습한 내비게이션 행동 공간에서 높은 성능을 유지하지만, 변경된 행동 공간에서는 성능이 급락한다. RL은 곡선 2개의 성능을 모두 높인다. 이는 논문이 학습 과제의 성능 향상과 전이를 구분하는 근거가 된다. 이 곡선들은 Figure 5와 Figure 6의 단계별 지표와 달리 전체 내비게이션 성공률을 나타낸다.
카드 [5, 4, 10, 7]에 대해 verifier 피드백은 계산 오류와 주어지지 않은 숫자 사용을 구분하며, 이후 모델은 (7-5)*10+4를 생성한다. 이 도식은 수정 과정에서 피드백을 활용하는 방식을 설명한다. 예시 보상 값인 −1, −5, +10은 Appendix A.3의 환경 명세와 다르다.
출처
[1] MiniMax-01: Scaling Foundation Models with Lightning Attention
[2] Inference-Time Scaling for Diffusion Models beyond Scaling Denoising Steps
[3] SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training