


2025년 11월 AI 논문 동향
30 Nov 2025 | Paper Review Monthly Papers Diffusion Models Efficient Attention Knowledge Distillation목차
이달의 트렌드
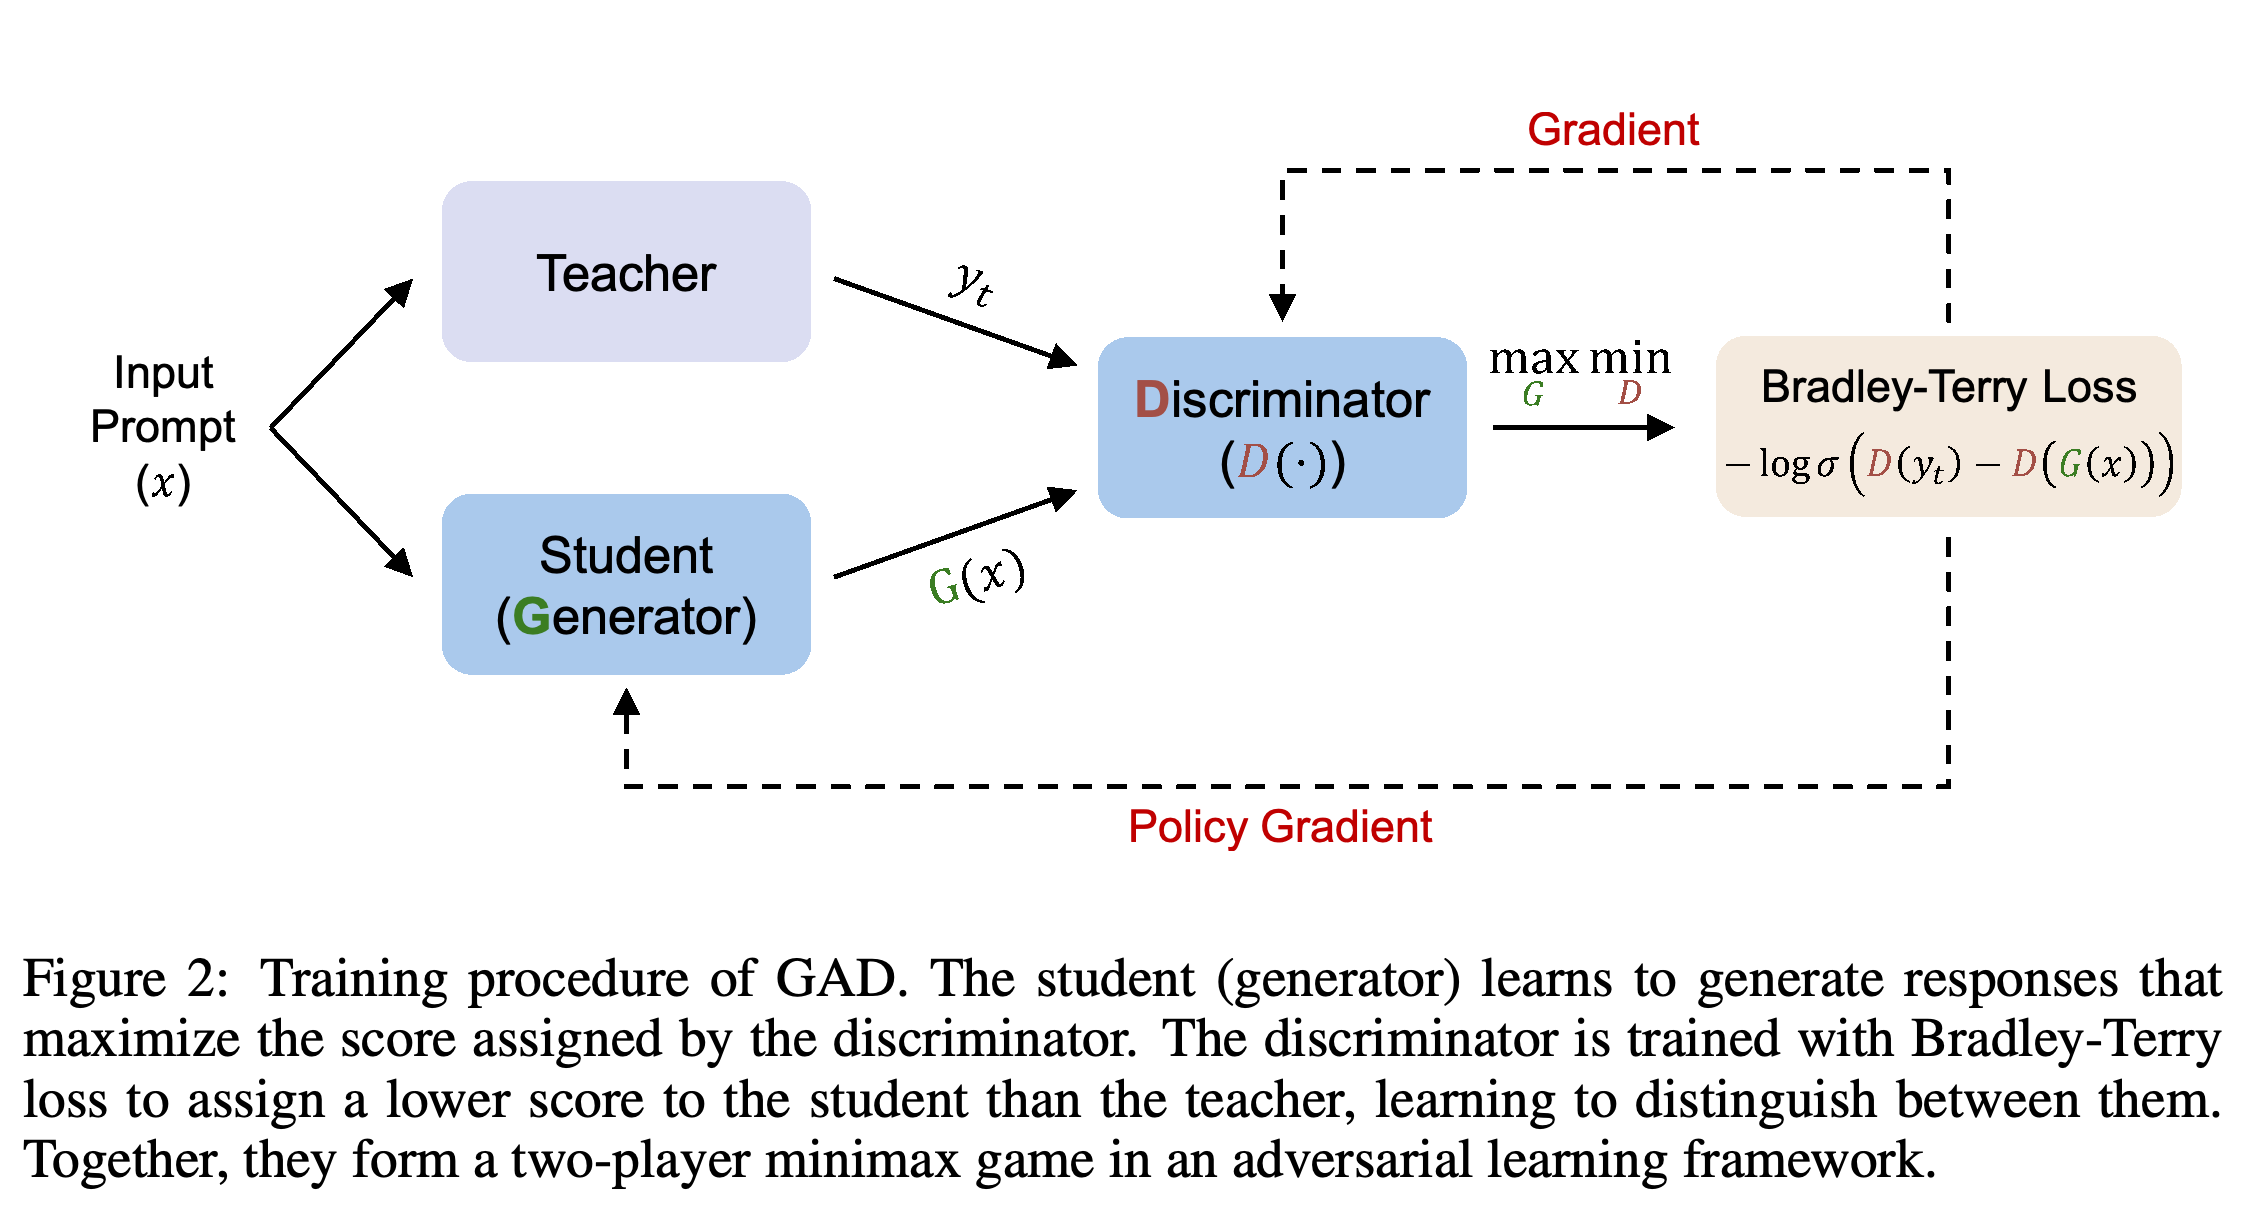
2025년 11월의 주제는 모델 용량을 더 효과적으로 활용하는 방법이며 선정된 논문 3편은 이미지 예측 대상, 언어 모델의 메모리, 학생 모델의 학습 피드백을 바꿔 특정 제약 아래에서 생성 성능을 개선한다. Just image Transformers(JiT)는 노이즈가 섞인 이미지 패치를 깨끗한 패치로 직접 변환하며 패치 차원이 높을 때 네트워크가 무엇을 예측하는지가 중요함을 보여준다. Kimi Linear는 토큰 이력을 고정 크기로 요약하는 순환 메모리와 이전 토큰 전체를 참조하는 전역 어텐션 계층을 주기적으로 결합한다. Generative Adversarial Distillation(GAD)은 교사와 학생의 응답에 점수를 매기는 판별기와 학생을 경쟁시켜 학습하며 교사의 텍스트만으로 학생이 직접 생성한 답변에 피드백을 제공한다. 이 연구들은 모델이 어떤 정보를 표현해야 하는지, 학습이 제한된 용량의 활용을 어떻게 유도하는지 살펴본다. 1, 2, 3
보고된 개선은 공학적으로 서로 다르게 해석해야 한다. JiT가 해상도를 높여도 연산량을 거의 유지하는 것은 해상도에 맞춰 패치 크기를 늘리는 설정에 따른 결과다. 연산량 비교는 전체 학습 비용이 아니라 순전파 1회를 측정한다. Kimi Linear는 프롬프트 처리와 단일 요청 디코딩의 가속을, 메모리 절감으로 더 큰 배치를 사용해 얻는 추가 가속과 구분한다. GAD는 동일한 학습 epoch 수에서 대화 평가 점수를 높이지만 지도학습 기준 모델과 연산 비용을 비교하지 않는다. 이 결과들은 각 설계를 이미지 표현, 긴 문맥 서빙, 텍스트만 제공하는 교사에 대한 접근이라는 실제 제약에 맞춰 평가할 근거를 제공한다.
2025년 11월의 주요 논문
1. Back to Basics: Let Denoising Generative Models Denoise
- https://arxiv.org/abs/2511.13720
- Back to Basics: Let Denoising Generative Models Denoise 요약 설명
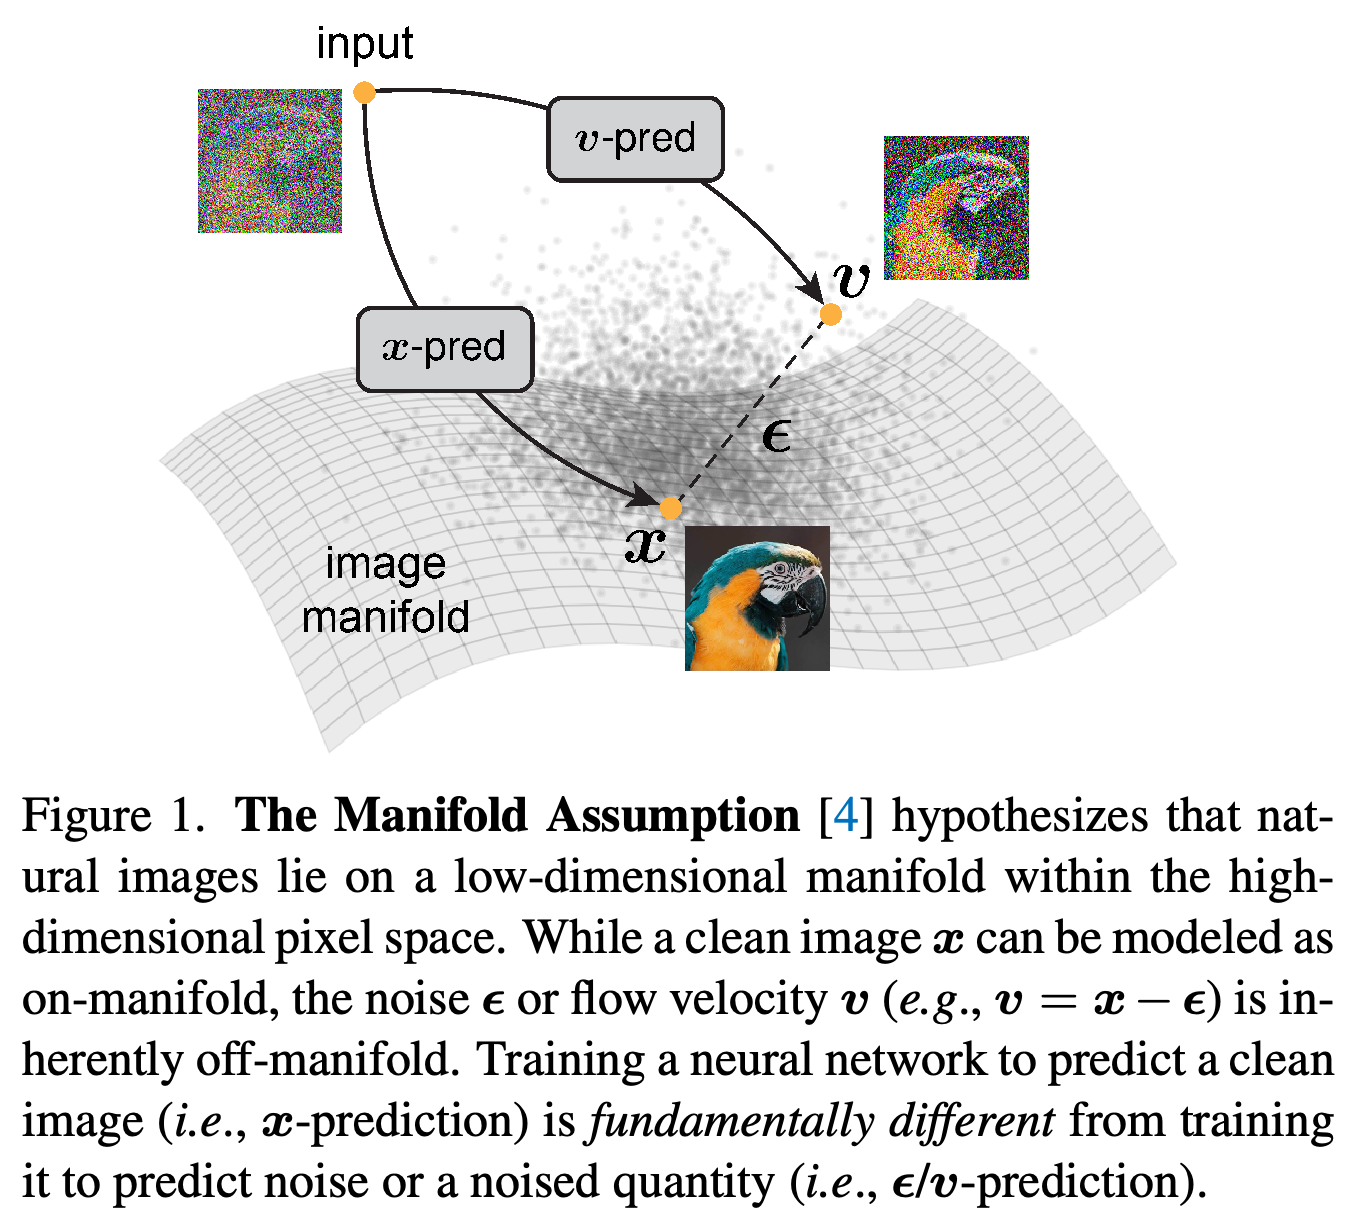
- Back to Basics: Let Denoising Generative Models Denoise는 네트워크가 직접 출력하는 값을 정하는 예측 공간과 학습 오차를 계산할 값을 정하는 손실 공간을 구분한다. JiT는 이미지 패치를 처리하는 Transformer인 Vision Transformer로 깨끗한 이미지를 직접 예측한다. 픽셀을 생성용 표현으로 인코딩하는 학습된 latent tokenizer, 외부 사전 학습, 보조 손실은 사용하지 않는다. 모델 용량에 관한 설명은 manifold 가정에 기반한다. 자연 이미지는 픽셀 공간 안의 저차원 구조에 대략 분포하지만 노이즈를 포함한 예측 대상은 그 주변의 고차원 공간에 분포한다는 가정이다.
- ImageNet 256×256에서 16×16 패치를 사용하는 기본 크기 모델 JiT-B/16은 깨끗한 이미지 예측으로 FID-50K 8.62를 기록한다. 노이즈 예측은 372.38이며, 노이즈가 섞인 샘플의 변화율을 예측하는 flow velocity 예측은 96.53이다. FID-50K는 생성 이미지 50,000장으로 측정한 Fréchet Inception Distance이며 낮을수록 좋다. 비교에는 동일한 구조, velocity 공간의 손실, 200 epochs 학습을 사용하고 샘플링 중 클래스 조건의 강도를 조절하는 classifier-free guidance를 적용한다. Guidance 설정과 학습 중 파라미터 평균 방식을 결정하는 exponential moving average 감쇠율은 모델마다 별도로 선택한다.
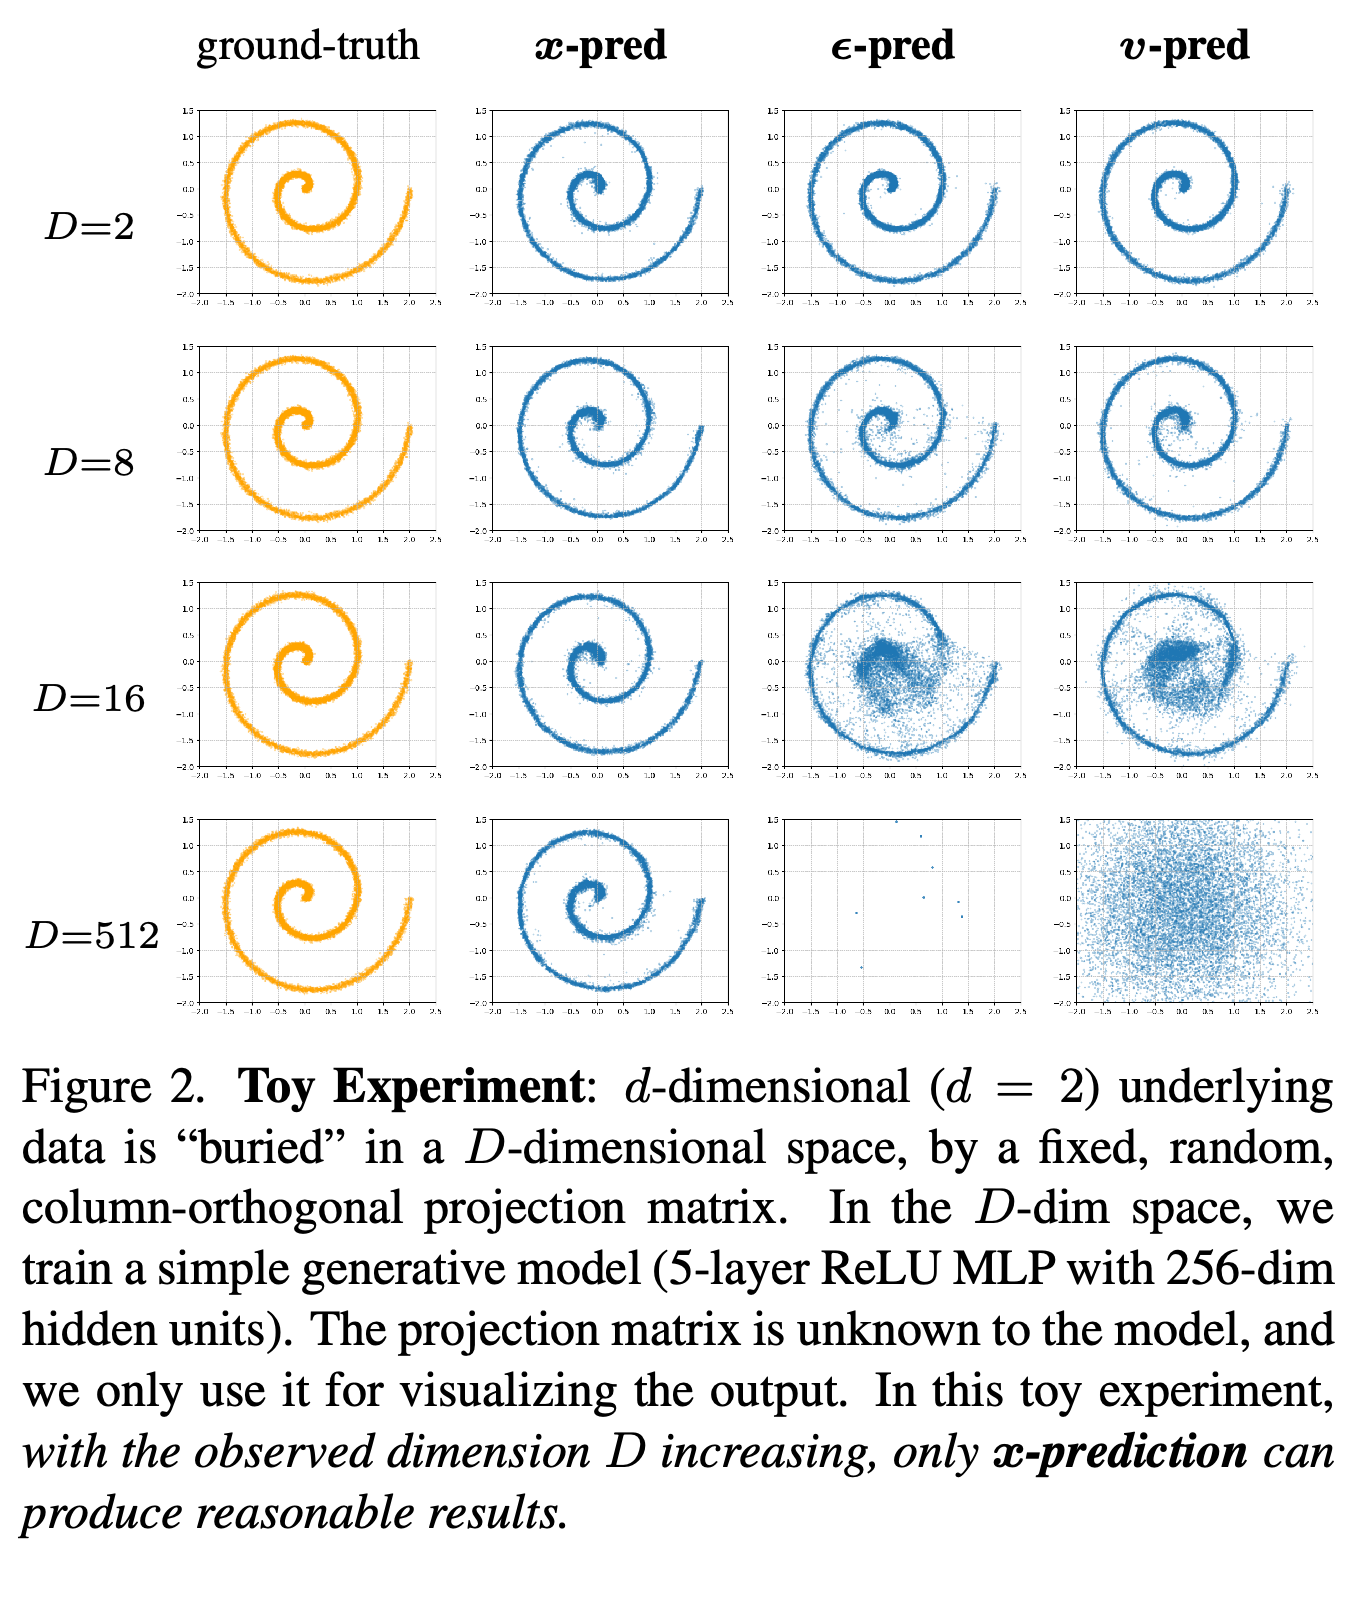
- 압축 실험은 평가한 설정 안에서 모델 용량에 관한 설명을 뒷받침한다. 768차원 원시 패치보다 좁은 중간 표현인 64차원 입력 bottleneck을 사용하면 JiT-B/16의 FID가 8.62에서 7.35로 개선된다. 16차원 bottleneck에서도 FID는 9.40이다. 합성 데이터 실험에서는 256차원 은닉층을 사용하는 깨끗한 이미지 예측 모델이 512차원 관측 공간에 삽입한 2차원 나선 구조를 보존한다. 같은 설정에서 노이즈 예측과 velocity 예측은 실패한다. 이 실험들은 자연 이미지의 내재 차원을 직접 측정하지 않는다. bottleneck에 대해서는 MobileNetV2 논문 설명(MobileNetsV2 - Inverted Residuals and Linear Bottlenecks 리뷰) 글을 참조하라.
2. Kimi Linear: An Expressive, Efficient Attention Architecture
- https://arxiv.org/abs/2510.26692
- Kimi Linear: An Expressive, Efficient Attention Architecture 요약 설명
- Kimi Linear: An Expressive, Efficient Attention Architecture는 이력을 고정 크기 메모리로 압축하고 특징 채널마다 별도의 망각률을 학습하는 선형 어텐션인 Kimi Delta Attention(KDA)을 제안한다. 델타 규칙 갱신은 메모리를 감쇠시킨 뒤 저장된 키–값 연결을 수정한다. 구조는 KDA 계층 3개 뒤에 논문의 전역 어텐션 기법인 Multi-Head Latent Attention(MLA) 계층 1개를 배치하는 패턴을 반복한다. 각 KDA 헤드는 고정된 128×128 상태를 저장한다. 전체 혼합 구조의 MLA 계층에서는 어텐션 이력을 저장하는 캐시가 계속 커진다.
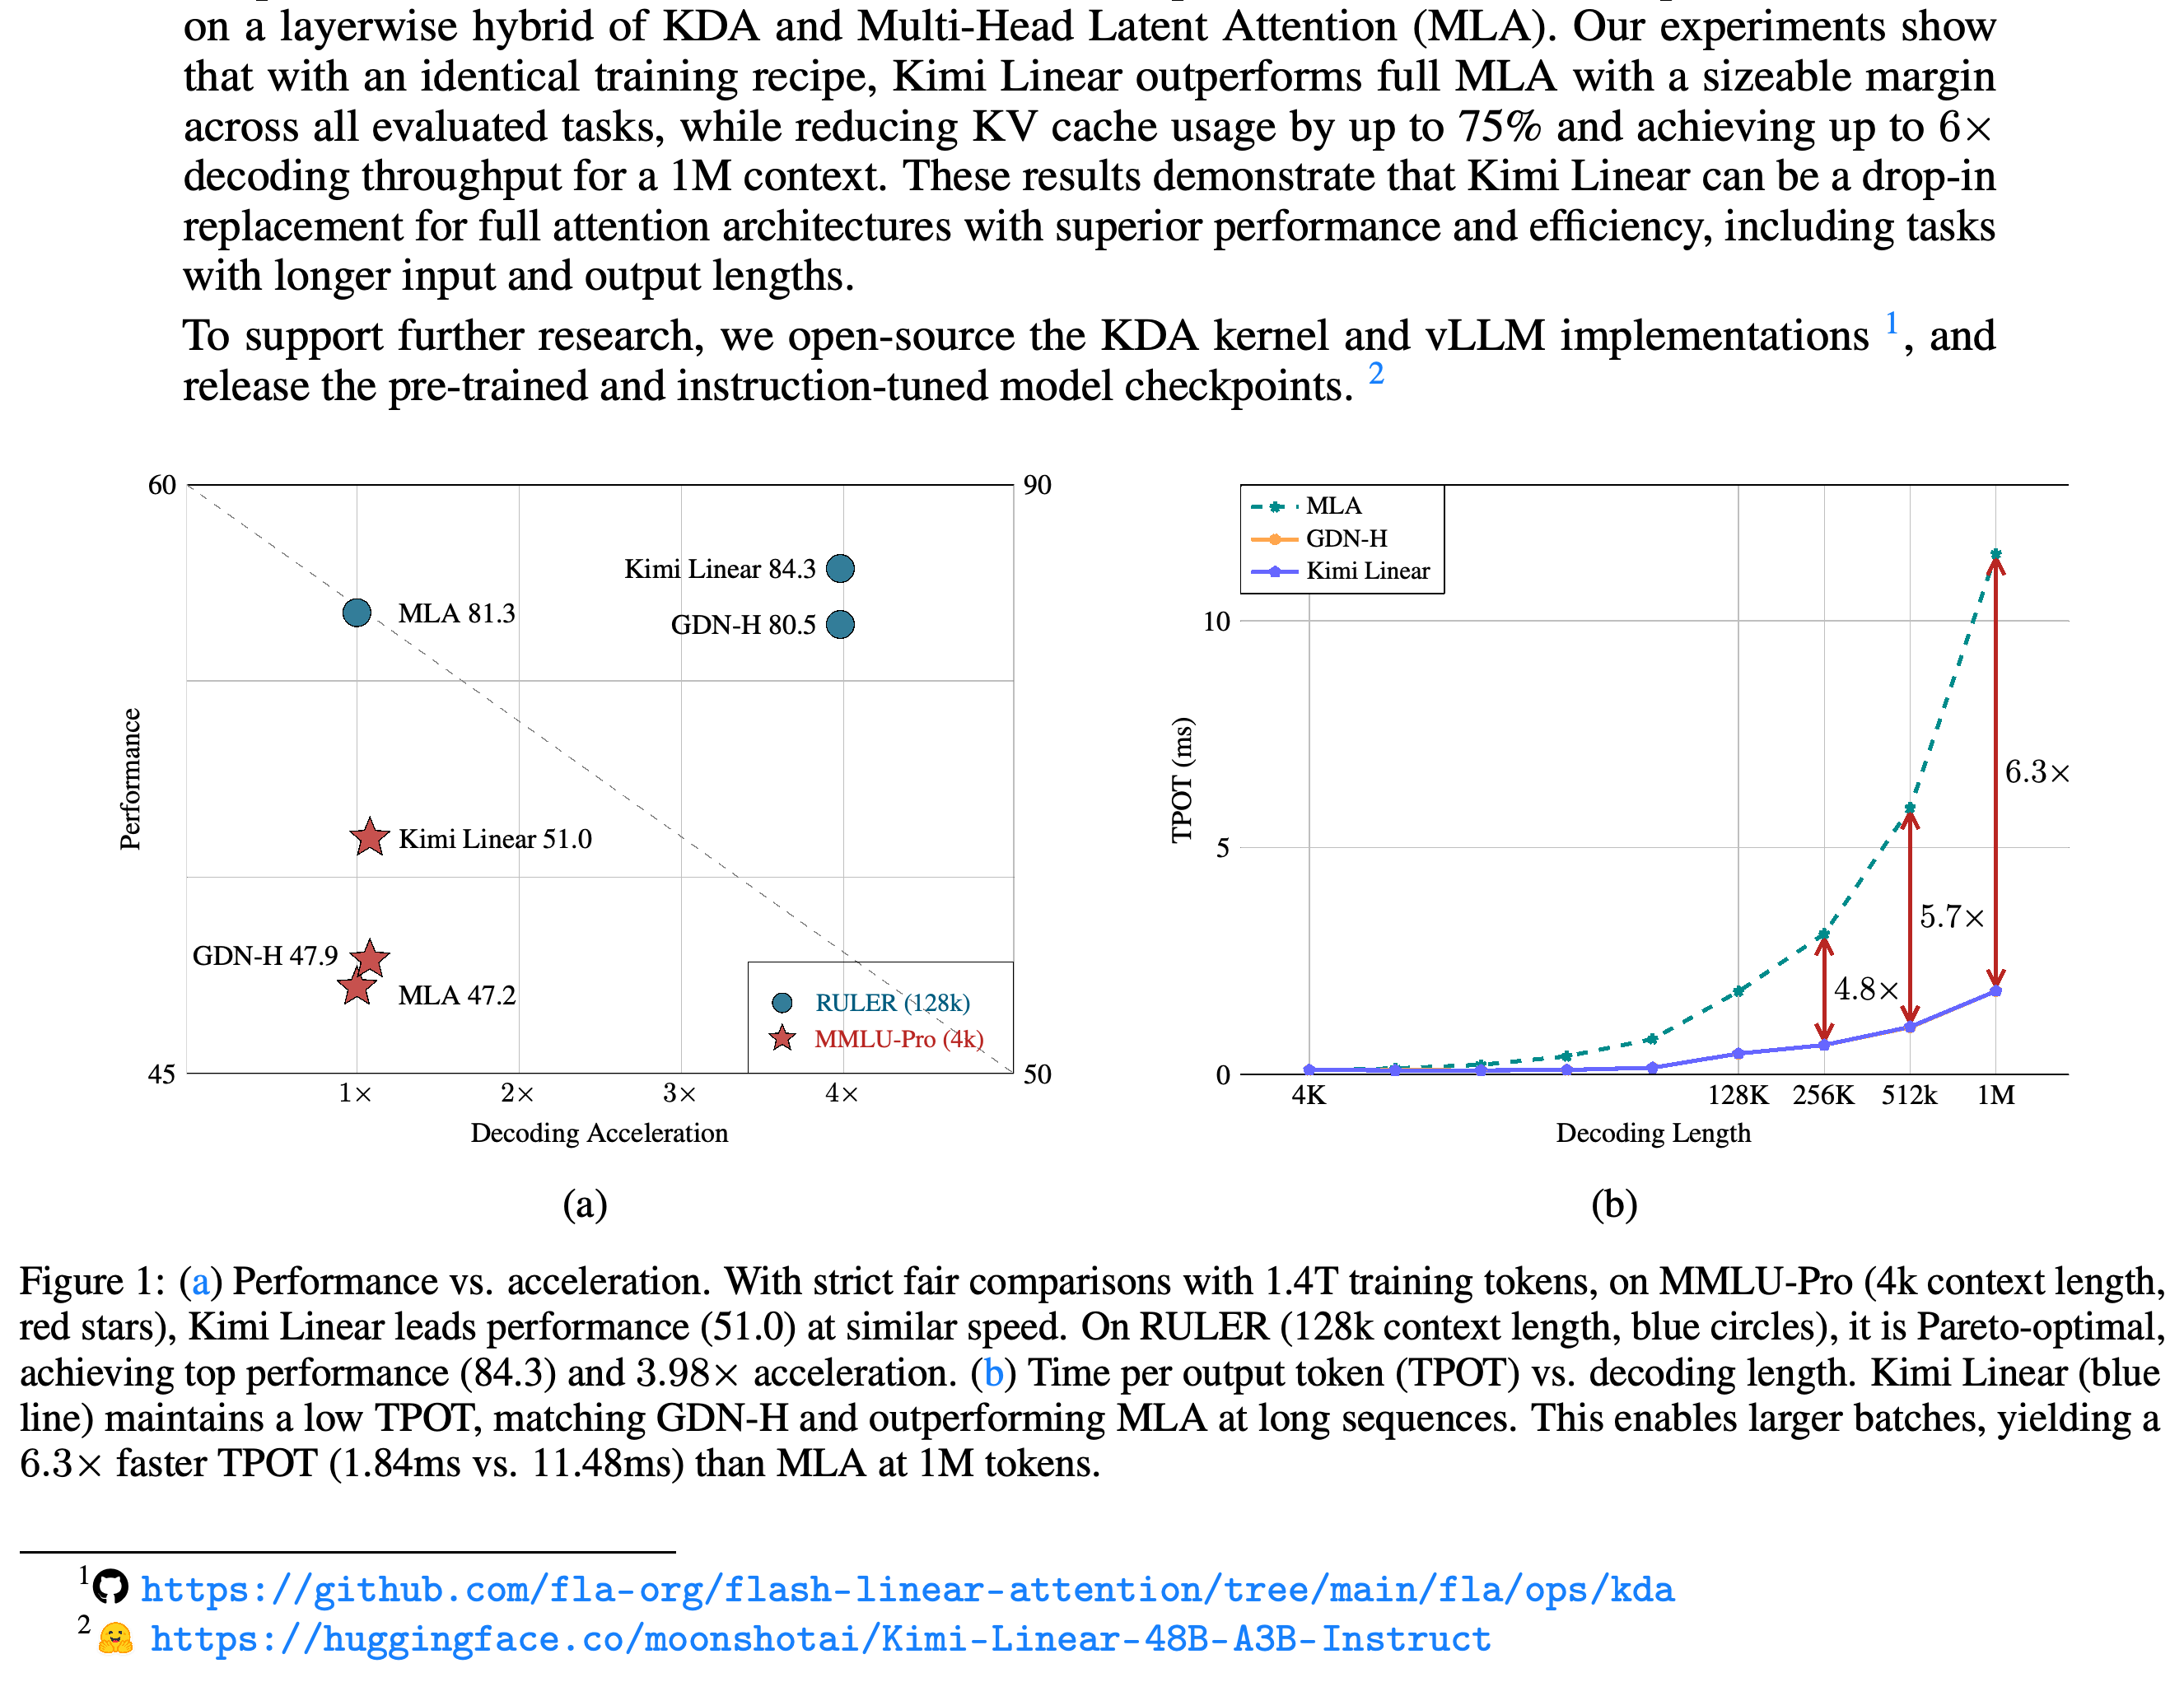
- 파라미터 수를 맞춘 비교는 전체 파라미터 48B, 순전파마다 사용하는 활성 파라미터 3B, 동일한 1.4T-token 학습 방식을 사용한다. Kimi Linear는 여러 과제의 언어 이해를 평가하는 MMLU-Pro 점수를 MLA의 47.2에서 51.0으로 높이며 128k-context 지표 8개의 평균을 52.2에서 54.5로 높인다. 개선은 과제마다 다르다. 수학 벤치마크인 MATH에서는 54.7로 MLA와 같고, 긴 문맥 지표 8개 중 3개에서는 MLA가 더 높다. 이 결과는 전체 혼합 구조를 평가하며 모든 개선을 채널별 망각만의 효과로 귀속하지 않는다.
- 혼합 구조는 어텐션 이력을 저장하는 키–값 캐시 사용량을 최대 75% 줄인다. 시간 측정 그래프는 1M 문맥과 배치 크기 1에서 MLA 대비 프롬프트 처리가 2.9×, 디코딩이 약 2.2× 빠르다고 보고한다. 별도의 큰 배치 비교에서는 생성 토큰당 시간을 1.84 ms와 11.48 ms로 보고하고 가속을 6.3×로 표시한다. 여기에는 메모리 절감으로 배치를 확대한 이점도 포함된다. 가속기 하드웨어와 큰 배치의 정확한 크기는 명시하지 않는다. 공개된 5.7T-token 모델과 Moonlight의 비교는 전체 파라미터 수도 16B에서 48B로 달라진다. 따라서 구조 비교에는 조건을 맞춘 1.4T-token 학습 실행이 더 강한 근거를 제공한다.
3. Black-Box On-Policy Distillation of Large Language Models
- https://arxiv.org/abs/2511.10643
- Black-Box On-Policy Distillation of Large Language Models 요약 설명
- Black-Box On-Policy Distillation of Large Language Models는 교사의 동작을 학생에게 전달하는 지식 증류를 내부 확률 없이 생성 텍스트만 제공하는 블랙박스 교사로 확장한다. GAD는 적응형 판별기를 통해 현재 학생에서 샘플링한 응답으로 학습하는 on-policy 학습을 가능하게 한다. 판별기는 교사 응답의 순위를 학생 응답보다 높게 매기도록 학습하며 학생 최적화에 보상을 제공한다. 학생과 판별기라는 모델 2개는 모두 1 epoch의 준비 학습을 거친 뒤 2 epochs의 적대적 훈련을 수행한다. 적대적 훈련 중에도 모델 2개를 모두 계속 갱신한다.
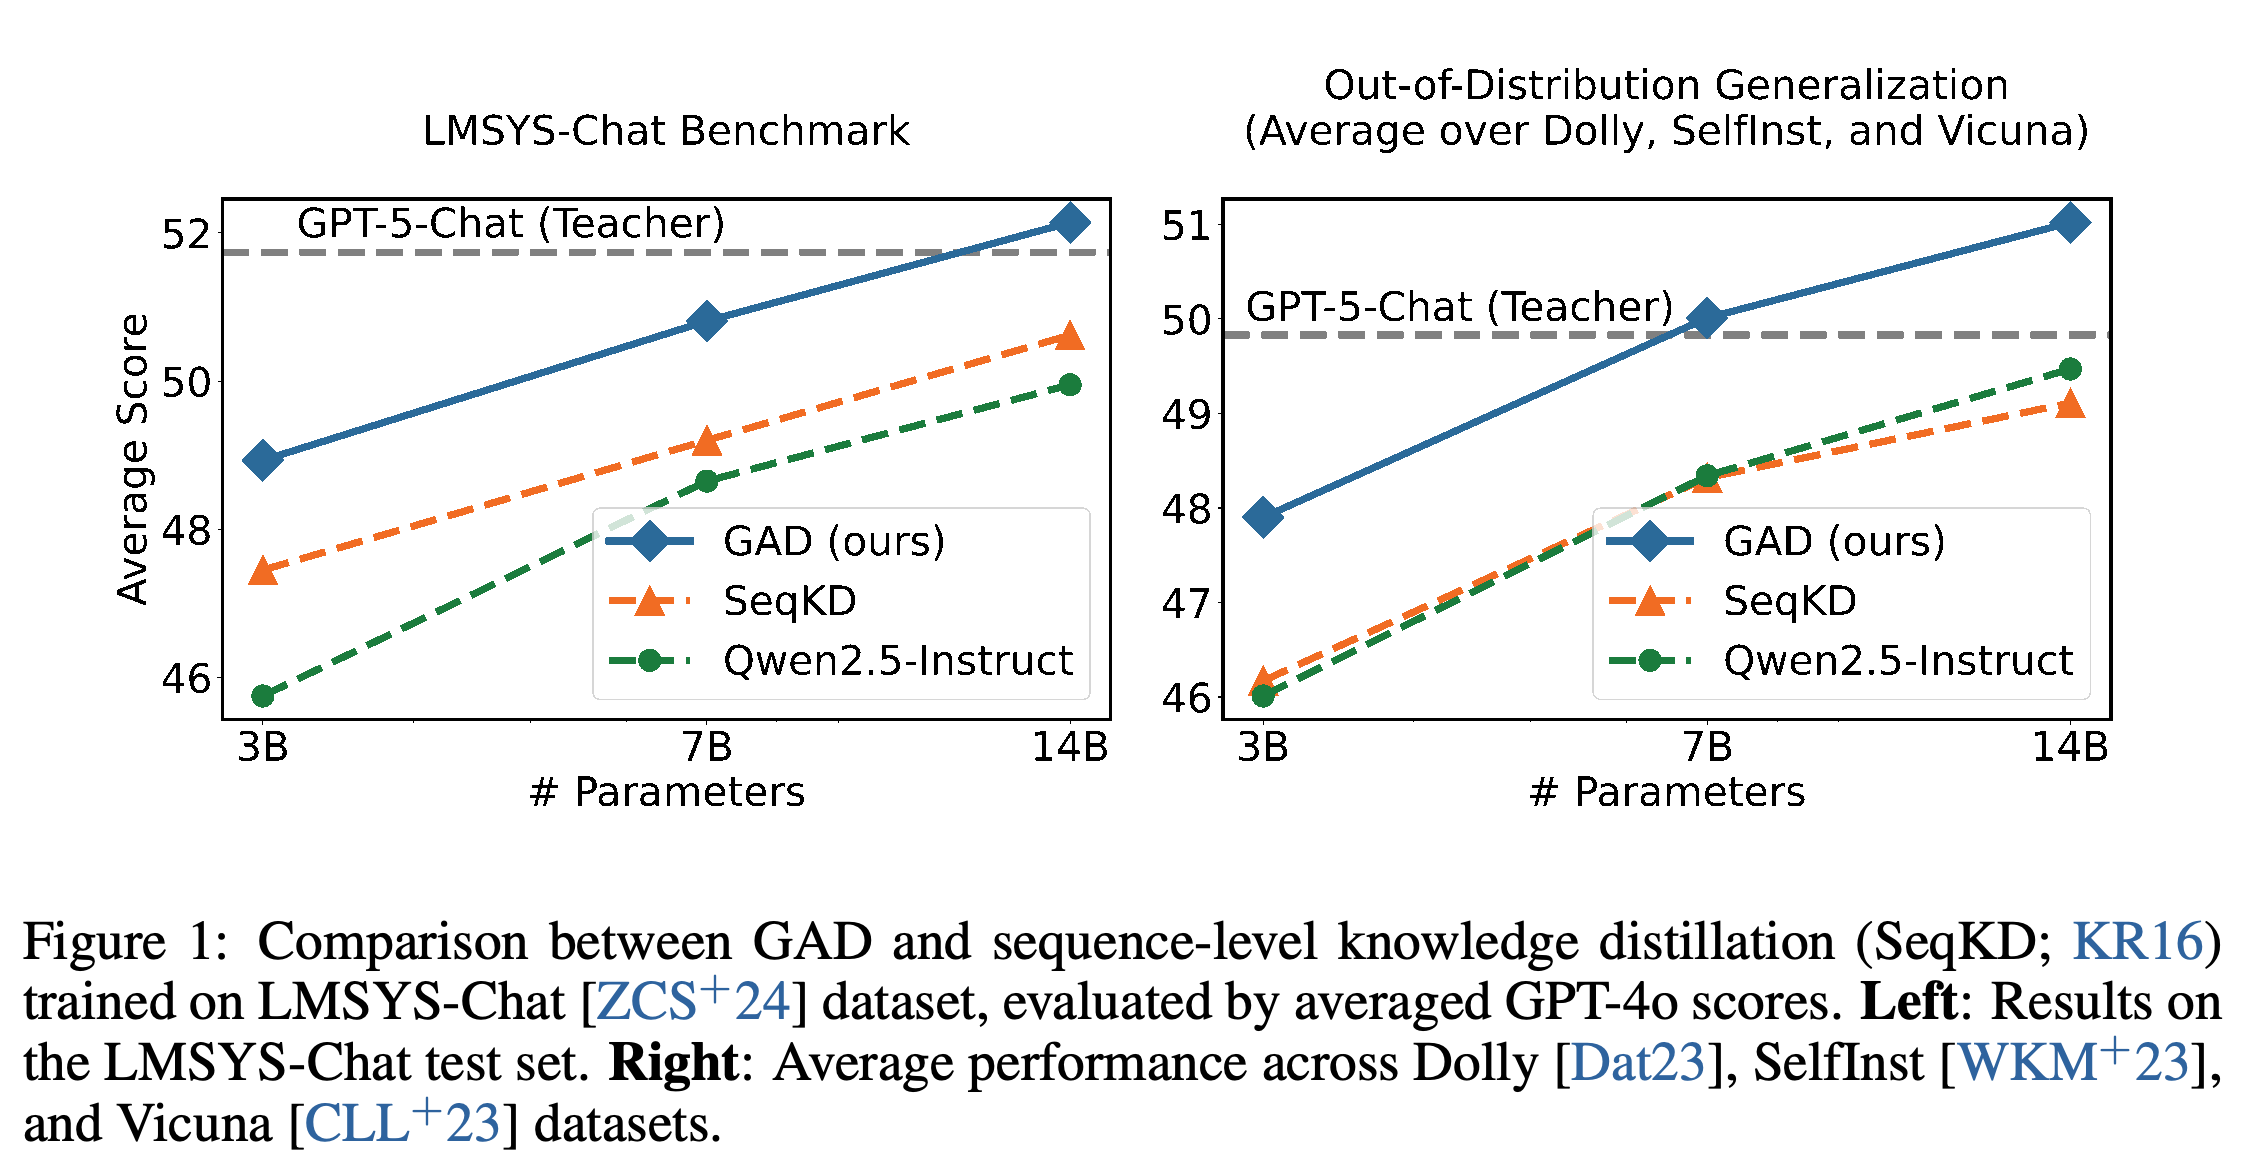
- GPT-5-Chat 응답과 짝지은 프롬프트 200K개로 학습한 GAD는 실험한 학생 5개 모두에서 평가 데이터셋 4개에 걸쳐 기준 모델 2개보다 높은 점수를 기록한다. 기준 모델은 각 학생의 초기 모델과 교사 응답에 학생을 맞춰 학습하는 sequence-level knowledge distillation(SeqKD) 모델이다. 동일한 3 epochs 학습 일정에서 Qwen2.5-14B-Instruct의 LMSYS-Chat 대화 테스트 점수는 GAD가 52.1, SeqKD가 50.6, 교사가 51.7이다. 이 수치는 각 답변의 평점을 GPT-4o-generated 기준 응답의 평점과 비교해 계산한 뒤 평균한 GPT-4o 평가 점수다. 정확도 백분율이나 직접적인 승률을 뜻하지 않는다.
- SeqKD와 비교한 사람 평가의 승리/무승부/패배 비율은 Qwen2.5-7B-Instruct에서 52%/40%/8%, Qwen2.5-14B-Instruct에서 68%/8%/24%, Llama-3.1-8B-Instruct에서 44%/40%/16%다. 판별기를 고정한 실험에서는 약 300 steps 이후 바람직하지 않은 출력으로 보상 신호를 악용하는 reward hacking이 나타나며 응답 길이가 약 1300 tokens까지 늘어난다. 적응형 판별기를 사용한 실행에서는 제시된 구간 동안 길이가 비교적 안정적으로 유지된다. 주요 점수에는 불확실성 추정치가 없고, 체크포인트 선택용 데이터 분할도 명확히 분리되어 있지 않으며 GAD 응답은 SeqKD 응답보다 길다. 14B 학생을 16 H100 GPUs에서 약 30시간 학습했다는 보고는 비용 참고치를 제공하지만 SeqKD와 비용이 같다는 근거는 아니다.
출처
[1] Back to Basics: Let Denoising Generative Models Denoise
[2] Kimi Linear: An Expressive, Efficient Attention Architecture
[3] Black-Box On-Policy Distillation of Large Language Models