


2025년 10월 AI 논문 동향
31 Oct 2025 | Paper Review Monthly Papers Image Editing Optical Compression Reinforcement Learning목차
이달의 트렌드
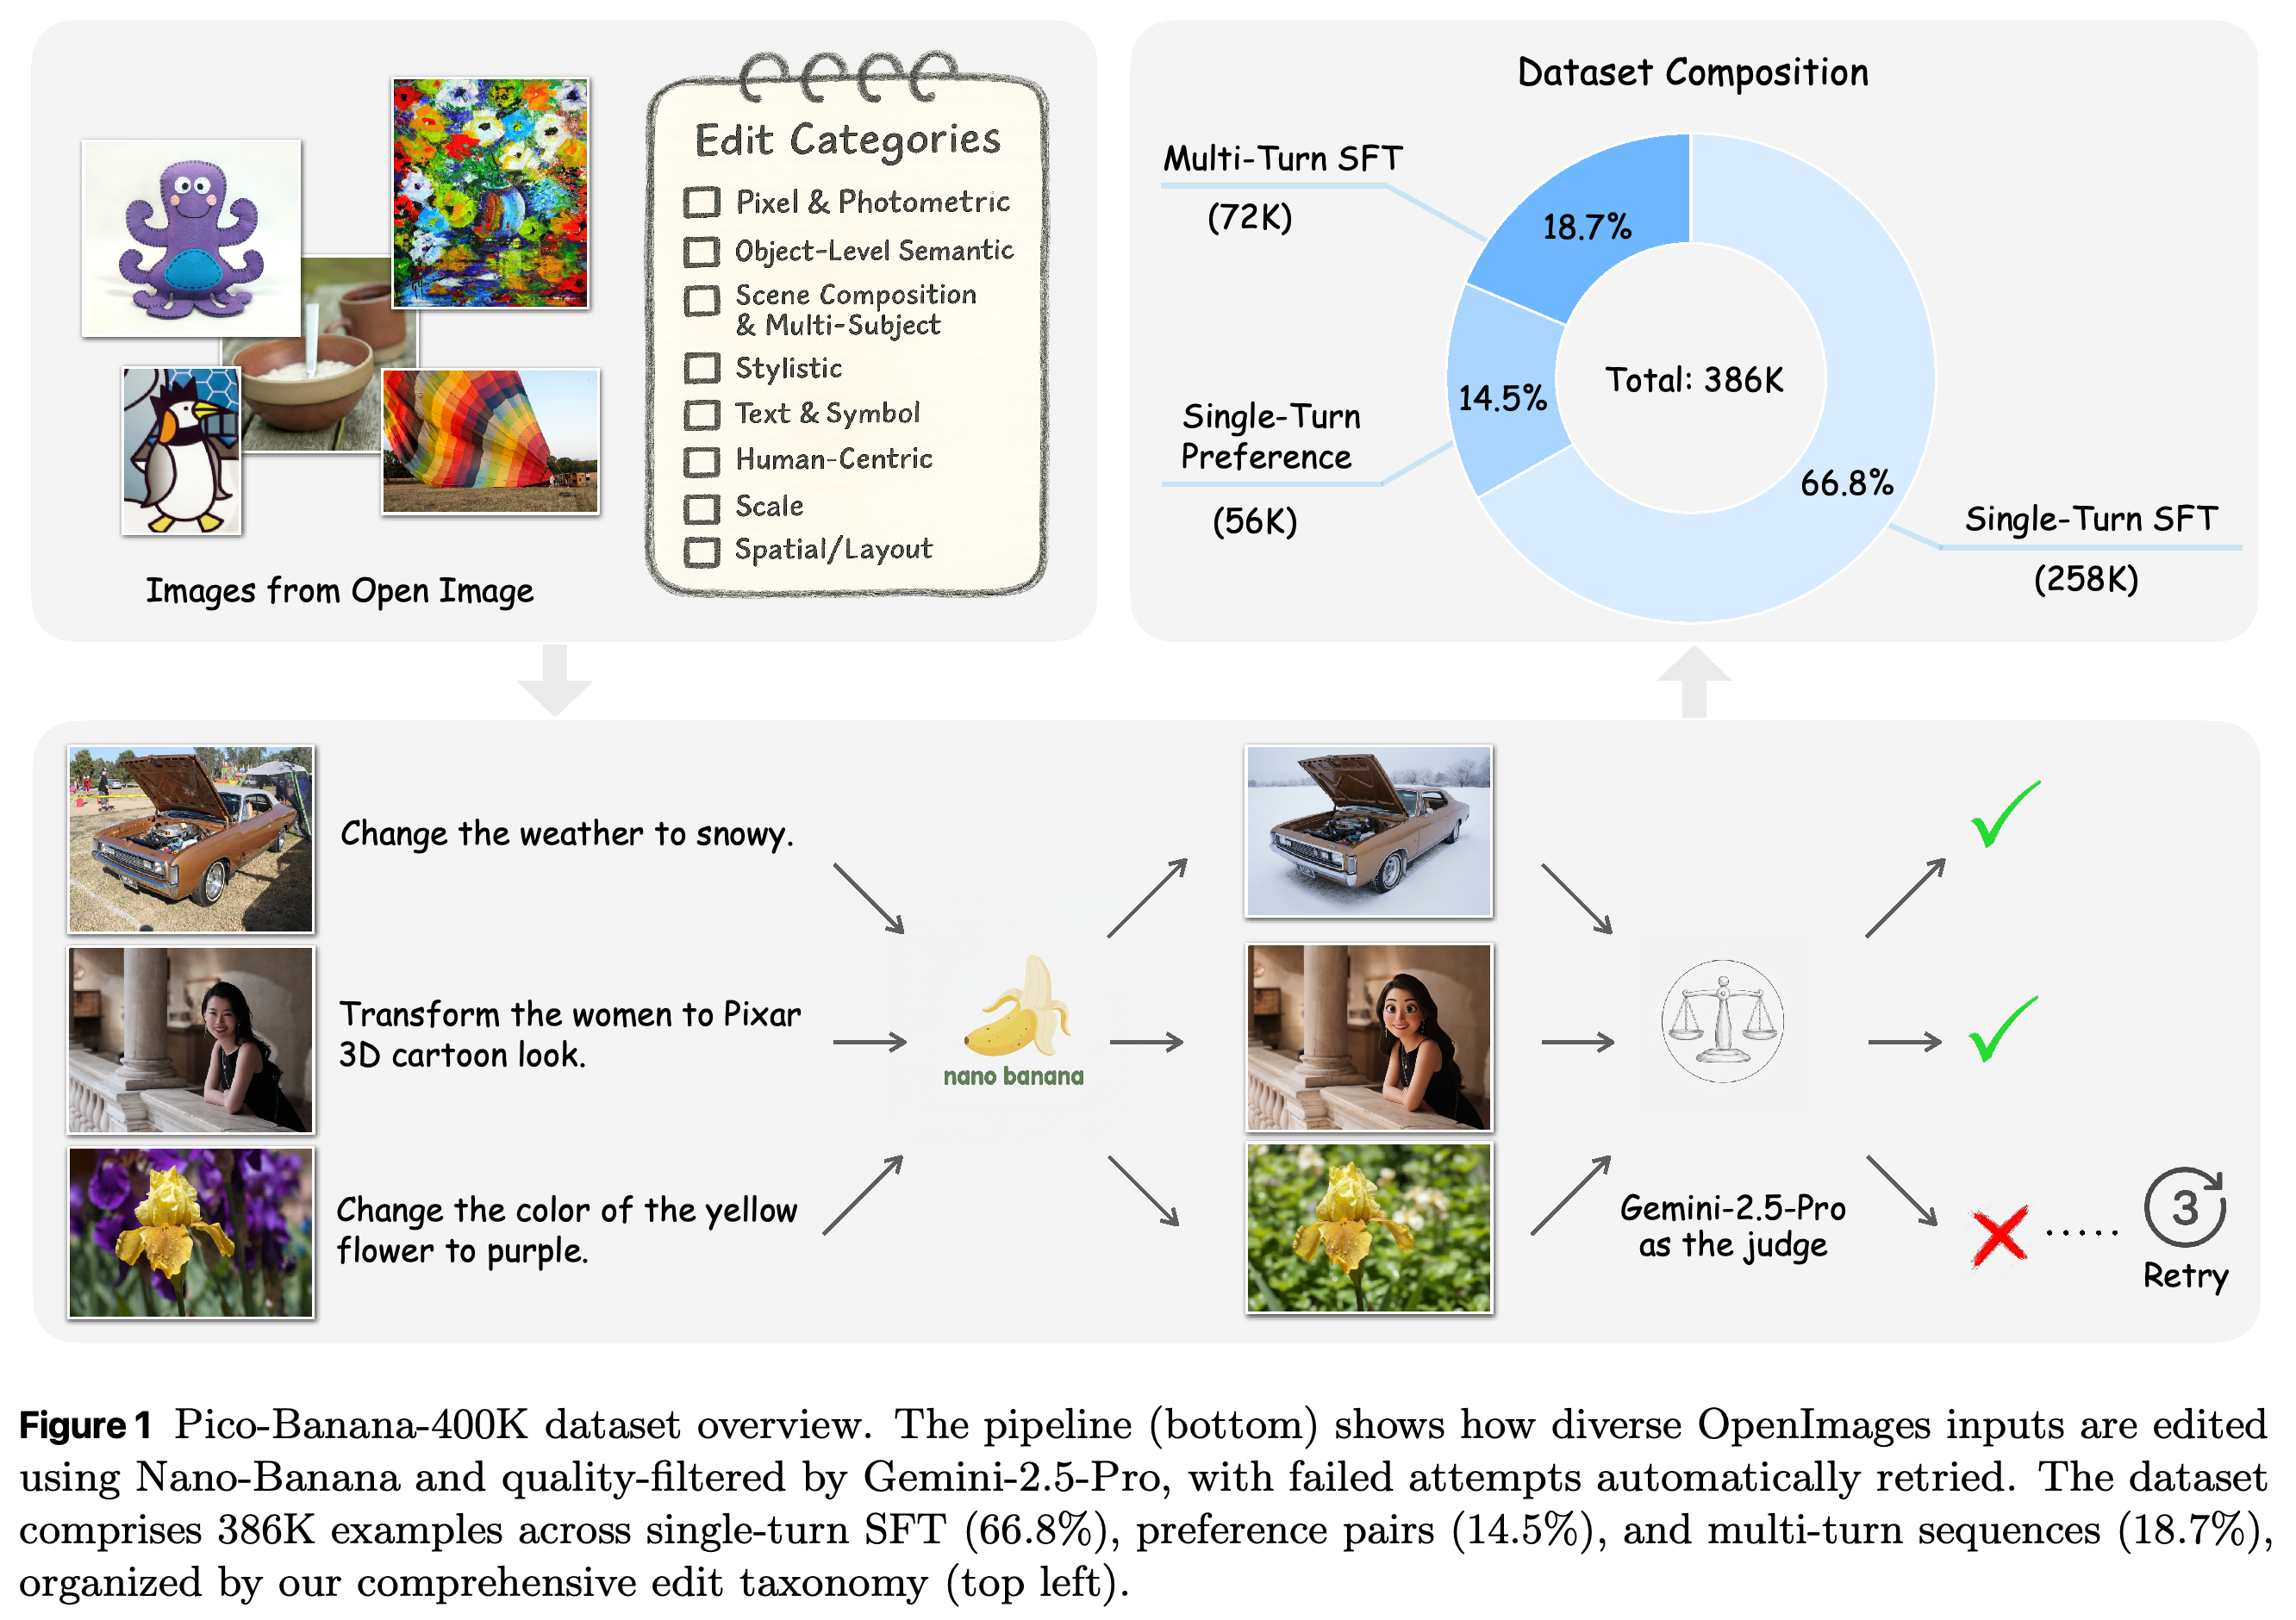
2025년 10월의 주제는 규모 확장을 위한 모델 파이프라인 설계이며 선정된 논문 3편은 품질을 관리한 학습 데이터, 압축된 입력 표현, 효율적인 학습 업데이트를 다룬다. Pico-Banana-400K는 자연어 요청에 따라 이미지를 수정하는 텍스트 기반 이미지 편집 데이터를 채택된 편집, 선호 출력 쌍, 연속 편집 세션으로 구성한다. DeepSeek-OCR은 문서 텍스트를 이미지로 인코딩하고 비교적 적은 vision token으로 표현하는 광학 압축을 연구한다. Vision token은 텍스트 디코더에 입력되는 이미지 표현이다. Ring-1T는 보상을 부여한 모델 출력으로 학습하는 강화학습에서 안정성과 응답 생성 비용을 다룬다. 이 연구들은 데이터 채택 기준, 토큰 배분, 학습 실행을 모델 개발의 명시적인 구성 요소로 다룬다. 1, 2, 3
가장 확실한 근거는 각 파이프라인에서 측정한 구체적인 결과다. Pico-Banana-400K는 데이터셋 구성과 자동 평가에 따른 편집 성공률을 보고하지만 후속 모델 학습의 성능 향상은 측정하지 않는다. DeepSeek-OCR은 제한된 토큰 예산으로 문서를 전사하고 파싱할 수 있음을 보여주지만 긴 문맥의 검색과 추론은 평가하지 않는다. Ring-1T는 학습 진단값의 급격한 증가를 억제하고 비슷한 과제 점수를 유지하면서 학습 단계를 가속했다고 보고한다. 다만 더 폭넓은 벤치마크 결과에는 모델 규모, 데이터, 알고리즘, 인프라의 변화가 함께 반영된다. 따라서 엔지니어링 의사결정에서는 목표 편집 유형, 대상 문서 분포, 응용 과제를 각각 평가할 필요가 있다.
2025년 10월의 주요 논문
1. Pico-Banana-400K: A Large-Scale Dataset for Text-Guided Image Editing
- https://arxiv.org/abs/2510.19808
- Pico-Banana-400K: A Large-Scale Dataset for Text-Guided Image Editing 요약 설명
- Pico-Banana-400K: A Large-Scale Dataset for Text-Guided Image Editing은 예제 386K개를 보고한다. 요청과 입력 및 출력 이미지를 포함하는 단일 턴 지도 미세조정 기록 258K개, 성공 출력과 실패 출력을 연결한 선호 출력 쌍 56K개, 다중 턴 시퀀스 72K개로 구성된다. 제목의 약 400K개는 서로 다른 기록 유형을 합친 수치다. 사람이 주석을 단 편집 triplet 약 10K개로 구성된 MagicBrush와의 비교는 규모와 구조의 차이를 보여주며, 편집 품질을 비교 측정한 결과는 아니다.
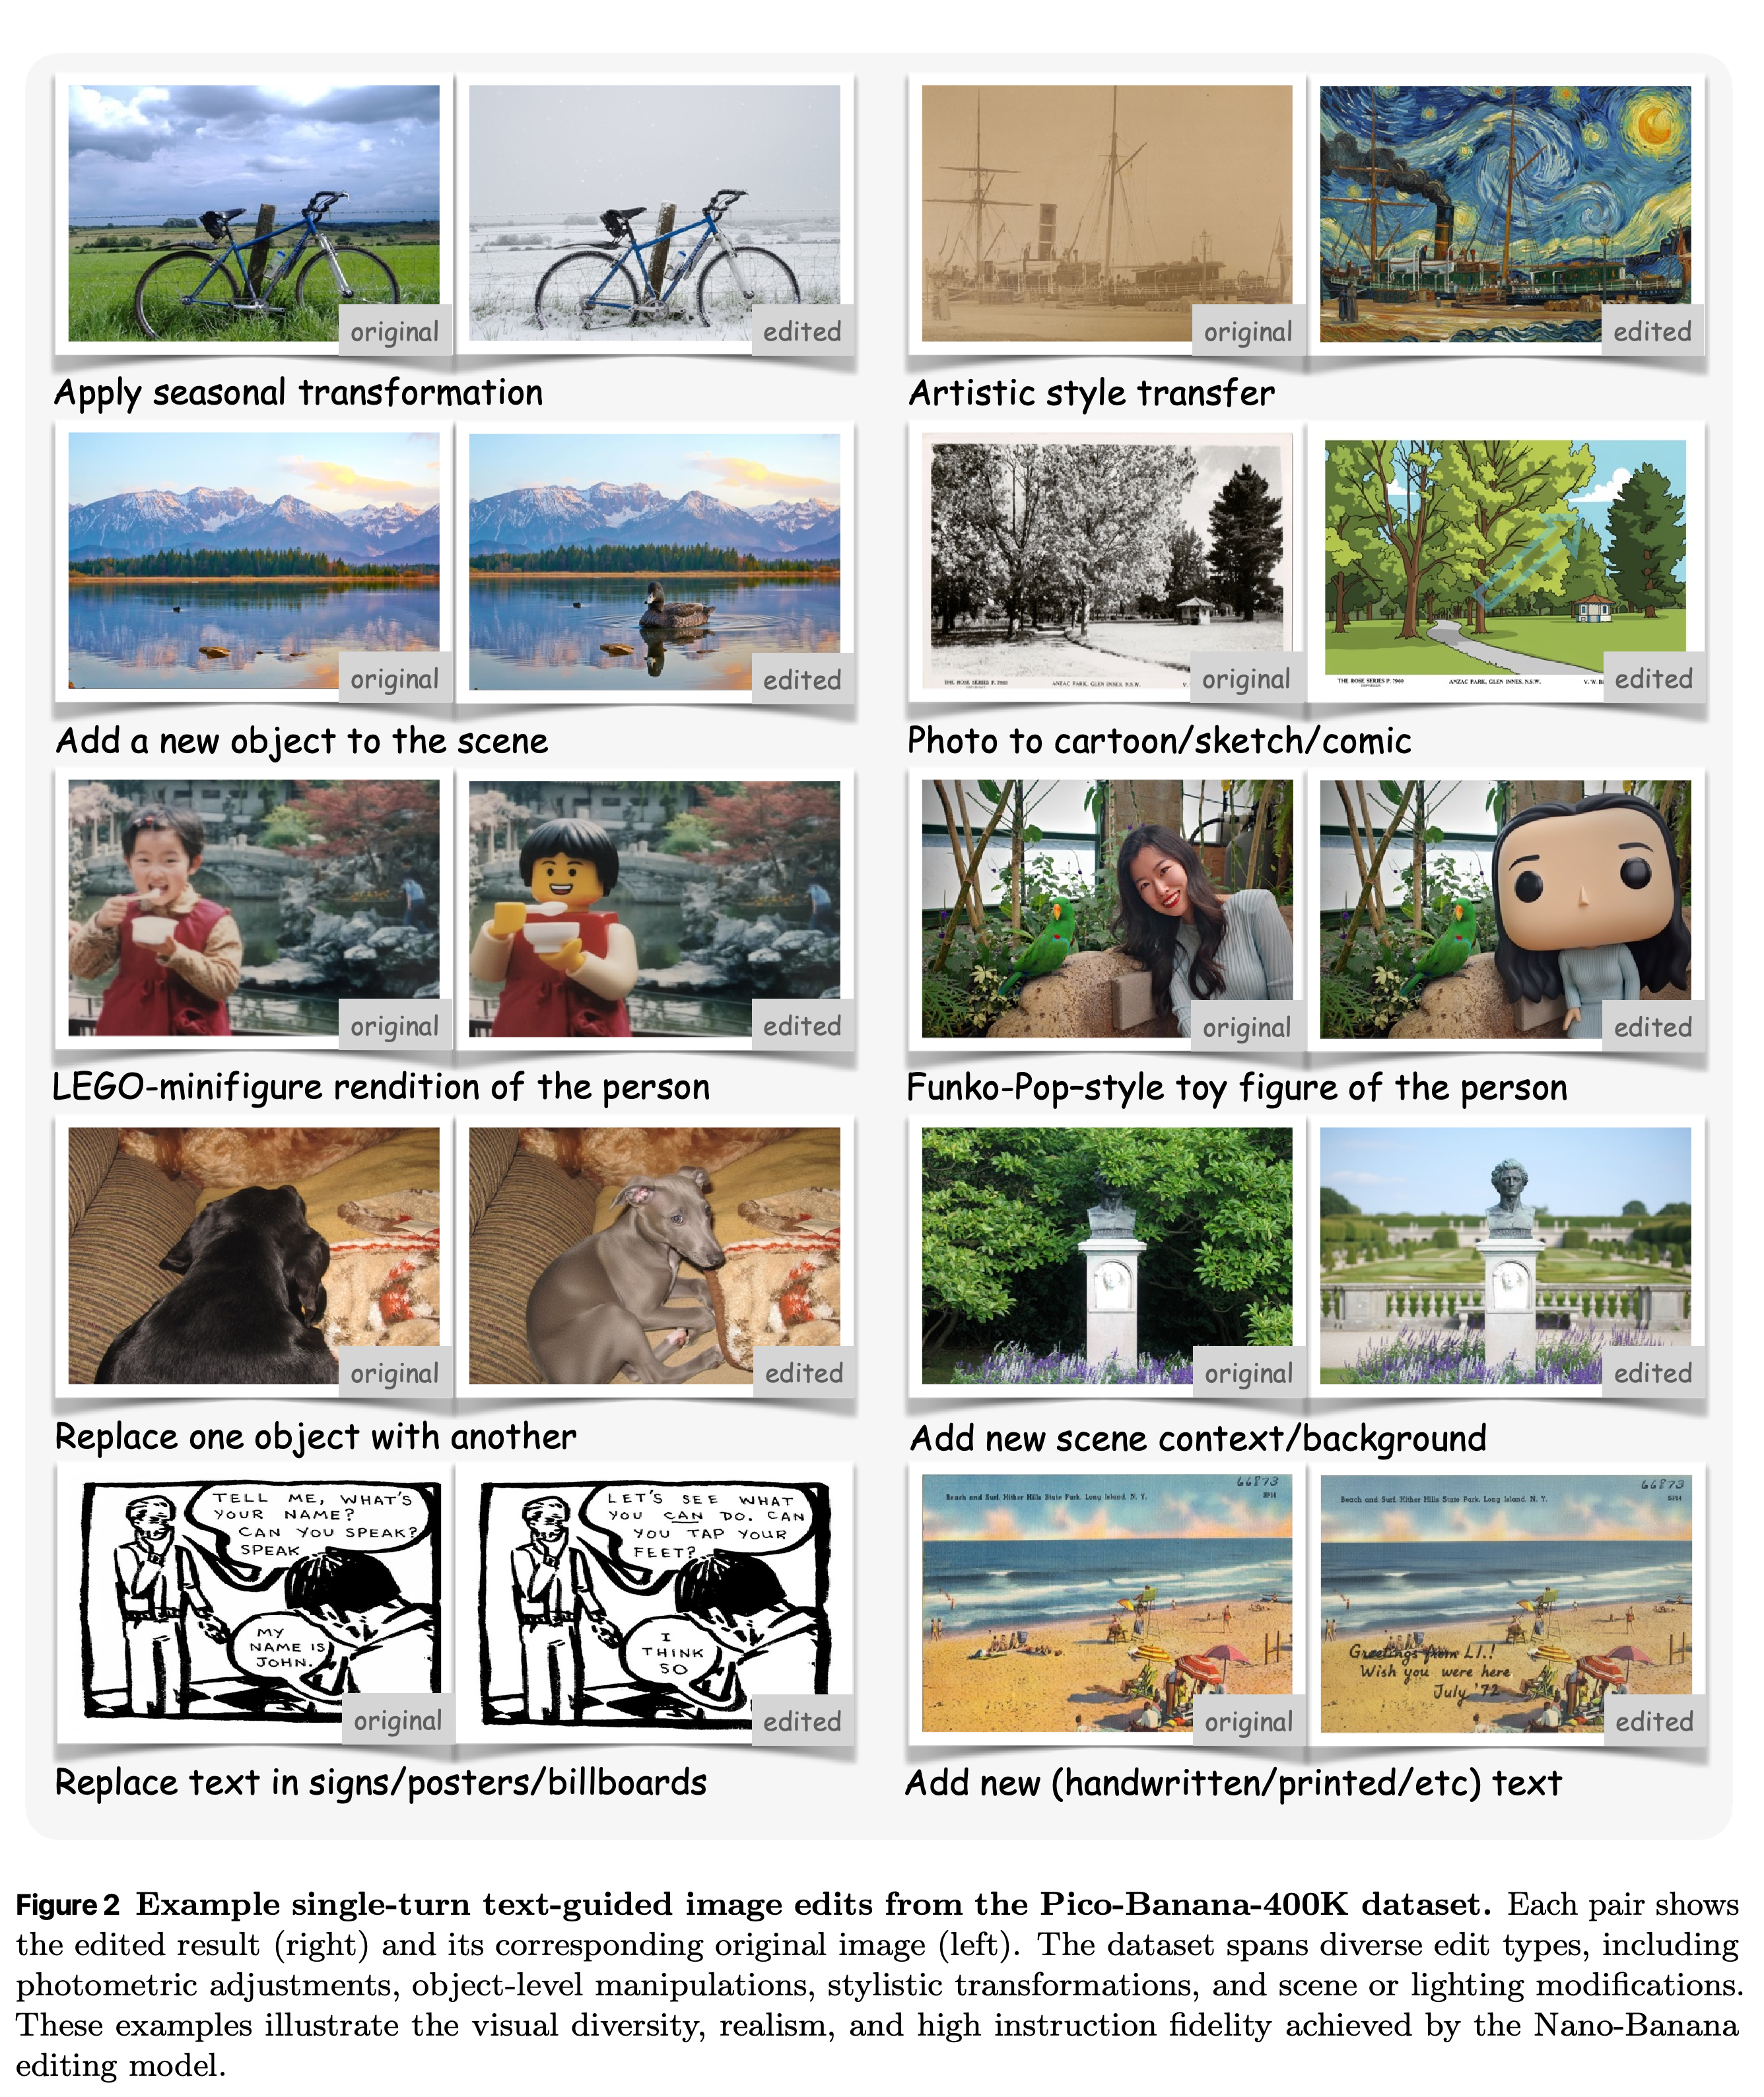
- 구축 파이프라인은 공개 이미지 데이터셋 OpenImages의 사진을 사용한다. Gemini-2.5-Flash가 상세한 요청을 생성하고 Qwen2.5-7B-Instruct가 간결한 요청으로 다시 쓰며, Nano-Banana에 해당하는 Gemini-2.5-Flash-Image 모델이 편집을 수행한다. Gemini-2.5-Pro는 요청 준수, 자연스러운 통합, 변경하지 않은 영역의 보존, 기술적 품질을 각각 40%, 25%, 20%, 15%의 가중치로 평가한다. 경험적으로 정한 약 0.7의 임계값을 초과한 출력을 채택한다. 편집 작업을 분류한 taxonomy는 8개 범주에 걸쳐 35개 유형을 포함한다.
- 자동 평가에 따른 신뢰도는 작업별로 크게 다르다. 이미지의 시각적 표현을 예술 양식으로 바꾸는 강한 artistic style transfer의 성공률은 0.9340이며, 객체 위치 이동은 0.5923, 이미지에 보이는 텍스트의 글꼴 스타일이나 색상 변경은 0.5759다. 신뢰도가 낮은 여러 작업은 제외했으며 남은 유형의 샘플 수도 고르지 않다. 이 성공률은 생성 파이프라인과 필터링 판단을 설명한다. 범주가 폭넓다는 사실만으로 편집 난이도까지 균형 있게 포괄한다고 볼 수는 없다.
2. DeepSeek-OCR: Contexts Optical Compression
- https://arxiv.org/abs/2510.18234
- DeepSeek-OCR: Contexts Optical Compression 요약 설명
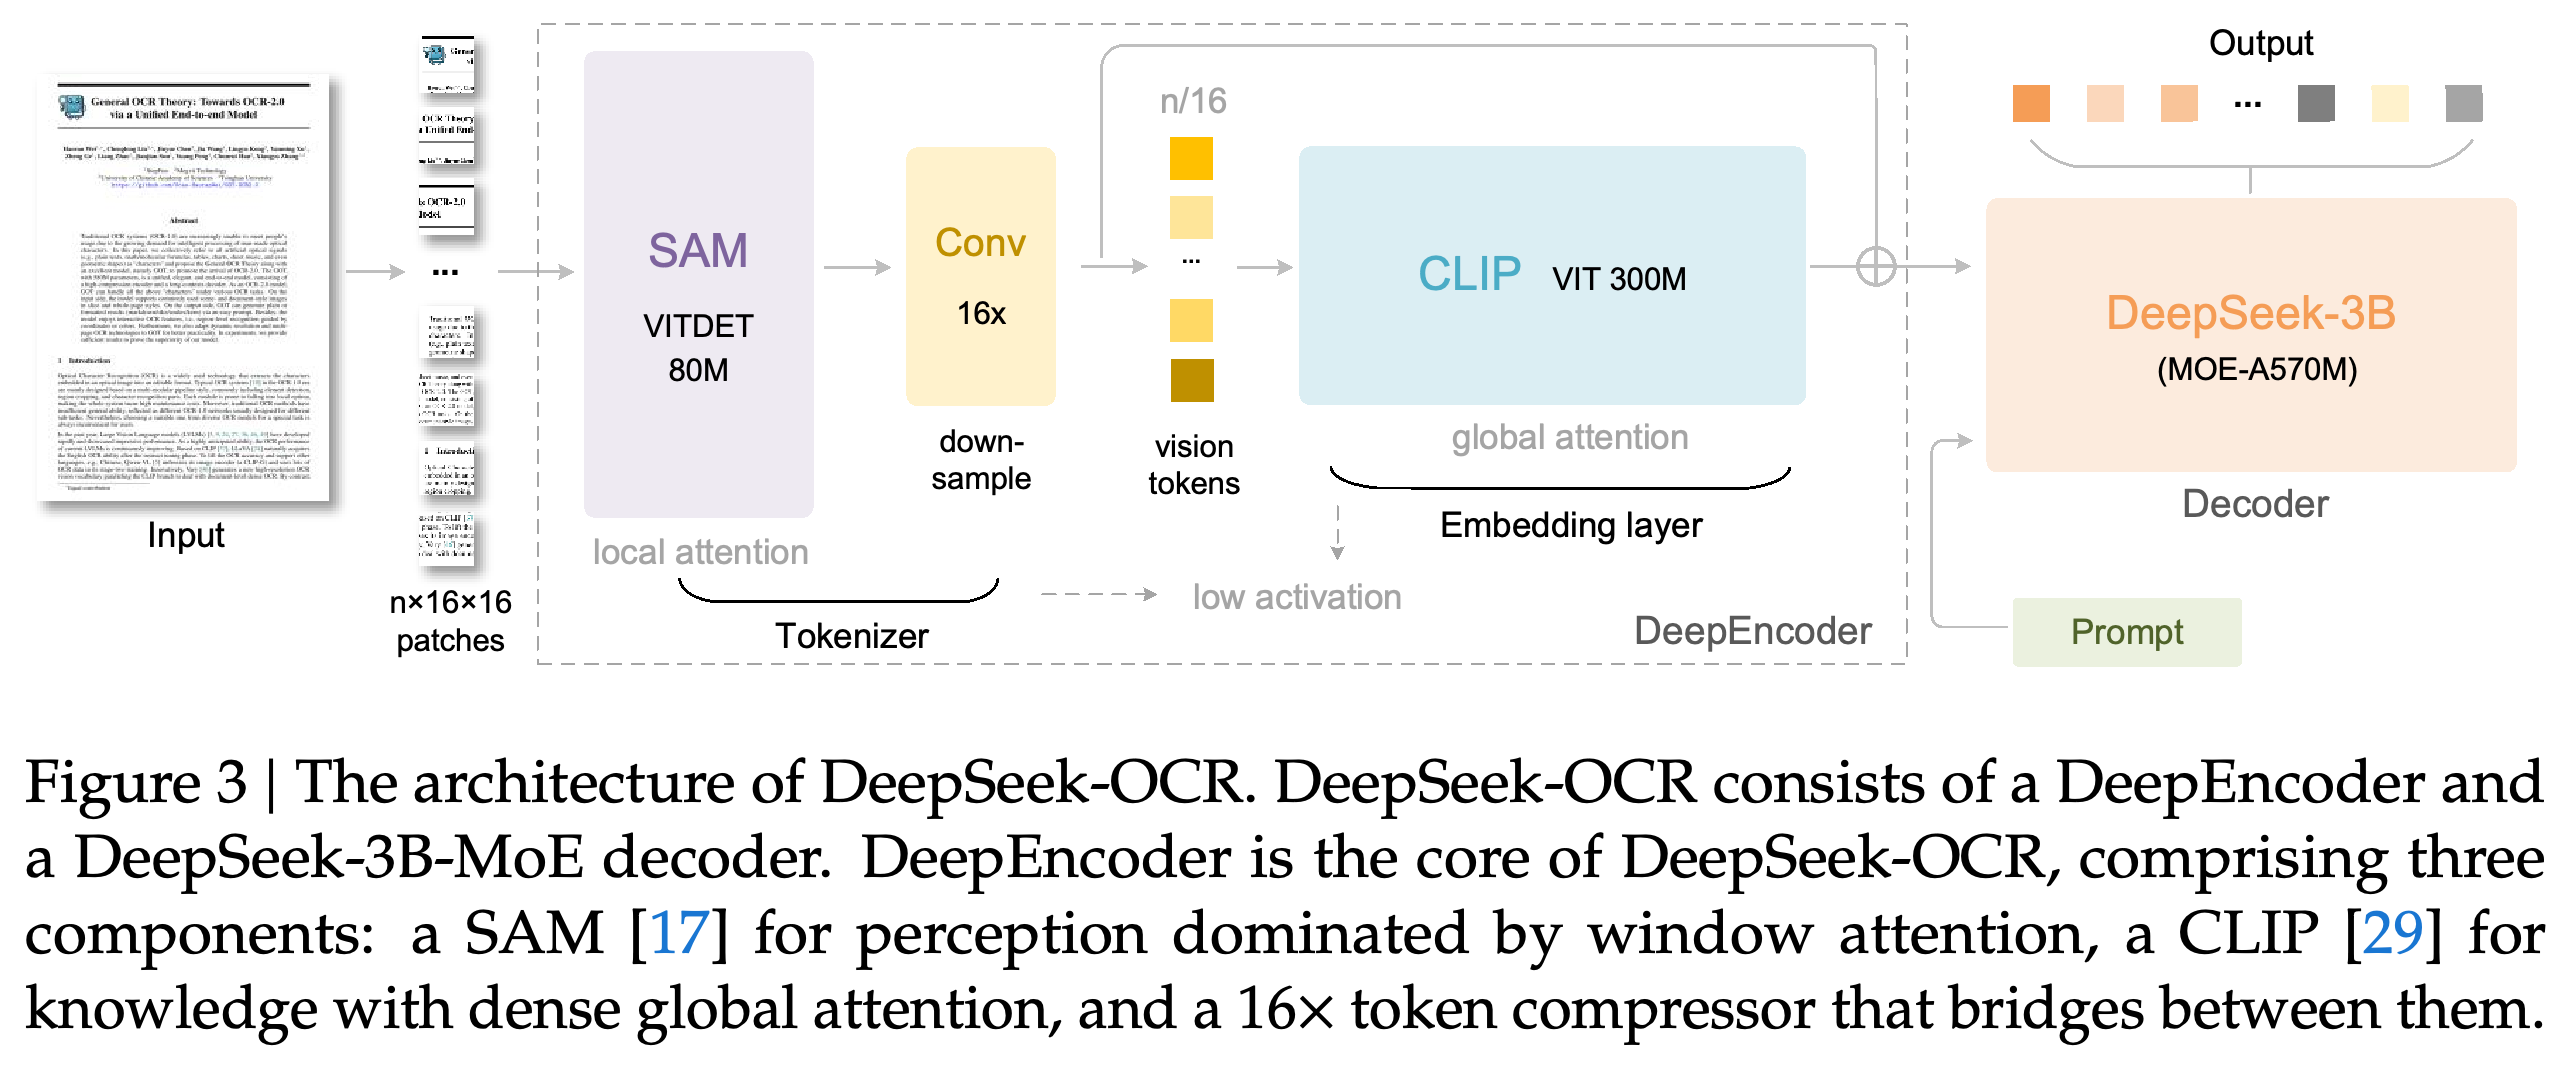
- DeepSeek-OCR: Contexts Optical Compression은 이미지에서 텍스트를 복원하는 광학 문자 인식(OCR)으로 텍스트 복원 성능을 평가한다. DeepEncoder는 국소 이미지 처리, 16× 토큰 다운샘플링, 전역 이미지 처리를 거쳐 3B mixture-of-experts(MoE) 디코더에 입력을 전달한다. 이 디코더는 선택된 전문가 네트워크로 입력을 전달하며 약 570M 파라미터를 활성화한다. 1024×1024 이미지에서 얻은 패치 토큰 4096개는 전체 시퀀스의 토큰들이 상호작용하는 전역 어텐션에 들어가기 전에 256개로 줄어든다. 전역 어텐션에 대해서는 Linformer(Self-Attention with Linear Complexity) 요약 설명 글을 참조하라.
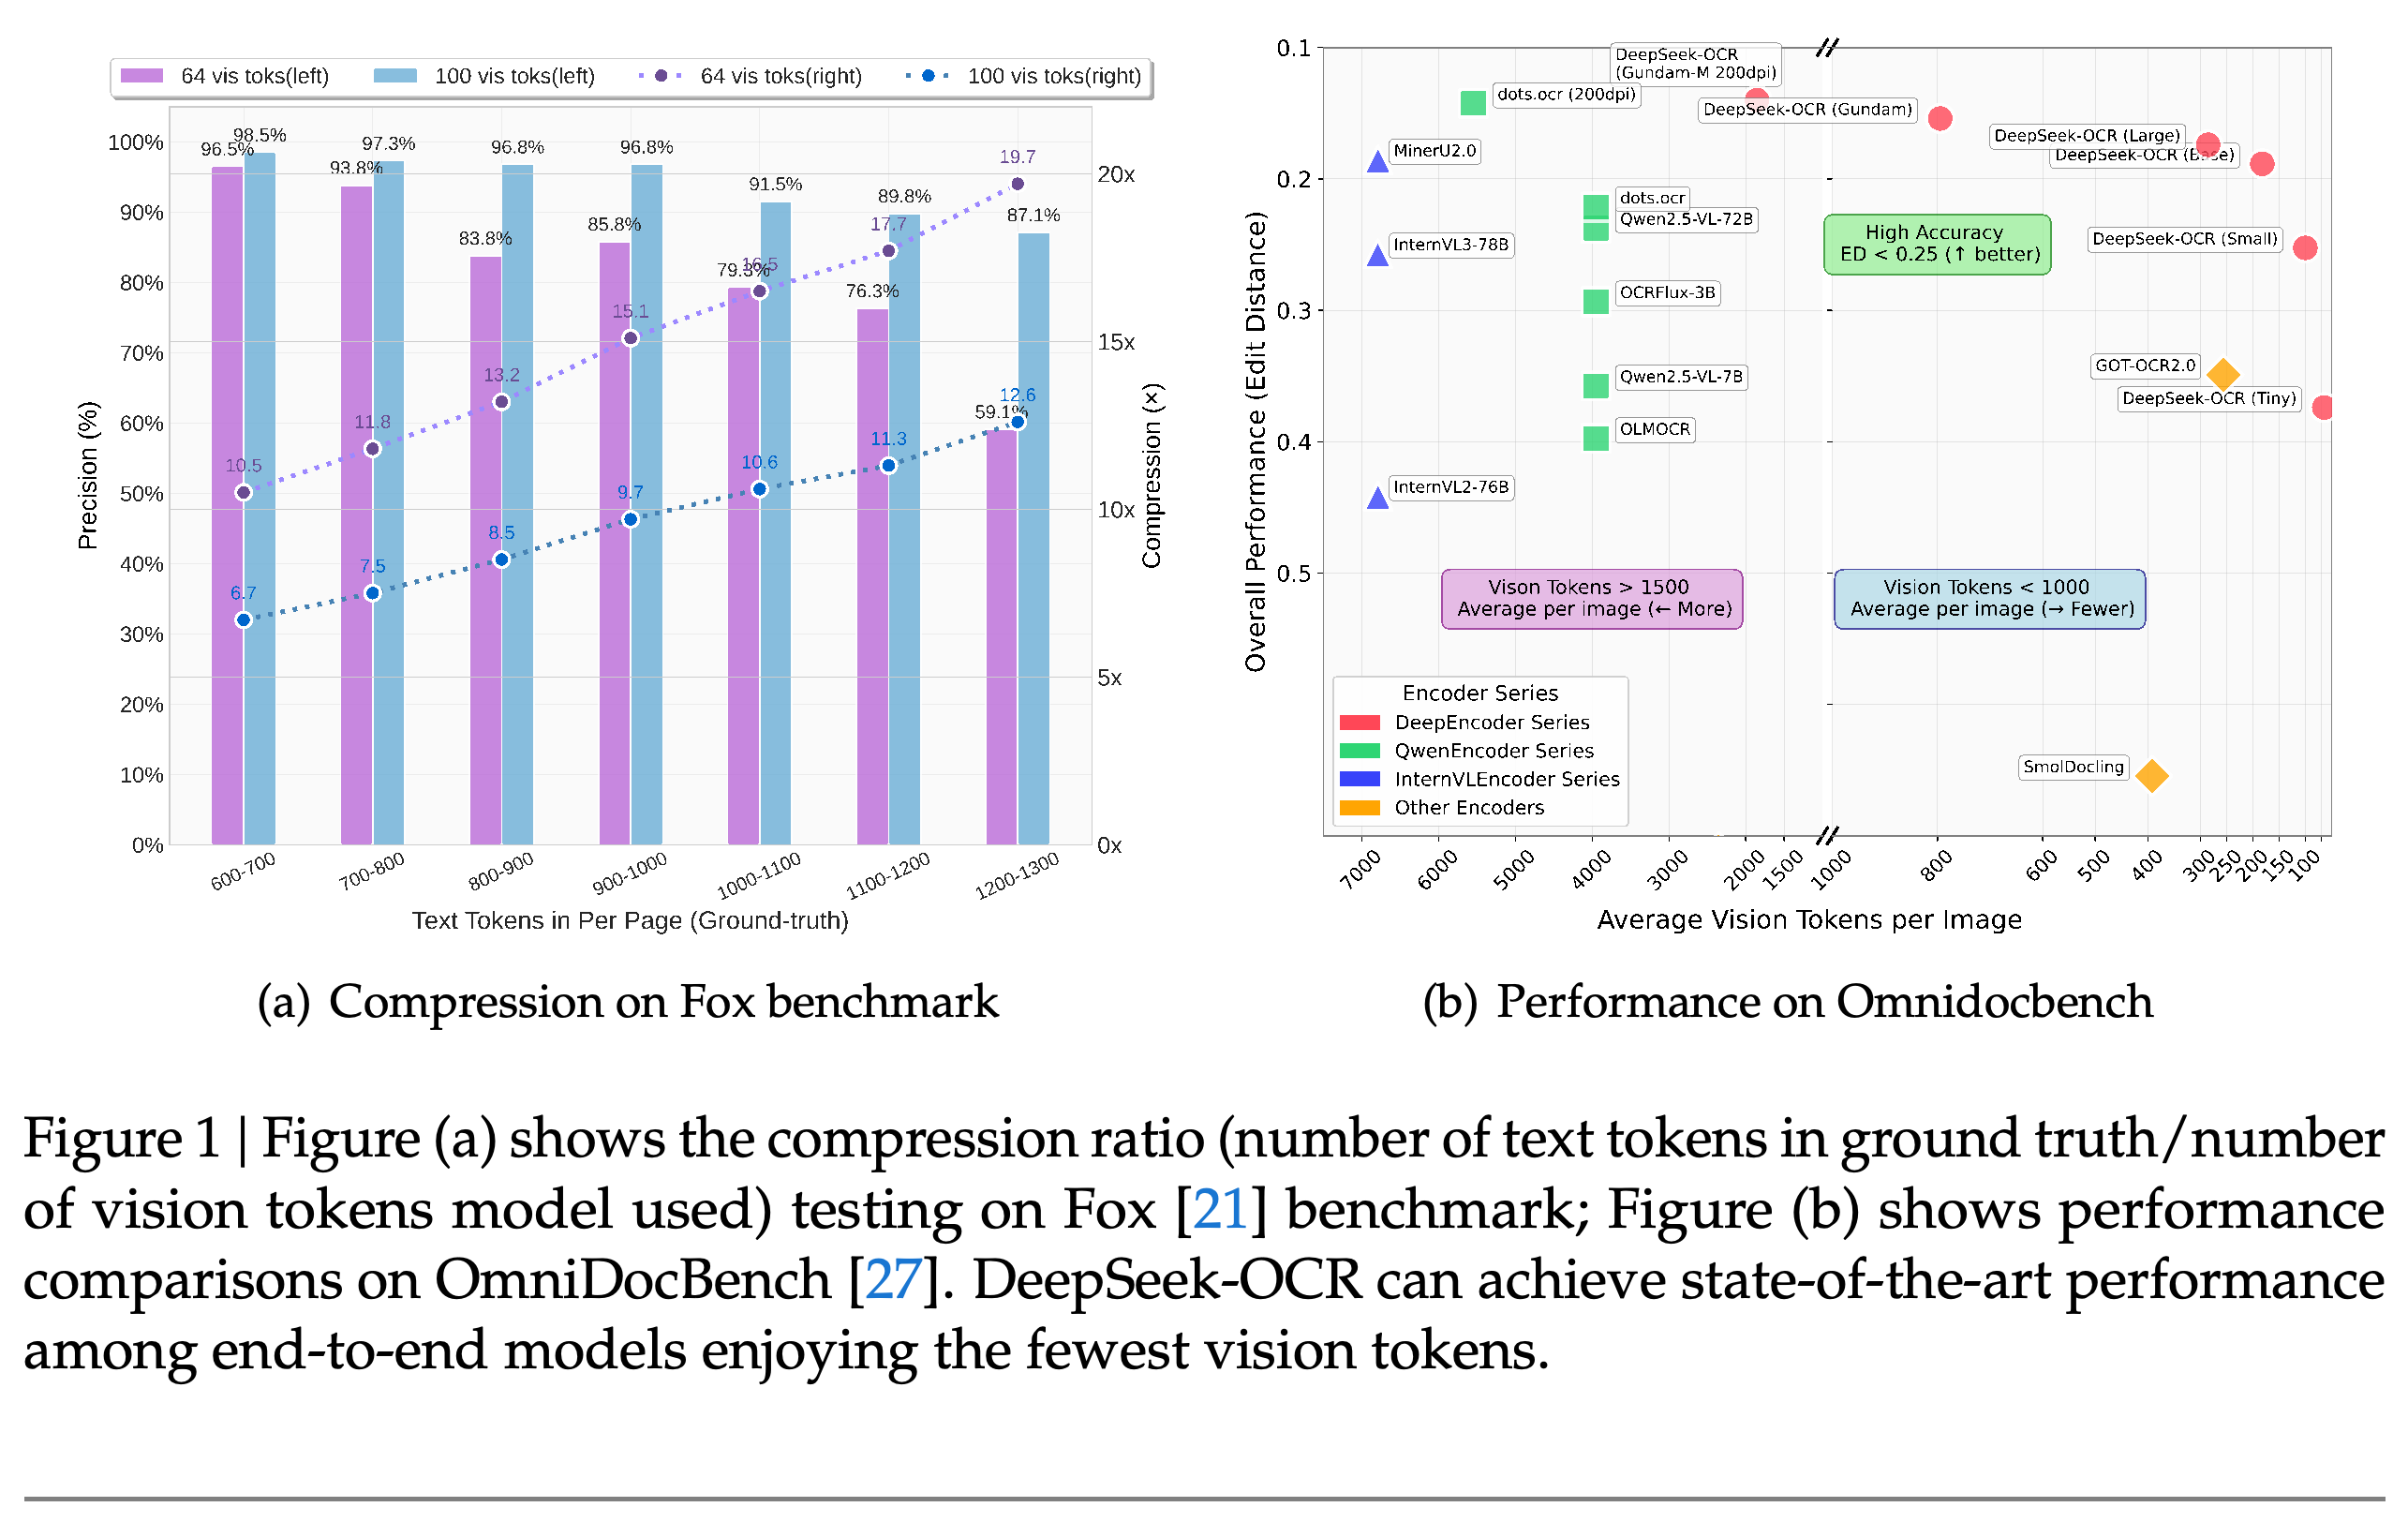
- 문서 파싱 벤치마크 OmniDocBench에서 Gundam 모드는 국소 이미지 조각과 전역 뷰를 결합하며 페이지당 평균 795 vision token을 사용한다. 영어/중국어 종합 편집 거리는 0.127/0.181로, 6790토큰을 사용하는 MinerU2.0의 0.133/0.238보다 낮다. 편집 거리가 낮을수록 정답 출력과의 차이가 적다. 해상도를 높이는 효과는 문서 유형에 따라 다르다. 신문 편집 거리는 Small 모드의 0.744에서 Gundam의 0.122로 낮아지지만 재무 보고서 편집 거리는 Large에서 0.022, Gundam에서 0.289다.
- 압축 실험은 정답 텍스트 토큰이 600–1300개인 문서 이해 벤치마크 Fox의 영어 100페이지를 다룬다. 압축률은 정답 텍스트 토큰 수를 vision token 수로 나눈 값이다. Vision token 100개를 사용하면 압축률 6.7×–9.7×의 구간별 정밀도는 96.8%에서 98.5%다. 압축률 19.7×에서는 64토큰을 사용하는 Tiny 모드의 정밀도가 59.1%이며, 해당 구간에는 4페이지만 포함된다. 모드를 바꾸면 이미지 해상도와 전처리도 달라지므로, 이 실험에서는 토큰 예산과 함께 시각적 세부 정보도 변한다.
3. Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model
- https://arxiv.org/abs/2510.18855
- Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model 요약 설명
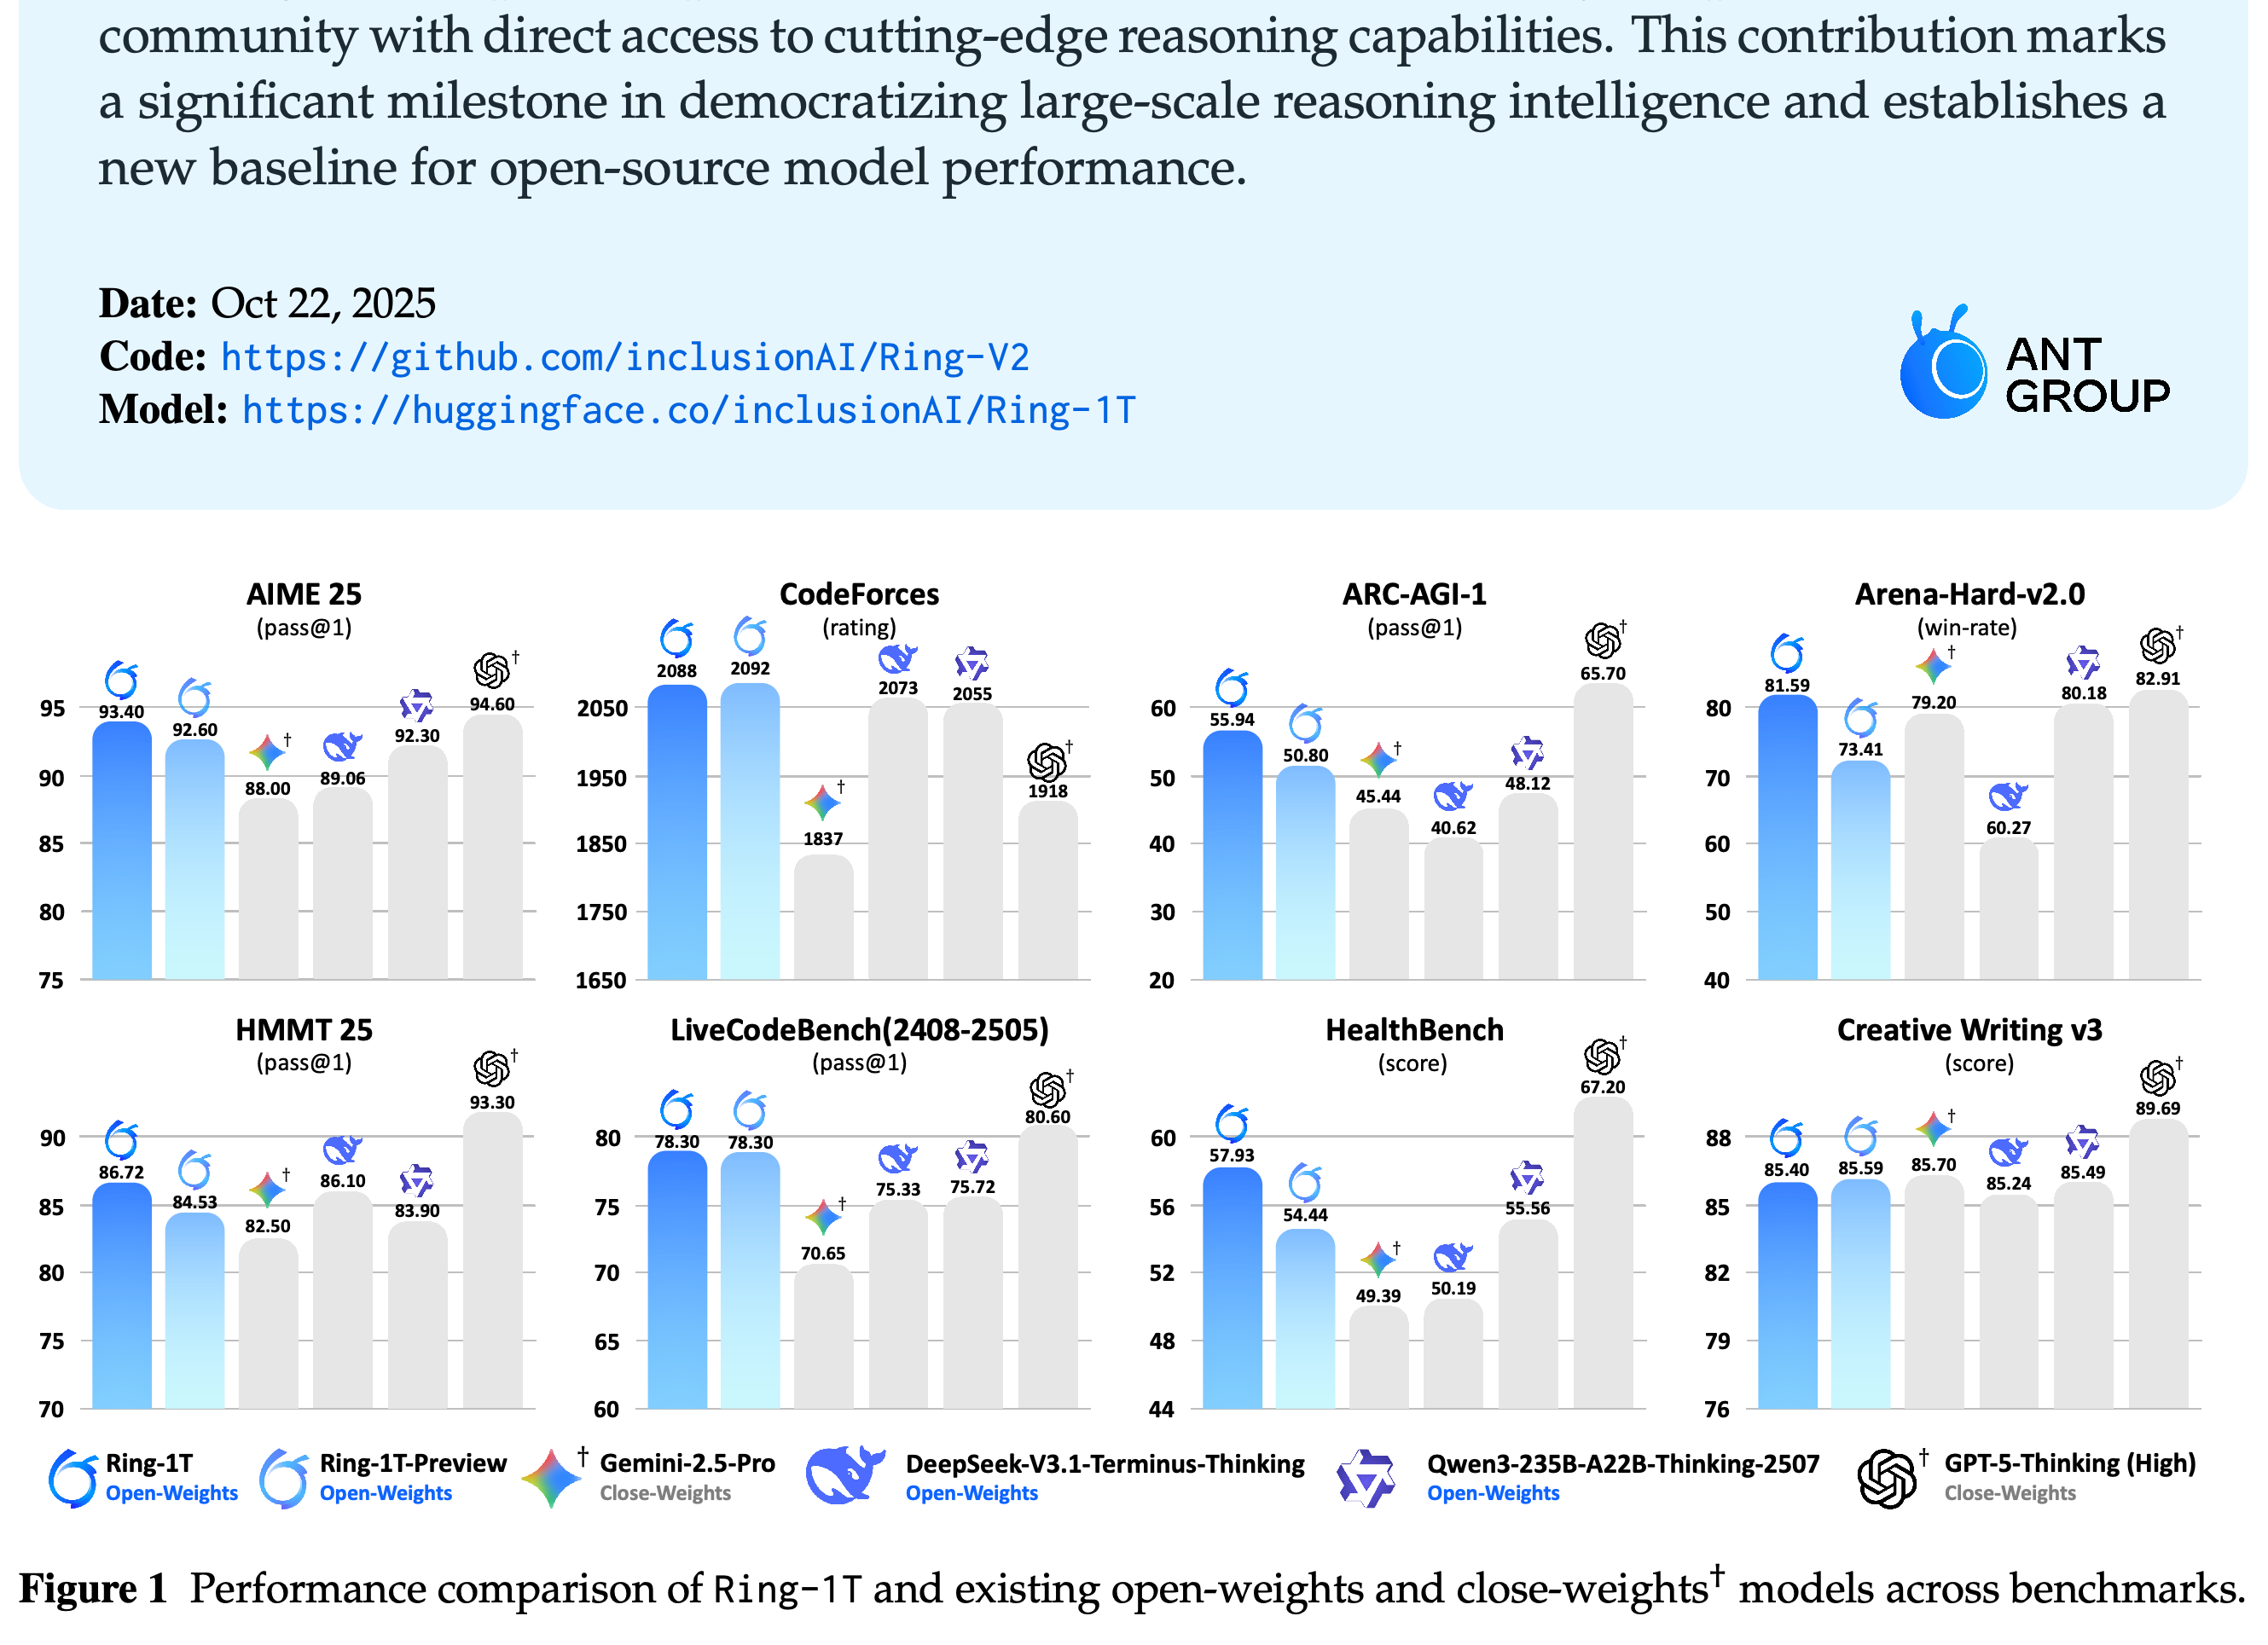
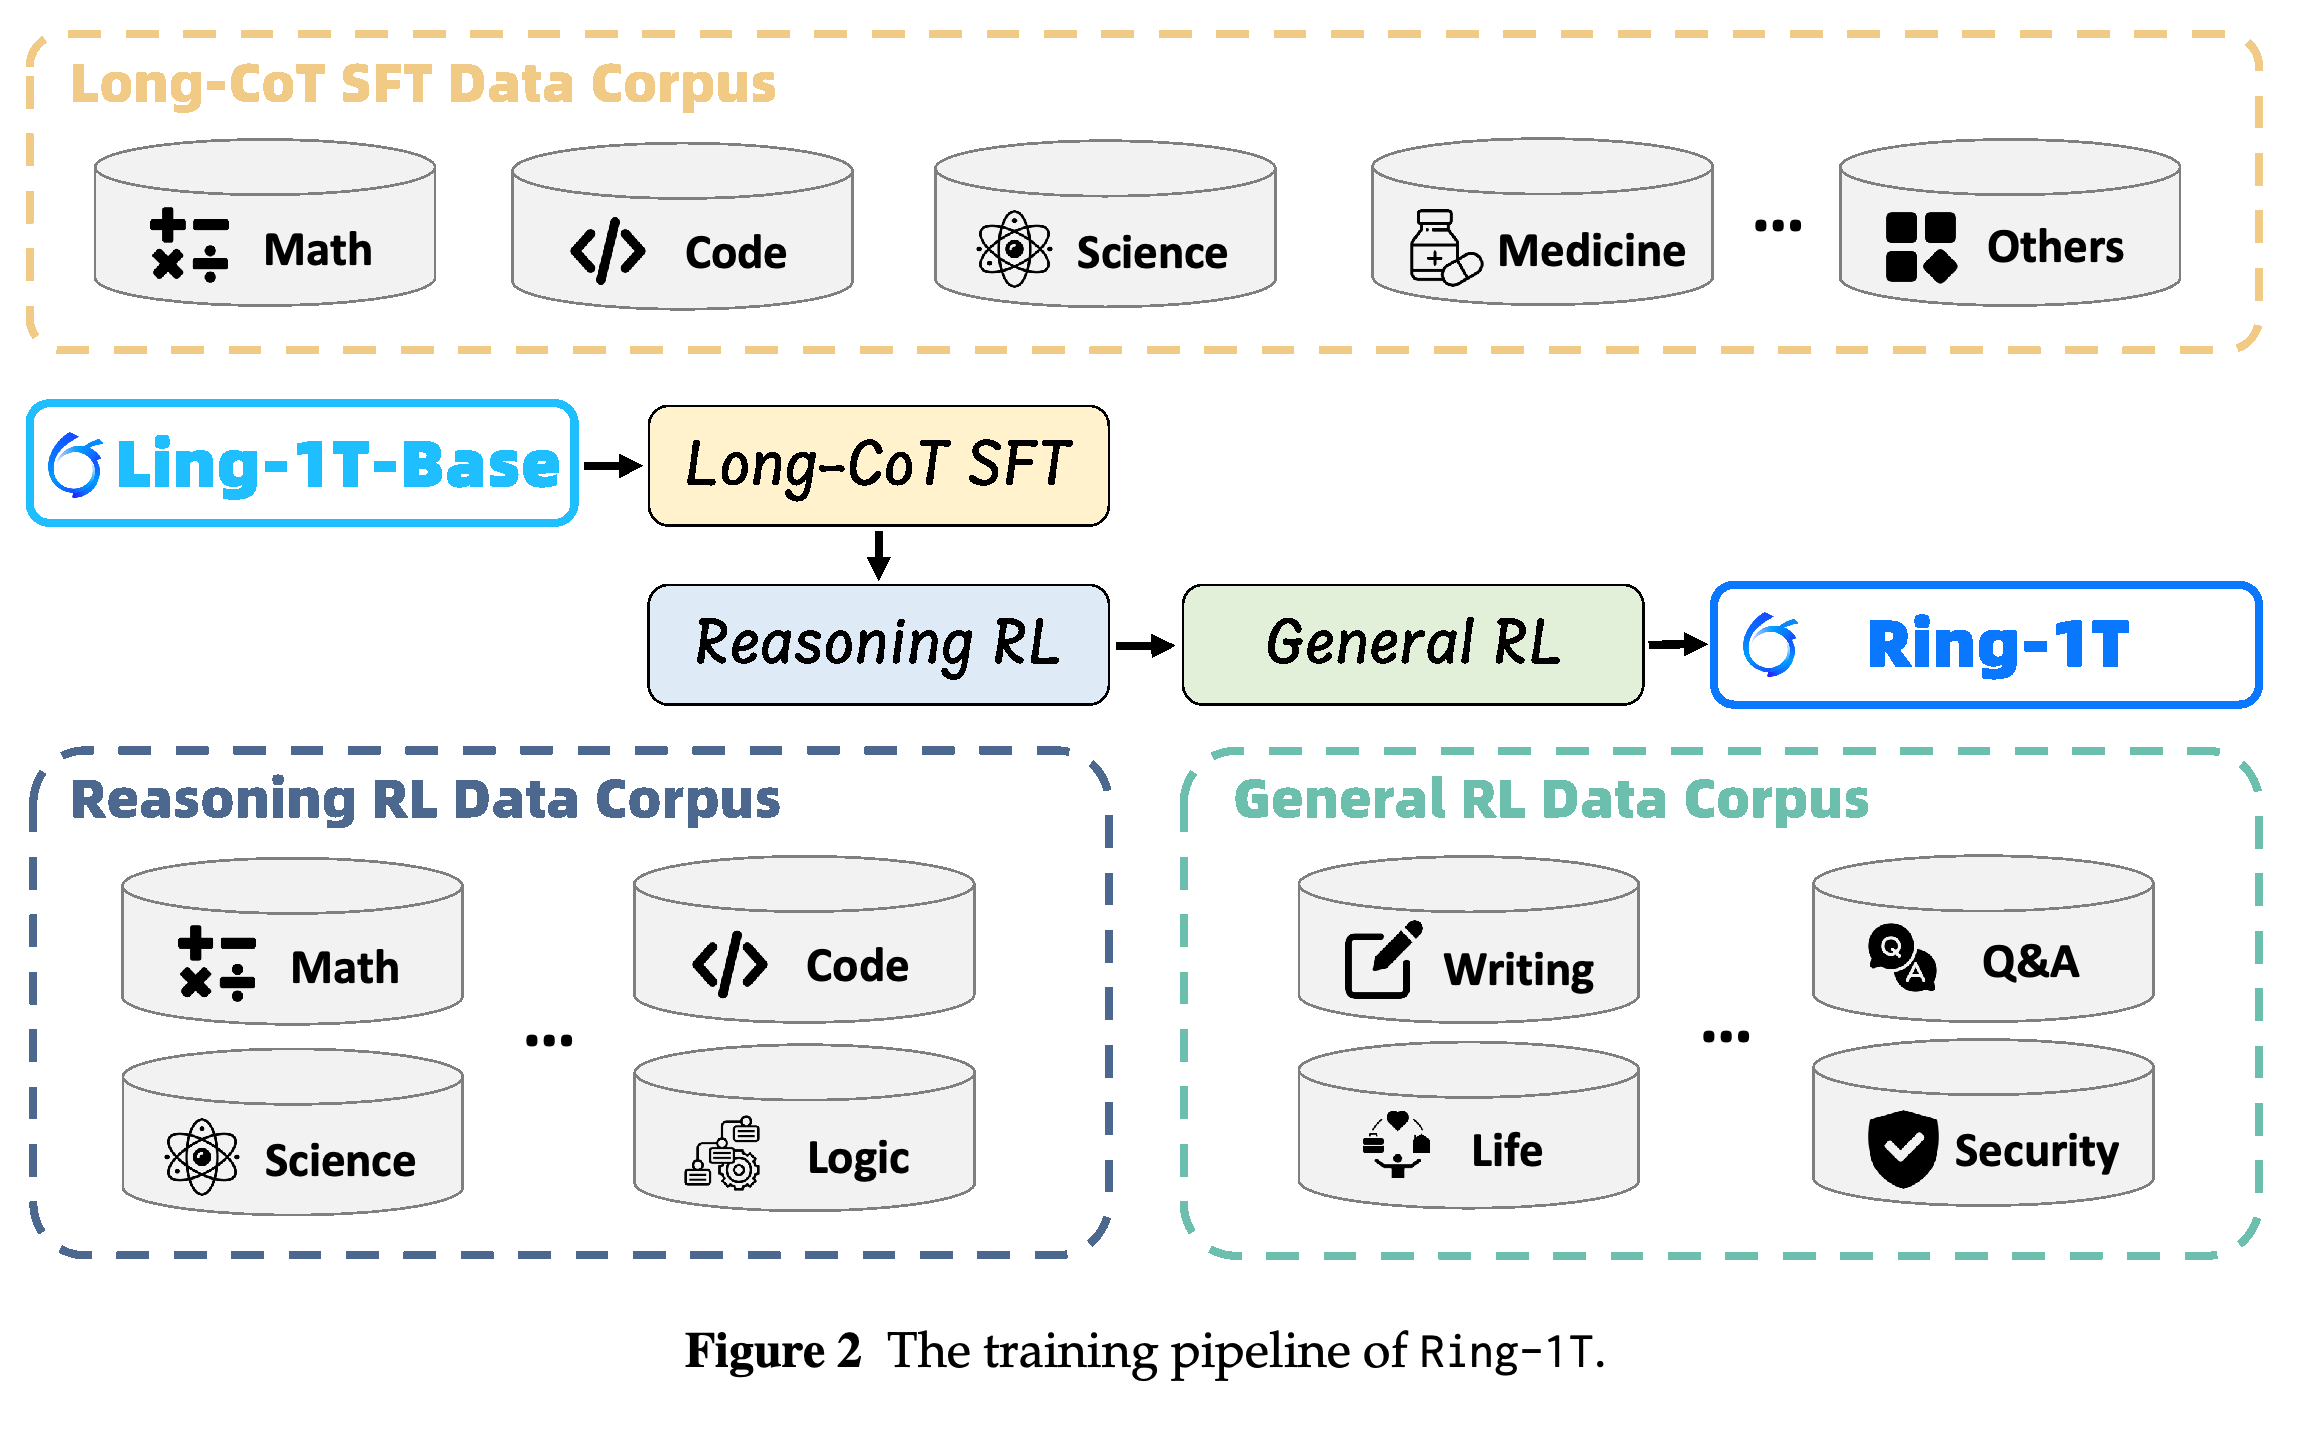
- Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model은 전체 파라미터가 1 trillion개이며 MoE 라우팅으로 토큰마다 약 50 billion개를 활성화하는 Ring-1T를 제시한다. 학습은 긴 단계별 추론을 이용한 지도학습, 검증 가능한 결과를 보상으로 사용하는 추론 강화학습, 인간 선호를 반영하는 일반 강화학습을 결합한다. 논문은 불안정한 업데이트와 긴 추론 응답의 생성 비용을 다룬다.
- IcePop은 이전 모델 파라미터에서 학습 엔진이 계산한 확률을 추론 엔진이 계산한 확률로 나눈 비율로 토큰 업데이트에 가중치를 부여한다. 비율이 지정한 구간을 벗어나면 해당 업데이트를 버린다. 추론 학습에는 α = 0.5와 β = 5를 사용한다. Ring-1T의 진단 결과에서는 비교 실행에서 관찰된 학습 후반의 급격한 gradient norm 증가와 극단적인 엔진 간 불일치 증가를 억제한다. Gradient norm은 업데이트 기울기의 크기다. 수치적 불일치는 여전히 남으며 이론적으로 제시한 불일치 증폭 결과는 명시된 가정 아래에서 성립한다.
- C3PO++는 생성된 응답 경로인 rollout을 여러 모델 업데이트에 걸쳐 분할한다. 완료된 경로의 누적 길이가 토큰 예산에 도달하면 학습을 수행한다. 미완료 경로는 갱신된 파라미터로 생성을 재개하므로 여러 모델 버전이 생성한 구간을 포함할 수 있다. 논문은 예산에 따른 분할을 사용하지 않는 기준 설정 대비 rollout 속도가 약 2.5×, 단계당 전체 실행 속도가 약 1.5× 빨라졌다고 보고한다. 기준 설정/C3PO++ 점수는 AIME25에서 92.29/92.29, CodeForces에서 2084/2085, ARC-AGI-1에서 53.62/53.25다. 이 차이에 대한 신뢰구간은 보고하지 않는다.
출처
[1] Pico-Banana-400K: A Large-Scale Dataset for Text-Guided Image Editing
[2] DeepSeek-OCR: Contexts Optical Compression
[3] Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model